

Python机器学习特征工程与模型调优最佳实践手册
系统讲解Python机器学习中特征工程的完整流程与模型调优的核心方法,涵盖特征构造、特征选择、超参数搜索、交叉验证及常见陷阱,附完整代码示例。
特征工程决定模型能力的上限,调优决定模型在这个上限内能走多远。本文以 scikit-learn 为主要工具,按"原始数据 → 特征构造 → 特征选择 → 建模 → 超参数调优 → 评估"的实际工作顺序,给出每一步的具体做法、完整代码和判断标准,帮助你在真实项目中做出有效的工程决策。
一、特征工程的完整流程
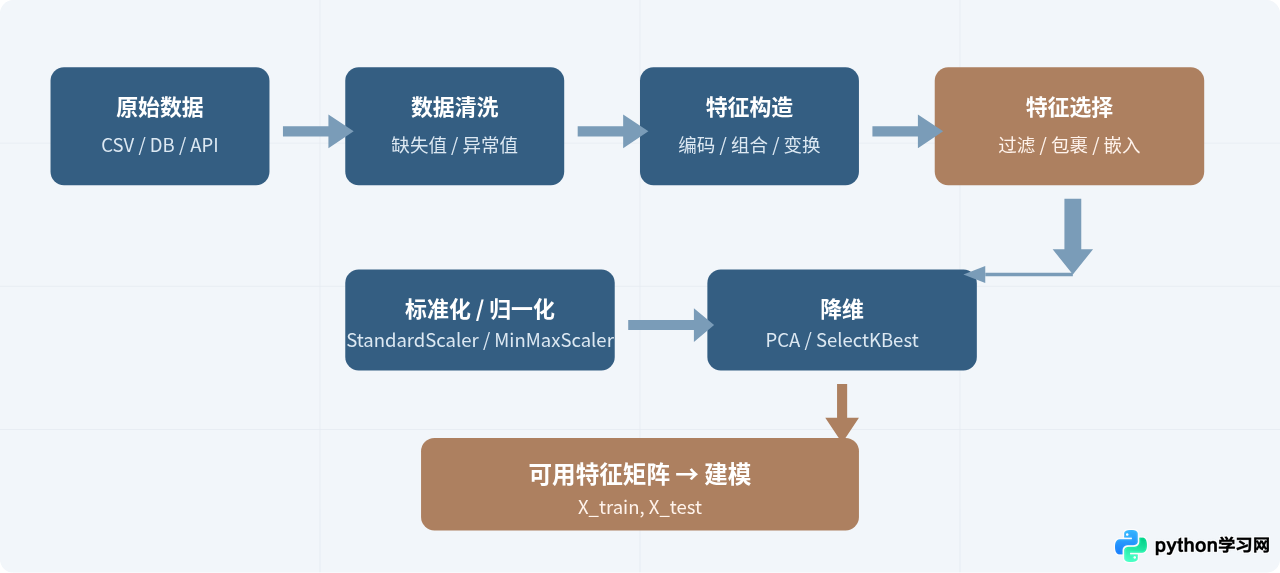
特征工程并非单一步骤,而是一条从原始数据到可用特征矩阵的处理链。典型流程如下图所示:
1.1 数据清洗:缺失值与异常值
清洗是起点。拿到数据后先用 df.info() 和 df.describe() 确认每列类型、缺失比例和分布范围。常用策略:
- 缺失率低于 5%:数值列用中位数填充(比均值对异常值更稳健),分类列用众数填充。
- 缺失率 5%–30%:考虑基于其他特征的预测填充(如
KNNImputer),或将"是否缺失"作为新特征。 - 缺失率超过 30%:先评估该列对目标变量的相关性。相关性弱则直接删除。
import pandas as pd
from sklearn.impute import SimpleImputer, KNNImputer

# 中位数填充
imp_median = SimpleImputer(strategy='median')
df[['age', 'income']] = imp_median.fit_transform(df[['age', 'income']])

# KNN 填充(适用于特征间有相关性时)
imp_knn = KNNImputer(n_neighbors=5)
df_filled = pd.DataFrame(imp_knn.fit_transform(df), columns=df.columns)
异常值检测常用 IQR(四分位距)方法:计算 Q1、Q3,将小于 Q1 − 1.5×IQR 或大于 Q3 + 1.5×IQR 的值视为异常。处理方式取决于业务:截断到边界值(winsorize)、标记为缺失再填充,或直接保留(对树模型通常影响不大)。
Q1 = df['income'].quantile(0.25)
Q3 = df['income'].quantile(0.75)
IQR = Q3 - Q1
lower, upper = Q1 - 1.5 * IQR, Q3 + 1.5 * IQR

# 截断到边界
df['income'] = df['income'].clip(lower, upper)
1.2 特征构造
特征构造是整个工程中对模型效果影响最大的环节。核心思路是把领域知识编码进数值。
分类特征编码
| 方法 | 适用场景 | 说明 |
|---|---|---|
| LabelEncoder | 有序分类(如学历:小学 < 初中 < 高中) | 转为整数,保留顺序含义 |
| OneHotEncoder | 无序分类且类别数少(<15) | 每个类别一列,避免引入假顺序 |
| TargetEncoder | 高基数分类(如城市、邮编) | 用目标均值替换,需在交叉验证内部拟合以防泄漏 |
from sklearn.preprocessing import OneHotEncoder, OrdinalEncoder
from sklearn.compose import ColumnTransformer

cat_low = ['color', 'shape']       # 低基数
cat_ord = ['education']             # 有序
num_cols = ['age', 'income', 'score']

preprocessor = ColumnTransformer([
    ('onehot', OneHotEncoder(drop='first', sparse_output=False), cat_low),
    ('ordinal', OrdinalEncoder(categories=[['小学','初中','高中','本科','硕士']]), cat_ord),
    ('num', 'passthrough', num_cols),
])
数值特征变换
- 对数变换:针对右偏分布(如收入、访问量),用
np.log1p()压缩尾部。 - 交叉特征:将两个相关特征相乘或相除,如"单价 × 数量 = 总价"。
- 时间特征:从日期字段提取年、月、星期、小时,以及"距今天数""是否周末"等派生值。
import numpy as np

df['income_log'] = np.log1p(df['income'])
df['price_per_sqm'] = df['total_price'] / df['area']
df['reg_dayofweek'] = pd.to_datetime(df['reg_date']).dt.dayofweek
df['is_weekend'] = df['reg_dayofweek'].isin([5, 6]).astype(int)
1.3 特征选择
特征太多会增加过拟合风险和训练时间。选择方法分三类:
- 过滤法:与模型无关,计算每个特征和目标之间的统计量(如互信息、方差、卡方检验),排序后取前 k 个。速度快,但不考虑特征间交互。
- 包裹法:用模型评估不同特征子集的效果,如递归特征消除(RFE)。效果较好,但计算量大。
- 嵌入法:利用模型自身的特征重要性,如 L1 正则化(Lasso)自动将不重要特征的系数压缩为 0,或树模型的
feature_importances_。
from sklearn.feature_selection import SelectKBest, mutual_info_classif
from sklearn.feature_selection import RFE
from sklearn.ensemble import RandomForestClassifier

# 过滤法:互信息选前 10 个
selector_mi = SelectKBest(mutual_info_classif, k=10)
X_mi = selector_mi.fit_transform(X_train, y_train)

# 包裹法:RFE 选 15 个
rfe = RFE(RandomForestClassifier(n_estimators=100, random_state=42), n_features_to_select=15)
rfe.fit(X_train, y_train)
selected_mask = rfe.support_

# 嵌入法:查看树模型重要性
rf = RandomForestClassifier(n_estimators=200, random_state=42).fit(X_train, y_train)
importances = pd.Series(rf.feature_importances_, index=feature_names).sort_values(ascending=False)
print(importances.head(15))二、特征类型与常用处理方法速查
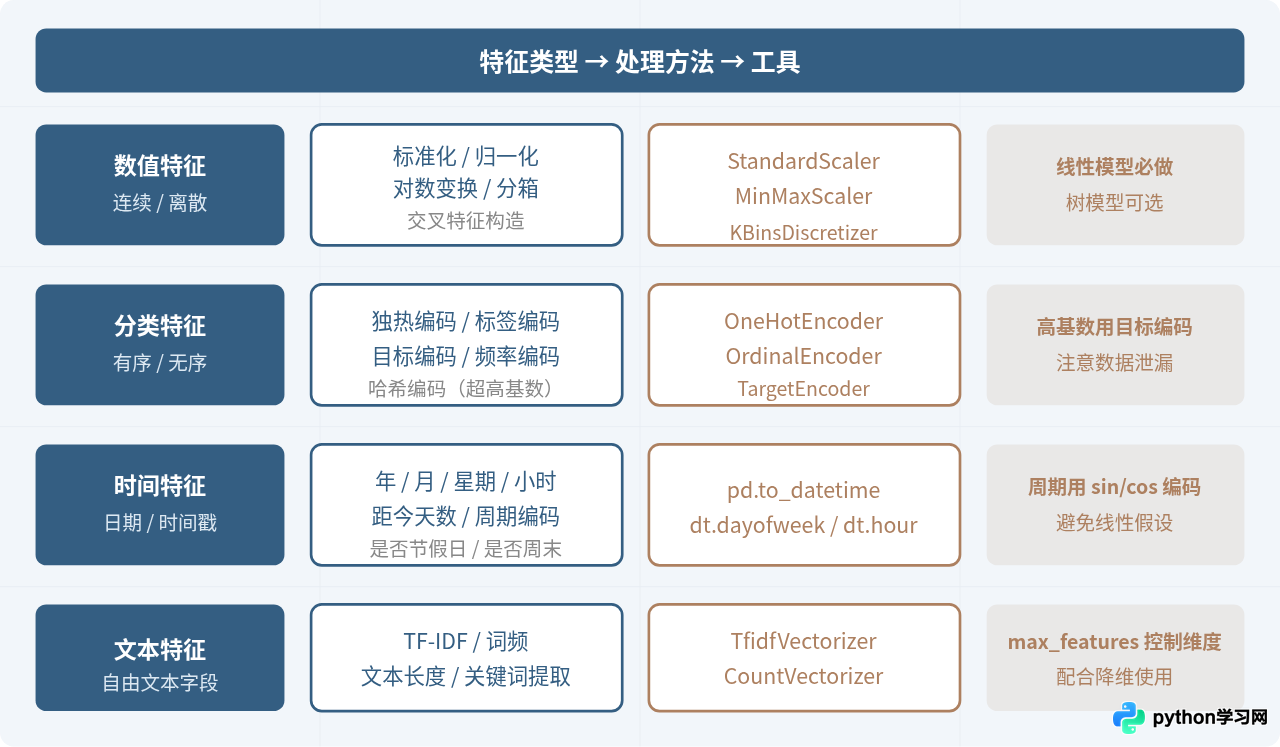
不同类型的特征需要不同的预处理方式,下图按特征类型汇总了核心方法和典型工具:
三、用 Pipeline 防止数据泄漏
数据泄漏是特征工程中最隐蔽的错误。一种常见的泄漏方式是先在全部数据上做标准化或特征选择,再划分训练/测试集——测试集的统计信息已经"混入"了训练流程。
解决方案是把所有预处理和建模步骤封装进 Pipeline,让每一步的 fit 只在训练集上执行:
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.feature_selection import SelectKBest, f_classif
from sklearn.ensemble import GradientBoostingClassifier

pipe = Pipeline([
    ('preprocess', preprocessor),              # 上文定义的 ColumnTransformer
    ('scale', StandardScaler()),
    ('select', SelectKBest(f_classif, k=20)),
    ('model', GradientBoostingClassifier(
        n_estimators=200,
        max_depth=5,
        learning_rate=0.1,
        random_state=42
    ))
])

# 交叉验证自动在每个 fold 内部执行 fit_transform
from sklearn.model_selection import cross_val_score
scores = cross_val_score(pipe, X, y, cv=5, scoring='roc_auc')
print(f"AUC: {scores.mean():.4f} ± {scores.std():.4f}")
# 示例输出:AUC: 0.8723 ± 0.0145cross_val_score 在每个 fold 内独立执行 fit→transform→predict,所有统计量(均值、方差、选择阈值等)都仅来自训练部分。四、模型调优:超参数搜索
选好特征后,下一步是找到合适的超参数。三种主流搜索方法各有适用场景:
4.1 网格搜索(GridSearchCV)
穷举所有参数组合,适用于参数空间小(如 2–3 个参数各 3–5 个值)的情况。参数数量多时计算量会指数增长。
from sklearn.model_selection import GridSearchCV

param_grid = {
    'model__n_estimators': [100, 200, 300],
    'model__max_depth': [3, 5, 7],
    'model__learning_rate': [0.05, 0.1, 0.2],
    'select__k': [10, 20, 30],
}

grid = GridSearchCV(pipe, param_grid, cv=5, scoring='roc_auc', n_jobs=-1, verbose=1)
grid.fit(X_train, y_train)

print(f"最佳参数: {grid.best_params_}")
print(f"最佳 AUC: {grid.best_score_:.4f}")
# 示例输出:
# 最佳参数: {'model__learning_rate': 0.1, 'model__max_depth': 5, ...}
# 最佳 AUC: 0.8891
4.2 随机搜索(RandomizedSearchCV)
从参数分布中随机采样固定次数,适用于参数空间大或包含连续型参数的情况。实验表明,在同等计算预算下,随机搜索通常比网格搜索找到更好的结果。
from sklearn.model_selection import RandomizedSearchCV
from scipy.stats import randint, uniform

param_distributions = {
    'model__n_estimators': randint(50, 500),
    'model__max_depth': randint(2, 10),
    'model__learning_rate': uniform(0.01, 0.3),
    'model__subsample': uniform(0.6, 0.4),
    'select__k': randint(5, 40),
}

random_search = RandomizedSearchCV(
    pipe, param_distributions, n_iter=60, cv=5,
    scoring='roc_auc', random_state=42, n_jobs=-1
)
random_search.fit(X_train, y_train)

print(f"最佳参数: {random_search.best_params_}")
print(f"最佳 AUC: {random_search.best_score_:.4f}")
4.3 贝叶斯优化(Optuna)
利用历史试验结果建立代理模型,智能选择下一组参数。在搜索次数有限时效果通常最好。需安装 pip install optuna。
import optuna
from sklearn.model_selection import cross_val_score

def objective(trial):
    params = {
        'n_estimators': trial.suggest_int('n_estimators', 50, 500),
        'max_depth': trial.suggest_int('max_depth', 2, 10),
        'learning_rate': trial.suggest_float('learning_rate', 0.01, 0.3, log=True),
        'subsample': trial.suggest_float('subsample', 0.6, 1.0),
        'min_samples_split': trial.suggest_int('min_samples_split', 2, 20),
    }
    model = GradientBoostingClassifier(**params, random_state=42)
    score = cross_val_score(model, X_train_processed, y_train, cv=5, scoring='roc_auc')
    return score.mean()

study = optuna.create_study(direction='maximize')
study.optimize(objective, n_trials=80)

print(f"最佳参数: {study.best_params}")
print(f"最佳 AUC: {study.best_value:.4f}")
五、模型调优流程与交叉验证策略
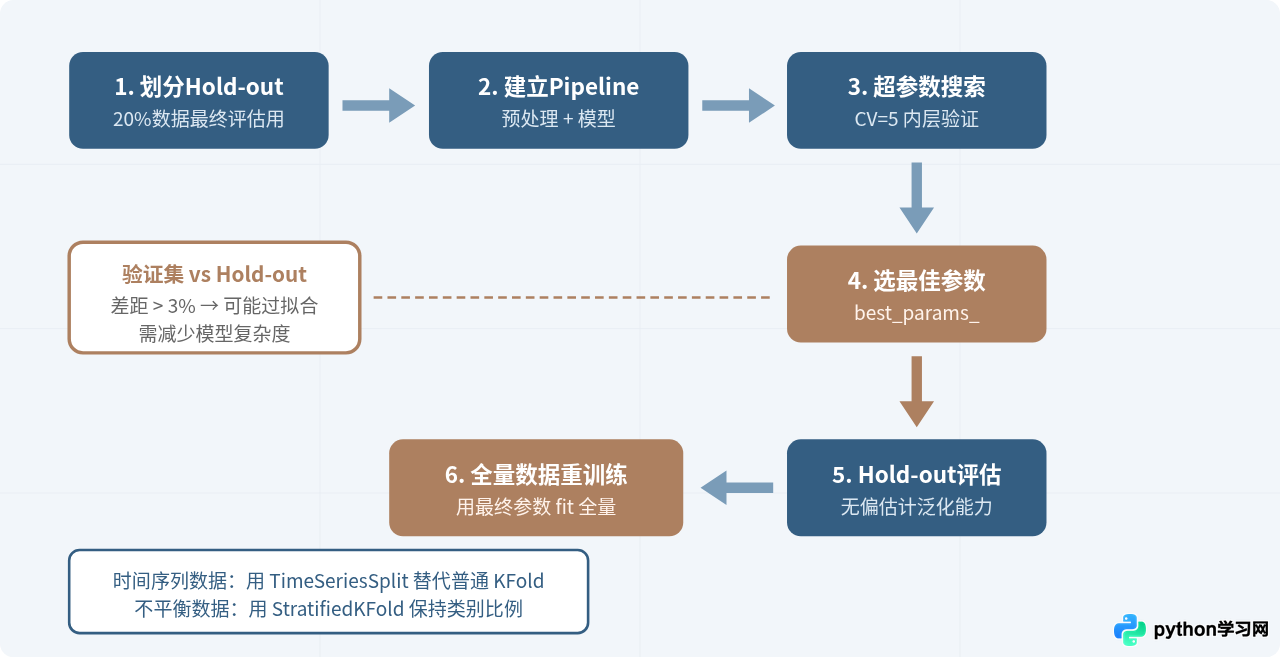
调优不是单纯找最高分,而是找到在新数据上表现稳定的参数组合。完整的调优流程如下:
5.1 交叉验证的选择
标准的 5 折交叉验证适用于大部分场景,但有两类数据需要特别注意:
- 时间序列数据:不能随机打乱,否则未来信息会泄漏到训练集。使用
TimeSeriesSplit,每次用过去的数据训练、未来的数据验证。 - 类别不平衡数据:少数类在某些 fold 中可能极少甚至没有。使用
StratifiedKFold保证每个 fold 的类别比例与整体一致。
from sklearn.model_selection import StratifiedKFold, TimeSeriesSplit

# 分类任务,类别不平衡
skf = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
scores = cross_val_score(pipe, X_train, y_train, cv=skf, scoring='roc_auc')

# 时间序列任务
tscv = TimeSeriesSplit(n_splits=5)
scores_ts = cross_val_score(pipe, X_train, y_train, cv=tscv, scoring='neg_mean_squared_error')
5.2 判断过拟合与欠拟合
调优完成后,对比以下指标:
| 场景 | 训练集分数 | 验证集分数 | 判断 | 对策 |
|---|---|---|---|---|
| A | 0.98 | 0.82 | 过拟合 | 降低 max_depth、增加正则化、减少特征数 |
| B | 0.75 | 0.73 | 欠拟合 | 增加特征、提升模型复杂度、检查数据质量 |
| C | 0.90 | 0.88 | 良好 | 进入 Hold-out 评估 |
一个实用的检查方法是画学习曲线:随训练样本量增加,训练分数和验证分数是否趋于收敛。如果两者差距大且不收敛,说明过拟合;如果两者都低,说明欠拟合。
from sklearn.model_selection import learning_curve
import numpy as np

train_sizes, train_scores, val_scores = learning_curve(
    pipe, X_train, y_train, cv=5, scoring='roc_auc',
    train_sizes=np.linspace(0.1, 1.0, 10), n_jobs=-1
)

# train_scores.mean(axis=1) 和 val_scores.mean(axis=1) 可绘制为曲线
# 两条曲线的走势反映模型状态
六、实战中的常见陷阱与解决方案
6.1 目标编码的泄漏
直接在全量数据上计算目标均值编码,测试集的标签信息会泄漏到编码中。正确做法是将编码放进 Pipeline,或在交叉验证内部用 fold-out 方式计算:
from sklearn.preprocessing import TargetEncoder

# 放进 Pipeline,自动在每个 fold 内独立 fit
pipe_with_target_enc = Pipeline([
    ('encoder', ColumnTransformer([
        ('target_enc', TargetEncoder(smooth='auto'), ['city']),
        ('num', 'passthrough', num_cols),
    ])),
    ('model', GradientBoostingClassifier(random_state=42))
])
6.2 特征选择与调优的顺序
应该把特征选择的参数(如 k)也放进搜索空间,和模型超参数一起调。分开做的问题在于:你用默认模型参数选出的特征,未必是最优模型参数下的最佳特征组合。
6.3 多重共线性
高度相关的特征(如"面积"和"面积×单价÷单价")对线性模型有害,会导致系数不稳定。检测方法是计算 VIF(方差膨胀因子),VIF > 10 通常需要处理:
from statsmodels.stats.outliers_influence import variance_inflation_factor

vif = pd.DataFrame({
    'feature': feature_names,
    'VIF': [variance_inflation_factor(X_train_processed, i)
            for i in range(X_train_processed.shape[1])]
})
print(vif.sort_values('VIF', ascending=False).head(10))
处理方式:删除 VIF 最高的特征后重新计算,直到所有 VIF 降到可接受范围;或者使用 PCA 降维;或者直接使用对共线性不敏感的树模型。
6.4 评估指标的选择
调优时选错指标比选错参数影响更大。几个关键原则:
- 二分类且正负样本均衡:accuracy 可用,但 AUC 更稳健。
- 二分类且样本不均衡:不要用 accuracy,用 AUC、F1 或 average_precision。
- 回归任务:RMSE(对大误差敏感)或 MAE(对异常值稳健),根据业务需要选择。
- 排序任务:NDCG 或 MAP。
七、完整实战示例
以下代码将以上步骤串联成一个完整的工作流。数据使用 scikit-learn 内置的乳腺癌数据集作为演示:
import numpy as np
import pandas as pd
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split, RandomizedSearchCV, StratifiedKFold
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.feature_selection import SelectKBest, mutual_info_classif
from sklearn.ensemble import GradientBoostingClassifier
from scipy.stats import randint, uniform

# 加载数据
data = load_breast_cancer()
X = pd.DataFrame(data.data, columns=data.feature_names)
y = data.target

# 划分 Hold-out 测试集
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42
)

# 构建 Pipeline
pipe = Pipeline([
    ('scale', StandardScaler()),
    ('select', SelectKBest(mutual_info_classif)),
    ('model', GradientBoostingClassifier(random_state=42))
])

# 定义搜索空间
param_dist = {
    'select__k': randint(5, 30),
    'model__n_estimators': randint(50, 400),
    'model__max_depth': randint(2, 8),
    'model__learning_rate': uniform(0.01, 0.29),
    'model__subsample': uniform(0.6, 0.4),
    'model__min_samples_split': randint(2, 15),
}

# 随机搜索 + 分层交叉验证
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
search = RandomizedSearchCV(
    pipe, param_dist, n_iter=60, cv=cv,
    scoring='roc_auc', random_state=42, n_jobs=-1
)
search.fit(X_train, y_train)

print("最佳交叉验证 AUC:", f"{search.best_score_:.4f}")
print("最佳参数:", search.best_params_)

# Hold-out 评估
from sklearn.metrics import roc_auc_score, classification_report
y_pred_proba = search.best_estimator_.predict_proba(X_test)[:, 1]
y_pred = search.best_estimator_.predict(X_test)

print(f"\nHold-out AUC: {roc_auc_score(y_test, y_pred_proba):.4f}")
print("\n分类报告:")
print(classification_report(y_test, y_pred, target_names=['恶性', '良性']))
运行后可以对比交叉验证 AUC 和 Hold-out AUC。两者差距在 1%–2% 以内说明模型泛化良好;差距过大则需要回到第五节排查过拟合。
八、总结:从数据到部署的路线图
特征工程和模型调优不是线性的一次性流程,而是一个迭代循环。下面用路线图总结全文的核心环节和决策要点:
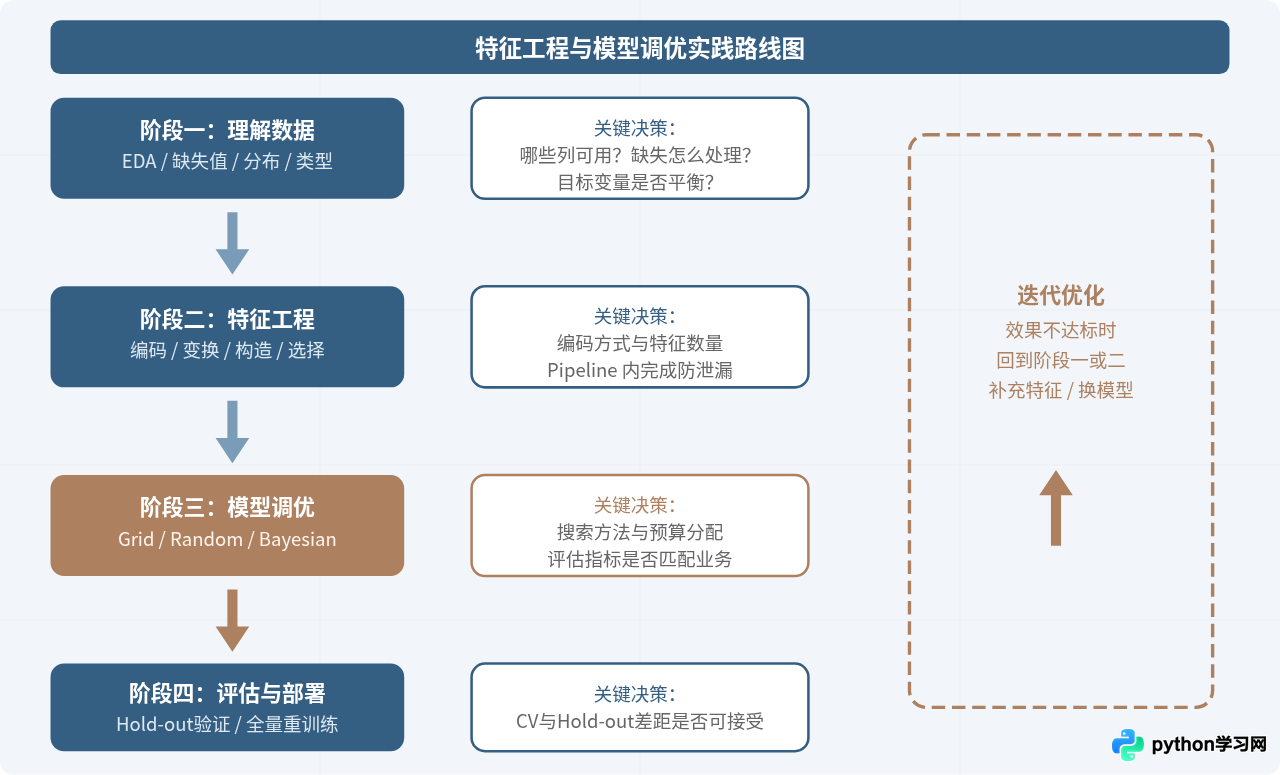
回顾全文的核心要点:
- 清洗先行:缺失值和异常值的处理直接影响后续所有步骤的质量。根据缺失比例和业务含义选择填充策略,不要机械地全用均值。
- 特征构造靠领域知识:编码方式取决于特征性质和模型类型。高基数分类用目标编码,时间特征提取周期成分,数值特征根据分布做变换。
- Pipeline 是底线:所有预处理必须放进 Pipeline,在交叉验证内部执行,杜绝信息泄漏。
- 调优要系统:参数空间小用 GridSearch,空间大或有连续参数用 RandomizedSearch 或 Optuna。特征选择的参数和模型超参数一起搜索。
- 评估要可靠:预留 Hold-out 集做最终评估,交叉验证策略要匹配数据特性(时间序列用 TimeSeriesSplit,不平衡用 StratifiedKFold)。
- 迭代是常态:一次跑通后对比训练和验证分数判断过拟合/欠拟合,不达预期就回到特征工程环节补充或调整,而不是一味增加搜索次数。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









