

Python defaultdict为何在key不存在时不抛出异常

在 Python 中,标准字典 dict 在访问一个不存在的键时会立即抛出 KeyError,而 collections.defaultdict 之所以能静默返回默认值,核心原因在于它继承自原生字典并重写实现了 __missing__(key) 特殊方法。当程序通过索引操作符 [] 查询缺失键时,底层协议会优先尝试调用该方法;defaultdict 的 __missing__ 会调用初始化时传入的工厂函数计算默认值,将新键值对直接写入字典底层并返回该值,从而免去了报错中断。
一、标准 dict 与 defaultdict 的行为差异直观呈现
在日常开发中,对字典查询缺失键是常见场景。原生 dict 严格遵循“找不到即抛出异常”的设计准则,迫使开发者显式检查键的存在性或进行捕获;而 defaultdict 则通过预定义工厂函数,将“缺失”静默转变为“初始化写入”。
# 示例 1: 标准 dict 在键不存在时报错
raw_dict = {}
try:
    print(raw_dict['counter'])
except KeyError as e:
print(f"捕获异常: KeyError - 键不存在: {e}")# 示例 2: defaultdict 在键不存在时自动赋予默认值
from collections import defaultdict
count_dict = defaultdict(int)
val = count_dict['counter']
print(f"获取到的默认值: {val}")
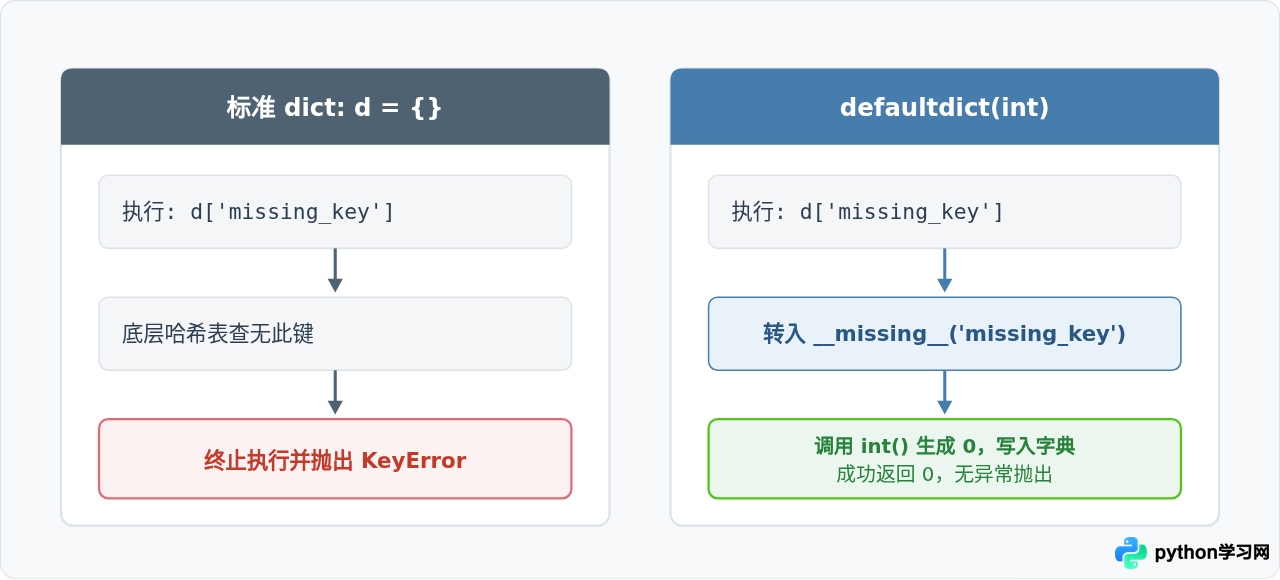
print(f"字典当前内容: {dict(count_dict)}")可以看到,count_dict['counter'] 不仅没有抛出 KeyError,反而得到了数值 0,同时键 'counter' 被持久化保存在了字典中。这种行为背后的核心逻辑如图 1 所示。
二、核心机制剖析:Python 底层的 __missing__ 协议
defaultdict 并不是某种黑盒魔法,而是 Python 语言内建数据模型的一部分。理解它的关键在于掌握两个概念:继承关系 与 __missing__ 方法。
1. 类的继承体系
collections.defaultdict 本质上是标准 dict 的直接子类。我们可以通过代码验证它的继承树:
from collections import defaultdict

print(issubclass(defaultdict, dict))  # 输出: True
这意味着 defaultdict 拥有原生字典的全部数据结构、哈希查找与存储能力。它唯一的核心扩展,就是覆盖了字典在“键找不到”时的后备逻辑。
2. __getitem__ 与 __missing__ 的底层调用链路
在 Python 中,通过方括号获取元素的操作 d[key] 会被解释器转换为对特殊方法 d.__getitem__(key) 的调用。
在 CPython 的原生实现中,dict.__getitem__ 在哈希表中未找到指定 key 时,并不会直接报出错误,而是会预先检查当前对象所属的类是否定义了 __missing__ 特殊方法:
- 如果没有定义
__missing__(例如普通的dict),立即构造并抛出KeyError(key); - 如果定义了
__missing__,则调用self.__missing__(key),并将该调用的返回值作为d[key]的最终求值结果。
3. defaultdict 中 __missing__ 的内部逻辑
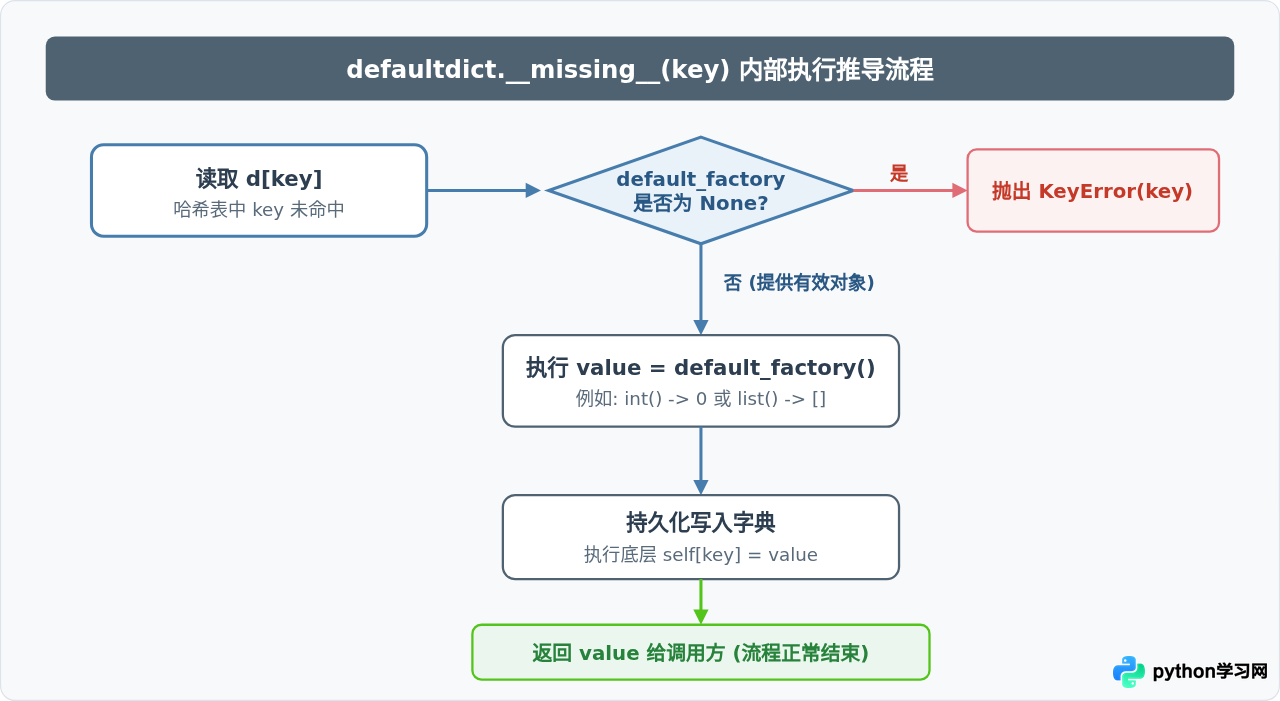
如果用等价的纯 Python 伪代码来表示 defaultdict 的内部实现,其核心运作如下:
class defaultdict(dict):
    def __init__(self, default_factory=None, *args, **kwargs):
        super().__init__(*args, **kwargs)
        self.default_factory = default_factory

    def __missing__(self, key):
        # 1. 检查工厂函数是否存在
        if self.default_factory is None:
            raise KeyError(key)

        # 2. 调用无参工厂函数生成默认值
        value = self.default_factory()

        # 3. 将新生成的键值存入当前字典
        self[key] = value

        # 4. 返回默认值
return value从这段逻辑可以看出,defaultdict 不抛出异常的前提是:default_factory 必须是一个有效的可调用对象。如果将 default_factory 设为 None,即便是 defaultdict,查询不存在的键时也依然会抛出 KeyError。
三、关键细节:索引访问 [] 与 .get() 的行为差异
很多初学者会误以为 defaultdict 在任何情况下都会自动填充默认值,这是最容易踩坑的地方之一:只有通过下标访问操作符 d[key] 时才会触发 __missing__;调用 d.get(key) 绝不会触发 __missing__!
from collections import defaultdict

data = defaultdict(list)

# 1. 使用 .get() 访问不存在的键
res_get = data.get('fruits')
print(f"data.get('fruits') 返回: {res_get}")
print(f"字典当前键列表: {list(data.keys())}")

# 2. 使用下标 [] 访问不存在的键
res_sub = data['fruits']
print(f"data['fruits'] 返回: {res_sub}")
print(f"字典当前键列表: {list(data.keys())}")为什么会出现这种差异?
因为 dict.get() 在 CPython 底层直接调用哈希查找,未找到时直接返回传入的默认参数(缺省为 None),设计上完全绕过了 __getitem__ 和 __missing__ 逻辑。同理,key in d 包含性测试也只检查哈希表中是否存在该键,不会触发 __missing__,因而不会向字典中插入新键。
四、避坑指南:必须注意的副作用与常见误区
虽然 defaultdict 简化了字典统计与聚类代码,但如果对其底层行为缺乏认知,往往会引入难以察觉的隐蔽 Bug。
1. “只读查询”变成“隐式写入”
在普通字典中,读取操作通常是幂等且无副作用的;但对 defaultdict 使用 d[key] 进行条件判断或打印查看时,只要该键原本不存在,就会在底层立刻新建并插入一个条目。
config = defaultdict(int)

# 开发者可能只是想验证是否有端口配置
if config['port'] == 8080:
    print("使用指定端口")

# 此刻 'port' 已经被悄悄添加进了字典!
print('port' in config)  # 输出: True
print(config) # 输出: defaultdict(<class 'int'>, {'port': 0})defaultdict[unknown_key] 进行条件判断,会导致字典不断膨胀,既消耗大量内存,又破坏了键集合的纯洁性。若只做查询检查,请改用 if 'port' in config: 或 config.get('port')。
2. default_factory 必须是无参可调用对象
defaultdict 的入参是生成默认值的函数本身,而不是默认值字面量。传入不可调用对象会在访问不存在键时抛出 TypeError:
# 错误用法: 直接传入字面量 0 或 []
# bad_dict = defaultdict(0)        -> 访问时报错 TypeError: 'int' object is not callable
# bad_dict = defaultdict([1, 2])   -> 访问时报错 TypeError: 'list' object is not callable

# 正确用法 1: 传入内置类型构造函数
dict_int = defaultdict(int)        # int() 返回 0
dict_list = defaultdict(list)      # list() 返回 []

# 正确用法 2: 使用 lambda 或自定义函数返回特定初始值
dict_custom = defaultdict(lambda: 100)
print(dict_custom['score'])        # 输出: 100
五、全景总结与技术选型决策
在 Python 中处理可能缺失的键时,语言提供了多种机制。下表展示了它们在触发机制、是否修改字典及典型应用场景上的清晰对比:
| 处理方式 | 语法形式 | 触发机制 | 缺失时的副作用 | 最适合的业务场景 |
|---|---|---|---|---|
| 原生 dict 下标 | d[key] |
直接寻址 | 无修改,抛出 KeyError |
确定键必须存在,缺失视为程序错误 |
| dict.get() | d.get(key, default) |
方法调用 | 无修改,返回备用值 | 只读探测、配置项读取、容错展示 |
| dict.setdefault() | d.setdefault(key, val) |
方法调用 | 有修改,就地插入 val |
偶发性初值设定,无需全局绑定工厂 |
| collections.defaultdict | d[key] |
__missing__ 协议 |
有修改,自动调用工厂写入 | 高频数据分组、嵌套统计、图邻接表构建 |
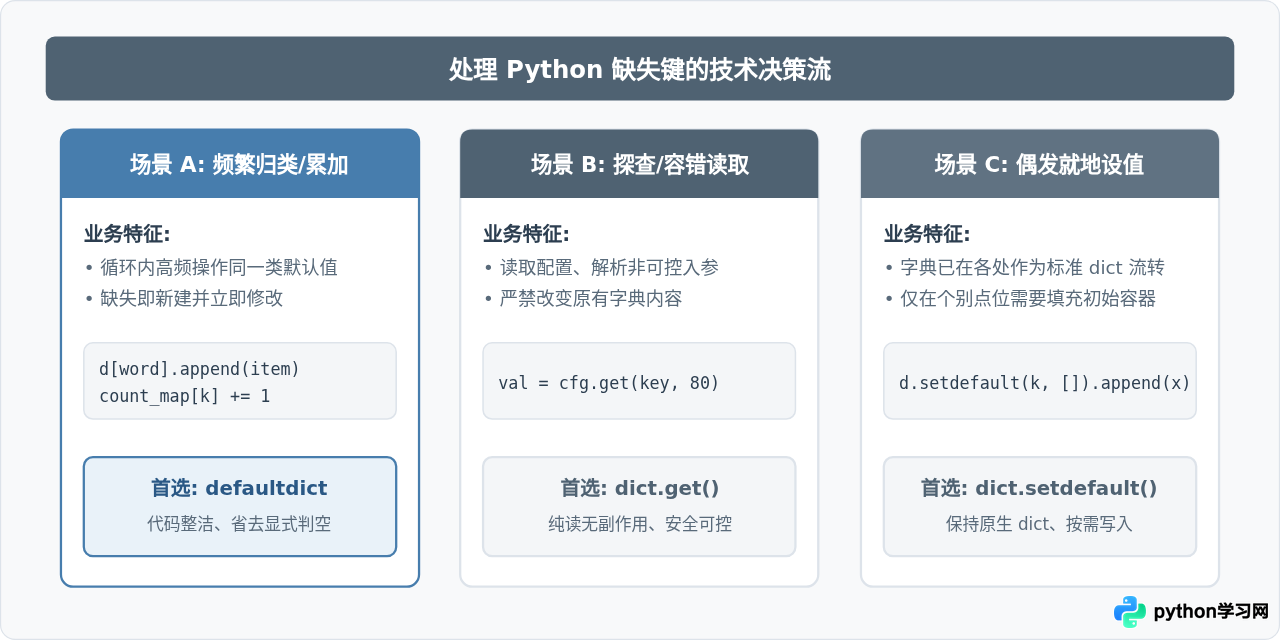
总结而言,defaultdict 之所以能够在 key 不存在时不抛出异常,本质上是依托于 Python 的 __missing__ 钩子协议。这一优雅的设计既保留了标准字典高效的哈希寻址能力,又赋予了开发者高度灵活的缺省值初始化体验。在实际工程中,只需分清 [] 与 .get() 的职责边界,即可写出兼具安全性与表现力的优秀 Python 代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









