

怎么用Python脚本快速提取网页图片并批量下载
本文详细讲解如何使用Python编写脚本批量提取并下载网页中的图片,涵盖网页请求、DOM解析定位、URL规范化补全、流式持久化存储以及线程池并发加速等实用技术与避坑技巧。
一、整体处理管线与核心逻辑
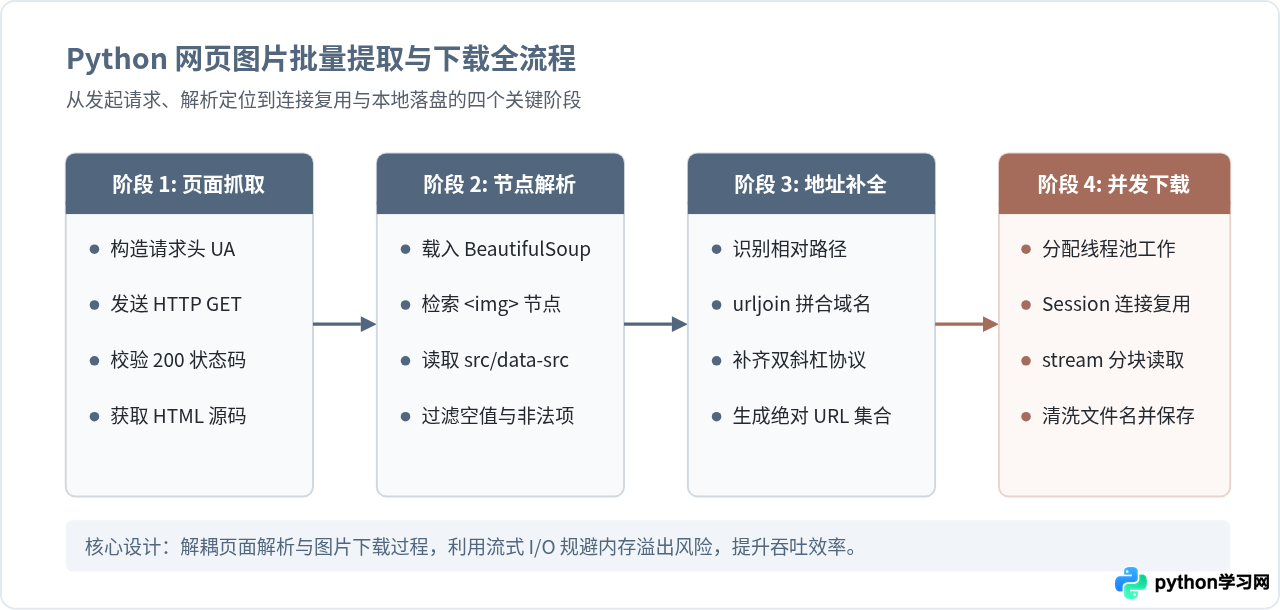
手动右键逐张保存网页图片在图片数量较多时效率极其低下。利用 Python 脚本进行自动化提取时,程序并不需要启动臃肿的浏览器渲染引擎,而是直接模拟 HTTP 客户端向目标地址发起请求,并在解析得到的 DOM 结构中批量定位图片标签。
整个流程由以下四个标准环节构成:通过网络库获取目标页面的文本内容;借助 HTML 解析器查找所有的 <img> 标签及其相关属性;将可能存在的相对地址或缺少协议头的链接统一转换为完整的 URL;最后分配工作单元,将二进制图片数据流式写入本地存储。
二、依赖环境与前置准备
执行该任务通常依赖两个成熟且稳定的第三方库:用于发起网络请求的 requests,以及用于遍历解析 HTML 结构的 beautifulsoup4。此外,还需要用到 Python 3 已经内置的标准库 os、re、urllib.parse 和 concurrent.futures。
在终端或命令行环境中执行以下命令安装外部依赖:
pip install requests beautifulsoup4安装完成后,检查 Python 版本是否在 3.7 及以上,即可开始编写业务逻辑。
三、精准提取与 URL 规范化补全
初学者在编写抓取脚本时,最容易遇到的问题是提取到的图片地址无法直接请求。现代网页中的图片地址写法各异,通常包括以下四种形式:
- 完整绝对路径:如
https://example.com/static/pic.jpg,这类可以直接访问; - 根相对路径:如
/images/banner.png,缺少协议和域名; - 协议相对路径:如
//cdn.domain.com/photo.webp,省略了具体的传输协议; - 懒加载占位属性:为了首屏加载速度,许多网站将真实图片链接写在
data-src或data-original中,而把src设为 1 像素的空白透明图。
为了保证图片能够被顺利下载,必须在解析阶段对所有获取到的链接进行规范化补全与过滤:
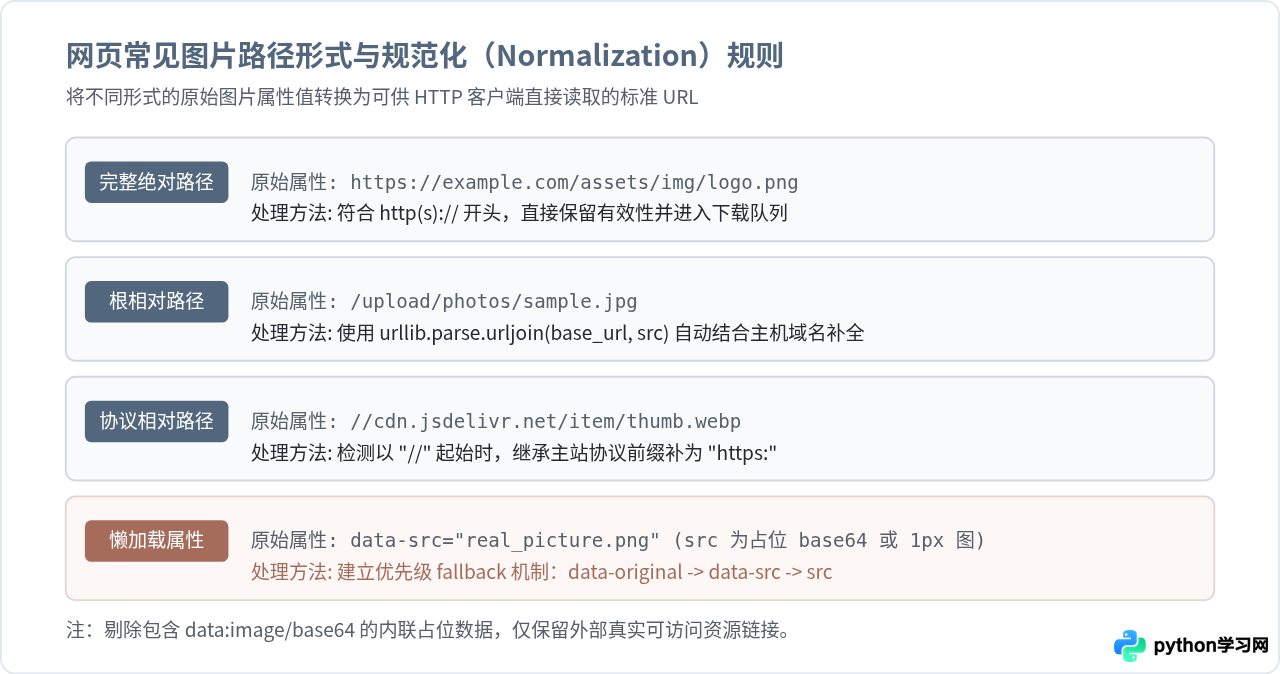
通过 Python 的 urllib.parse.urljoin 函数,可以自动根据当前页面的完整基准 URL 解析所有相对路径,省去了手动判断斜杠和主机的繁琐操作。
四、文件命名净化与流式下载设计
在向本地磁盘写入抓取到的图片时,直接从 URL 中截取的文件名往往带有 URL 查询参数(例如 image.png?v=1.2&size=large),或者包含本地操作系统禁止的特殊字符(如 \ / : * ? " < > |)。如果不加处理,程序会抛出 OSError: Invalid argument 异常。
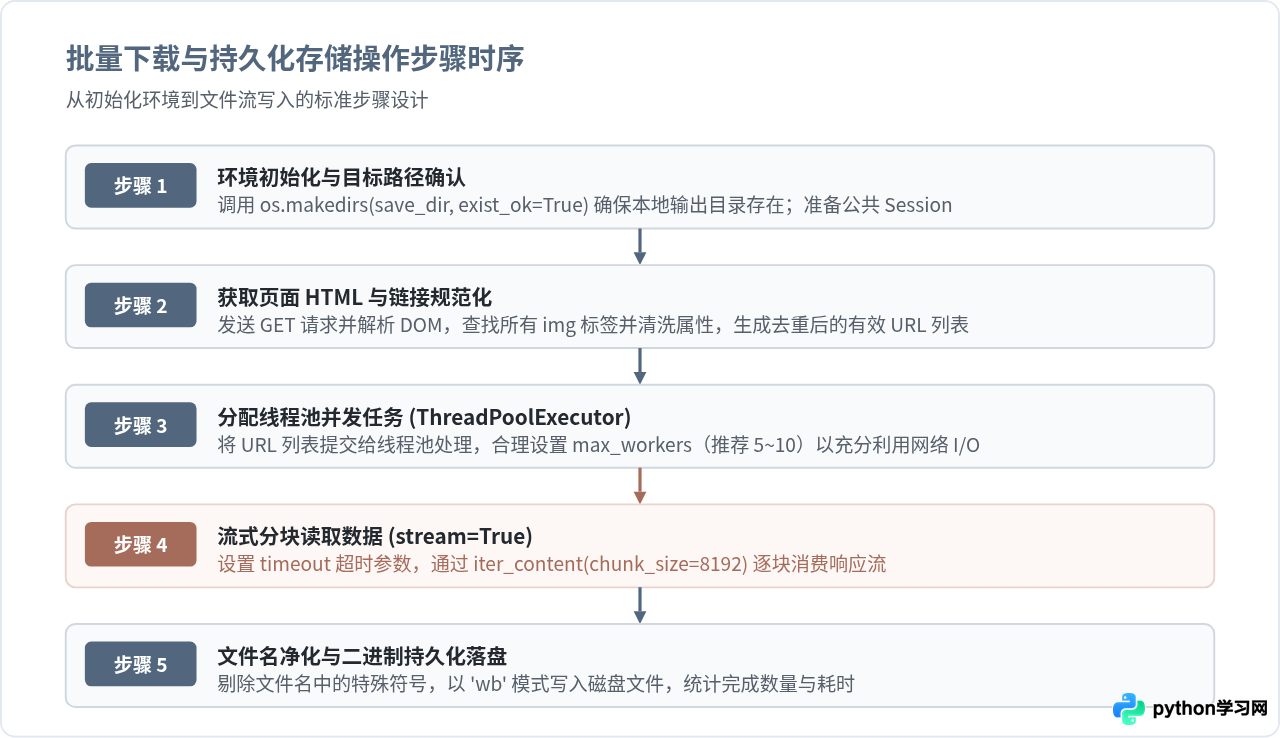
此外,下载时应避免使用 response.content 一次性把整张图片读入内存。如果网页中存在高清大图或大量图片,瞬间的内存峰值容易拖慢整个系统的运行速度。推荐的方式是开启 stream=True,按 8KB 的数据块(chunk)分批写入文件对象。
五、多线程并发加速与完整实现代码
图片下载是典型的网络 I/O 密集型操作。单线程循环下载需要等待前一张图片完全传输完毕才能开始下一张,面对几十上百张图片时耗时显著。借助 Python 标准库中的 concurrent.futures.ThreadPoolExecutor,可以以很低的代码量实现并发下载。
结合 requests.Session() 进行网络连接复用(Keep-Alive),避免了每张图片都重复建立 TCP 握手的开销。以下是包含完整错误处理与进度统计的代码实现:
import os
import re
from urllib.parse import urljoin, urlparse
from concurrent.futures import ThreadPoolExecutor, as_completed
import requests
from bs4 import BeautifulSoup

def sanitize_filename(url, index, default_ext=".jpg"):
    """
    清洗图片 URL 提取合法文件名,防止非法字符导致写入失败。
    """
    parsed = urlparse(url)
    raw_name = os.path.basename(parsed.path)

    # 移除查询参数部分并过滤非法字符
    clean_name = re.sub(r'[\\/*?:"<>|]', "", raw_name)

    # 若文件名过短或没有扩展名,以序列索引命名
    if not clean_name or "." not in clean_name:
        clean_name = f"image_{index:03d}{default_ext}"
    else:
        name_part, ext_part = os.path.splitext(clean_name)
        clean_name = f"{index:03d}_{name_part[:30]}{ext_part}"

    return clean_name

def extract_image_urls(page_url, session):
    """
    请求网页并解析所有 img 标签,返回去重后的绝对 URL 列表。
    """
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
                      "(KHTML, like Gecko) Chrome/118.0.0.0 Safari/537.36",
        "Referer": page_url
    }

    response = session.get(page_url, headers=headers, timeout=10)
    response.raise_for_status()
    response.encoding = response.apparent_encoding

    soup = BeautifulSoup(response.text, "html.parser")
    found_urls = []

    for img in soup.find_all("img"):
        # 兼容普通 src 与常见懒加载属性
        src = (img.get("data-original") or
               img.get("data-src") or
               img.get("src") or "").strip()

        # 排除空地址或内联 base64
        if not src or src.startswith("data:image"):
            continue

        # 协议补齐与相对路径转绝对路径
        if src.startswith("//"):
            src = "https:" + src
        else:
            src = urljoin(page_url, src)

        found_urls.append(src)

    # 去重并保持顺序
    return list(dict.fromkeys(found_urls))

def download_single_image(session, img_url, save_path, referer, timeout=10):
    """
    使用流式响应下载单张图片并写入磁盘。
    """
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
                      "(KHTML, like Gecko) Chrome/118.0.0.0 Safari/537.36",
        "Referer": referer
    }

    try:
        with session.get(img_url, headers=headers, stream=True, timeout=timeout) as resp:
            resp.raise_for_status()
            with open(save_path, "wb") as f:
                for chunk in resp.iter_content(chunk_size=8192):
                    if chunk:
                        f.write(chunk)
        return True, img_url, save_path
    except Exception as e:
        return False, img_url, str(e)

def batch_download_images(page_url, output_dir="downloaded_images", max_workers=5):
    """
    并发批量下载网页所有图片的主调度函数。
    """
    os.makedirs(output_dir, exist_ok=True)

    with requests.Session() as session:
        print(f"[*] 正在抓取页面: {page_url}")
        image_urls = extract_image_urls(page_url, session)
        total_count = len(image_urls)
        print(f"[*] 成功解析到 {total_count} 个图片链接")

        if total_count == 0:
            print("[!] 未找到可下载的图片链接,程序退出。")
            return

        success_count = 0
        fail_count = 0

        print(f"[*] 启动线程池(并发数={max_workers})开始下载...")
        with ThreadPoolExecutor(max_workers=max_workers) as executor:
            future_to_url = {}
            for idx, img_url in enumerate(image_urls, start=1):
                filename = sanitize_filename(img_url, idx)
                dest_path = os.path.join(output_dir, filename)

                future = executor.submit(
                    download_single_image, session, img_url, dest_path, page_url
                )
                future_to_url[future] = img_url

            for future in as_completed(future_to_url):
                success, target_url, msg = future.result()
                if success:
                    success_count += 1
                    print(f"[OK] 已保存: {os.path.basename(msg)}")
                else:
                    fail_count += 1
                    print(f"[FAIL] 下载失败: {target_url},原因: {msg}")

        print(f"\n[任务完成] 共 {total_count} 张,成功 {success_count} 张,失败 {fail_count} 张。")
        print(f"[*] 存储目录: {os.path.abspath(output_dir)}")

if __name__ == "__main__":
    # 替换为待抓取的实际网页目标地址
    TARGET_PAGE = "https://example.com"
batch_download_images(TARGET_PAGE, output_dir="./my_images", max_workers=6)python download_images.py。输出结果会清晰展示解析出的图片总数、每张图片落盘时的文件名,以及最终的成功与失败统计。
六、常见边界场景与排查避坑指南
在实际使用中,目标站点的反爬措施和渲染机制可能会让上述基础流程受阻。遇到问题时,可对照以下要点进行排查:
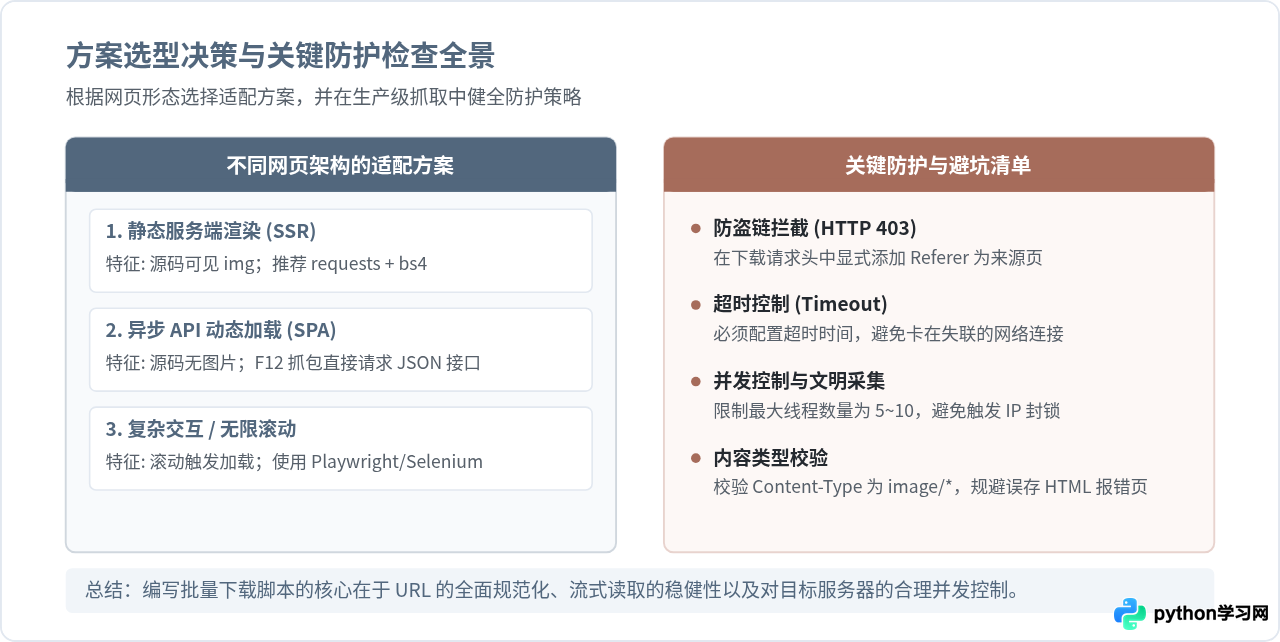
- 网页使用了动态渲染(SPA):若在浏览器中右键“查看网页源代码”搜不到目标图片链接,说明该页面的图片是通过前端 JavaScript 异步拉取的。此时先在浏览器控制台(F12)的 Network 标签页中筛选
Fetch/XHR,往往能直接发现返回图片列表的 JSON 数据接口;只有在接口参数被高强度加密时,才需要考虑引入 Playwright 或 Selenium。 - 遭遇 HTTP 403 Forbidden(防盗链):这是很多 CDN 采用的保护措施。务必在下载图片的请求头中添加
Referer: 目标网页URL,让服务器认为这是在站内正常浏览时发起的加载请求。 - 单图下载阻塞整体进度:务必给所有网络请求(包括页面抓取和图片下载)指定显式的
timeout。若未指定该参数,在网络连接异常挂起时,对应工作线程会无限期等待,进而导致整个脚本卡死。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









