

Python切片[::2]与[1::2]怎么用双冒号隔项取值
深入解析Python切片中双冒号隔项取值的核心机制,对比[::2]与[1::2]提取偶数与奇数索引元素的区别,配合图解与代码示例掌握步长原理与避坑要点。
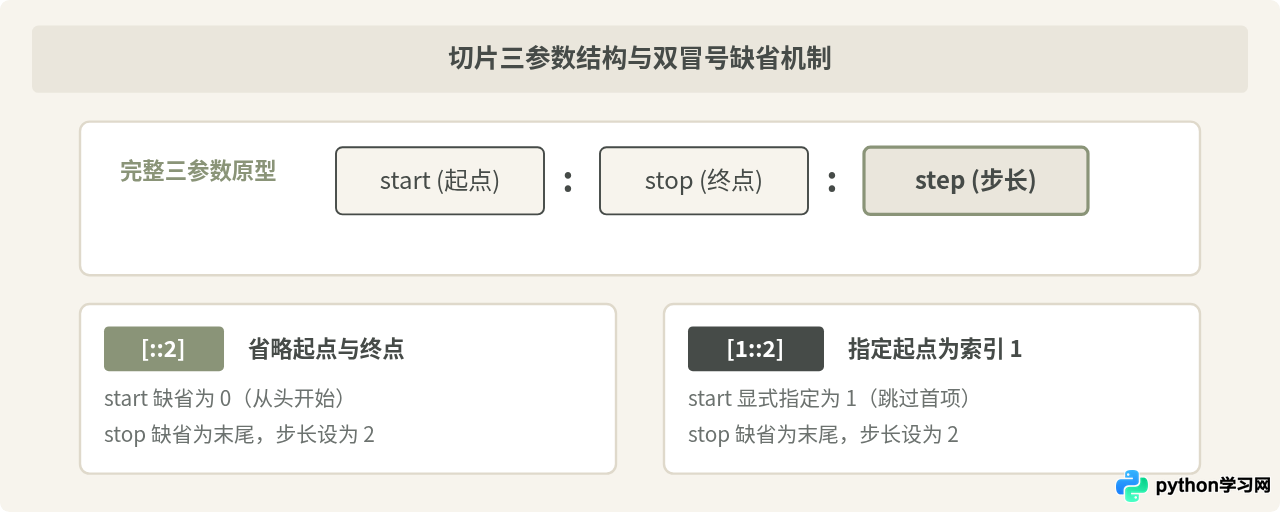
sequence[start:stop:step]。当省略终止边界且连续书写两个冒号时,第二冒号后填写的数字代表“步长”(step)。表达式 [::2] 表示从索引 0 开始、以步长 2 遍历序列,提取所有偶数索引项(第 1、3、5…… 项);而 [1::2] 则明确指定从索引 1 开始、以步长 2 遍历,提取所有奇数索引项(第 2、4、6…… 项)。
一、切片基础:双冒号“::”从何而来
Python 序列对象(包括列表 list、字符串 str、元组 tuple 等)均支持切片操作。最基础的切片往往只使用一个冒号,如 a[1:4],表示截取从索引 1 到索引 3 的连续元素。
当需要跳跃式提取或反向提取数据时,就需要引入第三个控制参数——步长(step)。完整的切片语法由三个分量组成:
sequence[start:stop:step]这三个参数都具备缺省默认值:
- start(起始索引):在正向步长下,默认值为
0(序列头部); - stop(结束索引):默认截取到序列末尾(包含最后一个元素);
- step(步长):默认值为
1,即逐个连续读取。
当我们不需要限制起始位置和结束位置,仅想调整提取的步长跨度时,可以同时省略 start 与 stop。由于语法必须保留参数位置的分隔符,原本放置参数的地方留空,两个连续的冒号 :: 便由此形成。
二、[::2] 的用法:从索引 0 开始隔项取值
当执行 data[::2] 时,Python 会按照以下规则取样:
- 以起始默认值
0为首个提取项; - 之后每次将当前索引累加
2,依次提取索引0, 2, 4, 6, 8...处的值; - 直到索引超出序列最大有效范围后平滑停止。
来看一组典型的数据测试示例:
# 示例 1:对数字列表隔项取值
numbers = [10, 20, 30, 40, 50, 60, 70]
even_indexed = numbers[::2]
print(even_indexed)
# 示例输出:[10, 30, 50, 70]

# 示例 2:对英文字符串隔项抽样
text = "ABCDEFG"
sub_text = text[::2]
print(sub_text)
# 示例输出:'ACEG'
在上述例子中,列表 numbers 索引 0 的值为 10,索引 2 的值为 30,索引 4 的值为 50,索引 6 的值为 70。因此 numbers[::2] 抓取出的就是这四个元素。
三、[1::2] 的用法:从索引 1 开始隔项取值
如果在第一个冒号前写入 1,即 data[1::2],表示强制将扫描起点设在索引 1 处:
- 首个提取项为索引
1; - 之后每次将当前索引累加
2,依次提取索引1, 3, 5, 7, 9...处的值; - 直到序列终止。
# 示例 1:提取奇数索引项
numbers = [10, 20, 30, 40, 50, 60, 70]
odd_indexed = numbers[1::2]
print(odd_indexed)
# 示例输出:[20, 40, 60]

# 示例 2:提取字符串中的第二组交替字符
text = "ABCDEFG"
sub_text_odd = text[1::2]
print(sub_text_odd)
# 示例输出:'BDF'
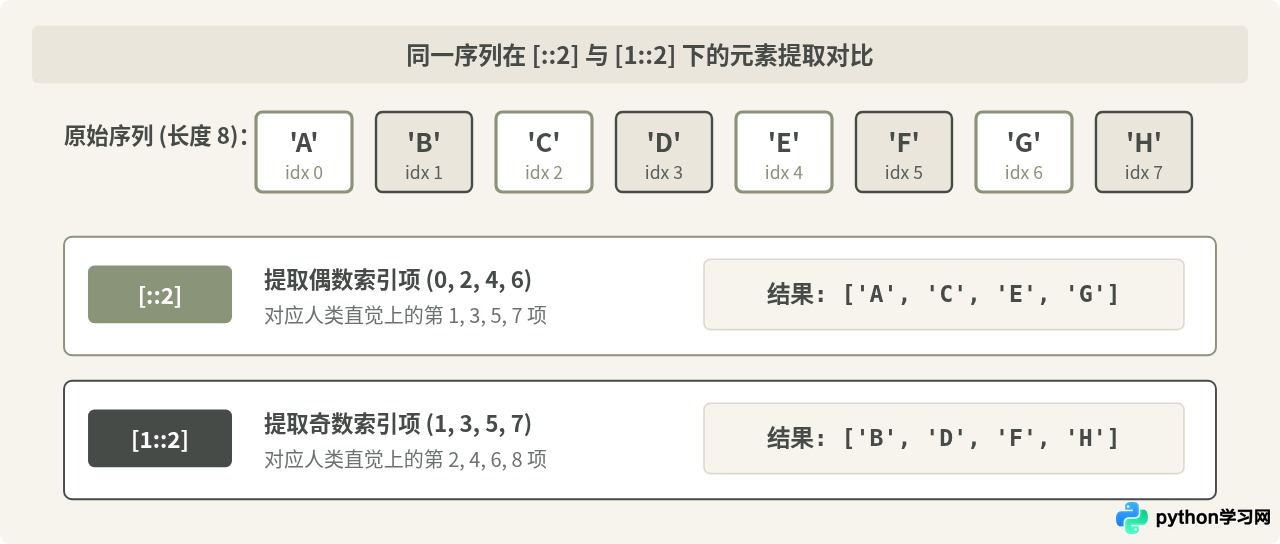
对比两个结果可以直观发现:[::2] 与 [1::2] 恰好构成了一组互补的交替分割,两者将原序列完整无重叠地拆分成了两组子序列。
四、核心辨析:“奇数项”与“奇数索引”的常见认知偏差
在实际编程交流中,经常会听到“我想用切片取列表里的奇数项”这类需求。然而,许多初学者在此处容易写出逻辑相反的代码。造成混淆的根源在于日常语言的序数习惯与计算机的 0 基索引(Zero-based indexing)之间的差异。
| 元素位置 | 日常语言序数 | Python 内部索引 | 归属切片表达式 |
|---|---|---|---|
| 第一个元素 | 第 1 项(奇数项) | 索引 0(偶数) | [::2] |
| 第二个元素 | 第 2 项(偶数项) | 索引 1(奇数) | [1::2] |
| 第三个元素 | 第 3 项(奇数项) | 索引 2(偶数) | [::2] |
| 第四个元素 | 第 4 项(偶数项) | 索引 3(奇数) | [1::2] |
如果你的需求是“保留第一个元素,然后隔一个取一个”(即取第 1、3、5…… 项),必须使用 [::2];如果需求是“跳过第一个元素,从第二个开始隔一个取一个”(即第 2、4、6…… 项),才使用 [1::2]。切勿仅凭字面“奇数”二字直接盲写 1 作为开头。
五、隔项取值的内部执行机制与计算流程
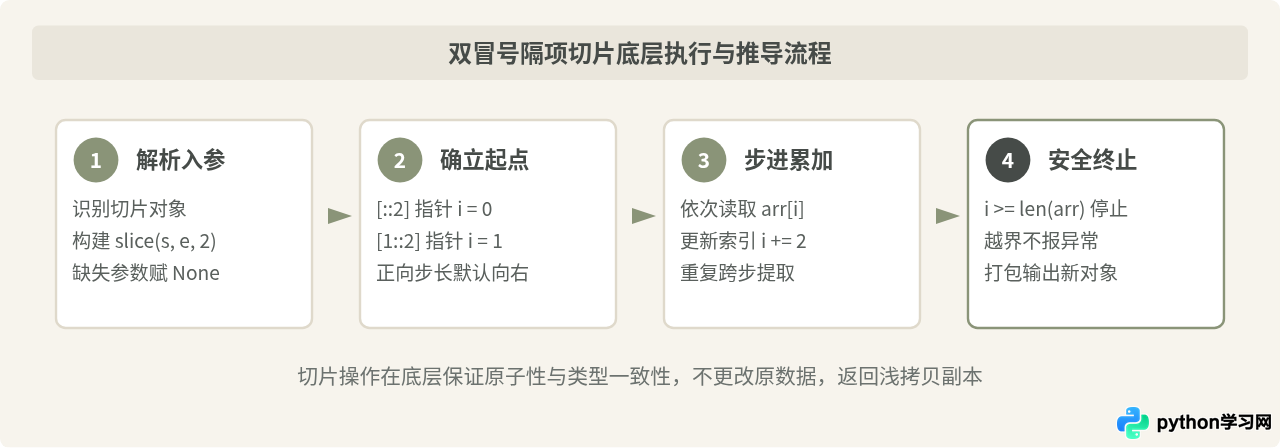
Python 在解释 sequence[start:stop:step] 时,底层是通过内置的 slice 类及其 indices() 方法完成边界规范化计算的。无论是 [::2] 还是 [1::2],其运算步骤可以明确抽象为四个阶段:
- 解析参数:未声明的位置由解释器填充
None,例如[::2]等价于slice(None, None, 2); - 确定初始指针:若步长为正且
start为None,则指针初始指向 0;若显式指定(如 1),则指针置为 1; - 步进循环生成:每次访问当前指针元素,并将指针值增加
step(此处为 2); - 越界安全截断:当指针值达到或超过序列长度时,循环安全终止,构造并返回一个全新的切片容器。
六、进阶技巧与注意事项
1. 越界安全性:切片与直接下标访问的区别
在 Python 中,如果直接使用单个索引访问超出范围的元素(例如对长度为 3 的列表访问 data[5]),解释器会抛出 IndexError: list index out of range 异常。
但双冒号切片具备容错截断机制。即使起始位置指定超出了列表长度,Python 也会安全地返回一个空列表,而不会中断程序运行:
short_list = [1, 2]
# 起始索引为 10,远超列表最大长度
result = short_list[10::2]
print(result)
# 示例输出:[]
2. 浅拷贝特性与内存隔离
切片运算产生的是原序列的一个浅拷贝(Shallow Copy)副本。对切片得到的新列表进行增删元素,绝对不会反向污染原列表。但在包含嵌套可变对象(如列表中的子列表或字典)时,内层引用依然保持共享。
original = [1, 2, 3, 4]
sub = original[::2]
sub.append(999)

print("新列表:", sub)
# 示例输出:新列表: [1, 3, 999]
print("原列表:", original)
# 示例输出:原列表: [1, 2, 3, 4] (未受任何影响)
3. 负步长的扩展:倒序隔项取值
步长不仅可以为正数,还可以是负数。负步长意味着“从右向左”反向抽取。最常用的 [::-1] 用于完整反转序列,而类似 [::-2] 则表示从序列最末尾开始倒序隔项提取:
data = [0, 1, 2, 3, 4, 5]
# 从末尾元素开始,向左每隔 2 项抽取一次
print(data[::-2])
# 示例输出:[5, 3, 1]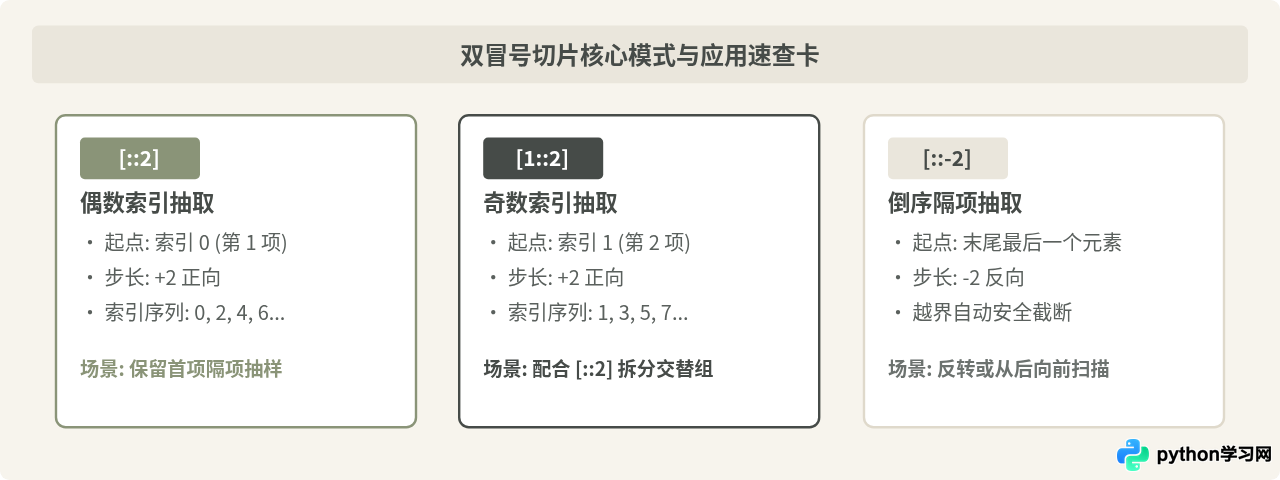
七、总结
Python 切片中的双冒号语法并不是特殊的关键字或独立运算符,而是省略了常规起始与终止参数后保留下来的语法格式。记住以下要点即可在日常开发中准确使用:
- 双冒号后面的数字决定步长与方向,正数表示从左到右,负数表示从右到左。
[::2]默认从第 0 个索引出发,提取的是偶数索引项(即第 1、3、5 项)。[1::2]显式指定从第 1 个索引出发,提取的是奇数索引项(即第 2、4、6 项)。- 两者结合能够轻松实现奇偶位置拆分、交替数据抽样等功能,且具备切片天生的越界安全性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









