

Python中from numpy import *有什么风险
深入剖析在Python代码中使用from numpy import *带来的核心风险,包括命名空间污染、静默覆盖Python内置函数、多库符号冲突与维护困难,并给出从星号导入安全迁移至标准规范的具体步骤。
在Python开发中,使用 from numpy import *(通配符导入或星号导入)看似省去了每次调用数组操作时输入 np. 前缀的麻烦,但在实际生产与团队协作中,这是一种公认的高危写法。其核心风险在于:它会无节制地将NumPy顶级命名空间下的600多个符号全量倾倒至当前模块的全局作用域中,引发严重的命名空间污染、静默覆盖Python的原生内置函数,并彻底破坏现代IDE的代码补全与静态检查能力,最终为系统埋下极难排查的逻辑隐患。
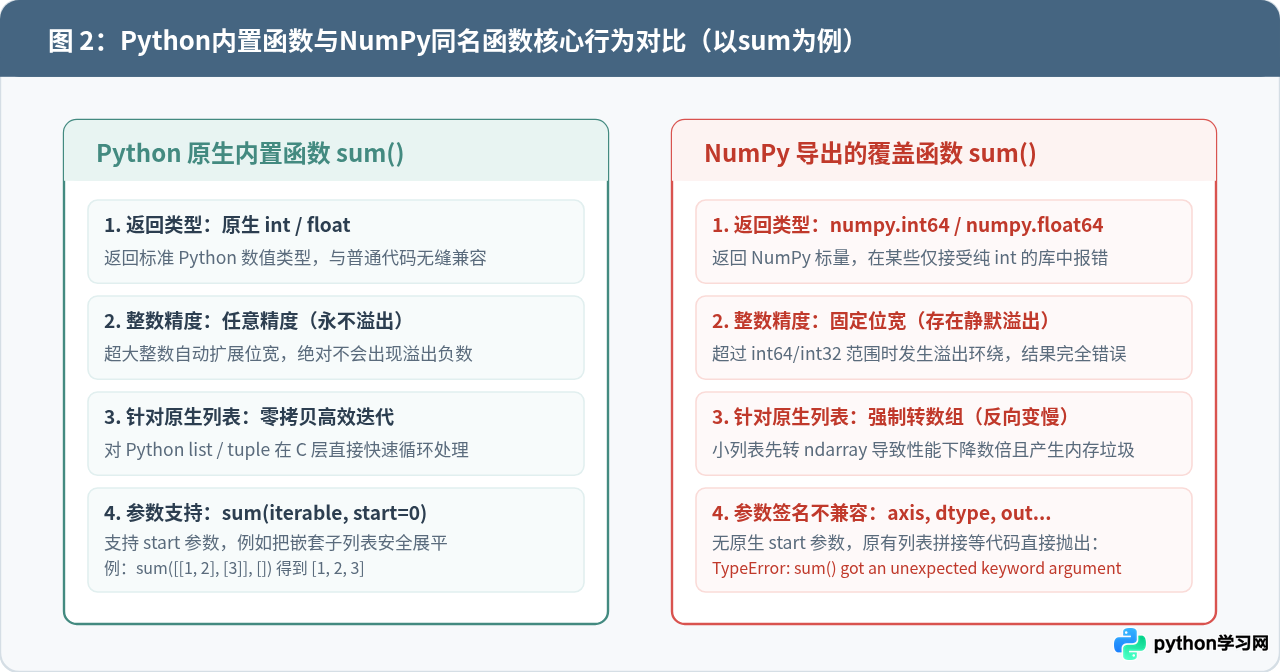
一、命名空间污染:600余个符号的无差别注入
Python的模块导入设计初衷是维持各自独立的命名空间。当执行 import numpy as np 时,NumPy内部的所有函数与对象都安全地收拢在 np 这个单一名称之下,当前脚本的 globals() 字典只增加了一个引用。
而一旦使用 from numpy import *,Python会将NumPy模块导出的全部公开符号直接复制到当前模块的全局命名空间中。在当前的NumPy稳定版本中,顶层暴露的符号数量超过600个。这意味着你原本清晰简洁的代码空间瞬间充斥着海量的数学函数、数据类型、常数和内部辅助函数。
这种无差别注入破坏了代码的自解释性。任何维护该文件的开发者阅读到 dot(a, b) 或 sin(x) 时,都无法直接判断这是当前文件自定义的业务方法、来自标准数学库 math,还是来自NumPy。更严重的是,现代编辑器与静态代码检查器(如 Ruff、Flake8、Pylance)会抛出 F403(星号导入导致无法检测未定义名称)和 F405 警报,无法判断某个变量究竟是有效引用还是打错了名字的拼写错误。
二、致命隐患:静默覆盖 Python 原生内置函数
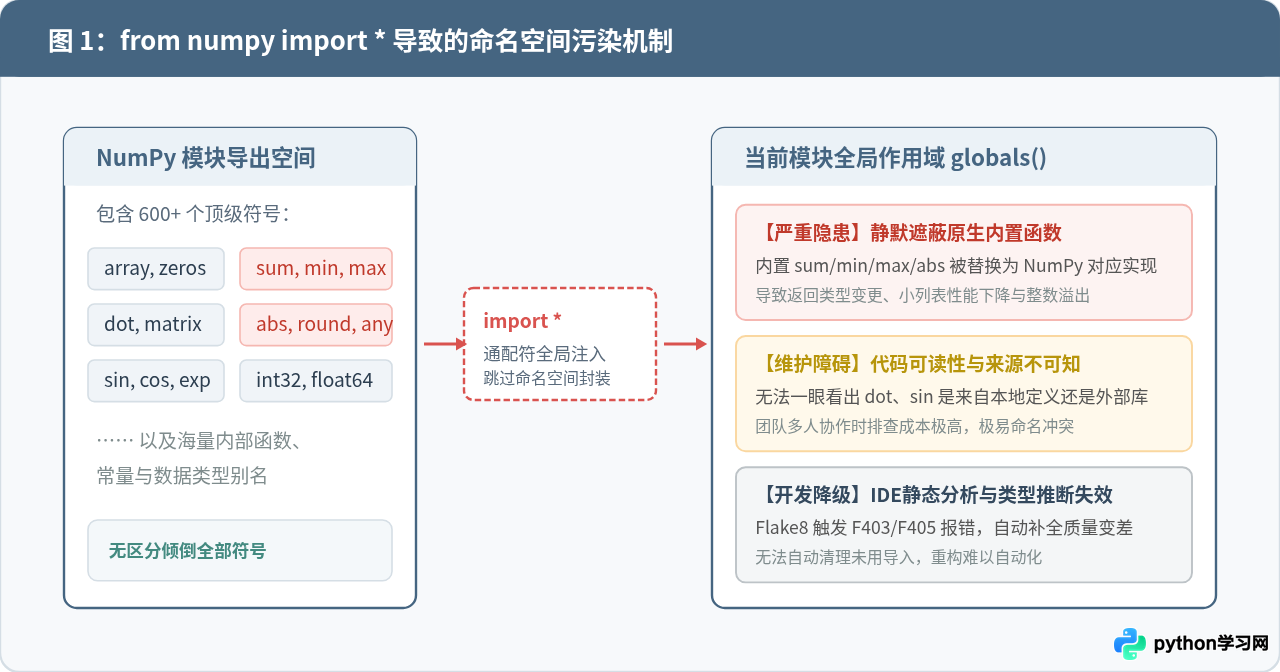
NumPy 中为了支持针对多维数组的高效向量化统计,实现了许多与 Python 原生内置函数同名的函数。例如:sum、min、max、abs、round、all、any 以及 pow。
当执行了 from numpy import * 之后,当前模块中的内置函数会被直接覆盖。此时调用 sum([1, 2, 3]) 执行的不再是 Python 内置的 builtins.sum,而是 numpy.sum。这种静默覆盖会带来四个极其隐蔽且破坏性极强的后果:
1. 返回值类型改变引发下游崩溃
Python 原生的 sum() 处理整型序列时返回的是标准的 Python int。但 numpy.sum() 返回的是 NumPy 标量对象(例如 numpy.int64 或 numpy.int32)。尽管很多数学运算符可以互相通用,但在遇到对类型要求严格的场景时就会报错:
from numpy import *

result = sum([10, 20, 30])
print(type(result))  # 输出 <class 'numpy.int64'>

import json
# 在某些老旧版本或纯标准类型限定的环境下,序列化非纯原生类型可能抛出异常:
# TypeError: Object of type int64 is not JSON serializable
2. 固定位宽整型引发“静默溢出”
在 Python 3 中,原生 int 是任意精度的长整型,无论数字累加到多大,都不会发生溢出。然而,NumPy 优先使用 C 语言层级的定长整数(通常是 64 位或 32 位)。一旦累加的大数超过该范围,NumPy 会发生算术溢出并环绕变为负数,且在默认配置下不会抛出任何异常,导致计算结果彻底失真:
# 原生 Python sum:正确处理大数累加
big_list = [2**62, 2**62, 2**62]
print(sum(big_list))  # 正常输出:13835058055282163712

# 引入星号后覆盖了 sum:
from numpy import *
print(sum(big_list))  # 在部分平台上发生溢出,输出负数或截断值!
3. 原生列表计算性能的反向暴跌
很多开发者误以为“NumPy速度快,所以用NumPy的sum算列表也一定更快”,事实恰恰相反。Python 原生 sum() 在处理纯 Python 列表时是在 C 层直接遍历链表指针,效率极高。而 numpy.sum() 接收到一个纯 Python 列表时,必须先将整个列表转换为一个内部的 ndarray 临时对象,再调度底层内核。对于中小型列表,这种内存分配和数据复制开销会导致执行耗时比原生函数慢数倍到十几倍。
4. 参数签名不兼容导致既有逻辑直接报错
Python 原生 sum(iterable, /, start=0) 支持通过 start 参数实现特殊累加,例如将多个子列表拼接为一个扁平列表:sum([[1, 2], [3, 4]], [])。但 numpy.sum(a, axis=None, dtype=None, out=None, ...) 的签名完全不同,如果将嵌套列表传给它并试图指定初始值,会直接报 TypeError: sum() got an unexpected keyword argument。
三、加载顺序灾难与局部符号冲突
除了覆盖内置函数,星号导入还会在与其他第三方库或本地变量混合使用时产生“顺序耦合”。
最典型的例子是与标准库 math 的冲突。考虑以下两行代码:
from math import *
from numpy import *

# 此时使用的是 numpy.sin,传入列表可执行向量计算:
sin([0.0, 1.57])
如果在另一次代码格式化或重构中,导入语句的先后顺序被调整为:
from numpy import *
from math import *

# 此时使用的变成 math.sin,传入列表会直接崩溃:
sin([0.0, 1.57])  # TypeError: must be real number, not list
一段业务代码是否报错,居然取决于头部两条无关 import 语句的排列顺序,这在工程上是不可接受的灾难。此外,NumPy 中包含了大量常见单词作为符号,如 mean、var、matrix、copy、type。开发者在编写业务逻辑时,极易不小心将其作为普通变量赋值(如 copy = True 或 type = "user"),从而破坏了该名字的原有功能,在后续调用时报出 'str' object is not callable 错误。
四、工程维护与团队协作成本
Python 官方编码规范 PEP 8 中明确指出:Wildcard imports (from <module> import *) should be avoided, as they make it unclear which names are present in the namespace, confusing both readers and many automated tools.(应当避免使用通配符导入,因为它们使命名空间中存在的名称变得不明确,同时会迷惑读者和众多自动化工具。)
在多人协同的代码库中,星号导入不仅让代码审查(Code Review)难以推进,更给依赖升级埋下了“定时炸弹”。例如,当项目升级 NumPy 次版本时,NumPy 可能会在顶级命名空间中新增若干功能函数。如果新增的函数名称恰巧与你之前代码里定义的某个全局变量或工具函数重名,升级后该模块就会被静默覆盖,引发诡异的线上故障。
五、消除星号导入的四步安全重构指南
如果现有代码中已经存在 from numpy import *,可以通过以下四个步骤进行无风险的安全重构:
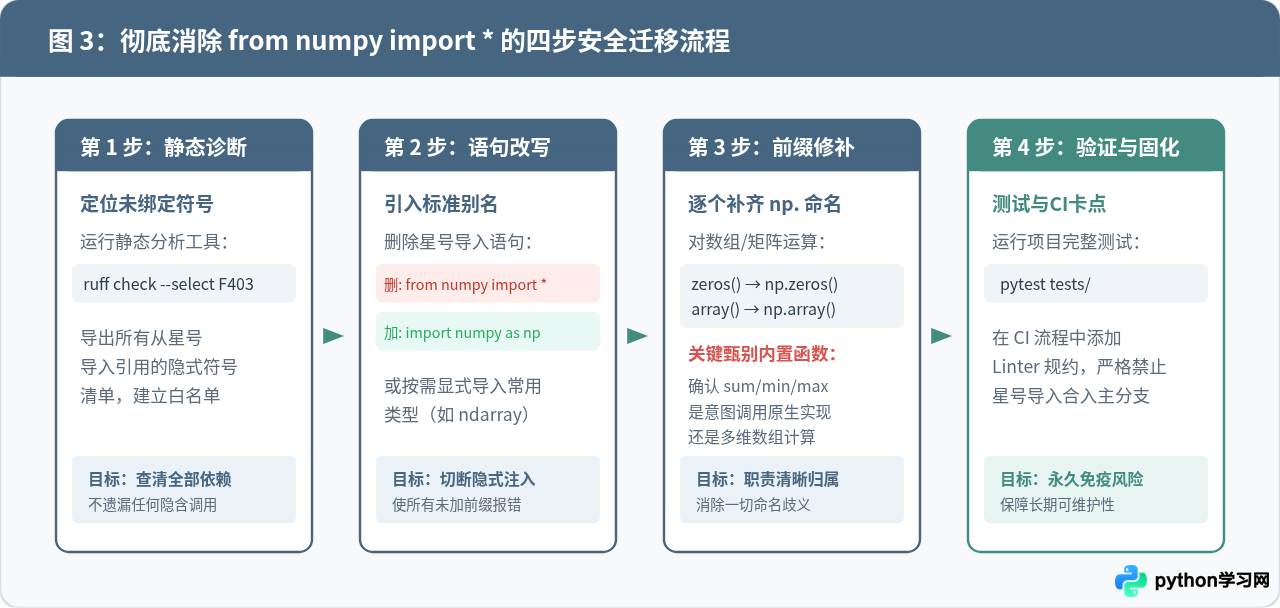
- 第一步:静态诊断定位:运行静态分析工具(例如使用
ruff check . --select F403,F405或flake8 --select F403,F405),统计出所有因为星号导入而产生的模糊符号。 - 第二步:改写导入语句:在文件头部将
from numpy import *移除,替换为业界标准写法import numpy as np。 - 第三步:修补前缀与甄别原生调用:
- 对于纯数组操作,将
zeros(...)改为np.zeros(...),将array(...)改为np.array(...)。 - 重点检查
sum、min、max、abs:判断原代码的意图是对纯 Python 列表求值还是对多维数组求值。如果是多维数组统计,添加np.前缀;如果是纯列表求和,保持原生调用,移除潜在性能瓶颈。
- 对于纯数组操作,将
- 第四步:自动化测试与CI校验:运行单元测试用例验证数值逻辑与返回值类型,并在代码仓库的 Pre-commit 或 GitHub Actions 中启用
flake8/ruff规则,禁止后续任何新的通配符导入合入。
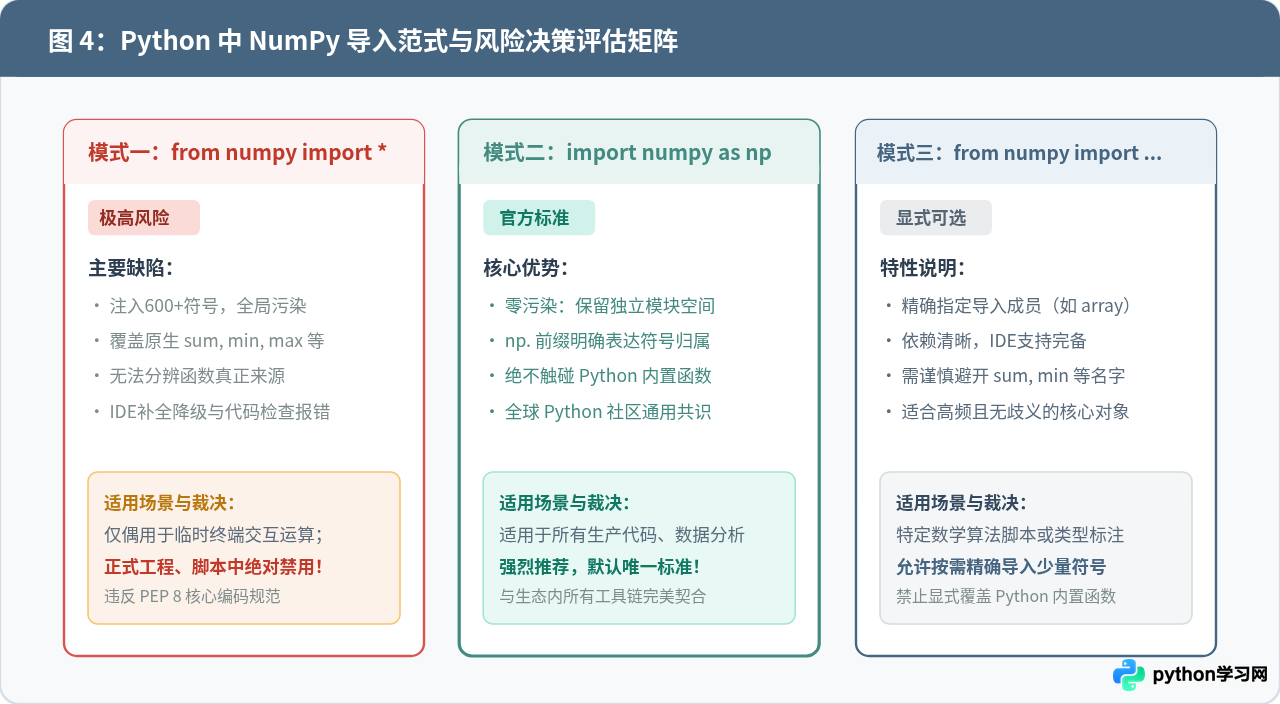
六、NumPy 导入范式与决策矩阵
在日常 Python 开发中,推荐始终使用显式、受控的导入方式。以下是针对三种不同导入方式的权衡与决策参考:
| 导入方式 | 典型写法 | 命名空间影响 | 工具链友好度 | 推荐指数 |
|---|---|---|---|---|
| 模块别名导入(标准) | import numpy as np |
零污染,仅注入单个统一别名 | 极高,跳转与自动补全完美 | ⭐⭐⭐⭐⭐(官方强烈推荐) |
| 显式按需导入 | from numpy import array, ndarray |
可控,仅显式引入指定的对象 | 高,依赖边界清晰 | ⭐⭐⭐⭐(适合特定算法脚本) |
| 通配符星号导入 | from numpy import * |
极高污染,注入600+符号并覆盖内置函数 | 极差,静态检查报警,补全失效 | ❌(生产与工程全面禁用) |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









