

Python批量下载文件太慢?aiohttp异步并发下载指南
针对Python批量下载文件耗时长、带宽利用率低的痛点,本文深入解析同步阻塞与异步I/O的差异,基于aiohttp与asyncio提供信号量限流、流式分块写入、连接池复用与异常重试的完整实战方案。
在日常数据采集或批量资源归档中,使用标准循环配合 requests.get 下载成百上千个文件,往往会耗费数十分钟甚至数小时。核心原因在于网络I/O的阻塞等待:CPU大部分时间都在闲置等待服务端回包,单线程串行模式完全无法利用本地带宽与系统算力。本文将带你通过 Python 的 asyncio 标准库与 aiohttp 异步 HTTP 客户端,实现一个兼具并发提速、信号量限流、流式分块写入与异常重试机制的工业级批量下载方案。
为什么同步下载会成为性能瓶颈?
很多开发者在批量下载时,最直观的代码往往是写一个 for url in urls: 循环,然后在循环体内部调用 requests.get(url) 并写入磁盘。这种模式被称为同步阻塞I/O。
一次标准的文件下载包含 DNS 查询、建立 TCP 连接、TLS 握手、服务端响应以及数据传输多个阶段。在串行下载中,第2个文件必须等第1个文件完全接收并写入完毕后才开始解析域名。如果每个文件下载平均耗时 2 秒,下载 1000 个文件就需要超过 33 分钟。事实上,在此期间本地机器的 CPU 利用率通常低于 3%,绝大部分耗时都在白白“挂起”等待网络数据包。
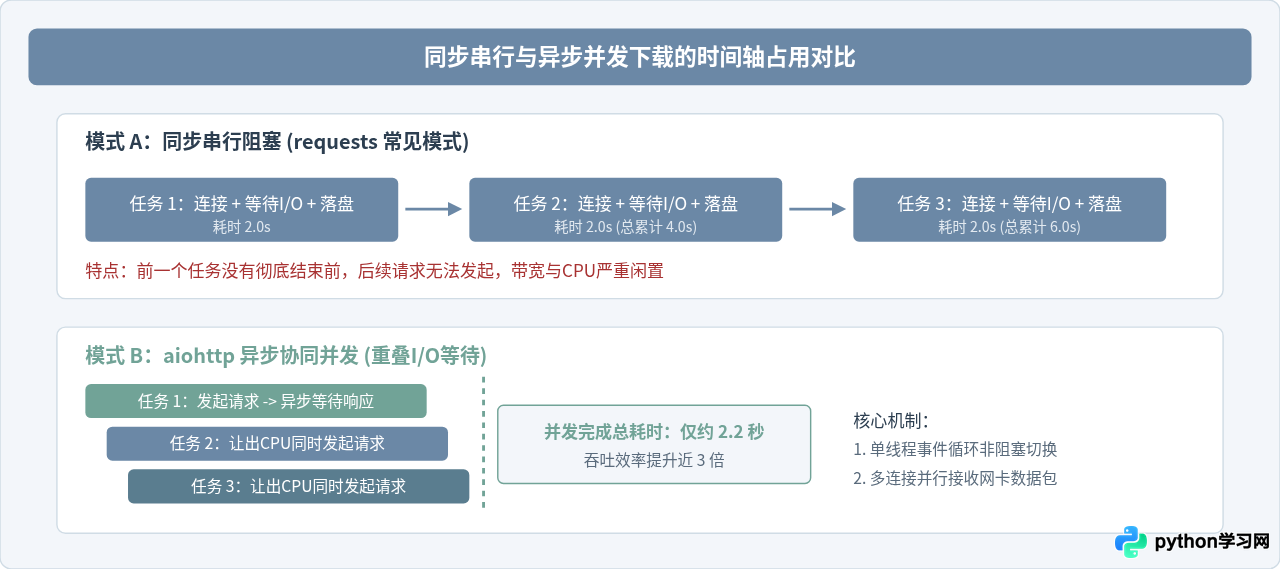
异步模型的精髓在于非阻塞与事件协同:当一个下载请求发出后,代码执行权立即通过 await 让给事件循环(Event Loop),去发起下一个文件的下载请求。当网卡接收到任意一个请求的数据包时,事件循环再唤醒对应的协程继续读取与落盘。这使得数个乃至数十个网络连接可以同时处于等待传输状态,大幅压缩整体等待时长。
环境准备与基础异步下载
要使用 aiohttp,需要确保 Python 环境为 3.8 及以上。通过终端安装所需依赖:
pip install aiohttp aiofiles其中 aiohttp 负责异步 HTTP 网络请求,aiofiles 负责异步本地文件读写,避免磁盘写操作阻塞事件循环。
异步下载单文件的标准写法
很多初学者会直接使用 await response.read() 一次性把整个文件读入内存,但这对于视频、大安装包等大文件而言极其危险,容易引发内存溢出(OOM)。规范做法是使用流式分块读取:
import aiohttp
import aiofiles

async def download_single_file(url: str, save_path: str):
    # 为当前请求设置独立的客户端超时时间
    timeout = aiohttp.ClientTimeout(total=60)
    async with aiohttp.ClientSession(timeout=timeout) as session:
        async with session.get(url) as response:
            if response.status == 200:
                async with aiofiles.open(save_path, mode="wb") as f:
                    # 每次读取 64KB 数据块并写入磁盘
                    async for chunk in response.content.iter_chunked(64 * 1024):
                        await f.write(chunk)
                print(f"下载完成: {save_path}")
            else:
                print(f"请求失败,HTTP 状态码: {response.status}")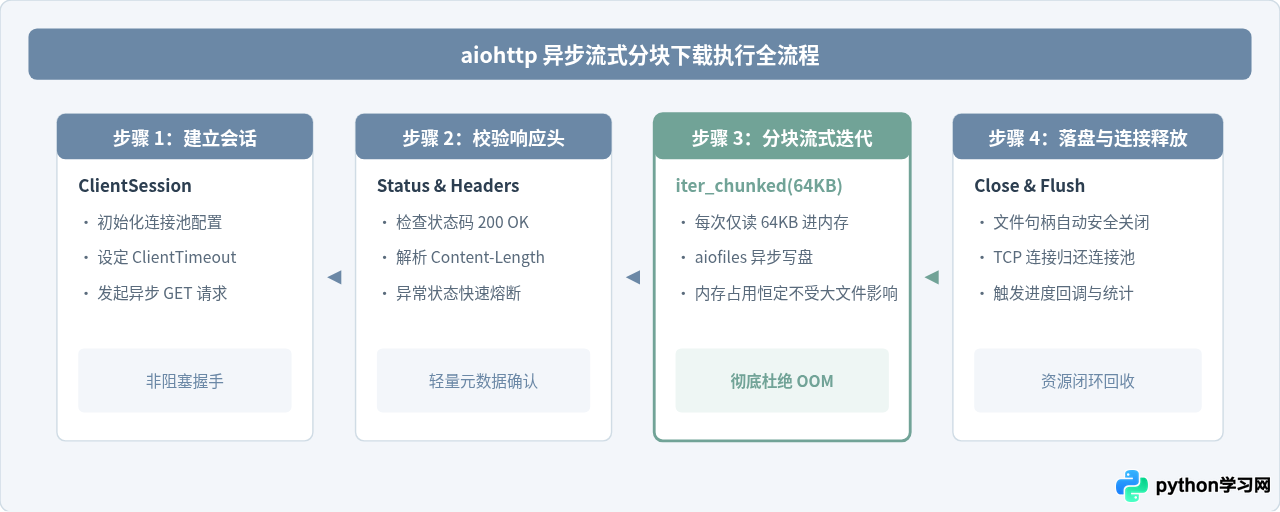
核心设计:信号量并发控制与连接池复用
很多开发者在掌握异步基础后,直接使用 asyncio.gather(*[download(u) for u in urls]) 一口气派发上千个任务。这往往会引发严重事故:
- 服务端封禁与限流:瞬时发起上千次连接会被目标服务器防火墙判定为拒绝服务攻击(DDoS),触发
429 Too Many Requests或503 Service Unavailable。 - 操作系统句柄耗尽:在类 Unix 系统中,同时打开过多 Socket 会抛出
OSError: [Errno 24] Too many open files。 - 网络栈拥塞丢包:带宽被过度挤占导致所有连接均出现大面积超时(Timeout)。
解决这个问题的标准工具是 asyncio.Semaphore(信号量)。信号量相当于一个令牌桶,只有拿到令牌的协程才能发起网络连接,执行完毕后归还令牌,将并发数稳定维持在预设的安全上限。
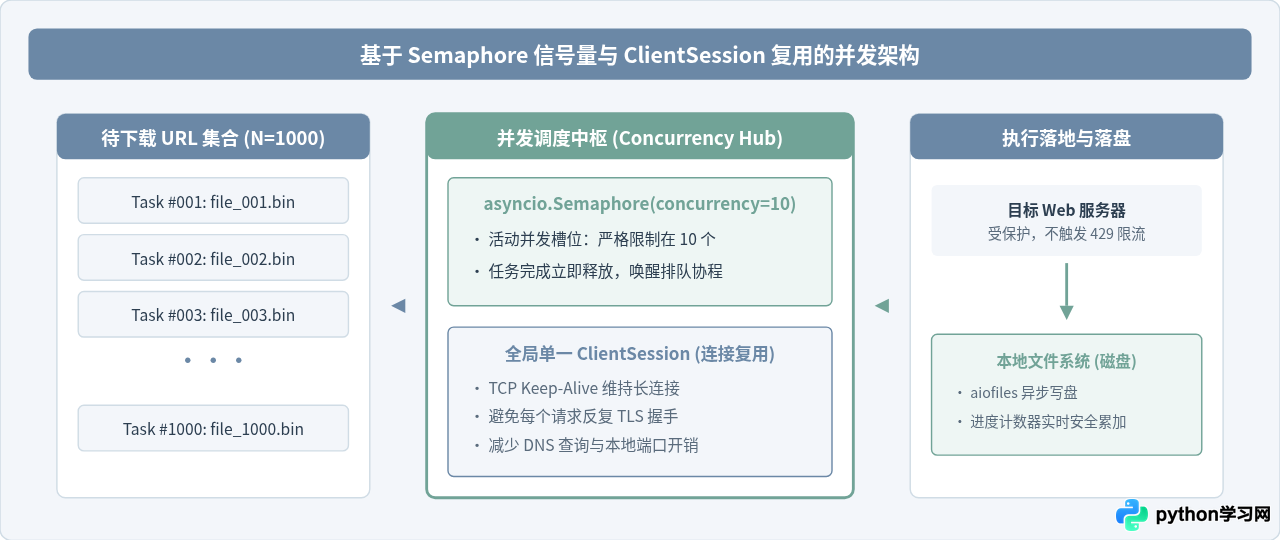
很多初学者会把 async with aiohttp.ClientSession() 写进单个下载函数的内部。这意味着每一次请求都会创建全新的连接池并重新建立 TCP 握手,既浪费服务器与本地资源,又完全丧失了连接复用的优势。正确的做法是在主流程中建立唯一的一个 ClientSession,将其作为参数传递给所有下载协程共享使用。
工业级批量下载实战代码
下面是一份经过工程检验的完整可运行代码。脚本集成了:全局单一会话池、信号量限流控制、流式异步落盘、超时防护与网络异常重试机制。
import asyncio
import os
import aiohttp
import aiofiles

# 允许的最大并发连接数
CONCURRENCY_LIMIT = 10
# 单次网络超时设定(秒)
TIMEOUT_SECONDS = 30
# 遇到网络抖动时的最大重试次数
MAX_RETRIES = 3

async def download_file_worker(
    session: aiohttp.ClientSession,
    url: str,
    save_path: str,
    semaphore: asyncio.Semaphore
):
    """
    单个文件下载协程:包含信号量配额获取、流式写入与失败重试
    """
    async with semaphore:  # 获取并发令牌
        for attempt in range(1, MAX_RETRIES + 1):
            try:
                async with session.get(url) as response:
                    if response.status == 200:
                        async with aiofiles.open(save_path, mode="wb") as f:
                            async for chunk in response.content.iter_chunked(64 * 1024):
                                await f.write(chunk)
                        print(f"[成功] 文件已保存: {os.path.basename(save_path)}")
                        return True
                    elif response.status == 429:
                        # 触发服务端频控,等待后重试
                        await asyncio.sleep(2 * attempt)
                    else:
                        print(f"[警告] HTTP {response.status}: {url}")
                        return False
            except (aiohttp.ClientError, asyncio.TimeoutError) as err:
                if attempt == MAX_RETRIES:
                    print(f"[失败] 超过最大重试次数: {url},原因: {err}")
                    return False
                await asyncio.sleep(1 * attempt)  # 简易指数退避
    return False

async def batch_download_manager(download_tasks: list, output_dir: str):
    """
    批量任务总控:初始化目录、统一管理连接池与并发调度
    """
    os.makedirs(output_dir, exist_ok=True)
    semaphore = asyncio.Semaphore(CONCURRENCY_LIMIT)
    timeout = aiohttp.ClientTimeout(total=TIMEOUT_SECONDS)

    # 全局唯一 ClientSession,复用 TCP 握手
    async with aiohttp.ClientSession(timeout=timeout) as session:
        coroutines = []
        for index, url in enumerate(download_tasks):
            # 依据需求指定文件名或从 URL 解析
            filename = f"file_{index + 1:04d}_{os.path.basename(url.split('?')[0])}"
            save_path = os.path.join(output_dir, filename)

            # 创建协程任务
            coro = download_file_worker(session, url, save_path, semaphore)
            coroutines.append(coro)

        print(f"开始批量下载,共计 {len(coroutines)} 个任务,并发限制: {CONCURRENCY_LIMIT}")
        results = await asyncio.gather(*coroutines)

        success_count = sum(1 for r in results if r)
        print(f"下载结束!成功: {success_count}/{len(download_tasks)},失败: {len(download_tasks) - success_count}")

# 脚本入口示例
if __name__ == "__main__":
    test_urls = [
        f"https://speed.cloudflare.com/__down?bytes=1048576"
        for _ in range(30)
    ]
    # 执行异步主事件循环
    asyncio.run(batch_download_manager(test_urls, "./downloaded_files"))
参数调优与生产避坑指南
将异步批量下载投入生产环境时,合理的参数配置直接决定了任务的稳定性和吞吐上限。以下是四个维度的核心权衡依据:
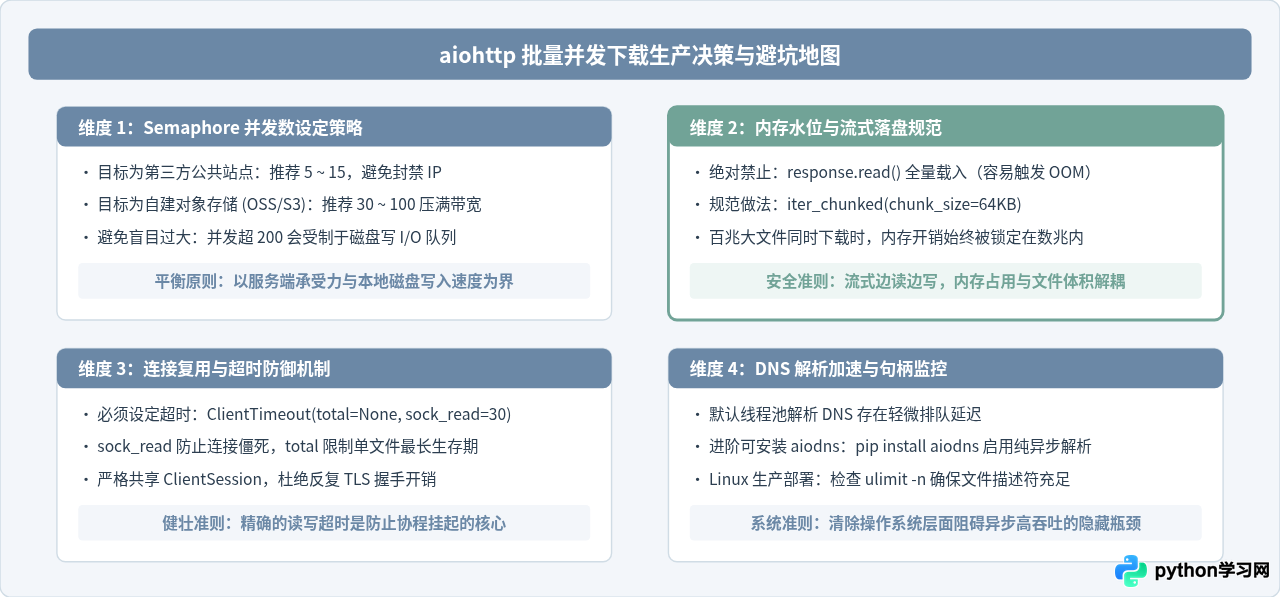
常见报错与针对性处理
| 常见异常 / 现象 | 根本原因 | 针对性解决方案 |
|---|---|---|
asyncio.TimeoutError |
目标服务器由于负载过高或网络拥堵,在指定超时窗口内未完成数据回传。 | 将 ClientTimeout 的 total 适当调大,并捕获异常后配合简易指数退避(如 sleep(2))进行二次重试。 |
ClientConnectorError / ServerDisconnectedError |
并发量过大导致服务器主动切断 TCP 连接,或本地端口分配耗尽。 | 调小 CONCURRENCY_LIMIT(例如从 50 降到 15),检查是否在多个协程间重复创建了 ClientSession。 |
HTTP 429 Too Many Requests |
触发了目标服务端的反爬虫或 API 频控保护。 | 在重试逻辑中加入随机休眠,同时适当下调信号量大小,模拟平缓的请求曲线。 |
OSError: [Errno 24] Too many open files |
单进程打开的文件句柄或网络 Socket 超出了操作系统的默认上限。 | 在系统层提高 ulimit -n 65535,并在 Python 端强制通过 asyncio.Semaphore 约束同时活动的连接数。 |
总结
解决 Python 批量下载速度慢的核心在于打破“串行等待”的模式。通过 aiohttp 结合 asyncio.Semaphore,我们不仅能在单线程中安全建立数十个重叠的网络 I/O 连接,把原本数十分钟的下载任务压缩到几分钟内,还能通过流式分块读取保证内存占用的平稳可靠。
在实际工程中,切记牢固遵循三条基准原则:连接池全局复用、信号量严格限流、数据流式落盘。只要守住这三项规范,你的批量下载服务就能兼顾极高的执行效率与稳定的容错表现。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









