

Python异步编程常用库:Asyncio与Aiohttp的核心优势

一、Asyncio的核心优势与底层运转机制
Asyncio是Python标准库中内置的异步编程框架。理解Asyncio的核心,关键在于搞清楚它与传统“多线程并发”的本质区别。
在传统的多线程模型中,每个线程由操作系统内核调度。当某个线程发起网络请求等待服务器响应时,操作系统会将其挂起,切换去运行其他线程。每个系统线程通常需要占用数兆字节的独立栈内存,而且成百上千个线程之间的频繁上下文切换会导致大量的CPU周期浪费在保存和恢复寄存器状态上。
Asyncio则采用了单线程协同式调度与事件循环(Event Loop)机制。在Asyncio中,任务被称为“协程(Coroutine)”,由用户层程序自主管理。当协程运行到需要等待外部I/O(如网络通信、磁盘读写)时,通过await关键字主动出让CPU执行权;事件循环借助底层的I/O多路复用机制(Linux上的epoll、macOS上的kqueue或Windows上的IOCP)监听就绪事件;一旦网络数据返回,事件循环立即唤醒对应的协程恢复执行。
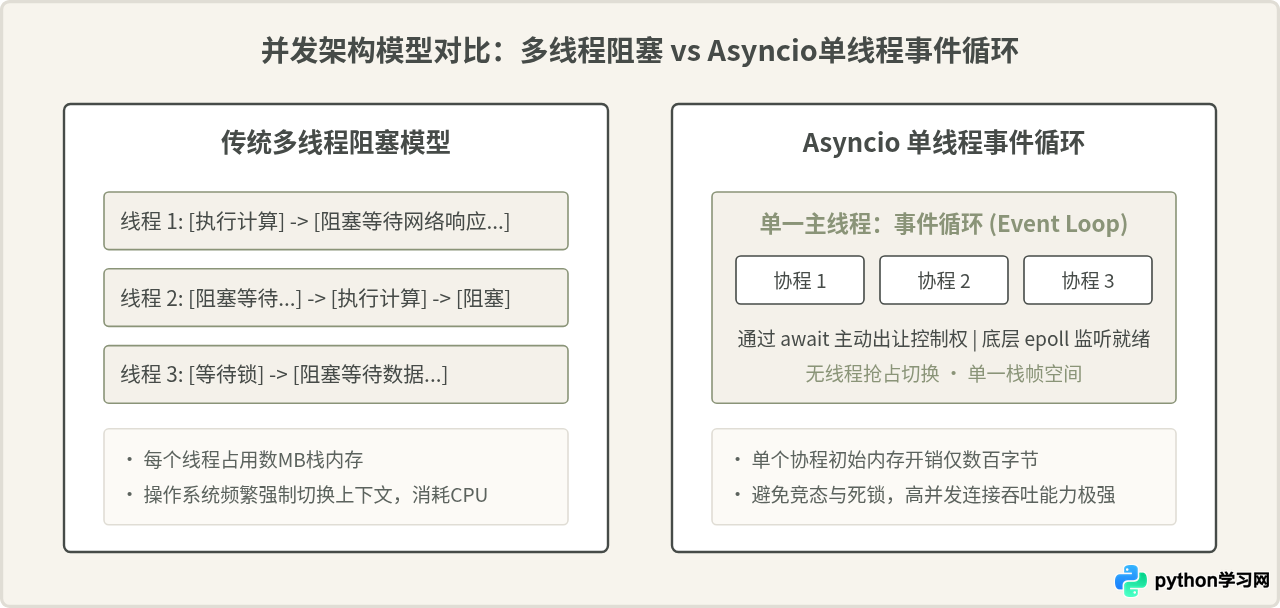
综合来看,Asyncio的核心优势主要体现在三个方面:
- 极低内存占用与高并发连接支撑: 一个系统线程通常需要占用2MB到8MB栈内存,创建数千线程很容易耗尽系统内存;而一个协程对象初生时仅占用几百字节,单个进程内轻松创建并维持数万个协程。
- 免除操作系统级上下文切换消耗: 协程切换发生在用户空间,没有进入内核态的开销,CPU始终高效运转在有效数据处理与事件分发上。
- 确定性的代码执行流: 协程只有在显式遇到
await时才会发生调度让步。在没有await的代码段内,代码拥有独占执行权,这大大降低了隐式共享内存数据破坏和复杂死锁的风险。
二、Aiohttp的核心优势与网络请求协同
初学异步编程时,很多开发者常犯的一个直觉错误是:在async def定义的协程函数内部直接调用requests.get()。
由于requests是纯同步阻塞库,其底层的网络Socket读取会直接卡住当前操作系统线程。在单线程的Asyncio事件循环中,一旦调用了同步阻塞代码,整个事件循环都会被完全“冻结”,导致其他已就绪的协程全部无法得到调度,异步并发瞬间退化为单线程串行执行。
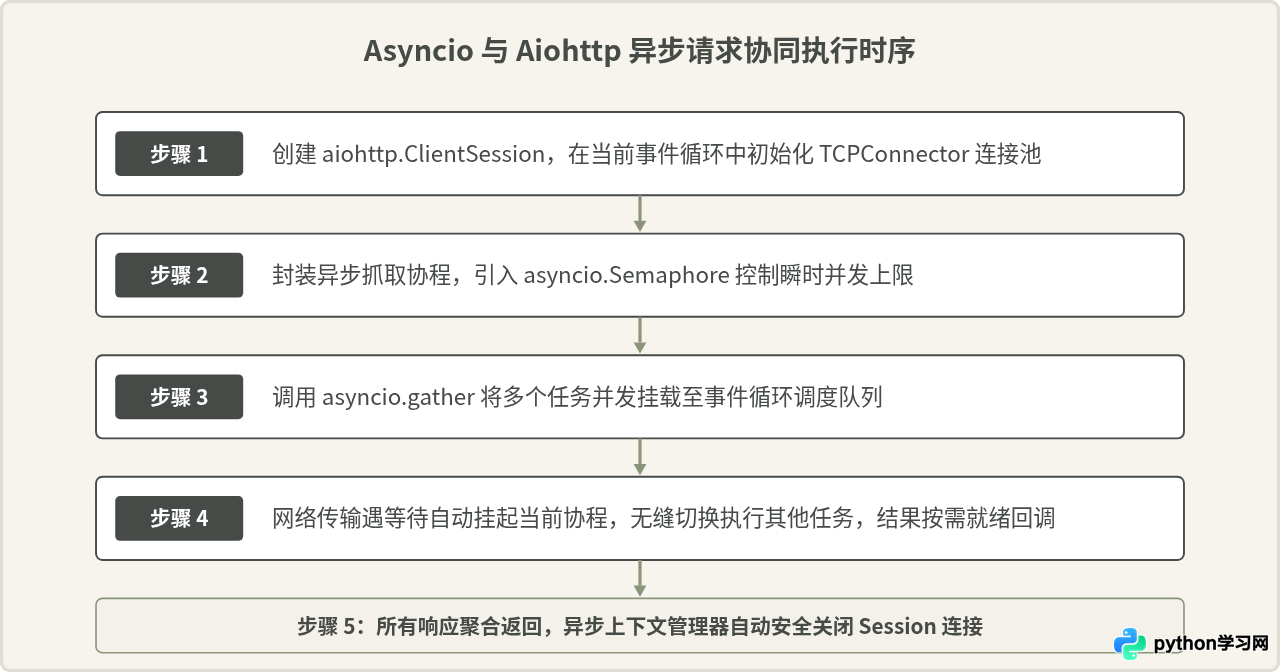
而Aiohttp正是为Asyncio量身定制的高性能异步HTTP客户端与服务端框架。它将网络I/O完全桥接到Asyncio的事件循环中,具有以下关键优势:
- 真正的非阻塞异步传输: 从TCP握手、TLS加密协商到HTTP头部与消息体的发送和接收,全程采用非阻塞Socket驱动,每个阶段都通过
await配合事件循环运转。 - 高效的TCP连接池管理(Connection Pooling): Aiohttp的
ClientSession内置了高效的连接池调度器(TCPConnector),能够针对同一域名保持长连接(Keep-Alive)、复用TCP连接与SSL握手凭证,显著降低高频请求的网络延迟。 - 流式响应与内存保护机制: 在下载大文件或流式API响应时,Aiohttp支持
content.read(chunk_size)逐块消费,避免一次性将数GB响应体载入内存引发OOM。 - 客户端与服务端生态统一: 开发者既可以使用Aiohttp作为高并发抓取与微服务调用的客户端,也可以用它快速搭建轻量级高性能异步Web服务。
三、常见认知误区与边界辨析
异步编程虽然强大,但在实际使用中常常伴随着一些似是而非的观念。明确这些误区有助于在工程中做出正确的架构抉择。
误区一:“只要加上 async 和 await,代码执行速度就会成倍提升”
现象与成因: 很多人看到基准测试中Aiohttp每秒处理成千上万请求,便认为给自己的计算函数套上async def也能大幅提速。
事实与修正: async/await本身完全没有任何加速CPU运算的神奇功效。如果代码所做的事情是纯计算(例如图像渲染、大数据矩阵运算、密码散列计算、大量JSON反序列化),单线程中的协程调度不仅不会带来提升,还会引入微小的协程对象创建与状态机跳转开销。异步编程的提速本质上来源于把原本在网络/磁盘I/O空转等待的时间利用起来去处理其他I/O任务。只有在存在显著I/O等待的场景下,并发收益才会体现出来。
误区二:“有了 Asyncio,多线程与多进程就可以完全淘汰了”
现象与成因: 认为Asyncio是Python官方推荐的现代并发标准,因此应当全面替换原有的多线程(threading)与多进程(multiprocessing)。
事实与修正: 三者各有明确的职责边界:
- Asyncio + Aiohttp: 专精于高并发I/O密集型任务(如同时向成百上千个HTTP端点发起抓取或等待长连接)。
- 多进程(Multiprocessing / ProcessPoolExecutor): 专精于CPU密集型任务。因为每个Python进程有独立的Python解释器和内存空间,能够真正利用多核CPU规避GIL限制。
- 多线程(Threading): 适合遗留的同步I/O阻塞库(如旧版数据库驱动、旧SDK),或者利用
concurrent.futures.ThreadPoolExecutor与Asyncio配合执行阻塞任务。
四、完整实战示例:可控并发的高性能异步请求
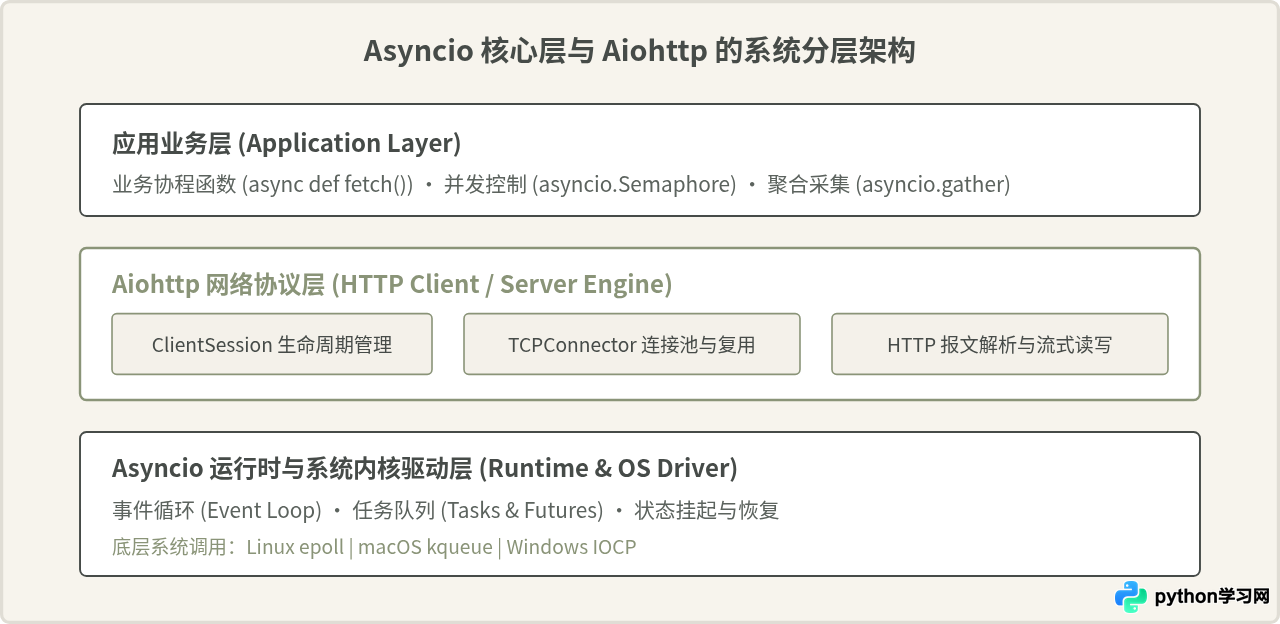
在生产环境中,无节制地同时发起成千上万个请求往往会导致目标服务器限流或本地端口耗尽。因此,成熟的异步代码必须结合信号量(Semaphore)进行并发流控。
1. 依赖安装
确保Python版本为3.8或以上,在终端中安装aiohttp:
pip install aiohttp2. 完整可执行代码
下面的代码演示了如何使用aiohttp.ClientSession、asyncio.Semaphore与asyncio.gather构建一个可控并发的HTTP抓取脚本:
import asyncio
import aiohttp
import time

# 待测试的目标URL列表
TARGET_URLS = [
    f"https://httpbin.org/delay/1" for _ in range(10)
]

async def fetch_url(session: aiohttp.ClientSession, url: str, sem: asyncio.Semaphore, index: int):
    # 使用信号量限制同时活跃的网络请求数量
    async with sem:
        print(f"[{time.strftime('%X')}] 任务 {index} 开始请求: {url}")
        try:
            # 设置请求超时时间为 10 秒
            timeout = aiohttp.ClientTimeout(total=10)
            async with session.get(url, timeout=timeout) as response:
                status = response.status
                # 异步读取响应内容
                content = await response.json()
                print(f"[{time.strftime('%X')}] 任务 {index} 完成,状态码: {status}")
                return status, content
        except asyncio.TimeoutError:
            print(f"[{time.strftime('%X')}] 任务 {index} 请求超时")
            return None, "Timeout"
        except Exception as e:
            print(f"[{time.strftime('%X')}] 任务 {index} 发生异常: {e}")
            return None, str(e)

async def main():
    # 最大并发限制:同时最多 3 个请求在途
    CONCURRENCY_LIMIT = 3
    sem = asyncio.Semaphore(CONCURRENCY_LIMIT)

    start_time = time.time()

    # ClientSession 推荐使用 async with 上下文管理,自动管理连接池关闭
    async with aiohttp.ClientSession() as session:
        # 创建多个异步任务
        tasks = [
            fetch_url(session, url, sem, i)
            for i, url in enumerate(TARGET_URLS, start=1)
        ]
        # 并发执行并收集结果
        results = await asyncio.gather(*tasks, return_exceptions=False)

    elapsed = time.time() - start_time
    print(f"\n全部任务处理完毕,总计请求 {len(TARGET_URLS)} 个,总耗时: {elapsed:.2f} 秒")

if __name__ == "__main__":
    # 启动 Asyncio 事件循环
    asyncio.run(main())
3. 代码关键要点说明
- 全局共用单个
ClientSession: 不要为每一个请求都单独async with aiohttp.ClientSession()。单个Session内部维持着TCP连接池,频繁创建和销毁Session会失去TCP连接复用的巨大优势。 - 利用
asyncio.Semaphore限流: 信号量确保在任何时刻,同时处于传输中的请求不会超过指定上限,既保护本地文件描述符(FD)不超限,也避免对目标服务器造成DDoS冲击。 - 显式配置超时(
ClientTimeout): 异步网络请求如果不设超时,可能会由于个别死连接长期挂起事件循环中的任务槽位。
[14:20:00] 任务 1 开始请求: https://httpbin.org/delay/1
[14:20:00] 任务 2 开始请求: https://httpbin.org/delay/1
[14:20:00] 任务 3 开始请求: https://httpbin.org/delay/1
[14:20:01] 任务 1 完成,状态码: 200
[14:20:01] 任务 4 开始请求: https://httpbin.org/delay/1
...
全部任务处理完毕,总计请求 10 个,总耗时: 4.15 秒(若为同步串行则需10秒以上)
五、选型决策与总结
在进行Python并发开发时,并非所有场景都必须引入Asyncio与Aiohttp。合理的选型应当基于“任务性质”与“并发量级”综合评估:
| 技术方案 | 核心优势 | 适用场景 | 主要限制条件 |
|---|---|---|---|
| Asyncio + Aiohttp | 单线程超高并发、内存极低、非阻塞I/O | 万级网络抓取、WebSocket实时通信、微服务聚合网关 | 不能直接混用同步阻塞库,存在一定异步心智负担 |
| Requests + ThreadPool | API直观简单、学习成本低、生态极为丰富 | 数十到数百个中低频请求、内部自动化运维脚本 | 线程数量过大(>1000)时内存暴涨、切换开销加剧 |
| Multiprocessing | 独立内存与解释器,突破GIL多核并行 | 视频编码、机器学习预处理、加密计算 | 跨进程内存通信成本高,不适合纯高并发I/O连接 |
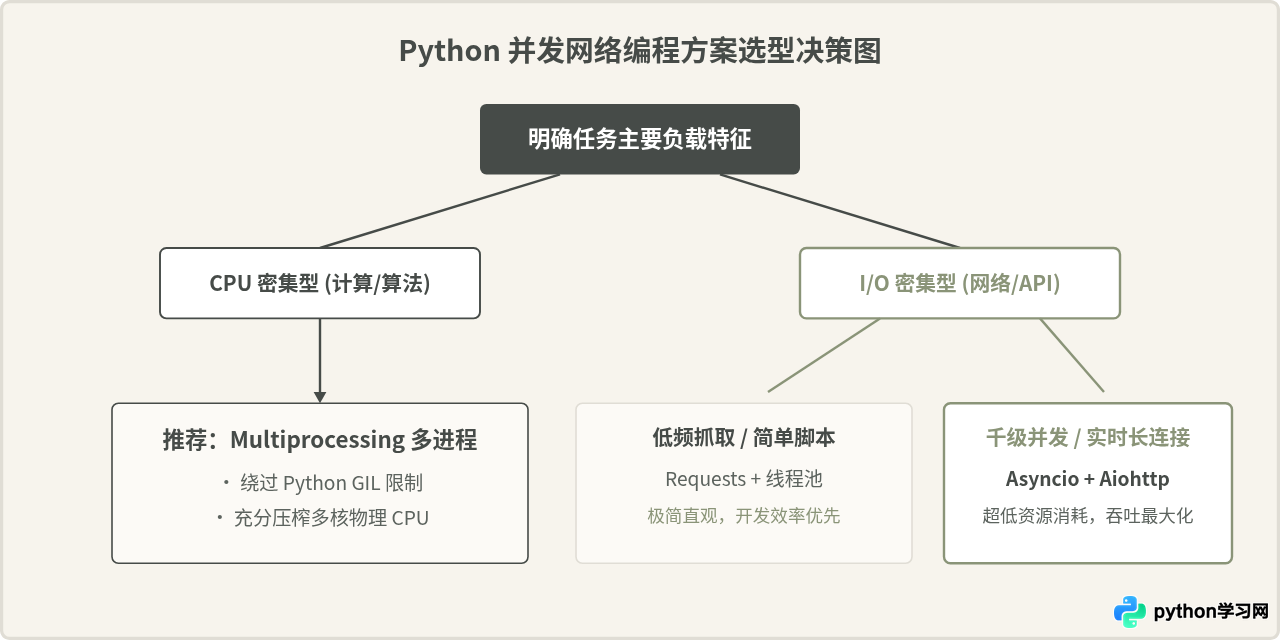
总结而言,Asyncio从语言底座解决了协同式调度与高并发事件循环,而Aiohttp则将这一能力完整落地在网络传输协议层面。只要准确识别出I/O密集型的核心场景,并配合ClientSession连接池与信号量限流,这一组合就能为现代Python应用提供兼顾高吞吐与低开销的稳定并发支撑。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









