

Python发展历程与技术现状:从起源到主流地位演变
深入剖析Python从1989年诞生到成为全球主流编程语言的技术演进史,详解ABC语言继承、Python 2至3的破坏性重构、C-API胶水架构以及现阶段JIT与无GIL技术突破。
一、起源与设计哲学:ABC语言的继承与系统级补全
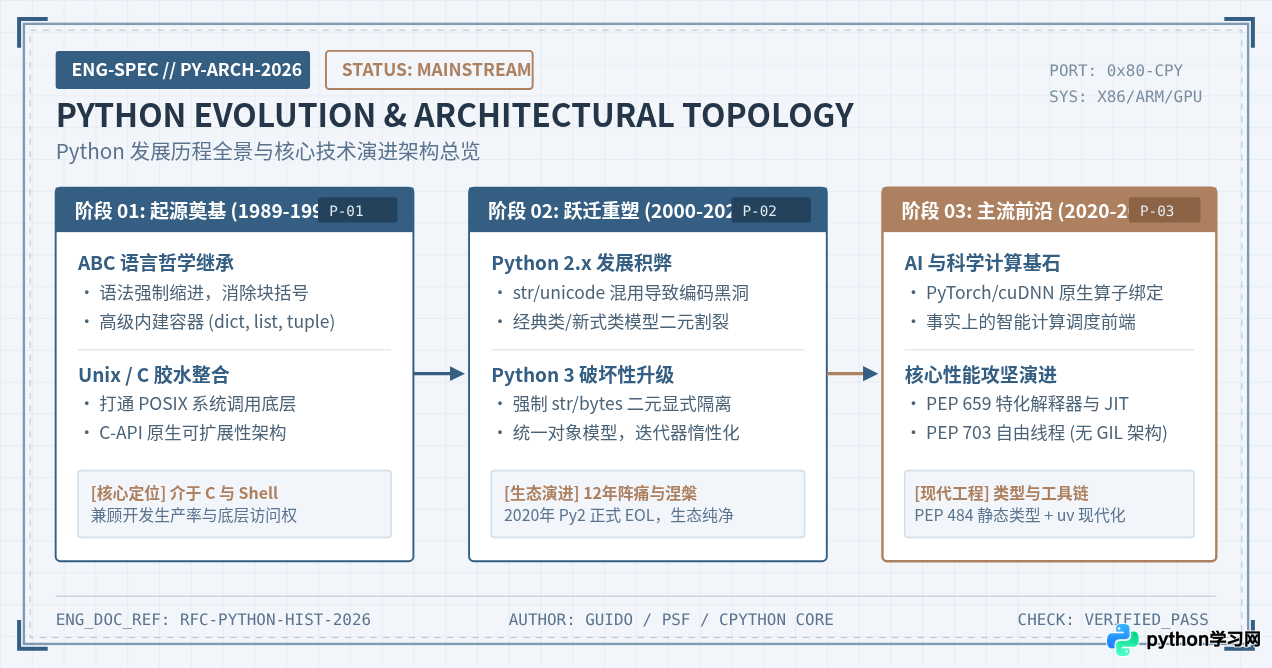
Python 的故事并非始于主流商业项目的驱动,而是源于对现有工具链断层的实际工程解决需求。1989 年圣诞节假期,荷兰国家数学和计算机科学研究中心(CWI)的研究员吉多·范罗苏姆(Guido van Rossum)启动了 Python 项目。当时 Guido 正在参与 Amoeba 分布式操作系统的研发,在日常系统管理与工具开发中面临着极为尴尬的技术选型困境。
1.1 夹缝中的诞生背景:C 与 Unix Shell 之间的缺失环节
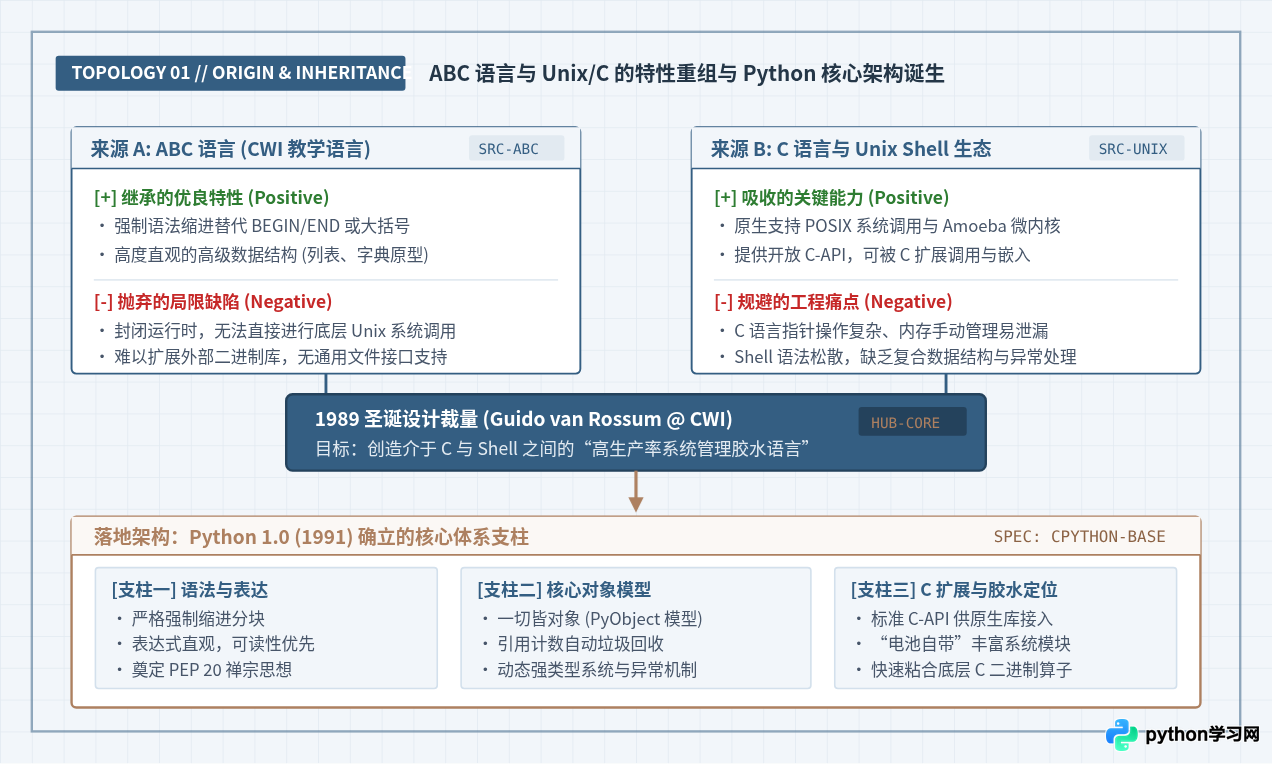
在 20 世纪 80 年代末,系统级开发几乎完全由 C 语言统治。C 语言执行效率极高,拥有对底层硬件和操作系统接口的完全掌控力,但其开发周期漫长,开发者必须耗费大量精力手动管理内存分配与指针生命周期。而在另一个极端,Unix Shell(如 sh、csh)虽然编写快捷、管道粘合方便,但缺乏复合数据结构(如原生的哈希表、复杂嵌套列表),且在跨平台、异常恢复和代码规模扩展上面临极大限制。
Guido 此前曾深度参与 CWI 的 ABC 语言设计。ABC 是一门教学导向的语言,其设计极其优雅,提出了强制语法缩进、内置高级容器以及极其直观的语法结构。然而,ABC 语言为了追求纯粹的教学闭环,彻底切断了与底层操作系统的直连通道——它无法访问原生 Unix 文件描述符、无法调用底层系统中断,也无法接入已有的 C 二进制库。这使得 ABC 尽管可读性极高,却无法在真实的生产环境中生存。
Guido 的核心突破在于:将 ABC 优美的可读性与面向人类的高级语法,移植到开放的 C 语言运行时之上,并赋予其无限制调用 POSIX 系统接口的能力。由此诞生的 Python 既具备脚本语言的编写速度,又具备系统级语言的底层穿透力。
1.2 核心设计哲学及其工程表现
Python 在演进中逐步凝练出独特的工程哲学,并在 PEP 20(《The Zen of Python》)中被系统化记录。这些原则直接映射到具体的语言机制中:
- 优美胜于丑陋,明了胜于晦涩(Explicit is better than implicit):Python 摒弃了 C/Perl 等语言中过度晦涩的隐式上下文变量(如 Perl 的
$_),要求参数传递、模块导入以及作用域查找均保持显式可见。 - 强制缩进构建代码块(Syntactic Indentation):ABC 继承来的缩进语法彻底消除了大括号与缩进不一致引发的“视觉欺骗 Bug”。编译器直接将缩进词法符号转换为
INDENT与DEDENT标记,强迫团队代码风格统一。 - “电池自带”(Batteries Included)理念:自 1.0 版本(1994年发布)起,Python 便在标准库中直接内置了操作系统抽象(
os)、正则表达式(re)、网络套接字(socket)、数据持久化(pickle)等模块,使开发者无需寻找外部依赖即可完成复杂系统任务。
二、演进关键节点:从 Python 2 的繁荣到 Python 3 的结构跃迁
在 2000 年 10 月发布 Python 2.0 之后,Python 迎来了第一轮工业界爆发。Python 2.0 引入了列表推导式(List Comprehensions)、带循环引用检测的垃圾回收器(Cycle-detecting GC)以及对 Unicode 的初步支持。然而,随着全球互联网规模的扩大,早期快速迭代遗留的技术负债开始集中爆发。
2.1 Python 2.x 的历史技术负债
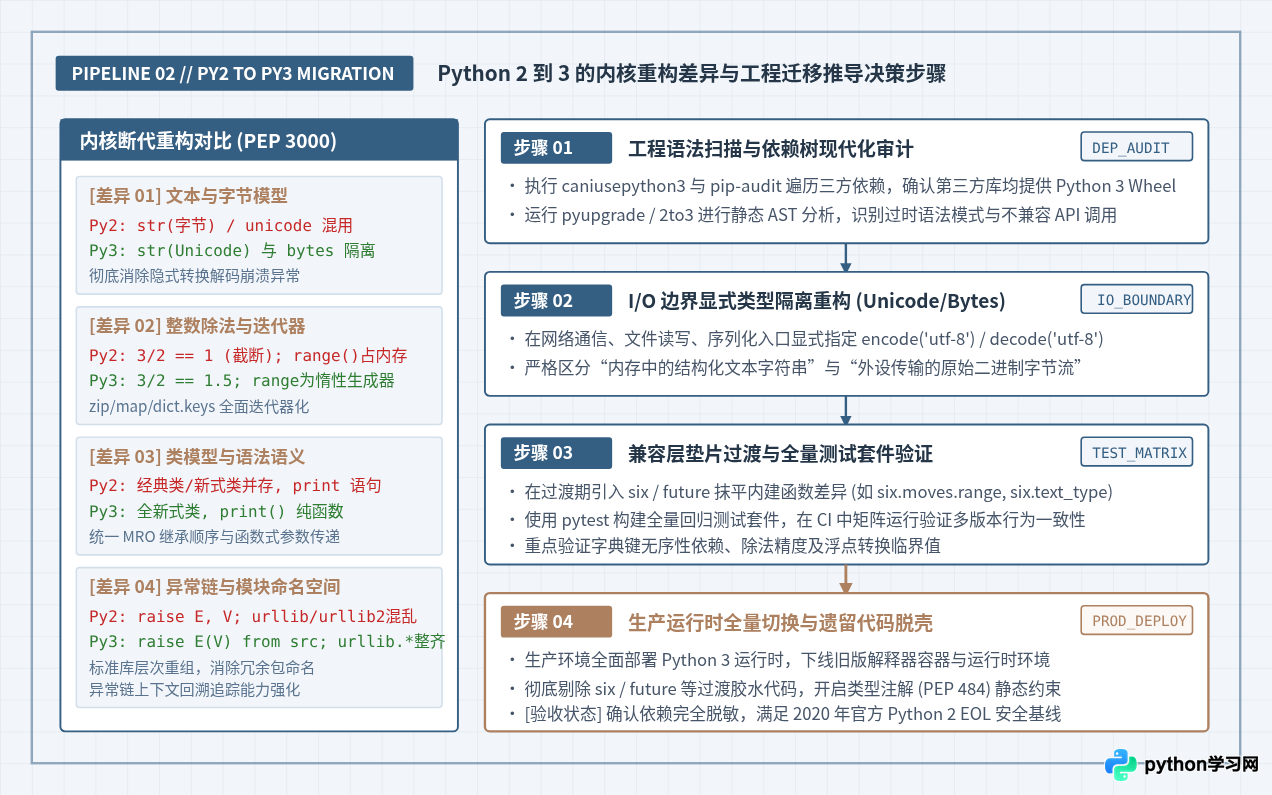
在 Python 2 的设计中,存在四个难以通过微调修复的深层结构缺陷:
- 文本与字节的模糊边界:Python 2 中的
str本质上是裸字节流(bytes),而unicode则是独立的字符类型。两者在执行比较或拼接时,Python 会尝试使用系统默认的 ASCII 编码进行隐式转换。当字符串包含非 ASCII 字符时,程序会在运行时不可预测地抛出著名的UnicodeDecodeError: 'ascii' codec can't decode byte...。 - 整数除法的整除截断:在 Python 2 中,
3 / 2的结果是整数1而非1.5。这种继承自 C 语言的截断行为经常给科学计算与金融业务带来静默的数据精度损失。 - 类模型的二元割裂:Python 2 同时存在“经典类”(Classic Class)与“新式类”(New-style Class,必须显式继承
object)。两者的属性查找顺序(MRO)和元类机制不一致,给面向对象体系带来了不必要的复杂性。 - 语句与函数的混淆:
print作为保留关键字语句存在,导致无法像普通函数一样作为一等公民传递,亦无法灵活重定向流或指定参数结束符。
2.2 Python 3.0 的破坏性革新与生态迁移路径
为了从根本上消除技术负债,Guido 于 2008 年 12 月发布了 Python 3.0(代号 Python 3000,遵循 PEP 3000)。Python 3 确立了一个极为激进的原则:打破向后兼容性,彻底清理设计缺陷。
Python 3 做出的核心结构改造包括:
- 绝对隔离文本与二进制:
str被重塑为纯粹的 Unicode 文本序列,而二进制数据由独立的bytes类型表示。两者不再允许任何隐式混用与运算。任何外部数据在进入程序时必须显式调用decode('utf-8'),在写出到网络或磁盘时必须显式调用encode('utf-8')。 - 函数与迭代器全面惰性化:
range()取代了原本消耗大量内存直接分配列表的xrange();dict.keys()、map()与filter()均返回视图与生成器对象,大幅降低内存峰值占用。 - 类模型与核心语法净化:彻底废除经典类,所有类默认继承自
object;print()正式成为内建函数;新增raise Exception from cause异常链语法,完整保留异常传播上下文。
six 兼容垫片库、pip 支持预编译二进制 Wheel 包,以及官方将 Python 2.7 的支持期限从 2015 年延期至 2020 年 1 月 1 日,生态才完成最终的彻底断舍离。这一过程给现代软件工程留下了深刻教训:语言核心的重大演进必须与依赖生态的构建工具链协同推进。
三、主流地位确立:推动爆发的技术支柱与生态版图
许多开发者曾质疑解释型语言在计算密集型场景下的可行性。然而,Python 最终不仅没有被性能瓶颈击垮,反而一跃成为科学计算、深度学习和人工智能的全球通用基础设施。这一看似悖论的技术演进,本质上是由其卓越的底层架构设计所决定的。
3.1 C-API 胶水层机制:打破解释器性能天花板
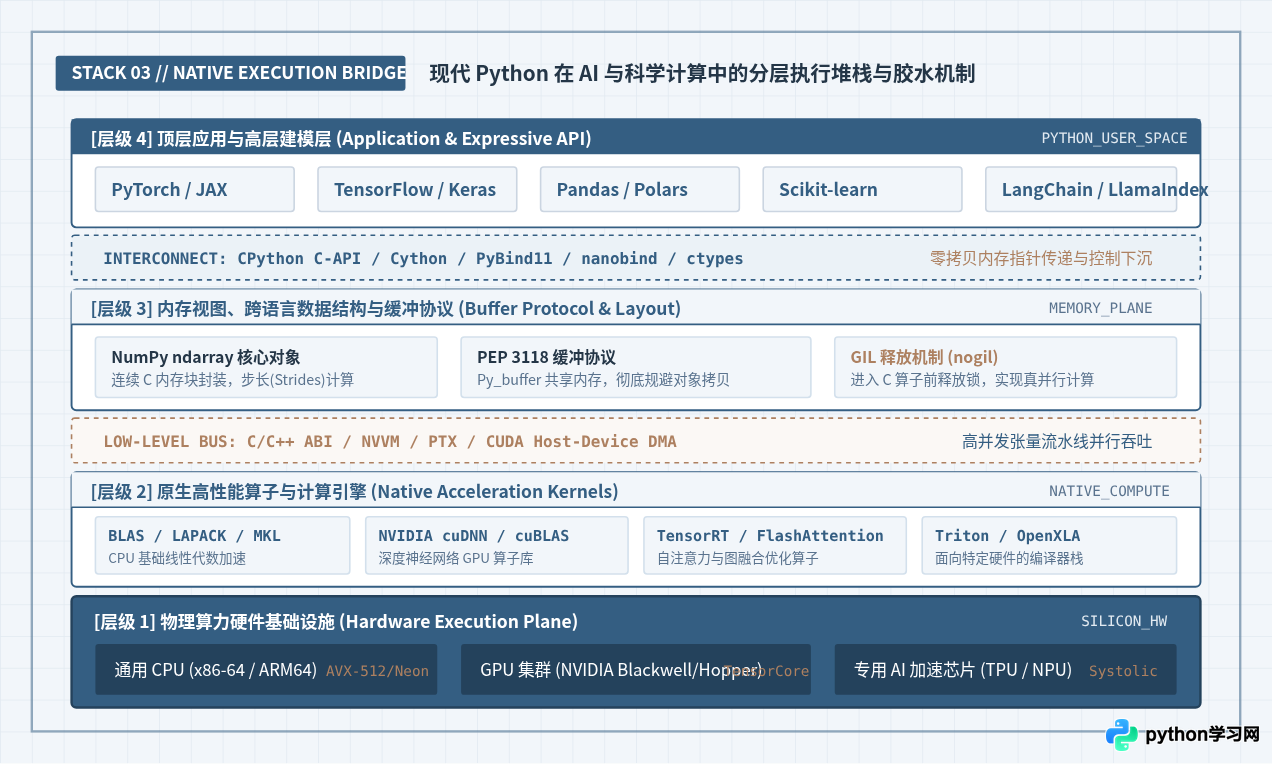
Python 统治 AI 与科学计算的核心武器是其跨语言 C-API 扩展机制。Python 开发者并不在纯 Python 虚拟机循环中执行数十亿次矩阵点积,而是将 Python 作为顶层声明式调度器。
以科学计算基石 NumPy 为例:NumPy 的核心是其底层的 PyArrayObject 结构体。它直接在 C 内存空间中分配一块连续的原始缓冲区(Buffer),并利用多维步长(Strides)元数据描述内存布局。当用户在 Python 中执行 c = a + b 时:
- Python 层仅负责解析高层语法、校验形状匹配并分发操作;
- 底层的加法计算通过 C-API 穿透至高度优化的原生 C/Fortran 内核(如 OpenBLAS、Intel MKL);
- 在执行底层向量化循环时,代码可以通过宏调用
Py_BEGIN_ALLOW_THREADS显式释放全局解释器锁(GIL),让多个底层 C 线程并行榨干所有 CPU 核心的 AVX-512 向量流水线。
3.2 深度学习框架与现代服务化生态
在现代人工智能领域,这一模式被推向了极致:
- PyTorch 与 TensorFlow 的执行范式:开发者使用直观的 Python 语法构建计算图、定义神经网络层和编写前向传播。然而,底层的自动微分(Autograd)、张量算子及通信拓扑(NCCL)完全由 C++、CUDA 与 cuDNN 实现。Python 仅占用了整个训练执行时间的不到 1%,而 99% 以上的时钟周期均消耗在 GPU Tensor Cores 的密集浮点运算上。
- 异步服务端(ASGI)的成熟:伴随 Python 3.5 引入原生的
async/await语法协程,服务端生态从传统的多进程同步阻塞 WSGI(如 Gunicorn + Django)进化至基于asyncio与uvloop(基于 libuv 封装)的高并发 ASGI 生态。以 FastAPI 为代表的现代框架,通过类型注解与极速路由解析,使 Python 在微服务网关和高并发 I/O 密集型接口中展现出接近 Go 和 Node.js 的吞吐性能。
四、现阶段技术现状:核心痛点攻坚与演化前沿
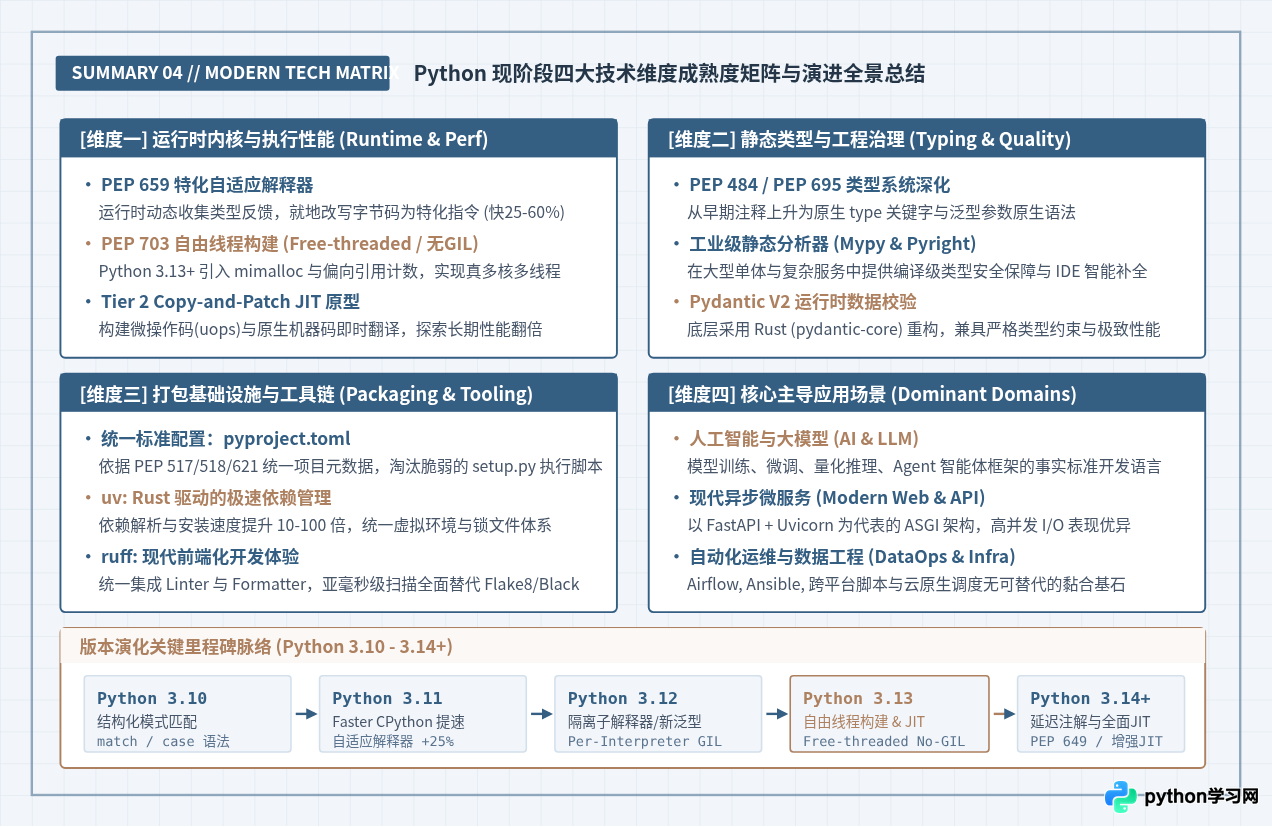
当前,Python 已经进入 3.12 与 3.13 时代,语言设计的重心从早期的“功能补全”全面转向“执行性能攻坚”、“静态工程治理”与“底层并行度释放”。
4.1 Faster CPython 与特化自适应解释器
长期以来,标准 CPython 解释器的单线程循环因动态寻址开销较大而受到诟病。为了彻底改善这一现状,Python 核心团队与微软共同发起了 Faster CPython 计划,并在 Python 3.11 中正式合并了 PEP 659(Specializing Adaptive Interpreter)。
PEP 659 的工作原理是:当解释器运行字节码时,会监控每个操作码(Opcode)的执行频率。当某个循环被识别为热点代码后,解释器会收集操作数运行时的实际具体类型。例如,一个原本通用的 BINARY_OP_ADD 指令在观察到两端均为整数时,会在内存中被就地改写为特化的 BINARY_OP_ADD_INT 指令。特化指令跳过了冗长的对象类型分支判断与字典属性寻址,从而让纯 Python 逻辑的代码执行速度平均提升 25% 至 60%。
在 Python 3.13 中,团队进一步引入了实验性的 Tier 2 Copy-and-Patch JIT 编译器 原型,将高频字节码微操作直接编译为本地原生机器码,为未来的即时编译优化打开了架构大门。
4.2 移除全局解释器锁(PEP 703 自由线程构建)
全局解释器锁(Global Interpreter Lock, GIL)是 CPython 自早期采用引用计数内存管理以来最大的历史包袱。在单核时代,GIL 保护了内部数据结构的线程安全性,且使得 C 扩展极易编写;但在多核时代,GIL 阻止了多线程在纯 Python 逻辑中利用多个 CPU 核心。
Python 3.13 迈出了划时代的一步:正式支持 PEP 703(Free-threaded CPython) 实验性编译选项。为了在没有 GIL 的情况下保证安全与性能,CPython 内核进行了革命性重构:
- 偏向引用计数(Biased Reference Counting):将对象引用计数拆分为“拥有线程的本地计数”与“多线程共享计数”,避免在单线程频繁访问时产生昂贵的原子指令开销。
- 现代内存分配器 mimalloc:引入具备极高并发性能的无锁(Thread-local)内存分配器,减少多线程同时申请对象时的堆锁争用。
- 不朽对象(Immortal Objects):依据 PEP 683,将
None、True、小整数等全局高频对象的引用计数标记为永不销毁,彻底消除核心常量在多线程下的缓存行颠簸(Cache-line bouncing)。
4.3 静态类型系统与现代工程工具链革新
现代 Python 在企业级项目中的大规模应用,直接催生了类型系统与工程工具链的现代化革命:
- 渐进式类型系统(PEP 484 至 PEP 695):从最初依赖
typing模块复杂泛型声明,演进到 Python 3.12 支持原生的type Point[T] = tuple[T, T]语法糖。结合工业级静态分析工具 Mypy 与微软 Pyright,开发团队可以在不牺牲开发灵活性的前提下,于 CI/CD 阶段拦截超过 80% 的空指针、属性拼写与参数类型不匹配错误。 - 基于
pyproject.toml的标准打包规范:PEP 517、518 与 621 彻底淘汰了具有安全隐患的setup.py脚本,建立了纯声明式的工程元数据标准。 - Rust 赋能的极速工具链(uv 与 ruff):近年来,Python 工具链生态迎来了 Rust 的全面重塑。以 Astral 团队开发的
uv为例,其利用 Rust 的高并发能力实现跨平台 Wheel 包解析与极速软链接安装,速度较传统pip提升 10 至 100 倍;而ruff则以单二进制文件整合了 flake8、black、isort 等多个旧工具的功能,实现了毫秒级代码检查与格式化。
五、工程选型与实践建议
为了帮助开发者和架构师在当前技术背景下做出合理决策,以下梳理了针对生产环境的明确选型依据与边界建议:
| 工程决策维度 | 推荐实践规范 | 判断依据与适用边界 |
|---|---|---|
| 运行时版本选择 | 生产推荐 Python 3.11 / 3.12 |
3.11/3.12 处于黄金稳定期,已全面享受特化解释器提速收益,且三方预编译 Wheel 覆盖率达 100%。3.13 自由线程构建目前处于实验阶段,仅推荐用于前沿多核性能测试,暂不宜直接部署于关键业务生产。 |
| 类型约束策略 | 核心业务强制启用 PEP 484 类型注解 |
公共函数接口、数据模型(Pydantic)与数据库映射层必须全覆盖类型定义;内部简单脚本可保持轻量动态。配合 Pyright 在编辑器与流水线中开启严格类型检查。 |
| 依赖管理工具链 | 采用 pyproject.toml + uv |
杜绝在系统环境中全局执行 pip install。统一使用 uv venv 创建隔离虚拟环境,并使用 uv.lock 进行确定性版本锁定,消除“在我的机器上能跑”的环境分歧。 |
| 性能扩展分界线 | 计算密集型算法下沉至 Rust (PyO3) 或 C++ |
当纯 Python 逻辑成为 CPU 瓶颈且无法通过向量化库(NumPy/Polars)解决时,优先通过 PyO3 编写 Rust 扩展模块并生成原生二进制 Wheel,兼顾内存安全性与原生性能。 |
回顾 Python 的整个发展历程,其从一个小众的系统管理原型演变为当今跨越人工智能、科学探索与工业服务的主流基础设施,靠的从来不是单一性能指标的极致,而是在语言表现力、系统可集成性与工程实用主义之间维持的卓越平衡。随着自由线程内核与即时编译技术的不断落地,Python 正在补全其最后的性能短板,在下一个技术周期中继续巩固其通用编程的核心地位。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









