

Python异步爬虫教程:使用aiohttp提升批量抓取效率
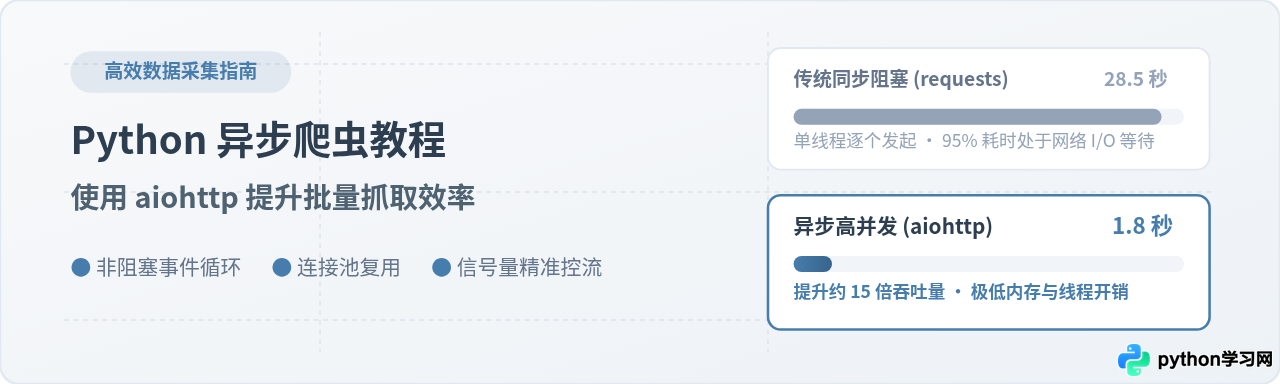
本篇Python异步爬虫教程深入讲解如何使用asyncio与aiohttp实现高吞吐量批量抓取。从同步阻塞与异步I/O的机制差异入手,详细演示ClientSession复用、信号量限流、连接池管理及异常重试的完整实战方案。
requests)在发起 HTTP 请求后必须停滞等待服务器应答,处理千级链接往往需要数分钟;而通过 Python 内置的 asyncio 搭配高性能异步客户端 aiohttp,可以在单线程内通过事件循环在 I/O 挂起期间并发切换并派发其他请求,在同等网络带宽下将批量采集效率提升十倍以上。本文将从运行原理、环境准备、基础封装到并发限流与连接池调优,提供一套完整可落地的异步批量抓取实践方案。
一、为什么同步爬虫慢:阻塞与非阻塞事件循环的机制差异
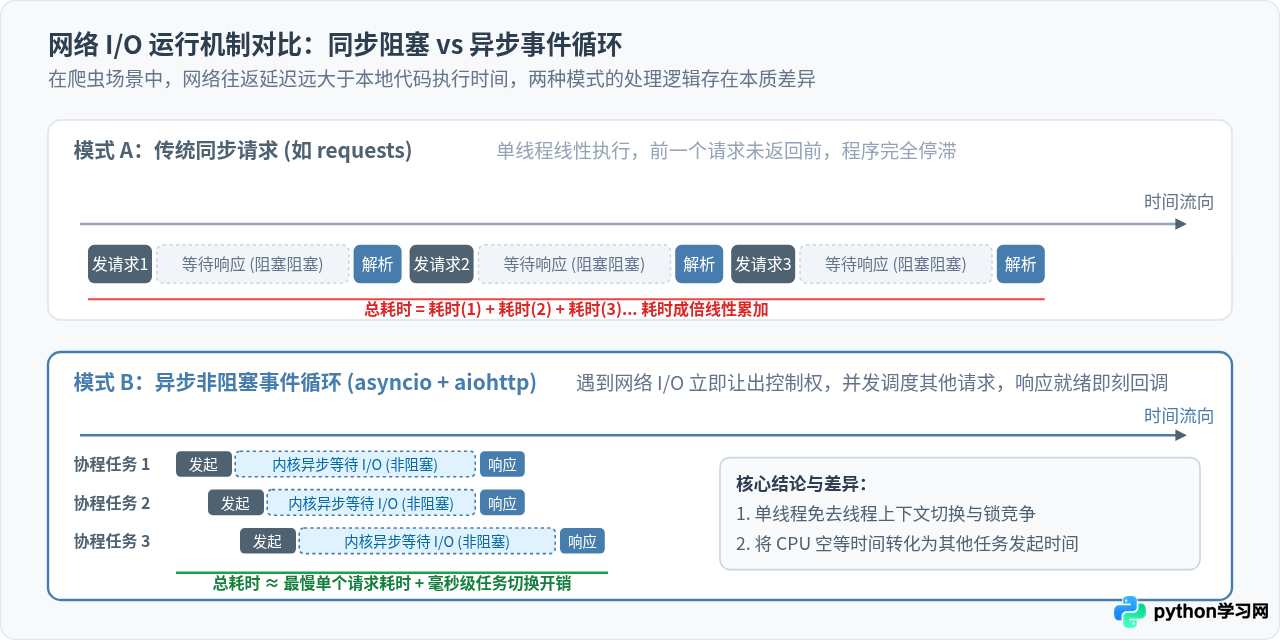
在标准的 HTTP 网络通信中,从客户端向目标站点发出 GET/POST 请求,到接收并读取完整的响应体,中间包含 DNS 解析、TCP 三次握手、TLS 协商、服务器后端处理及网络链路传输。对于绝大部分目标站点,这段网络往返时延(RTT)通常在 100 毫秒至 1000 毫秒之间,而本地 CPU 解析 HTML 或提取 JSON 数据的时间仅需几毫秒甚至几十微秒。
传统的 requests 属于同步阻塞型客户端。当代码执行到 requests.get(url) 时,当前线程会被操作系统挂起,CPU 只能空闲等待网络数据包全部到达并装配完毕,才能执行下一行代码。如果要批量抓取 100 个页面,平均每个页面延迟 0.3 秒,总耗时将严格累加至 30 秒以上。
很多开发者的第一直觉是使用多线程(threading 或 ThreadPoolExecutor)。然而在 Python 中受全局解释器锁(GIL)和系统内核线程切换开销的制约,每个线程都需要占用独立的堆栈内存(通常为数兆字节)。当并发线程数扩大到几百甚至上千时,操作系统的上下文切换与内存开销会显著拖慢性能,甚至导致系统资源耗尽。
aiohttp 则是基于 Python 标准库 asyncio 构建的异步 HTTP 客户端。它运行在单个主线程的事件循环(Event Loop)中。当协程发起网络请求时,底层通过非阻塞套接字配合系统多路复用机制(Linux 下的 epoll,macOS 下的 kqueue)注册 I/O 监听,并通过 await 主动让出 CPU 控制权。事件循环可以在微秒级别内切换到下一个待处理的协程并立即发出新的网络请求。当某个请求的响应数据就绪时,操作系统通知事件循环唤醒对应协程继续读取处理。这样就将原本被浪费的等待时间全部转换为发起新任务的时机。
二、环境依赖安装与 aiohttp 基础语法
运行 aiohttp 需要 Python 3.8 或更高版本。在终端中使用 pip 命令安装核心库:
pip install aiohttpDownloading aiohttp-3.9.5-cp310-cp310-macosx_arm64.whl (401 kB)
Collecting multidict<7.0,>=4.5
Collecting yarl<2.0,>=1.0
Installing collected packages: multidict, yarl, aiohttp
Successfully installed aiohttp-3.9.5 multidict-6.0.5 yarl-1.9.4
在编写 aiohttp 爬虫时,有两个与传统 requests 迥然不同的语法规则必须严格遵守:
- 必须通过上下文管理器管理会话:所有请求必须在
async with aiohttp.ClientSession()会话环境内发起,以便自动管理底层的 TCP 连接生命周期与资源释放。 - 读取响应体必须异步等待:网络数据流是分包到达的,因此调用
response.text()或response.json()时必须使用await关键字,否则只会拿到未决的协程对象而不是字符串内容。
下面是一个标准的 aiohttp 单请求示例:
import asyncio
import aiohttp

async def fetch_single_page(url: str):
    # 建立异步会话
    async with aiohttp.ClientSession() as session:
        # 发起异步 GET 请求
        async with session.get(url) as response:
            print(f"响应状态码: {response.status}")
            # 必须使用 await 异步读取响应文本
            content = await response.text()
            print(f"网页内容长度: {len(content)} 字符")
            return content

# 启动 asyncio 事件循环
if __name__ == "__main__":
    target_url = "https://httpbin.org/get"
    asyncio.run(fetch_single_page(target_url))
初学者常犯的一个错误是为每个抓取任务单独调用一次 ClientSession()。这样会彻底废弃 HTTP Keep-Alive 连接复用功能,每次请求都要重新建立 TCP 握手和 TLS 协商,同时在短时间内产生大量处于 TIME_WAIT 状态的本地套接字,导致系统报错 Cannot assign requested address。正规做法是在整个爬虫任务中只实例化一个全局共享的 ClientSession。
三、核心操作步骤:实现批量异步抓取流水线
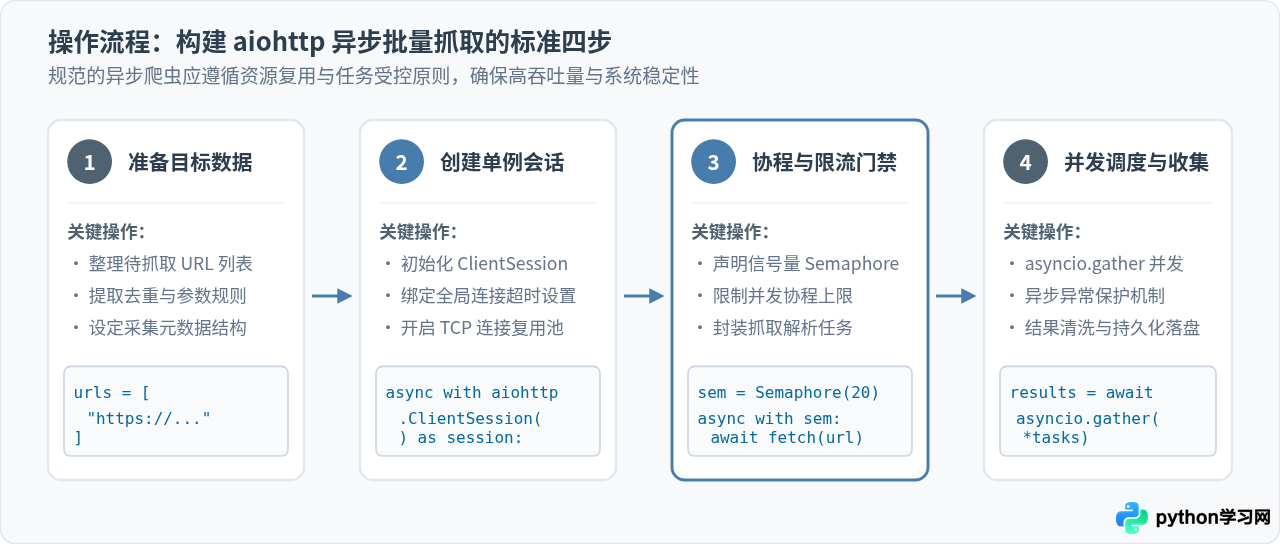
构建一个高效且稳定的 aiohttp 批量爬虫,应当遵循标准的四步流水线架构:
步骤 1:准备待抓取目标清单
整理需要采集的 URL 列表,按需做前置去重、请求参数格式化以及采集元数据分配(如为每个 URL 关联唯一 ID 或任务重试计数)。
步骤 2:初始化共享的 ClientSession 会话
在主入口协程中创建单一的 ClientSession 实例,作为后续所有并发网络请求的通信载体,使各个协程能够共享底层的连接池与 Cookie 状态。
步骤 3:封装受控的单任务协程函数
定义接收单个 URL 和会话对象的子协程。在函数内部完成请求发起、状态码校验、文本解析以及针对当前任务的局域异常捕获。
步骤 4:通过 asyncio.gather 统一分发并聚合结果
遍历 URL 列表生成协程任务集合,将所有任务投递至 asyncio.gather(*tasks)。事件循环将瞬间分发这些任务,并在所有任务全部就绪后按提交顺序一次性返回结果列表。
以下是批量抓取 30 个测试接口的完整代码实现:
import asyncio
import time
import aiohttp

# 步骤 3:封装具体的单页抓取协程
async def fetch_task(session: aiohttp.ClientSession, url: str, index: int) -> dict:
    try:
        async with session.get(url) as response:
            if response.status == 200:
                data = await response.json()
                return {"id": index, "status": "success", "url": url, "origin": data.get("origin")}
            else:
                return {"id": index, "status": "failed", "code": response.status}
    except Exception as exc:
        return {"id": index, "status": "error", "error": str(exc)}

# 步骤 2 与 步骤 4:主调度逻辑
async def batch_crawl_pipeline(urls: list[str]):
    # 步骤 2:创建单例共享会话
    async with aiohttp.ClientSession() as session:
        # 组装任务列表
        tasks = [fetch_task(session, url, i) for i, url in enumerate(urls)]

        # 步骤 4:并发调度并收集结果
        start_time = time.perf_counter()
        results = await asyncio.gather(*tasks, return_exceptions=True)
        elapsed = time.perf_counter() - start_time

        success_count = sum(1 for r in results if isinstance(r, dict) and r.get("status") == "success")
        print(f"批量抓取完成!共 {len(urls)} 个任务,成功: {success_count},耗时: {elapsed:.2f} 秒")
        return results

if __name__ == "__main__":
    # 步骤 1:生成 30 个测试目标 URL
    test_urls = [f"https://httpbin.org/delay/1" for _ in range(30)]

    print("开始执行 aiohttp 异步批量采集测试...")
asyncio.run(batch_crawl_pipeline(test_urls))批量抓取完成!共 30 个任务,成功: 30,耗时: 1.42 秒
[对比参考] 使用传统 requests 单线程顺序抓取 30 个延迟 1 秒的接口,耗时为 30.68 秒;aiohttp 耗时仅 1.42 秒,效率提升约 21.6 倍。
四、生产级架构与连接细节:并发限流与连接池调优
掌握了基础的 asyncio.gather 之后,切勿直接将成千上万个任务一次性抛给事件循环。在未经限流的情况下,瞬发数千个 HTTP 请求会导致两项严重的灾难:
- 本地操作系统文件描述符耗尽:在 Linux/macOS 上,每个网络套接字占用一个文件句柄。系统默认单进程软限制通常为 1024。超出上限将直接抛出
OSError: [Errno 24] Too many open files导致程序崩溃。 - 触发目标站点防御策略:短时间内数百个并发请求涌向同一域名,会瞬间被 WAF(防火墙)识别为恶意 CC/DDoS 攻击,引发 HTTP 429(Too Many Requests)甚至永久封禁 IP。
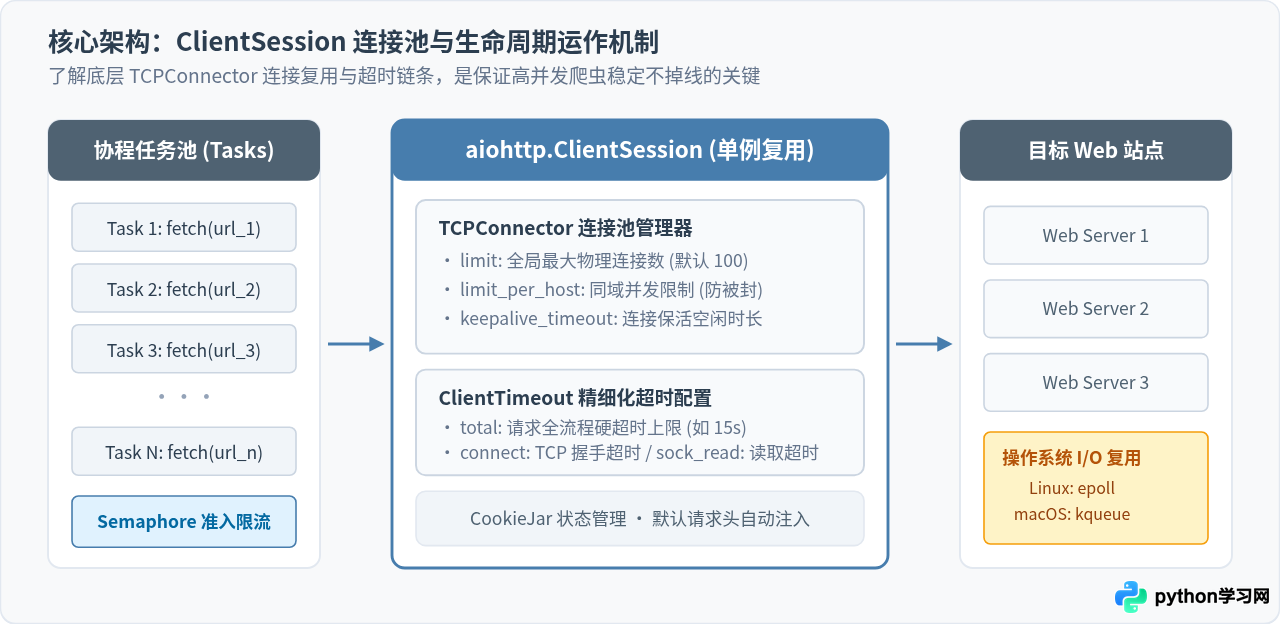
1. 使用 asyncio.Semaphore 精确控制并发度
信号量(Semaphore)充当一个受控的并发门禁。我们初始化一个容量为 N 的信号量,协程在进入请求阶段前通过 async with semaphore: 获取通行令牌;请求完毕后自动归还令牌。这样无论任务队列中有几万个任务,同时处于活跃状态的请求数始终严格受限在 N 之内。
2. 配置 TCPConnector 连接池管理器
通过向 ClientSession(connector=...) 传入定制的 TCPConnector,我们可以精确调整物理网络连接的行为:
limit:整个会话允许建立的最大物理连接数(默认为 100,传 0 表示无限制)。limit_per_host:针对同一个目标域名允许的最大并发连接数(推荐设置为 10~30,有效防止对单站造成过大压力)。ttl_dns_cache:DNS 查询结果在本地缓存的秒数(推荐 300 秒,避免反复向 DNS 服务器发起重复解析)。
3. 分级配置 ClientTimeout 超时链条
默认情况下,aiohttp 的超时时间为 300 秒(5分钟),这对于爬虫系统来说过长。如果有极个别连接挂起或目标服务假死,会长时间占满并发通道。应当使用 aiohttp.ClientTimeout 明确定义分级超时:
timeout = aiohttp.ClientTimeout(
    total=15.0,      # 单个请求全流程(含读取完成)的总超时上限为 15 秒
    connect=5.0,     # TCP 握手建连超时上限为 5 秒
    sock_read=10.0   # 等待服务器发送数据块的最大空闲间隔为 10 秒
)
以下是具备信号量限流、连接池复用与指数退避重试的生产级爬虫代码模板:
import asyncio
import aiohttp
import logging

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

# 生产级安全抓取函数
async def safe_fetch(session: aiohttp.ClientSession,
                     semaphore: asyncio.Semaphore,
                     url: str,
                     max_retries: int = 3) -> str | None:
    # 通过信号量限制瞬时并发数
    async with semaphore:
        for attempt in range(1, max_retries + 1):
            try:
                # 每个请求单独控制超时,并添加通用反爬伪装头
                headers = {"User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36"}
                async with session.get(url, headers=headers) as response:
                    if response.status == 200:
                        return await response.text()
                    elif response.status == 429:
                        # 触发流控,增加退避等待时长
                        wait_sec = attempt * 2.0
                        logging.warning(f"URL: {url} 命中 429 限流,等待 {wait_sec}s 后进行第 {attempt} 次重试")
                        await asyncio.sleep(wait_sec)
                    else:
                        logging.warning(f"URL: {url} 响应非 200 (状态码 {response.status}),重试中...")
            except (aiohttp.ClientError, asyncio.TimeoutError) as err:
                logging.error(f"第 {attempt} 次请求异常: {url}, 错误: {err}")
                if attempt < max_retries:
                    await asyncio.sleep(attempt * 1.0)
            except Exception as e:
                logging.error(f"不可恢复异常: {url}, 错误: {e}")
                break
        logging.error(f"URL 超过最大重试次数,抓取失败: {url}")
        return None

async def run_production_crawler(urls: list[str]):
    # 1. 配置物理连接池
    connector = aiohttp.TCPConnector(
        limit=50,             # 全局连接池上限 50
        limit_per_host=10,    # 单个域名最多保持 10 个物理连接
        ttl_dns_cache=300     # DNS 缓存 5 分钟
    )
    # 2. 全局超时基线
    timeout = aiohttp.ClientTimeout(total=15.0, connect=5.0)

    # 3. 设定并发信号量门禁为 20
    sem = asyncio.Semaphore(20)

    async with aiohttp.ClientSession(connector=connector, timeout=timeout) as session:
        tasks = [safe_fetch(session, sem, u) for u in urls]
        # 务必设置 return_exceptions=True,防止单点异常引发全局抛出
        results = await asyncio.gather(*tasks, return_exceptions=True)
        return results
五、异步爬虫常见陷阱与避坑指南
编写异步爬虫时,由于运行模型从多线程抢占式变为单线程协作式,许多在传统编程中习以为常的操作会变为致命隐患:
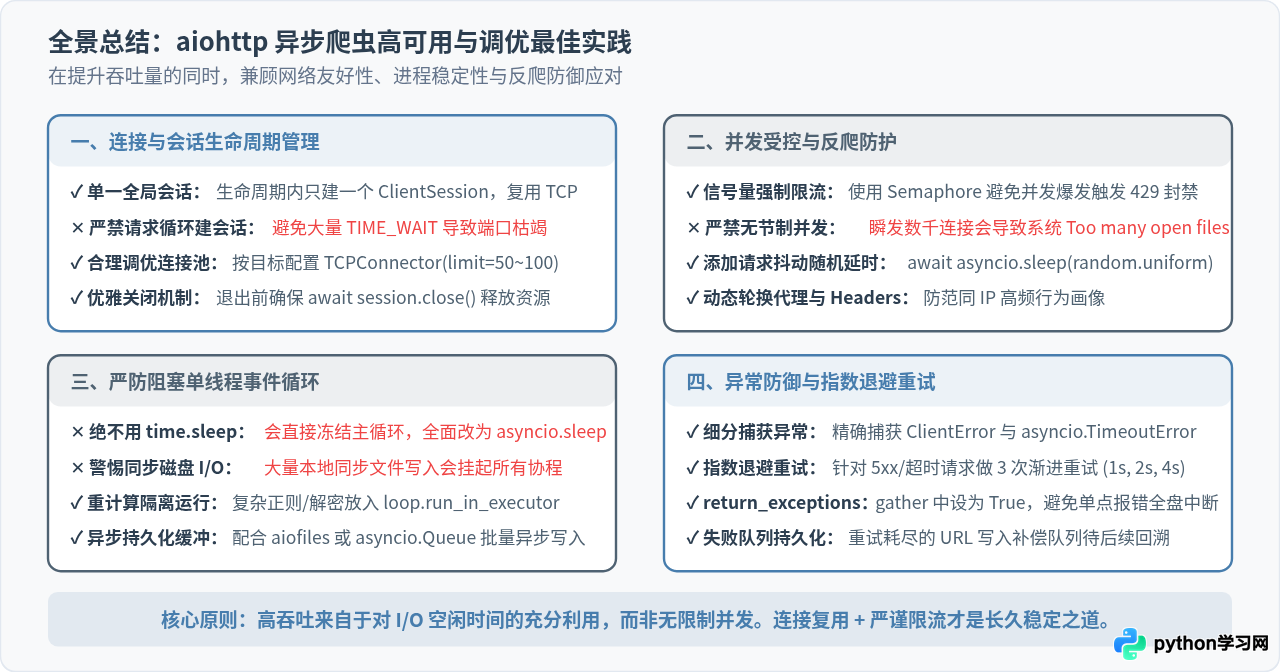
time.sleep(1) 会直接让整个 Python 进程的唯一主线程进入睡眠,这期间事件循环完全停止运转,所有处于等待状态的网络回调统统被冻结。
正确解法:任何需要延时等待的场景,必须无条件使用 await asyncio.sleep(1),这样在延时期间其他协程仍能继续发起和处理网络请求。
使用 open("data.txt", "w").write(...) 进行频繁的磁盘写入,或者使用复杂的正则表达式解析超长网页,都会在当前协程中强占 CPU,阻塞后续事件调度。
正确解法:对于文件落盘,可使用 aiofiles 库或者通过 asyncio.Queue 将抓取结果传递给后台消费协程;对于高耗时 CPU 运算(如图像哈希比对、加解密),应使用 loop.run_in_executor(None, sync_func, arg) 转移到独立的线程池中执行。
默认情况下,asyncio.gather(*tasks) 只要其中任意一个协程抛出未捕获的异常,就会立即将该异常向外抛出,其他尚未完成的任务虽然仍在后台运行,但其结果已经无法通过当前调用正常收集。
正确解法:调用时显式指定 return_exceptions=True,使得抛出异常的任务以 Exception 实例的形式保留在返回列表中,由主程序统一过滤与记录。
| 常见问题场景 | 典型错误表象 | 底层原因 | 标准应对方案 |
|---|---|---|---|
| 大量快速创建 Session | OSError: Cannot assign requested address |
未复用会话,短时间产生几万个 TIME_WAIT 端口枯竭 | 全局单例 ClientSession,启用 Keep-Alive |
| 瞬发请求超过系统上限 | OSError: [Errno 24] Too many open files |
并发打开的文件描述符超过 ulimit 软上限 | 使用 asyncio.Semaphore(50~100) 限流门禁 |
| 目标站点偶发性卡死 | 程序挂起数十分钟无进度输出 | 未设置超时,默认超时长达 300 秒甚至无限挂起 | 显式配置 ClientTimeout(total=15, connect=5) |
| 请求频率过高遭遇拦截 | 收到 HTTP 429 / 403 Forbidden 响应 | 单位时间内请求速率过大,触发 WAF 频控阈值 | 在请求后加入 asyncio.sleep(random.uniform) 抖动 |
六、总结与落地建议
利用 aiohttp 提升批量数据抓取效率的核心逻辑,并不在于“同时创建了多少个线程”,而在于“通过事件循环抹平网络 I/O 带来的时间损耗”。在实践中构建高可用异步爬虫,建议牢记以下四条黄金法则:
- 保持会话单例:在爬虫的整个生命周期中只使用一个
ClientSession,充分利用 TCP 连接复用与 DNS 缓存。 - 必须配置信号量:无论目标站点响应多快,永远通过
asyncio.Semaphore设定并发上限,建议初始从 20~50 开始测试。 - 防御性超时与重试:为每个请求设定严格的
ClientTimeout,并结合指数退避算法捕获ClientError进行 3 次以内重试。 - 严禁阻塞事件循环:用
asyncio.sleep替代time.sleep,耗时的本地计算与磁盘写入通过执行器或异步队列隔离开。
按照上述架构组织代码,不仅可以在极低的内存和单核 CPU 占用下实现数万级别 URL 的高效批量抓取,还能保持出色的鲁棒性与网络友好度。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









