

Python异步编程常用库入门:asyncio与aiohttp实战
深入讲解Python异步编程的核心库asyncio与异步HTTP客户端aiohttp的实战入门教程。包含事件循环与协程调度机制、aiohttp连接池复用、gather并发任务管理、Semaphore限流控制与异常防护,配套工程级可运行代码与完整架构图解。
在网络爬虫、微服务数据聚合与第三方 API 对接等典型 I/O 密集型场景中,传统的同步代码往往因为长时间等待网络响应而导致 CPU 算力大量空转。Python 官方标准库 asyncio 与广受欢迎的高性能异步网络库 aiohttp,构成了现代 Python 异步网络编程的核心技术栈。本文围绕这两个核心库展开,先讲透单线程事件循环与协程调度的工作机制,再通过模块化的可执行代码,实战讲解并发请求构造、连接池生命周期管理、信号量(Semaphore)限流以及异常重试防护,帮助你在实际工程中构建高并发、低开销的网络程序。
一、异步编程的核心机制:为什么网络 I/O 需要 asyncio?
理解异步编程的切入点是认清 I/O 密集型任务的性能瓶颈。在使用传统的 requests 库或者原生套接字发送网络请求时,程序从发出 HTTP 请求报文到接收到服务器首包数据之间,通常存在数十到数百毫秒的网络延迟。在这段等待期间,操作系统线程处于挂起阻塞状态,无法执行其他任务。
为了实现多个请求的并发,传统的方案通常是创建多线程或多进程。然而在 Python 中,每个操作系统原生线程通常需要占用数兆字节的独立栈内存;当并发请求规模上升到几百甚至数千时,频繁的线程上下文切换开销与内存暴涨,会迅速耗尽服务器资源。
asyncio 的核心思想是在单操作系统线程内运行一个事件循环(Event Loop)。在这个模型中,每个具体的业务逻辑被编写为“协程(Coroutine)”。当某个协程遇到网络 I/O 操作时,它通过 await 关键字主动向事件循环让出执行权,并由底层内核(Linux 系统的 epoll、macOS 系统的 kqueue 等 I/O 多路复用机制)监听套接字状态。在此期间,单线程立刻切换去执行其他已经就绪的协程;一旦底层网卡收到数据,内核触发就绪事件通知,事件循环便恢复原协程继续向下执行。
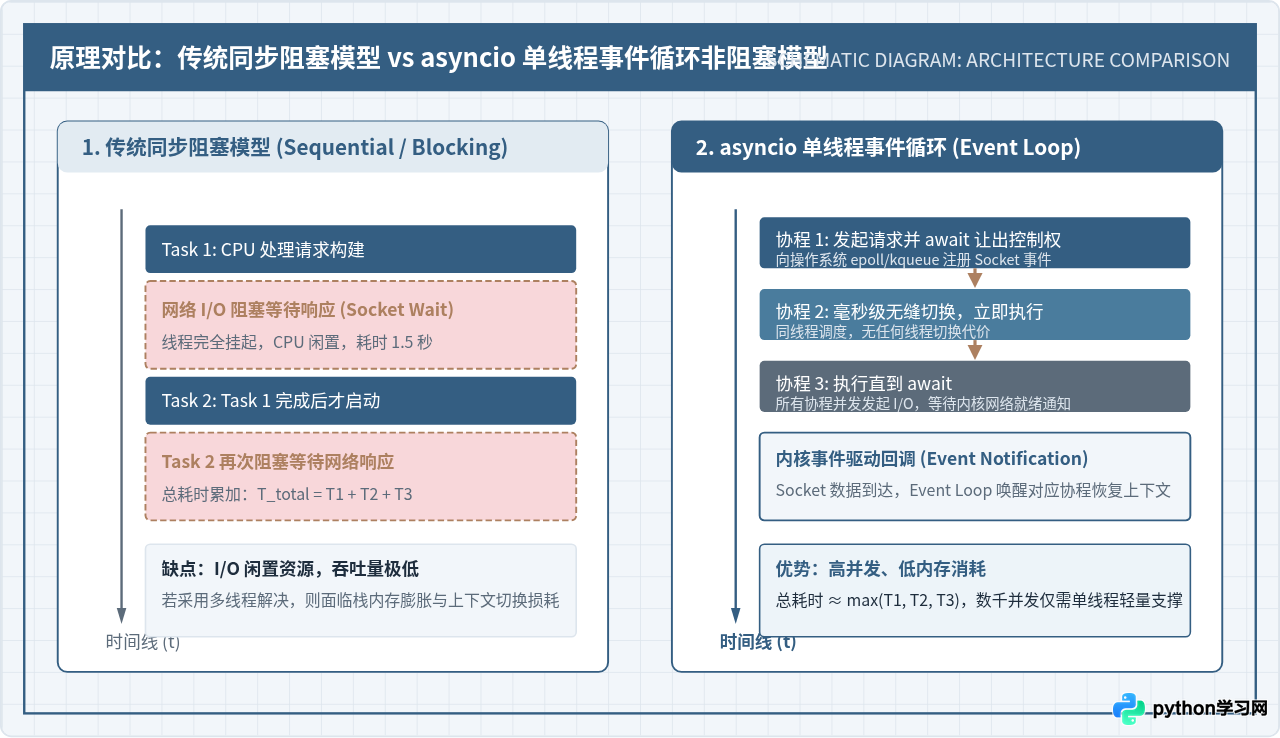
通过图 1 可以清晰看到,asyncio 并未创建额外的物理线程,而是通过非阻塞套接字与协作式让出机制,将传统串行累加的时间开销压缩为取多个请求网络延迟的最大值,极大提升了网络吞吐能力。
二、asyncio 核心用法:协程、Task 与并发管理
编写异步程序必须掌握 asyncio 的三个核心要素:定义协程的 async def、等待异步结果的 await 以及将协程包装为后台并发任务的 asyncio.create_task()。
1. 异步入口与协程基础语法
在 Python 3.10+ 的现代实践中,启动异步程序的标准方式是调用 asyncio.run()。它负责隐式创建全新的事件循环、运行传入的顶层协程,并在其执行完毕后安全关闭底层资源。
import asyncio

async def fetch_user_data(user_id: int):
    # 模拟网络 I/O 延迟,不能使用 time.sleep()
    print(f"[开始] 获取用户 {user_id} 数据...")
    await asyncio.sleep(1.0)
    print(f"[完成] 用户 {user_id} 数据已返回")
    return {"user_id": user_id, "status": "active"}

async def main():
    # 顺序等待单个协程
    result = await fetch_user_data(101)
    print("获取结果:", result)

if __name__ == "__main__":
asyncio.run(main())async def 内部调用了 time.sleep() 或同步数据库查询,整个单线程的事件循环将被彻底卡死,期间所有的其他异步任务都将停滞。异步代码中必须使用对应的非阻塞版本(如 asyncio.sleep())。
2. 多任务并发:asyncio.create_task 与 asyncio.gather
直接在协程前写 await coroutine() 仍然是顺序执行的。要让多个协程真正“同时在飞”,需要借助 asyncio.create_task() 将协程提交给事件循环调度,或者使用 asyncio.gather() 进行批量打包。
import asyncio
import time

async def download_file(file_name: str, duration: float):
    print(f"[启动下载] {file_name},预计耗时 {duration}s")
    await asyncio.sleep(duration)
    print(f"[下载就绪] {file_name}")
    return f"{file_name}_data"

async def main():
    start_time = time.perf_counter()

    # 构造并发任务列表
    tasks = [
        download_file("file_A.zip", 1.5),
        download_file("file_B.zip", 2.0),
        download_file("file_C.zip", 1.0)
    ]

    # 并发执行并按顺序收集返回值
    results = await asyncio.gather(*tasks)

    cost_time = time.perf_counter() - start_time
    print(f"全部完成,下载结果: {results}")
    print(f"实际总耗时: {cost_time:.2f} 秒 (串行理论耗时需 4.50 秒)")

if __name__ == "__main__":
    asyncio.run(main())
运行该程序时,三个下载任务几乎同时打印启动信息,实际总耗时约为 2.0 秒(取决于耗时最长的单个任务),充分展示了并发协作的性能优势。
三、aiohttp 异步 HTTP 客户端:高并发请求实战
标准库 asyncio 提供了底层套接字协议与事件循环支持,但没有内置高层的 HTTP/HTTPS 客户端协议解析器。要在生产环境中发起异步 HTTP 请求,事实上的行业标准库是 aiohttp。
1. 环境准备与核心设计原则
在命令行终端中安装 aiohttp 及其推荐的高性能 DNS 解析器与 cchardet 加速库:
BASHpip install aiohttp aiodns
使用 aiohttp 时的首要原则是:合理管理 ClientSession 的生命周期。aiohttp.ClientSession 内部维护着底层套接字连接池(Connection Pool)和 DNS 缓存。在实际工程中,必须在全局或主生命周期内复用同一个 Session,绝不能为每一个 URL 请求单独创建和销毁一个 Session。
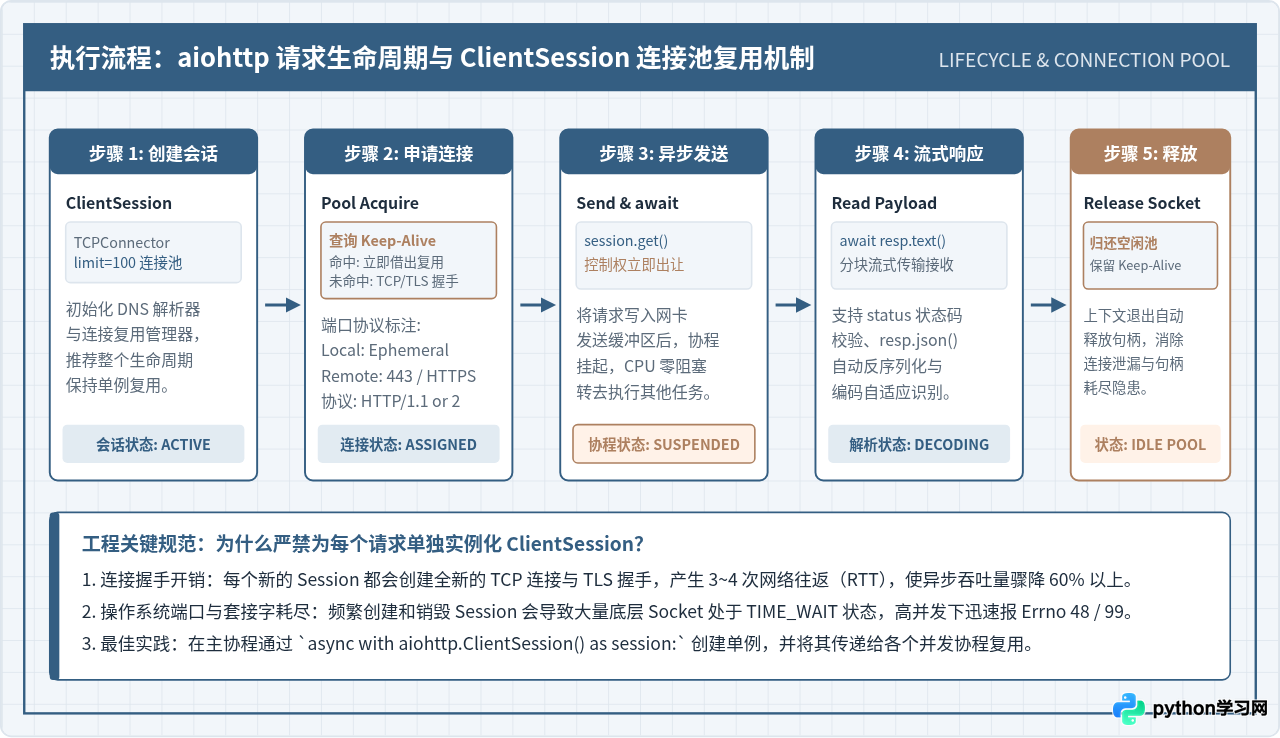
2. 发送异步 GET 请求与 JSON 反序列化
以下是规范使用 ClientSession 的标准模板,采用异步上下文管理器 async with 确保请求结束后连接能被正常归还至连接池:
import asyncio
import aiohttp

async def fetch_api(session: aiohttp.ClientSession, url: str):
    try:
        # 在上下文管理器内发起 GET 请求
        async with session.get(url) as response:
            print(f"响应状态码: {response.status}, 内容类型: {response.headers.get('Content-Type')}")
            # 必须使用 await 异步读取响应体文本或 JSON
            data = await response.json()
            return data
    except aiohttp.ClientError as err:
        print(f"网络通信异常: {err}")
        return None

async def main():
    target_url = "https://httpbin.org/json"

    # 显式配置超时:连接 5 秒,总耗时不超过 15 秒
    timeout = aiohttp.ClientTimeout(total=15, connect=5)

    # 在最外层统一建立会话
    async with aiohttp.ClientSession(timeout=timeout) as session:
        result = await fetch_api(session, target_url)
        if result:
            print("解析成功,标题:", result.get("slideshow", {}).get("title"))

if __name__ == "__main__":
    asyncio.run(main())
四、并发控制与稳定性保障:asyncio.Semaphore 与限流防雪崩
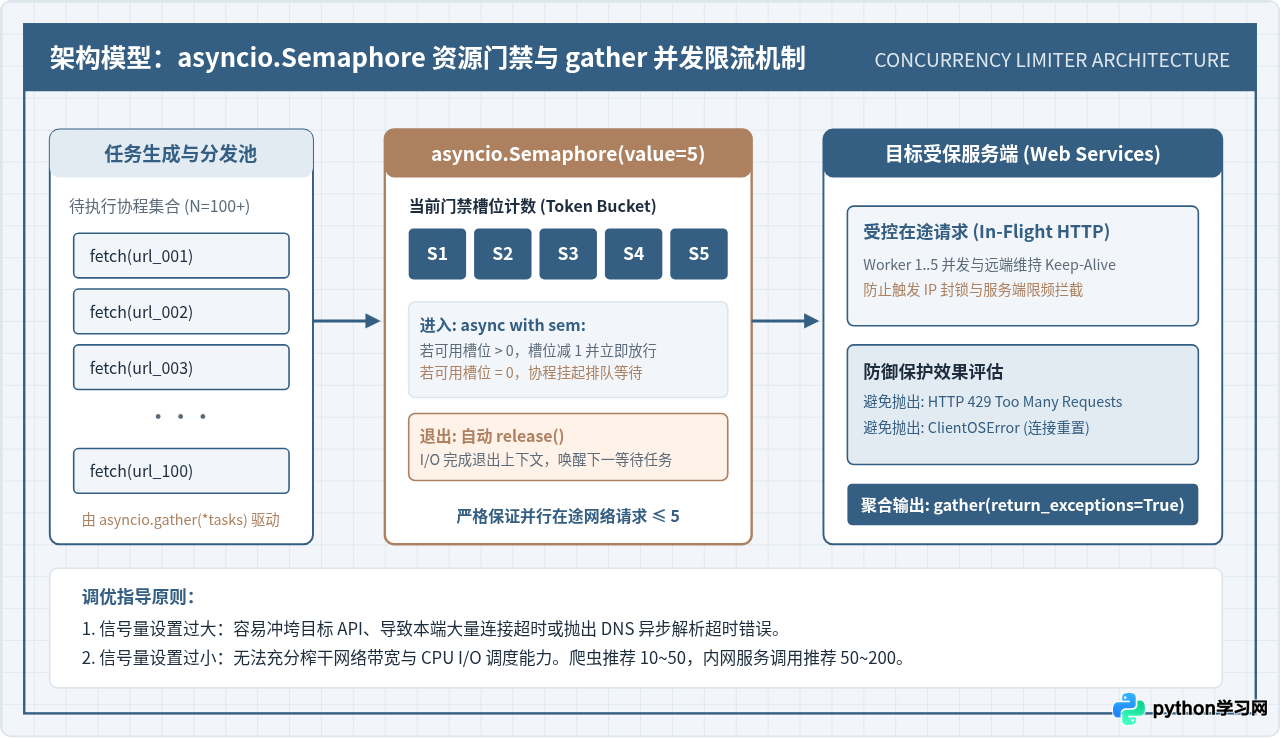
当需要批量抓取几千甚至上万个接口时,很多初学者会直接通过列表推导式生成所有任务并传入 asyncio.gather(*tasks)。这种做法极其危险:
- 本端风险:瞬间打开数千个并发套接字,极易导致操作系统的文件描述符(File Descriptor)耗尽,抛出
Too many open files或ClientOSError。 - 对端风险:巨大的并发突发流量会触发目标服务器的 WAF 防火墙或频率限制(Rate Limiting),返回
429 Too Many Requests并将你的客户端 IP 封禁。
解决这一问题的工程标准手段是引入 asyncio.Semaphore(异步信号量)。信号量内部维护一个计数器,当有协程进入时计数减 1,离开时计数加 1。当计数归零时,后续协程将原地挂起排队,从而将同时在途的网络连接数精确限制在预设阈值以内。
完整工程实战:批量并发抓取与限流脚本
下面是一个工业级可用的批量并发请求示例。代码中整合了信号量限制、超时控制、异常隔离以及结果聚合机制:
PYTHONimport asyncio
import aiohttp
import time
from typing import List, Dict, Any, Optional
async def safe_fetch(
session: aiohttp.ClientSession,
url: str,
semaphore: asyncio.Semaphore,
max_retries: int = 2
) -> Dict[str, Any]:
"""通过信号量保护的异步请求函数,支持失败重试"""
# 限制进入该临界区的并发数量
async with semaphore:
for attempt in range(1, max_retries + 1):
try:
# 针对单个请求配置细粒度超时
async with session.get(url, timeout=aiohttp.ClientTimeout(total=5)) as response:
if response.status == 200:
data = await response.json()
return {"url": url, "status": "success", "data": data}
elif response.status == 429:
# 触发流控,等待后重试
await asyncio.sleep(1.5 * attempt)
continue
else:
return {"url": url, "status": "failed", "http_code": response.status}
except (aiohttp.ClientError, asyncio.TimeoutError) as exc:
if attempt == max_retries:
return {"url": url, "status": "error", "error_message": str(exc)}
await asyncio.sleep(0.5 * attempt)
return {"url": url, "status": "max_retries_exceeded"}
async def batch_fetch_urls(urls: List[str], max_concurrency: int = 5) -> List[Dict[str, Any]]:
# 创建限制并发数的信号量
semaphore = asyncio.Semaphore(max_concurrency)
# 客户端通用连接池配置
connector = aiohttp.TCPConnector(limit=100, ssl=False)
async with aiohttp.ClientSession(connector=connector) as session:
# 创建任务列表
tasks = [safe_fetch(session, url, semaphore) for url in urls]
# return_exceptions=True 确保单个任务异常不影响其他任务继续执行
results = await asyncio.gather(*tasks, return_exceptions=False)
return results
async def main():
# 构造待抓取的目标接口列表
test_urls = [
f"https://httpbin.org/delay/1" for _ in range(10)
]
start_time = time.perf_counter()
print(f"开始批量并发请求,总任务数: {len(test_urls)},最大并发限制: 5")
results = await batch_fetch_urls(test_urls, max_concurrency=5)
cost = time.perf_counter() - start_time
success_count = sum(1 for r in results if r.get("status") == "success")
print(f"抓取完毕!耗时: {cost:.2f}s | 成功: {success_count}/{len(results)}")
if __name__ == "__main__":
asyncio.run(main())
在上面的示例中,总共有 10 个延迟 1 秒的模拟请求。由于设置了 max_concurrency=5,系统会分批以 5 个在途请求的速率推进,最终执行耗时稳定在约 2.1 秒左右,既达到了极高的执行效率,又杜绝了突发峰值流量对服务端的冲击。
五、异步编程常见误区与工程落地总结
为了让编写的异步系统在长期运行中保持稳定高效,开发人员应当对照以下架构分层与避坑清单进行代码审查:
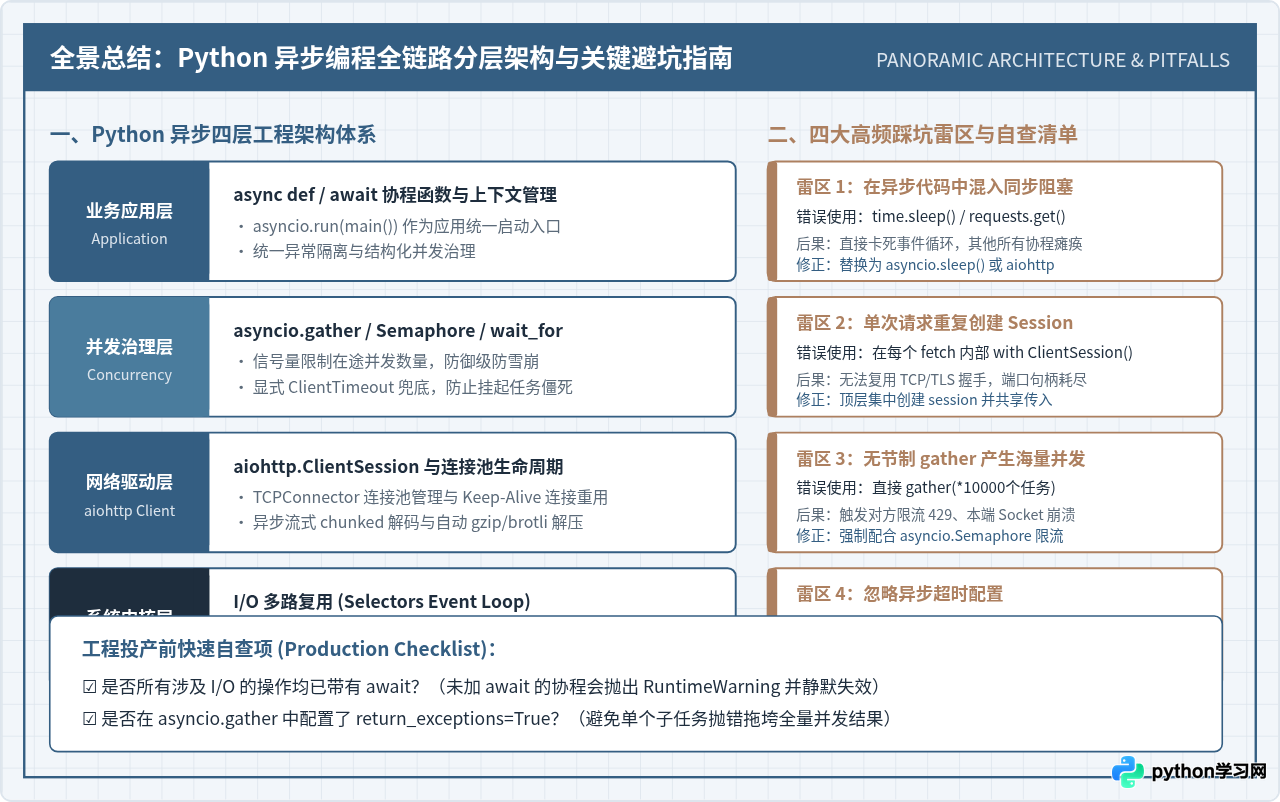
| 常见问题维度 | 高风险错误做法 | 标准生产级规范 |
|---|---|---|
| 阻塞混用 | 在协程中调用 time.sleep() 或同步数据库 ORM 查询。 |
全面使用非阻塞 API。若必须调用不可修改的同步库,使用 asyncio.to_thread() 委派至后台工作线程。 |
| 连接池泄露 | 每次发起请求临时 async with aiohttp.ClientSession()。 |
主协程内保持 Session 单例复用,充分利用底层 TCP Keep-Alive 连接池。 |
| 并发雪崩 | 直接 gather(*10000_tasks) 不设限流。 |
强制配合 asyncio.Semaphore(N),根据对端限频与本端网络设置阈值。 |
| 协程挂死 | 直接发起网络请求,不设置全局或单请求超时。 | 显式传入 aiohttp.ClientTimeout(total=10, connect=3) 兜底。 |
| 异常击穿 | gather 时未加异常捕获,一个任务报错导致全盘中断。 |
使用 gather(return_exceptions=True) 或在单个任务内部使用 try-except 局部兜底。 |
六、总结
asyncio 通过单线程事件循环与协程让出机制,突破了传统同步阻塞网络 I/O 的性能瓶颈;而 aiohttp 则在套接字与协议层之上,提供了优雅高效的异步 HTTP 请求客户端。
在实际工程开发中,编写出可靠异步代码的关键并不在于死记语法,而在于树立清晰的系统观念:始终复用连接会话、严格控制并发阈值、显式防御网络超时,并确保所有 I/O 操作均处于非阻塞管辖之下。掌握了本文介绍的模式与防护策略,你就可以自信地将异步能力应用到海量数据采集、分布式接口调用以及高吞吐后端微服务的开发当中。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









