

python必背源代码数据类dataclass代码
全面梳理Python标准库dataclass核心源代码与必背经典模板,覆盖基础声明、可变默认容器避坑、不可变冻结模型、生命周期校验、自定义排序及slots性能调优。
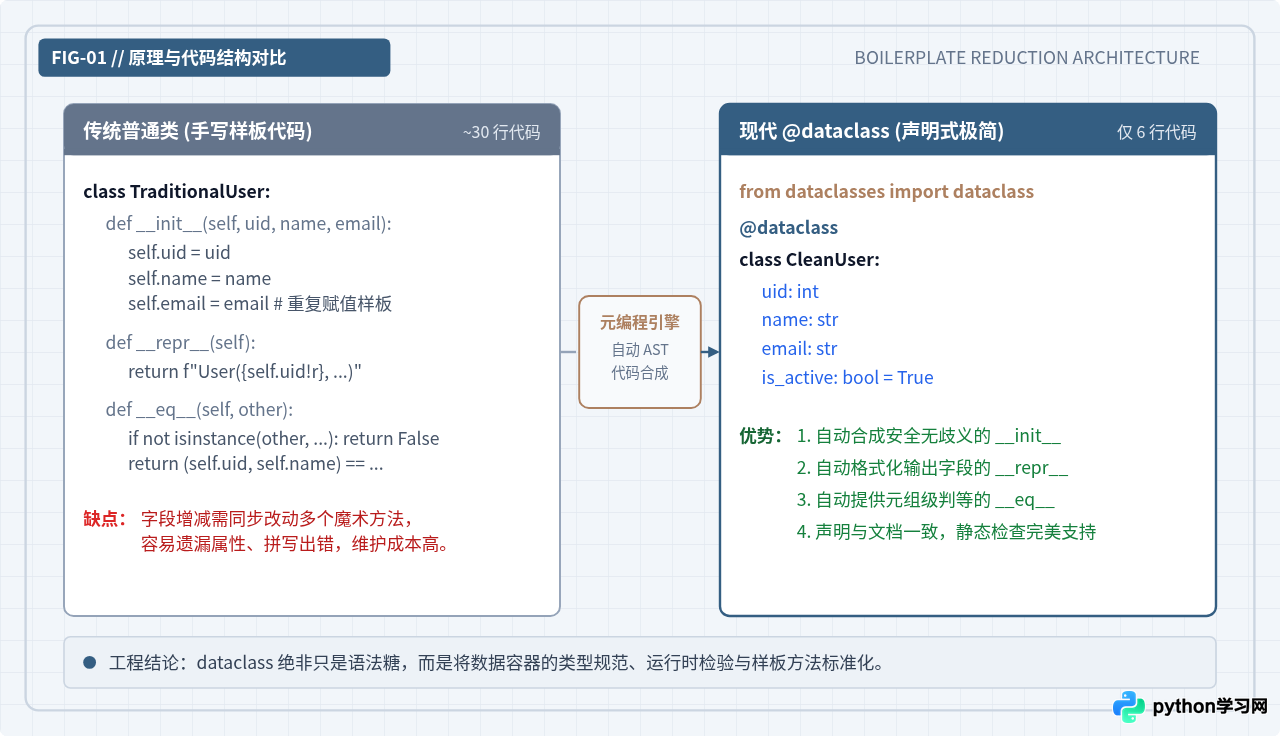
dataclass)是自 Python 3.7 引入的标准库特性。它通过声明式类型注解,在类定义阶段自动生成 __init__、__repr__、__eq__ 等重复率极高的样板代码。掌握数据类最核心的 6 个必背源代码模板,能够帮助开发者在日常编码中快速消除冗长代码、规避可变默认值共享陷阱,并构建类型严谨、内存高效的数据实体模型。
一、必背模板 1:基础数据容器与自动样板生成
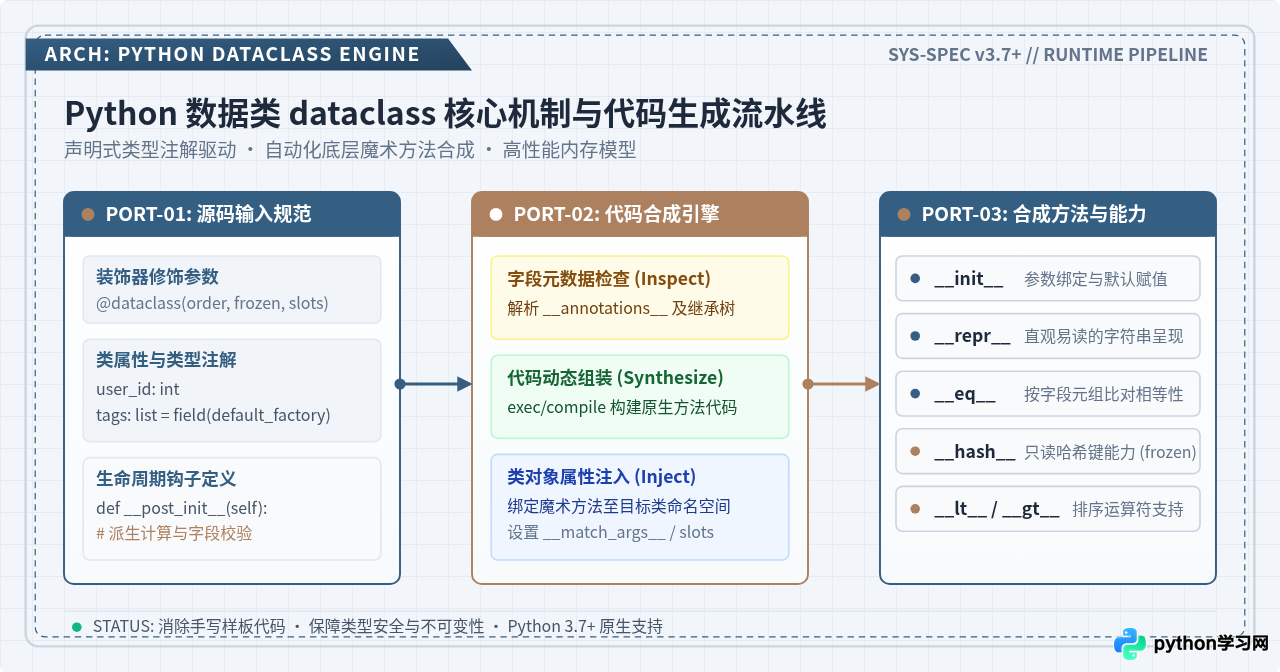
在日常开发中,若仅为封装多个属性而编写传统普通类,需要手动编写参数逐一赋值的 __init__、便于打印排查的 __repr__ 以及按属性判断相等的 __eq__。这些样板代码容易出现变量名拼写错误,并且在增删字段时需要同步修改多处方法。
基础数据类的必背模板采用 @dataclass 装饰器修饰类,并通过类型注解直接声明属性名称与类型。Python 在加载类时会自动扫描类的 __annotations__,并把对应的初始化与比对方法合成绑定至类命名空间中。
# 示例位置:user_model.py
# 运行环境:Python 3.7+
from dataclasses import dataclass

@dataclass
class UserProfile:
    user_id: int
    username: str
    email: str
    is_active: bool = True

# 实例化与调用验证
user_a = UserProfile(user_id=1001, username="alex", email="alex@example.com")
user_b = UserProfile(user_id=1001, username="alex", email="alex@example.com")

print(user_a)
print("实例是否相等:", user_a == user_b)
从输出可以看出,UserProfile 自动具备了直观的可视化打印输出,且两个属性值相同的不同实例在调用 == 时能够准确判定为相等。未指定默认值的属性必须在带默认值的属性之前声明,这与 Python 普通函数的传参规则完全一致。
二、必背模板 2:容器类型与动态默认值(避开可变默认值陷阱)
在 Python 中定义包含列表(list)、字典(dict)或集合(set)等容器类型的字段时,如果直接书写 tags: list = [],Python 会在加载类定义时直接抛出 ValueError: mutable default <class 'list'> for field tags is not allowed: use default_factory。这是由于直接传递可变对象会导致所有实例共享同一个内存容器。
规避该陷阱的必背规范是导入 field 函数,并使用 default_factory 指定无参构造工厂。每次创建新实例时,数据类都会单独调用工厂函数返回独立的新容器。同时,若希望在日志打印或控制台输出中隐藏敏感信息(如密码或密钥),可以设置 repr=False。
# 示例位置:config_model.py
# 运行环境:Python 3.7+
from dataclasses import dataclass, field
from typing import List, Dict

@dataclass
class AppConfig:
    app_id: str
    # 必背用法:使用 default_factory 隔离容器实例
    tags: List[str] = field(default_factory=list)
    options: Dict[str, str] = field(default_factory=dict)
    # 敏感字段脱敏:不展示在 __repr__ 字符串中
    secret_key: str = field(default="DEFAULT_SECRET", repr=False)

# 独立性验证
cfg1 = AppConfig(app_id="srv-01")
cfg2 = AppConfig(app_id="srv-02")
cfg1.tags.append("production")

print("cfg1:", cfg1)
print("cfg2:", cfg2)
print("tags 是否相互独立:", cfg1.tags is not cfg2.tags)default 和 default_factory 属于互斥参数,不能在同一个 field() 中同时设置。不可变对象(如数字、字符串、元组)可直接赋值或传给 default,可变对象必须通过 default_factory 传递其类型构造器(如 list、dict、set)。
三、必背模板 3:执行流程与属性派生校验(__post_init__ 与 InitVar)
数据类自动生成的 __init__ 仅负责将传入的参数直接挂载到实例属性上。如果需要在对象初始化后执行数据清洗、派生计算(例如根据单价与数量计算总额)或防御性合法校验,必须背诵 __post_init__ 钩子方法。
如果某个参数仅在初始化计算阶段需要使用,而不需要永久保留在实例属性中(不挂载到 __dict__),可以使用 InitVar 标识为“初始化专用变量”。__post_init__ 会按顺序接收所有 InitVar 传入的实参。
# 示例位置:order_model.py
# 运行环境:Python 3.7+
from dataclasses import dataclass, field, InitVar

@dataclass
class OrderItem:
    item_id: str
    unit_price: float
    quantity: int
    # 仅用于初始化的临时参数:折扣率
    discount_rate: InitVar[float] = 1.0
    # 派生字段:不直接由外部构造传参,由 __post_init__ 计算得出
    total_price: float = field(init=False)

    def __post_init__(self, discount_rate: float):
        # 步骤 1:合法性防御校验
        if self.unit_price < 0:
            raise ValueError(f"单价不能为负数: {self.unit_price}")
        if self.quantity <= 0:
            raise ValueError(f"数量必须大于0: {self.quantity}")
        if not (0 < discount_rate <= 1.0):
            raise ValueError(f"折扣率必须在 (0, 1.0] 区间内: {discount_rate}")

        # 步骤 2:动态计算派生字段
        self.total_price = round(self.unit_price * self.quantity * discount_rate, 2)

# 正确创建实例
order = OrderItem(item_id="ORD-2026-001", unit_price=128.5, quantity=2, discount_rate=0.9)
print(order)
print("是否存在 discount_rate 属性:", hasattr(order, "discount_rate"))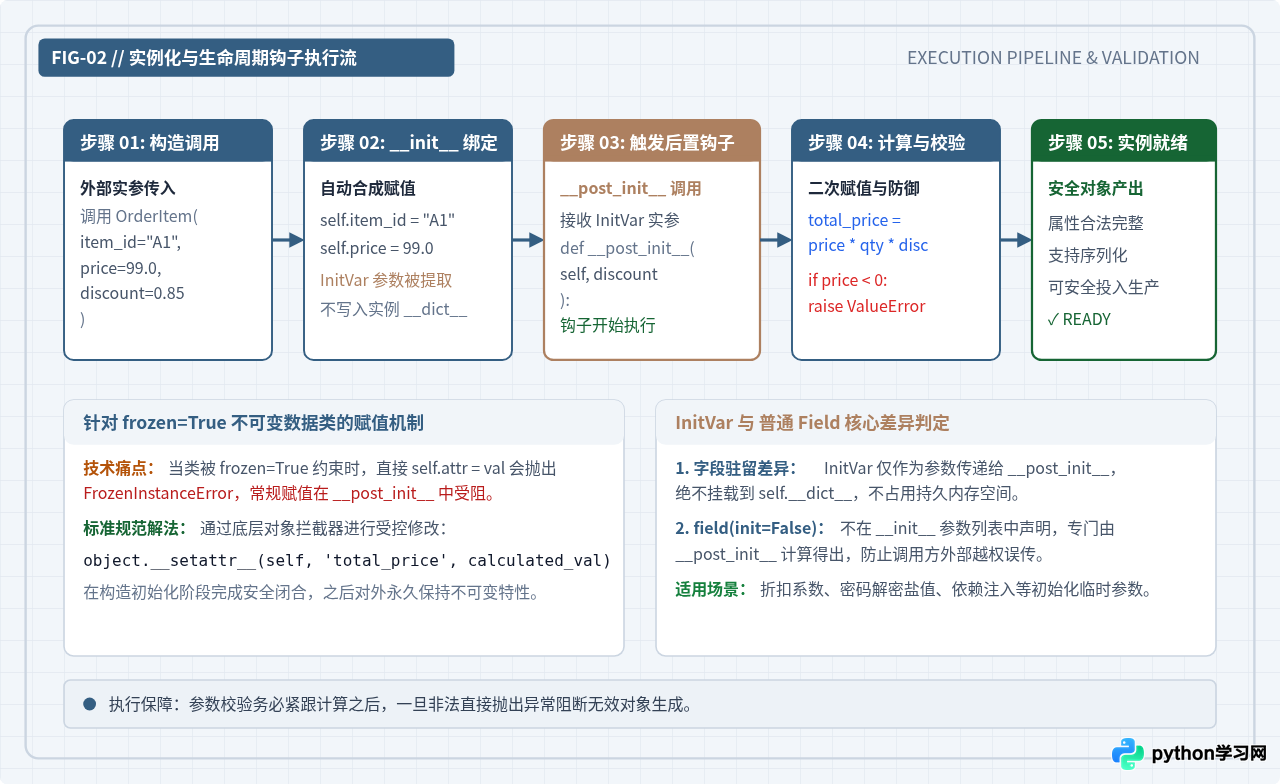
四、必背模板 4:只读不可变安全模型(frozen 与哈希能力)
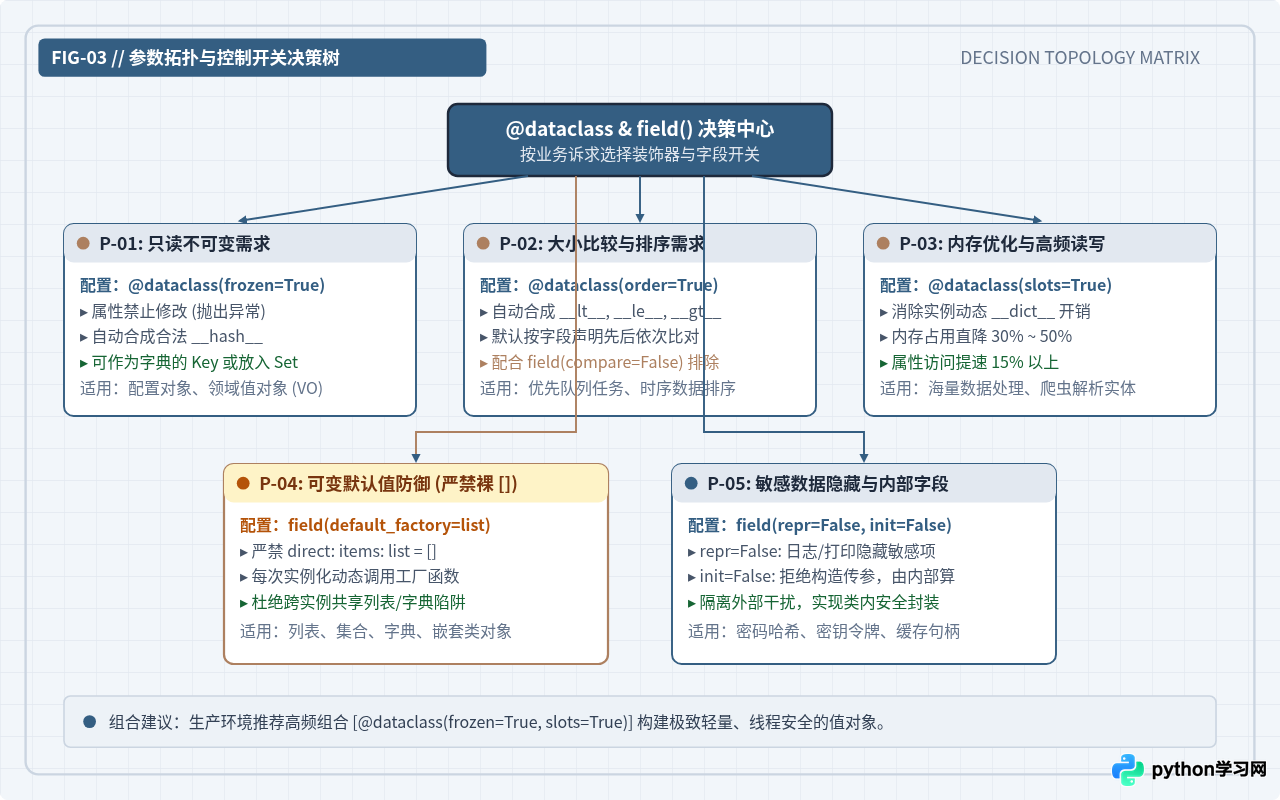
在多线程并发读取、全局不可变配置分发,或者需要将对象实例存入 set 或作为 dict 的键(Key)时,对象必须具备不可变性与哈希一致性。普通数据类在默认情况下是可变的,并且 Python 会明确禁用其 __hash__ 方法以防键值漂移。
通过设置 @dataclass(frozen=True),可以将实例属性设定为只读。一旦对象完成初始化,任何对实例属性的直接修改都会触发 FrozenInstanceError,同时装饰器会自动基于全部参与判等的字段合成 __hash__。
# 示例位置:coord_model.py
# 运行环境:Python 3.7+
from dataclasses import dataclass

@dataclass(frozen=True)
class GeoCoordinate:
    latitude: float
    longitude: float
    label: str = "WGS84"

# 实例化
coord = GeoCoordinate(latitude=31.2304, longitude=121.4737)
print("坐标哈希值:", hash(coord))

# 能够直接放入集合和作为字典的键
coord_cache = {coord: "Shanghai Station"}
print("缓存检索结果:", coord_cache[coord])

# 尝试篡改属性会抛出异常
try:
    coord.latitude = 39.9042
except Exception as e:
print("拦截篡改异常类型:", type(e).__name__)frozen=True 的类中编写 __post_init__ 给派生字段赋值,直接使用 self.attr = val 会被只读保护机制拦截。标准做法是使用底层对象属性注入:object.__setattr__(self, 'attr', val),即可在初始化阶段合法赋值。
五、必背模板 5:自定义比较与排序策略(order 与 compare 细粒度控制)
当数据实体需要放入优先队列(如 heapq)、支持 list.sort() 或直接进行 <、<=、>、>= 大小比对时,无需手动重载全部富比较方法,仅需声明 @dataclass(order=True)。
默认的比对规则是将所有字段按声明顺序组成一个虚拟元组进行逐项比较。如果某些描述性字段(如任务名称、创建人备注)不应影响排序顺序,必须在字段定义中通过 field(compare=False) 明确将其排除出比较计算。
# 示例位置:task_queue.py
# 运行环境:Python 3.7+
from dataclasses import dataclass, field

@dataclass(order=True)
class ScheduledTask:
    # 权重优先参与比对(数值越小优先级越高)
    priority: int
    task_id: str
    # 描述信息与重试次数不参与大小比对
    description: str = field(compare=False)
    retry_count: int = field(default=0, compare=False)

task1 = ScheduledTask(priority=1, task_id="B-001", description="生成离线报表")
task2 = ScheduledTask(priority=2, task_id="A-002", description="刷新用户缓存")
task3 = ScheduledTask(priority=1, task_id="A-003", description="发送短信验证码")

task_list = [task2, task1, task3]
task_list.sort()

for t in task_list:
    print(f"优先级: {t.priority} | 编号: {t.task_id} | 说明: {t.description}")
由输出可知,在 priority 相同的情况下,比较逻辑自动顺延到第二个字段 task_id 进行字符串字典序比对,而标记了 compare=False 的 description 则不参与任何比对决策。
六、必背模板 6:数据序列化转换与内存优化(asdict、replace 与 slots)
数据类通常充当系统边界的数据载体。在与数据库交互、API JSON 格式化或者调用第三方接口时,需要将其转换为标准字典或元组。标准库提供了 asdict() 与 astuple() 函数,能够对嵌套数据类递归完成深拷贝转换。
此外,当处理不可变数据类时,如果需要基于现有对象衍生一个仅修改部分字段的新对象,无需手动解包,直接调用 replace() 函数即可。而在 Python 3.10 及以上版本中,通过启用 @dataclass(slots=True),可以为类自动生成 __slots__,消除传统类的 __dict__ 内存开销,使海量对象运行时的内存占用减少 30% 到 50%,并显著加快属性读写速度。
# 示例位置:transform_and_slots.py
# 运行环境:Python 3.10+ (slots 特性)
from dataclasses import dataclass, asdict, replace
import json

# 开启 slots 压榨内存与加速属性访问
@dataclass(slots=True)
class SensorReading:
    sensor_id: str
    temperature: float
    humidity: float

reading = SensorReading(sensor_id="TEMP-01", temperature=24.6, humidity=58.2)

# 1. 递归转换为字典与 JSON 字符串
reading_dict = asdict(reading)
json_payload = json.dumps(reading_dict)
print("序列化 JSON 载荷:", json_payload)

# 2. 安全复制并替换局部字段
calibrated_reading = replace(reading, temperature=24.8)
print("修正后对象:", calibrated_reading)

# 3. 验证 slots 是否生效(无 __dict__)
print("是否存在 __dict__ 属性:", hasattr(reading, "__dict__"))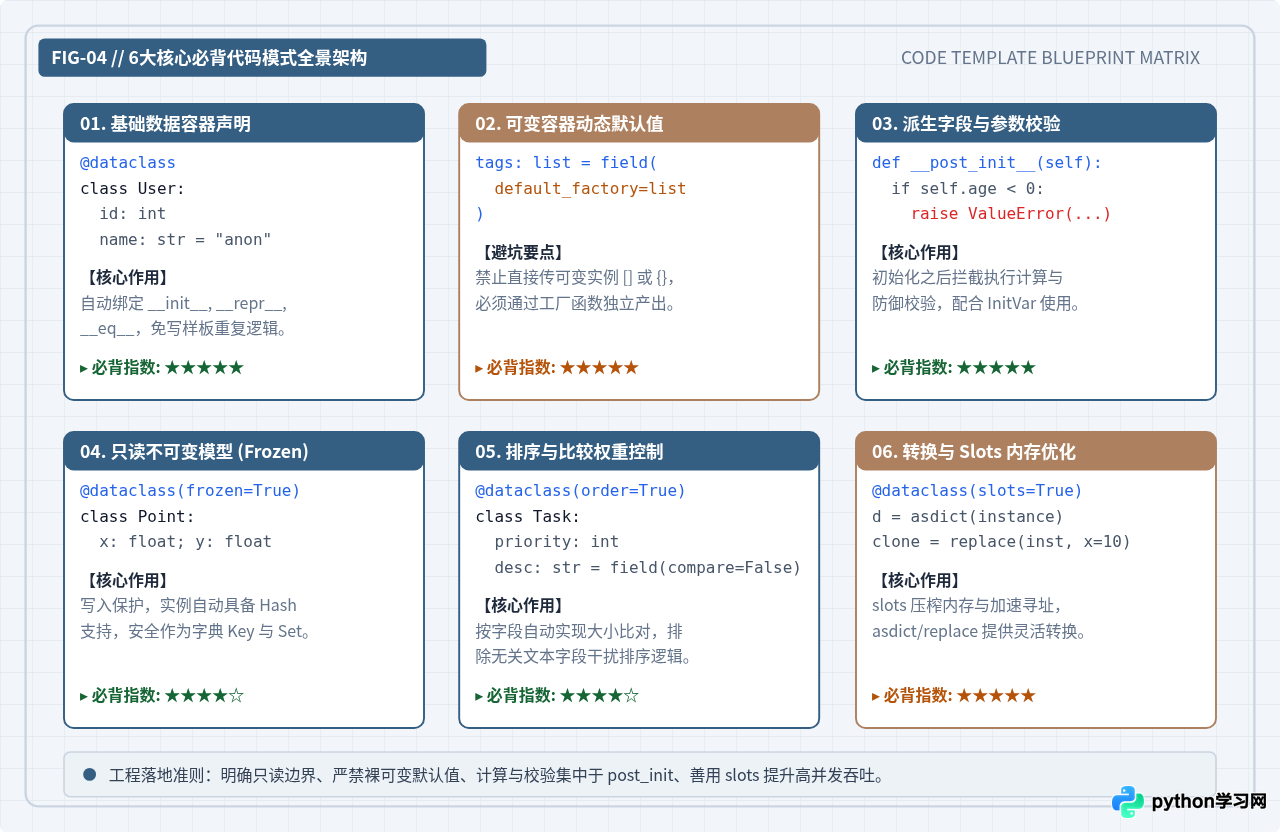
七、核心代码模式与选型参数速查
为了便于在工程实战中快速选型与代码审查,下表汇总了数据类最核心的参数组合、适用场景及主要约束条件:
| 必背代码模式 | 核心装饰器 / 字段声明 | 典型适用场景 | 核心注意事项 |
|---|---|---|---|
| 基础数据容器 | @dataclass |
通用业务实体、DTO(数据传输对象) | 无默认值的字段必须置于有默认值字段之前 |
| 动态可变默认值 | field(default_factory=list/dict) |
列表、字典、集合类内部字段 | 严禁直接使用 [] 或 {} 作为默认值 |
| 初始化派生校验 | __post_init__ + InitVar |
属性合法性检查、二次计算字段 | 派生字段通常配合 field(init=False) |
| 不可变只读模型 | @dataclass(frozen=True) |
系统配置项、集合元素、字典 Key | 内部若有后置计算需用 object.__setattr__ |
| 排序权重控制 | @dataclass(order=True) |
优先队列、按时间或权重排序任务 | 使用 field(compare=False) 剔除无关字段 |
| 内存与转换优化 | @dataclass(slots=True) |
海量实例处理、日志流解析实体 | Python 3.10+ 支持;转换使用 asdict |
综上所述,Python dataclass 的价值不仅在于减少日常代码行数,更在于通过标准的底层协议与声明规范,提升整体工程的可读性与健壮性。掌握上述 6 组核心源代码模板,能够应对绝大部分业务建模与数据处理场景。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









