

怎么在Python遍历字典时同时获取键和值?
详细解答在Python遍历字典时同时获取键和值的标准高效方法items(),解析元组解包底层原理、dict_items视图对象机制、结合enumerate多层解包以及防止遍历中动态修改字典的实用避坑指南。
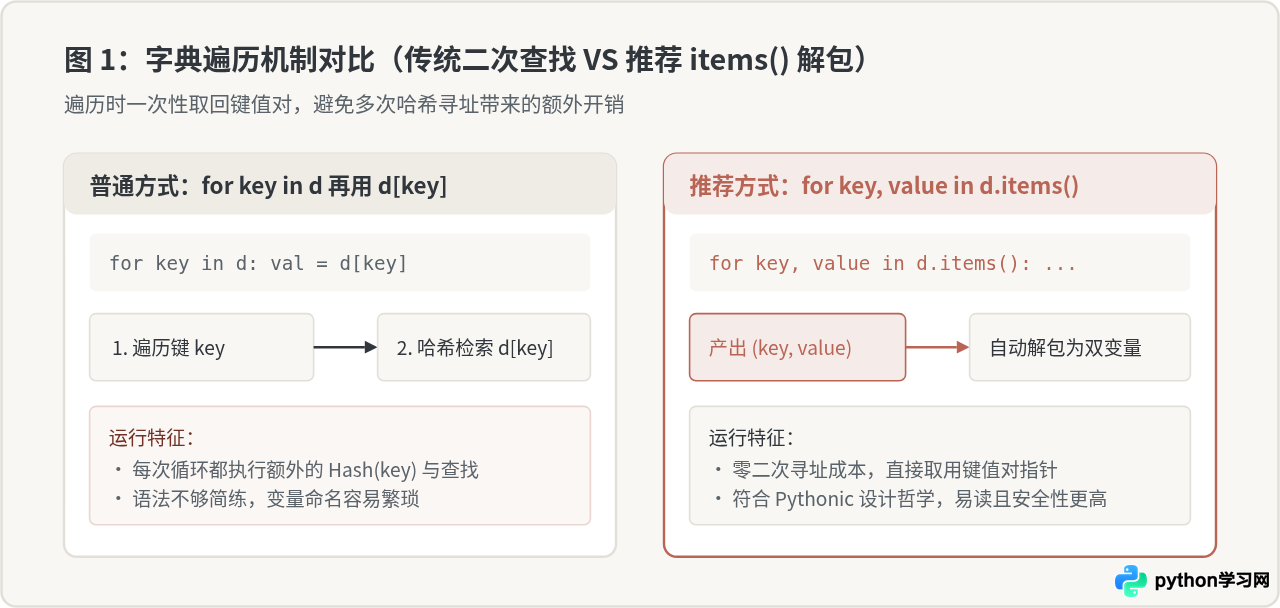
.items() 方法,并利用循环变量自动进行元组解包:for key, value in dictionary.items():。这种写法无需二次哈希检索,代码直观且性能最佳。
一、标准解法:items() 方法与元组解包
初学 Python 时,很多读者习惯直接对字典对象运行 for 循环。在默认情况下,直接遍历字典只会依次产出所有的键(keys),若想拿到对应的值,通常会写出形如 value = d[key] 的代码。虽然逻辑上可行,但这不仅增加了额外的代码行数,还会导致每一次循环都重复进行一次哈希索引查询。
Python 提供了内建的 .items() 方法。当对字典调用该方法时,循环机制在每一次迭代中都会产出一个形如 (key, value) 的二元元组。Python 解释器支持直接将元组中的元素解构到两个独立的临时变量中,这就是“元组解包(Tuple Unpacking)”。
# 示例 1:使用 items() 同时获取键和值
user_profile = {
    "name": "张伟",
    "role": "研发工程师",
    "department": "数据技术部",
    "level": "P7"
}

# 推荐的标准写法
for key, value in user_profile.items():
    print(f"属性字段: {key:12} => 对应内容: {value}")
运行该段代码,终端将依次输出字典的每一个字段名称及其对应的内容。这种语法结构不仅视觉上非常紧凑,而且在语义上明确地传达了“成对处理数据”的意图。
二、深入机制:视图对象与性能
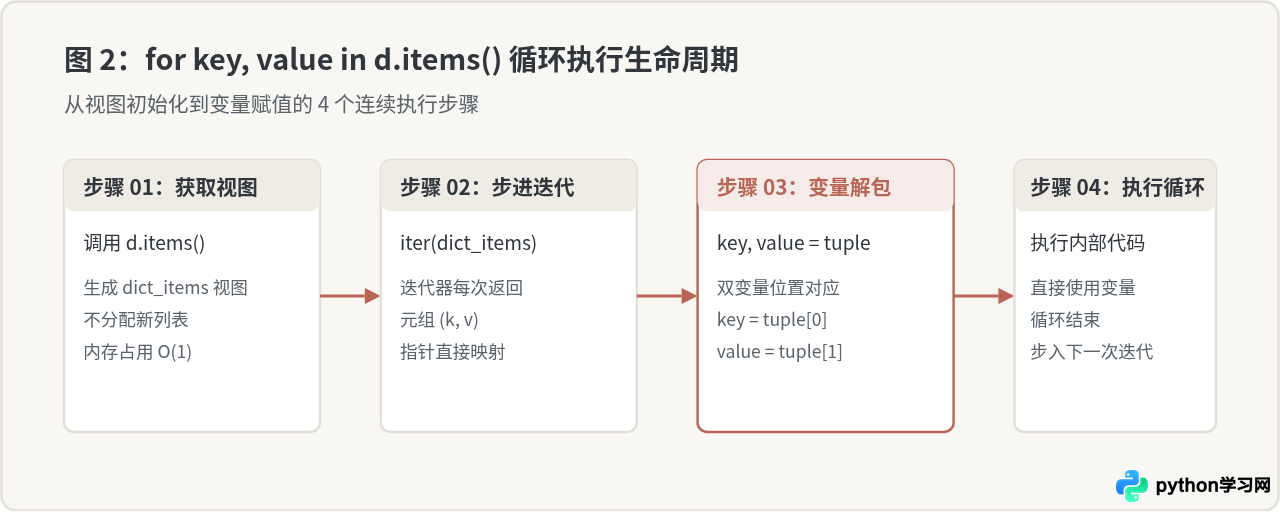
理解 items() 的底层机制有助于写出内存占用更低的代码。在 Python 2 时代,调用 d.items() 会在内存中立即完整复制一份由所有键值元组组成的真实列表(List),当字典数据量达到百万级时容易造成显著的内存开销(为此 Python 2 当时提供了生成器版本的 iteritems())。
在当今通用的 Python 3 中,d.items() 返回的是一个轻量级的视图对象(View Object),具体类型为 dict_items。它具备如下关键特征:
- 动态只读反射: 视图本身不占用独立的键值拷贝空间,其内存占用为恒定的 $O(1)$,它直接引用原字典底层的连续哈希数组。
- 随动变化: 如果在创建视图后、开始迭代前原字典内容发生了变动,视图会即时反映最新数据。
- 支持集合运算:
dict_items集合视图如果其中的键和值都是可哈希类型,甚至可以直接支持并集|、交集&等集合运算符。
三、常见实际应用场景与衍生技巧
掌握了 items() 的基础用法后,在实际项目中还可以结合 Python 的其他语言特性实现更紧凑、优雅的操作。
1. 同时需要计数序号:结合 enumerate()
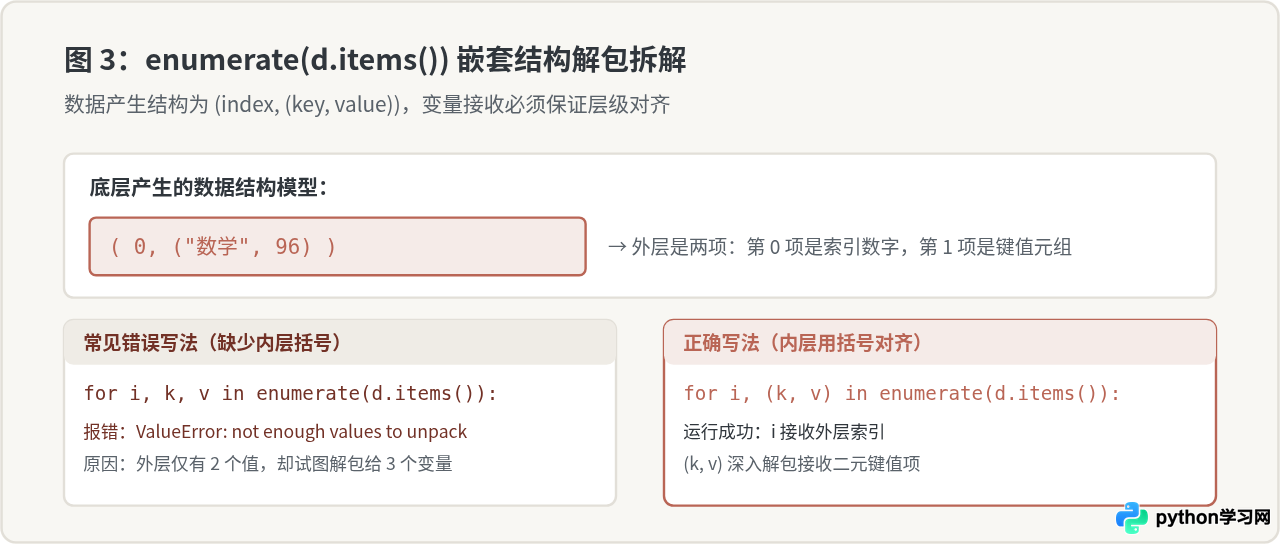
有时不仅需要键和值,还需要打印出当前项目的序列号(从 1 或从 0 开始)。这时可以使用 Python 内置的 enumerate() 函数。但需要特别注意元组嵌套解包的括号匹配:
scores = {"数学": 96, "物理": 89, "化学": 92}

# 正确写法:给 (key, value) 套上一对小括号进行嵌套解包
for index, (subject, score) in enumerate(scores.items(), start=1):
    print(f"序号 [{index}] 科目: {subject} => 成绩: {score}")
2. 字典推导式:过滤与转换
当任务不是为了打印输出,而是要基于已有字典生成一个新的过滤后或计算后的字典时,items() 与字典推导式(Dictionary Comprehension)是绝配:
# 场景:筛选成绩合格(>= 60)的学生并加权计算
raw_scores = {"小明": 75, "小红": 58, "小刚": 90, "小美": 85}

# 结构:{新键: 新值 for 键, 值 in 字典.items() if 筛选条件}
passed_students = {
    name: score * 1.1
    for name, score in raw_scores.items()
    if score >= 60
}

print(passed_students)
# 示例输出: {'小明': 82.5, '小刚': 99.0, '小美': 93.5}
3. 键值反转(Inverting a Dictionary)
如果需要将字典的“键”与“值”对调,通过遍历 items() 能一行代码搞定。不过前提是:字典原有的所有值必须是可哈希类型(如字符串、数字或元组),且没有重复值(若有重复值,后者会覆盖前者):
code_to_status = {200: "OK", 404: "Not Found", 500: "Server Error"}

# 互换位置:以 value 为键,以 key 为值
status_to_code = {status: code for code, status in code_to_status.items()}

print(status_to_code["OK"])  # 示例输出: 200
四、避坑准则:遍历过程中的常见陷阱
del d[k] 删除或 d[new_k] = v 新增操作!
很多新手在按条件清理字典数据时容易写出类似下面的错误代码:
# ❌ 错误示范:在遍历过程中直接变动字典键集
data = {"a": 1, "b": 2, "c": 3}
for k, v in data.items():
    if v % 2 == 0:
        del data[k]  # 触发异常!
# 运行时报错:RuntimeError: dictionary changed size during iteration
发生原因: Python 字典底层的迭代器维护着内部散列表的哈希表大小标记。如果在迭代过程中向字典插入或删除了键,哈希表的内存尺寸可能重构,破坏迭代器遍历状态,因此解释器会立即抛出 RuntimeError 保护程序状态。
稳妥解决方案:
- 方案 A(推导式新建): 推荐优先使用字典推导式创建符合条件的新字典,既安全又速度快。
- 方案 B(转为静态列表): 如果必须原地修改,可以使用
list(d.items())或list(d.keys())将视图转为静态列表快照,再进行循环遍历。由于遍历的是快照列表,原字典的增删不会干扰列表迭代器。
# 方案 B 代码示例:
data = {"a": 1, "b": 2, "c": 3}
for k, v in list(data.items()):
    if v % 2 == 0:
        del data[k]  # 安全删除,遍历的是快照
五、四种遍历方式对比与选型指南
在实际编写 Python 业务代码时,字典提供了多种遍历途径,根据需要获取的数据形态选择最精准的方法,能够最大程度提升代码的可读性和执行效率。
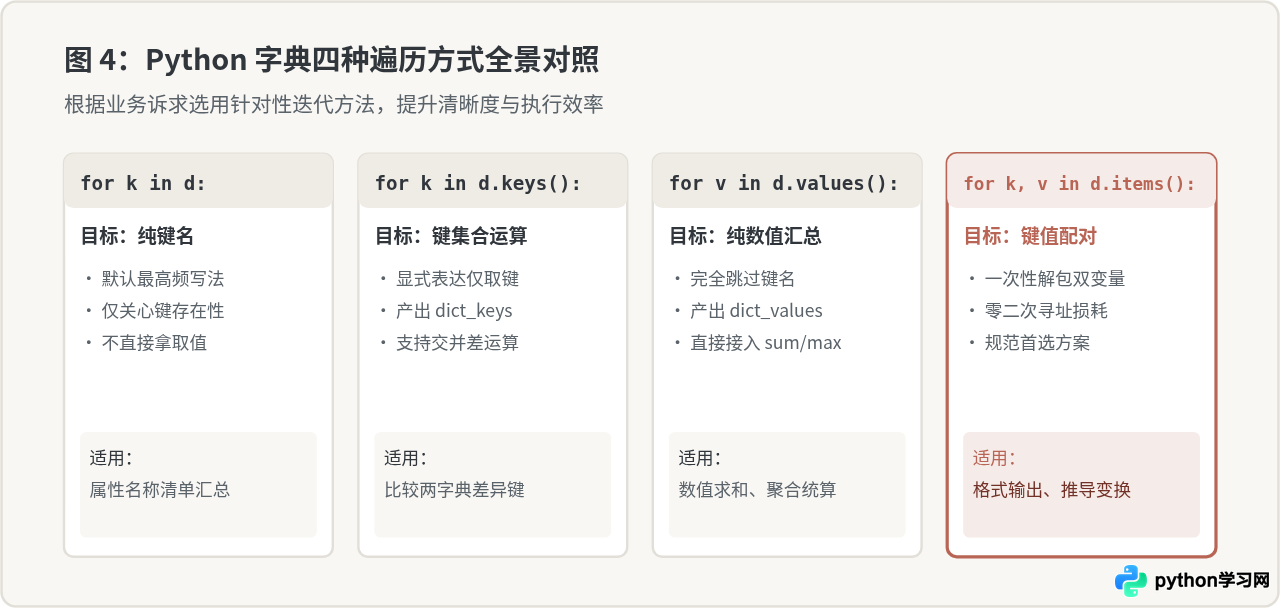
| 遍历写法 | 每次循环产出 | 返回值类型 | 常见场景 |
|---|---|---|---|
for k in d: |
单个键 k |
字典迭代器 | 只需使用键名,或仅检查键存在性 |
for k in d.keys(): |
单个键 k |
dict_keys 视图 |
显式表达意图,或利用集合操作进行差集对比 |
for v in d.values(): |
单个值 v |
dict_values 视图 |
不需要关心键名,直接对数据进行汇总或统计 |
for k, v in d.items(): |
键值对元组 (k, v) |
dict_items 视图 |
同时操作键与对应的值(推荐首选) |
六、总结
在 Python 中同时获取字典的键与值,只需牢记核心语法 for key, value in dictionary.items():。这一写法的底层逻辑是借助 dict_items 轻量级视图对象与 Python 的自动元组解包特性,一次性将键和值的引用绑定到指定变量,避免了额外的哈希寻址。在需要带序号遍历时,配合 enumerate(d.items()) 时注意给键值对加上内层括号 (key, value);若涉及对字典的动态增删,切记利用 list(d.items()) 创建快照或通过字典推导式生成新对象,从而编写出高效、健壮的 Python 代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









