

Python遍历字典的三种基本方法:keys、values与items
深入讲解Python字典遍历的三种基本方法:keys()、values()与items()。结合底层视图对象机制、代码示例、性能对比与常见避坑指南,帮助读者掌握高效、规范的Python字典遍历技巧。
一、核心认知:Python 字典的视图对象(View Objects)
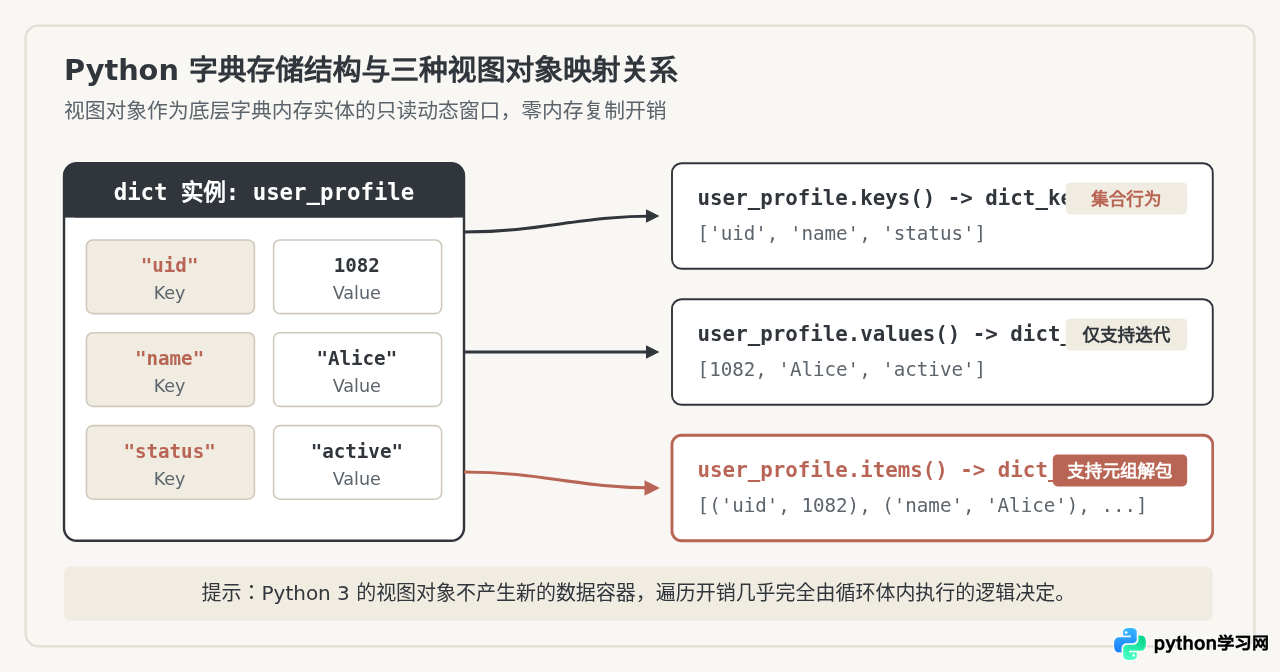
在 Python 3 中,调用字典的 keys()、values() 或 items() 方法时,返回的并非独立的静态列表(List),而是被称为“字典视图”(Dictionary View Objects)的专用对象。
这些视图对象具备两大关键特性:
- 动态实时性(Dynamic Reflection): 视图对象并不会在调用时复制字典中的元素。若底层字典在后续操作中发生增删改,视图中的数据会实时联动更新。
- 内存友好与常数级开销: 生成视图对象的时间复杂度为 $O(1)$,不管字典中存储了 10 个键值对还是 1000 万个键值对,都不会触发额外的内存拷贝。
二、方法一:使用 keys() 遍历键(及与直接遍历的取舍)
dict.keys() 返回一个包含字典全部键名的 dict_keys 视图。它的核心目的是让开发者专注于字典的属性名或索引集。
1. 基础用法与代码示例
以下是一个使用 keys() 检查并过滤系统中所有设置项名称的典型场景:
# 环境:Python 3.8+
config = {
    "host": "127.0.0.1",
    "port": 8080,
    "debug": True,
    "timeout": 30
}

# 显式使用 .keys() 进行键名遍历
for key in config.keys():
    print(f"配置项名称: {key}")
配置项名称: port
配置项名称: debug
配置项名称: timeout
2. 关键对比:for k in d.keys() 与 for k in d
在 Python 中,字典本身就是一个可迭代对象。对字典直接进行 for k in d 循环时,默认行为就是迭代该字典的键。
两者的效率在 CPython 实现中完全等价(底层均使用相同的键迭代器),但在代码工程风格上有明确的最佳实践:
- 常规循环中,优先采用直接遍历: 编写
for key in config:更加精炼,也是 Python 社区公认的 Pythonic 写法。 - 涉及集合运算时,必须显式调用
.keys():dict_keys实现了collections.abc.Set协议,支持直接与其他集合或键视图进行交集(&)、并集(|)或差集(-)计算,例如:# 快速校验必填字段是否缺失 required_fields = {"host", "port", "secret_key"} missing = required_fields - config.keys() print(f"缺失字段: {missing}") # 输出: 缺失字段: {'secret_key'}
三、方法二:使用 values() 遍历值
当业务逻辑完全不关心键名,仅需对数据值进行聚合、筛选、极值查找或类型断言时,应选用 dict.values()。
1. 基础用法与代码示例
例如统计班级学员的考试成绩,或者核算商场购物车的合计总价:
# 环境:Python 3.8+
fruit_inventory = {
    "apple": 120,
    "banana": 85,
    "orange": 210,
    "watermelon": 45
}

# 1. 遍历库存值并打印警戒提示
for count in fruit_inventory.values():
    if count < 50:
        print(f"发现紧缺库存项,当前余量: {count}")

# 2. 与内置函数直接配合
total_units = sum(fruit_inventory.values())
max_stock = max(fruit_inventory.values())
print(f"总库存件数: {total_units}, 单品最高库存: {max_stock}")
总库存件数: 460, 单品最高库存: 210
dict.values() 返回的值序列不具备哈希表索引特性。如果试图在遍历 values() 的过程中反推对应的键名,只能通过遍历原字典进行值匹配,时间复杂度高达 $O(n)$。若业务场景频繁需要通过值查键,应在初始化时构建倒排字典(Inverted Dict)。
四、方法三:使用 items() 同时遍历键与值(元组解包)
dict.items() 是生产代码中应用最为广泛的遍历方法。它返回包含 (key, value) 双元素元组的 dict_items 视图,配合 Python 优雅的变量解包语法,可以同时拿到键与值。
1. 基础用法与代码示例
以下演示同时格式化输出用户信息,并在遍历中进行条件分支判断:
# 环境:Python 3.8+
user_roles = {
    "Alice": "Admin",
    "Bob": "Editor",
    "Charlie": "Viewer",
    "David": "Viewer"
}

# 推荐规范:利用元组解包同时获取 key 和 value
for username, role in user_roles.items():
    print(f"用户 [{username}] 当前权限等级为: {role}")
用户 [Bob] 当前权限等级为: Editor
用户 [Charlie] 当前权限等级为: Viewer
用户 [David] 当前权限等级为: Viewer
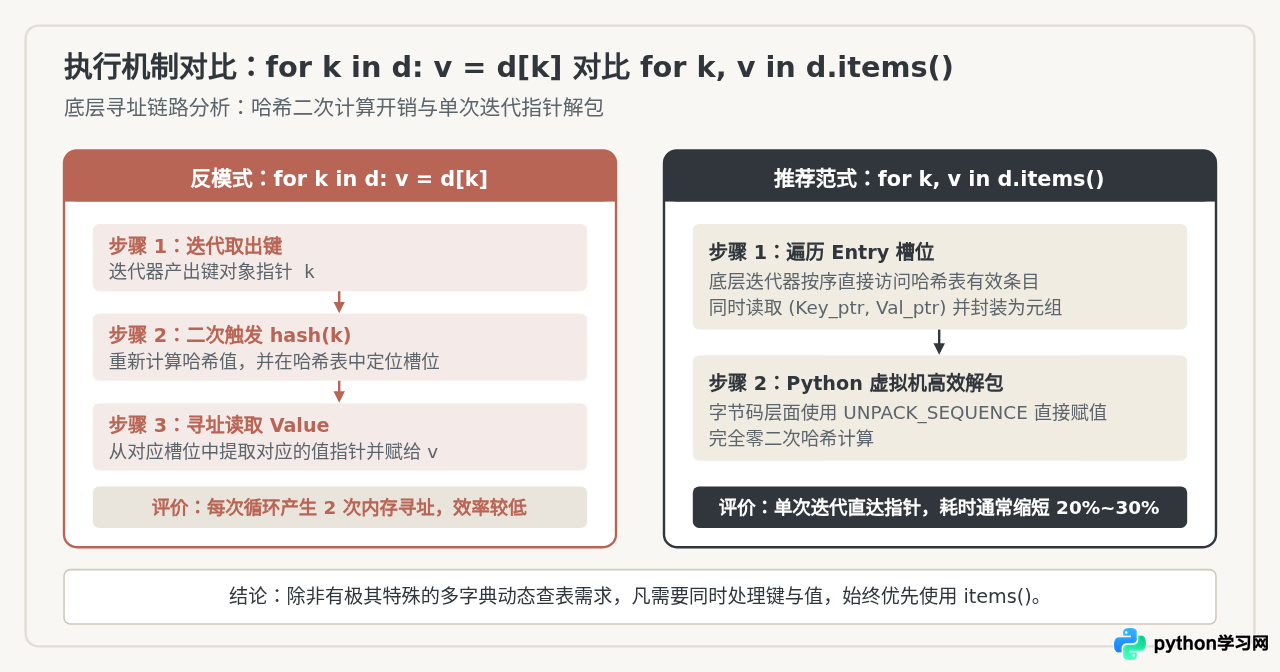
2. 为什么坚决避免 for k in d: v = d[k]
很多有其他语言背景的初学者,容易写出通过键再次回表查值的代码:
# 反模式(Anti-Pattern):不推荐!
for k in user_roles:
    v = user_roles[k]  # 产生了不必要的哈希计算与寻址开销
    print(k, v)
这种写法存在两大弊端:
- 重复哈希寻址(Double Hash Lookup): 循环内部每次执行
d[k],Python 解释器都要对k重新计算哈希值、查找哈希槽、解析内存指针。而d.items()在底层一次遍历即可直接取得条目中的键指针和值指针,省去了二次查找。 - 代码冗余且意图模糊: 显式元组解包
for k, v in d.items():明确传达了“本次遍历同时依赖键和值”的意图,可读性显著更佳。
五、遍历选型与操作实施步骤
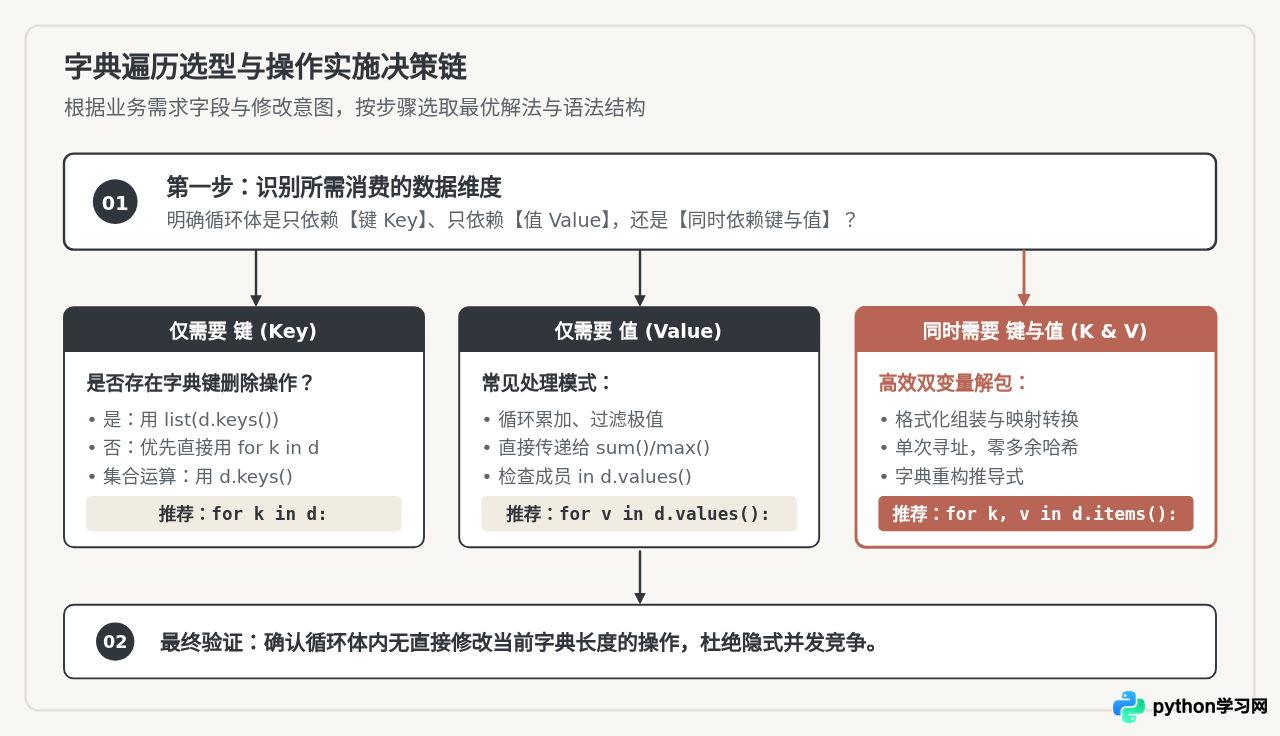
在实际业务开发中,选择哪种遍历方式并非凭感觉决定,而应当根据“数据消费目标”与“是否有结构变更”两个维度进行推导。
标准实施三步法
- 明确访问范围: 若只打印或检查键,用
for k in d;若只聚合数值,用for v in d.values();若打印键值映射,必须用for k, v in d.items()。 - 排查结构改动: 检查循环体内部是否存在
del d[k]或d[new_k] = val。如果存在,立即参照下文介绍的快照法(Snapshot)进行隔离。 - 验证输出与性能: 在百万级数据场景下,避免在循环体内再次调用
d.keys()或d.values(),避免重复生成临时视图。
六、避坑指南:遍历过程中的常见陷阱与反例
陷阱一:在遍历过程中直接增删字典键导致 RuntimeError
这是 Python 开发者最常遭遇的运行时错误之一。当我们在遍历视图时,如果试图直接向字典添加新键或删除现有键,Python 会立即抛出异常:
# 错误示范:在遍历中就地删除键
user_scores = {"Alice": 95, "Bob": 58, "Charlie": 42}

for name, score in user_scores.items():
    if score < 60:
        del user_scores[name]  # 触发异常!
原理解释: 前文提到,字典视图对象是底层字典的实时投影,并不拥有独立拷贝。为了防止在修改散列表底层存储结构时出现哈希槽错乱或死循环,Python 在迭代器内部设置了状态版本检查(mutation check),一旦发现字典长度改变便主动中断报错。
安全解决方案有两种:
- 方案 A(快照遍历法): 使用
list()将键或条目固化为静态列表快照:# 正确做法:对快照列表进行遍历,安全修改原字典 for name in list(user_scores.keys()): if user_scores[name] < 60: del user_scores[name] print(user_scores) # 输出: {'Alice': 95}
- 方案 B(字典推导式新建法): 避免就地修改,直接构建符合条件的新字典:
# 更加推荐的无副作用写法
user_scores = {k: v for k, v in user_scores.items() if v >= 60}
陷阱二:反模式与推荐写法的底层机制差异
为什么说 for k, v in d.items() 是最优解,而 v = d[k] 是次选?下图直观展示了两种写法在底层的寻址执行路径:
七、方法全景对比与速查矩阵
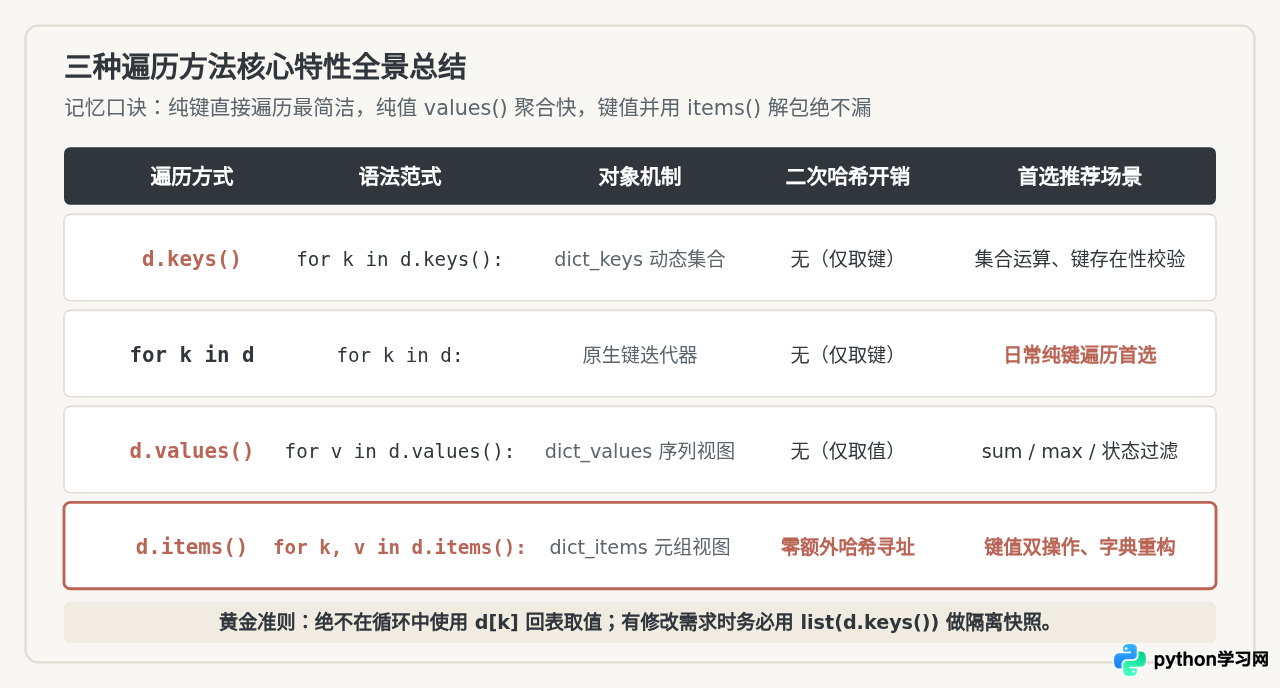
为了便于在工程实战中快速对比,下表归纳了 Python 字典三种基本方法及其直接遍历形式的关键属性:
| 方法 / 语法 | 返回类型 | 典型写法 | 集合操作支持 | 最适用业务场景 |
|---|---|---|---|---|
dict.keys() |
dict_keys |
for k in d.keys(): |
支持(交、并、差) | 多字典键名求交差集、显式只读键遍历 |
for k in d(隐式) |
键迭代器 | for k in d: |
不支持集合符号运算符 | 日常最地道的纯键遍历写法 |
dict.values() |
dict_values |
for v in d.values(): |
不支持 | 纯数值累加、极值查找、状态标志校验 |
dict.items() |
dict_items |
for k, v in d.items(): |
支持(仅当 values 均为可哈希对象) | 键值对提取、数据结构转换、格式化报表输出 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









