

Python遍历字典时怎么获取下标序号

在 Python 中,字典(dict)是键值对映射容器,并不像列表或元组那样原生支持通过数值下标(例如 dict[0])直接索引元素。要在循环遍历字典时同时获取从 0(或指定数字)开始递增的序号,最标准的做法是结合内置函数 enumerate()。本文将具体讲解 enumerate() 在遍历字典键、值以及键值对时的三种完整写法、序号自定义方式与关键避坑要点。
一、核心解决方案:使用 enumerate() 函数
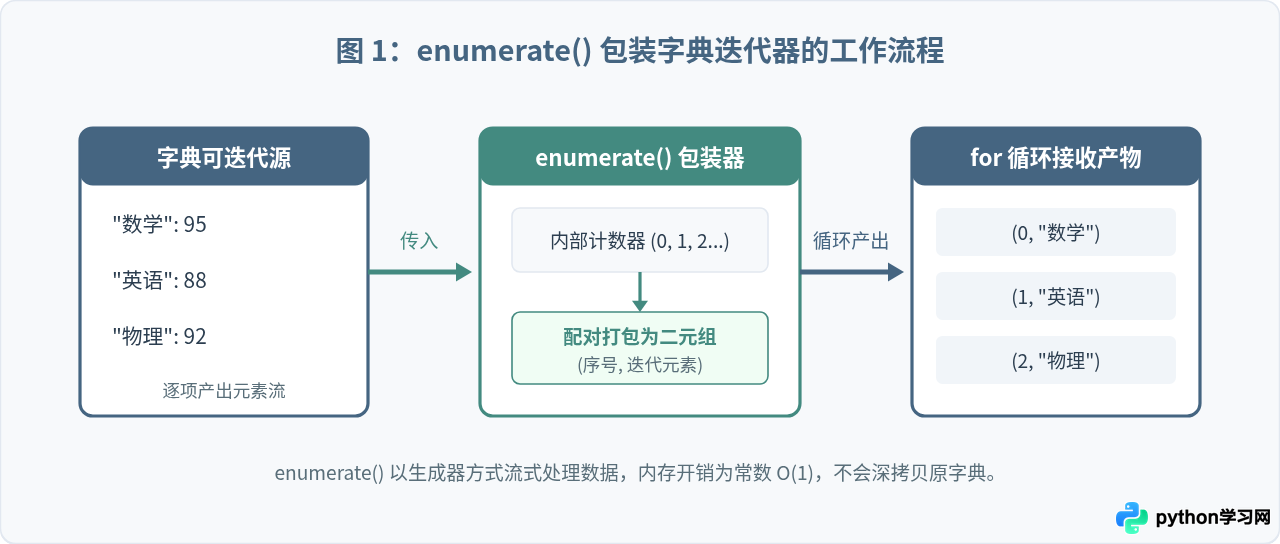
enumerate() 是 Python 提供的内置枚举函数。它接收任意可迭代对象,并在每次迭代时产出一个包含两个元素的元组:(序号, 元素)。由于字典本身也是可迭代对象(默认产出其键名),因此直接对字典使用 enumerate() 即可直接拿到当前遍历的下标序号。
# 基础演示:获取字典键及其对应的遍历下标
scores = {"数学": 95, "英语": 88, "物理": 92}

for index, key in enumerate(scores):
    value = scores[key]
    print(f"序号: {index} | 科目: {key} | 分数: {value}")
运行结果示例:
序号: 0 | 科目: 数学 | 分数: 95
序号: 1 | 科目: 英语 | 分数: 88
序号: 2 | 科目: 物理 | 分数: 92
二、三种遍历目标的具体语法与解包
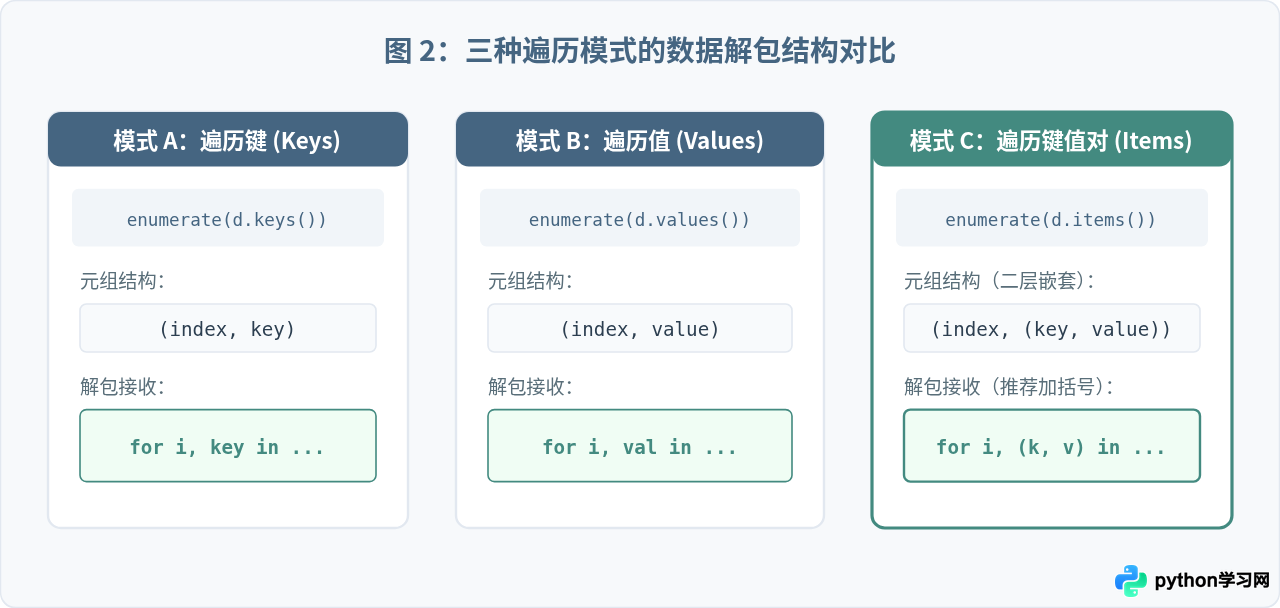
遍历字典时,通常根据业务需要选择遍历键、遍历值或同时遍历键值对。由于所传入的视图方法不同,for 循环解包变量的写法也有差异:
1. 仅获取下标与键名(默认方式)
直接遍历字典或调用 dict.keys() 均可:
info = {"host": "127.0.0.1", "port": 8080, "protocol": "HTTP"}

for idx, key in enumerate(info.keys()):
    print(f"索引: {idx}, 键名: {key}")
2. 仅获取下标与字典值
当不需要键名、只需按顺序处理所有字典的值时,使用 dict.values():
prices = {"apple": 5.5, "banana": 3.2, "orange": 4.8}

for idx, val in enumerate(prices.values()):
    print(f"条目 #{idx}: 单价为 {val} 元")
3. 同时获取下标、键名与值(双层解包语法)
这是实际开发中最常用的场景。调用 dict.items() 时,每一项产出的是 (key, value) 元组。再被 enumerate() 包裹后,整体结构为 (index, (key, value))。在 for 循环中,需要使用括号对第二项进行解包:
user_roles = {"admin": "超级管理员", "editor": "内容编辑", "guest": "访客"}

# 注意 (key, role) 外侧的圆括号
for index, (key, role) in enumerate(user_roles.items()):
    print(f"[{index}] 标识符: {key} -> 权限名称: {role}")
三、自定义起始序号:start 参数的使用
在日常展示、打印清单或生成编号报表时,人们通常习惯从数字 1 开始计数,而不是从 0 开始。enumerate() 提供了可选关键字参数 start,用于指定下标计数的初始数值。
rankings = {"Alice": 980, "Bob": 940, "Charlie": 915}

# 设置 start=1,计数从 1 开始递增
for rank, (name, points) in enumerate(rankings.items(), start=1):
    print(f"第 {rank} 名: {name} (积分: {points})")
示例输出:
第 1 名: Alice (积分: 980)
第 2 名: Bob (积分: 940)
第 3 名: Charlie (积分: 915)
start 可以传入任何整数,包括负数(例如 start=-1)或从指定基数开始(例如 start=100)。它只影响下标变量的值,不会改变对字典内部条目的读取顺序。
四、常见错误与避坑指南
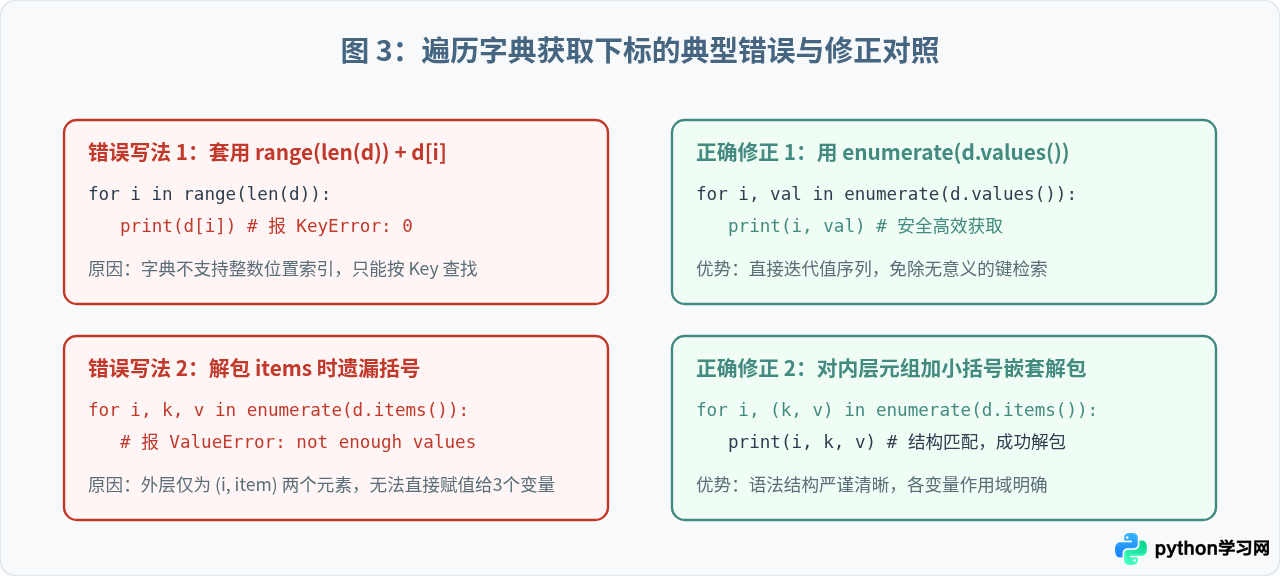
在字典遍历获取下标的场景中,初学者常常因为把列表的处理习惯套用到字典上,从而引发以下两类高频异常:
1. 误区一:混淆下标与键名,使用 dict[i] 导致 KeyError
在列表(List)中,我们可以通过 for i in range(len(lst)): print(lst[i]) 依靠数字下标取值。但在字典中,中括号内传入的是键(Key)而非下标索引。除非字典原本就恰好包含 0, 1, 2 这样的整数作为键,否则直接执行 d[i] 会立刻抛出 KeyError。
2. 误区二:解包 items() 时缺少括号导致 ValueError
当执行 enumerate(d.items()) 时,返回项为一个两元组 (index, item)。若直接写 for i, k, v in enumerate(d.items()):,Python 会尝试将由 2 个元素组成的元组解包到 3 个变量中,从而抛出:
ValueError: not enough values to unpack (expected 3, got 2)。
正确的写法务必在键值变量外侧加上小括号:for i, (k, v) in enumerate(d.items()):。
五、字典顺序保障与性能考量
在较旧的 Python 版本(Python 3.5 及之前),字典内部是无序哈希表,遍历顺序在不同运行实例下可能随机变化。自 Python 3.7+ 起,官方语言规范正式保障了字典保持插入顺序(Insertion Order)。因此在现行 Python 环境中,通过 enumerate() 得到的下标 0, 1, 2... 稳定且严格对应键值对写入字典的相对先后次序。
在性能层面,enumerate() 返回的是一个惰性迭代器(Iterator),在循环步进时仅维护一个整型计数器并读取下一次迭代项,其额外空间复杂度为 O(1),无需像 list(d.items()) 那样在内存中复制一份完整的列表,在大体量字典遍历时具备极高的执行效率。
六、总结与选型参考
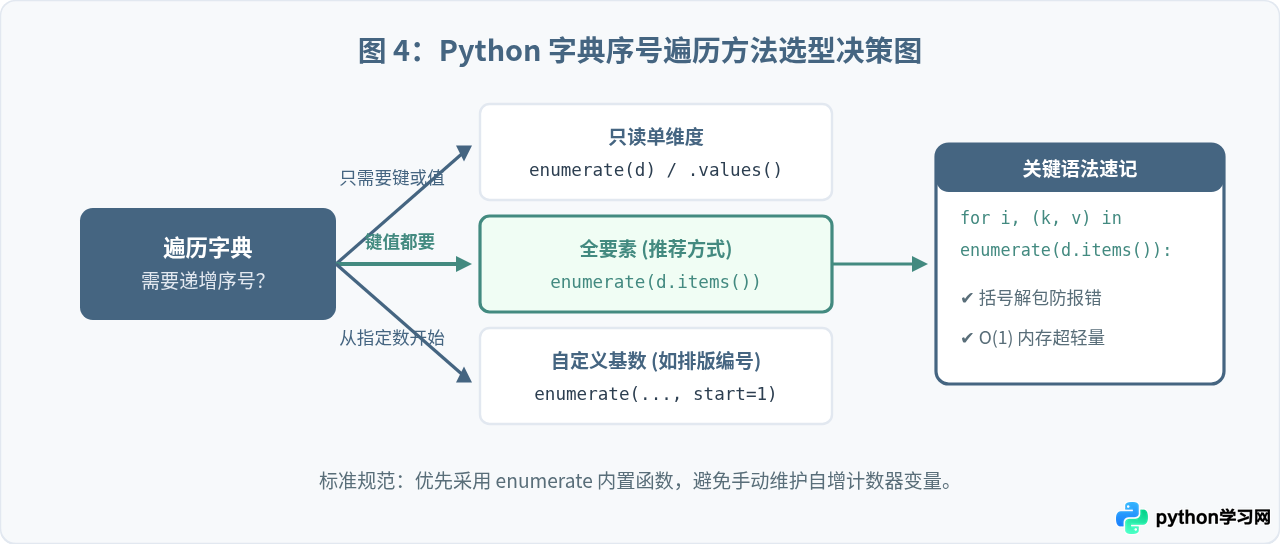
下表归纳了遍历字典时获取序号的不同场景与推荐语法:
| 遍历目标 | 推荐代码语句 | 产生序号范围 | 适用场景 |
|---|---|---|---|
| 仅键名 | for i, k in enumerate(d): |
0 到 N-1 | 仅需检查键存在性或进行键序列编号 |
| 仅值内容 | for i, v in enumerate(d.values()): |
0 到 N-1 | 不关心键名,仅需对所有值进行顺序统计 |
| 完整键值对 | for i, (k, v) in enumerate(d.items()): |
0 到 N-1 | 同时依赖键与值,需要完整展示与处理 |
| 自定义起始序号 | for i, (k, v) in enumerate(d.items(), start=1): |
1 到 N | 终端打印、排行榜生成、向用户呈现友好序号 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









