

Python字典遍历中keys()、values()与items()的区别
深入解析Python字典遍历中keys()、values()与items()的核心差异、底层视图对象机制、性能表现以及最佳实践场景。
在 Python 中遍历字典时,keys()、values() 与 items() 这三个方法决定了循环每次拿出的数据形态。简单来说,keys() 仅获取所有键,values() 仅获取所有值,而 items() 则同时获取键与值构成的键值对元组。选对方法不仅可以让代码更简练易读,还能避免多余的哈希查找开销与潜在的运行时错误。
一、核心认知:Python 3 的视图对象(View Objects)
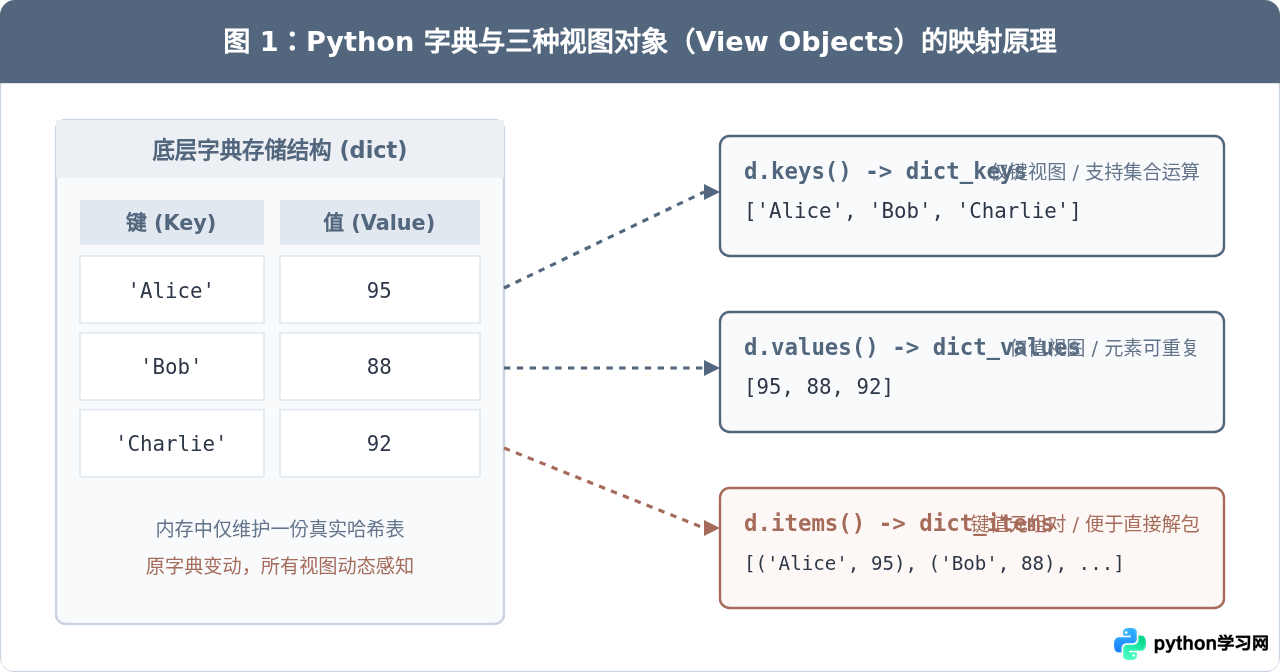
很多初学者容易把 keys()、values() 和 items() 的返回值当成普通的 Python 列表。在 Python 2 中它们确实直接返回静态列表,但在现代 Python 3 中,这三个方法返回的是名为字典视图对象(dict_keys、dict_values、dict_items)的特殊类型。
视图对象具有两个关键特征:第一,它们是动态的,不分配独立的列表内存空间,而是直接绑定底层字典哈希表;第二,它们会随着底层字典的变化实时联动。如果字典在视图创建后增加了新键值对,视图会即时反映这些变化,而不需要重新调用对应方法。
二、三个遍历方法的具体差异与代码示例
1. keys():只提取字典的键
当业务逻辑仅需要检查键的存在性、输出所有字段名称,或者对键进行集合计算时,使用 keys()。
scores = {"Alice": 95, "Bob": 88, "Charlie": 92}

# 方式 A:显式使用 keys()
for student in scores.keys():
    print(f"学生姓名: {student}")

# 方式 B:直接遍历字典对象
for student in scores:
print(f"学生姓名: {student}")注意:在常规循环中,直接 for k in d 与 for k in d.keys() 在运行行为上完全等价。直接遍历字典默认就是在迭代键。但在需要明确表达代码意图,或使用集合运算(例如 dict_a.keys() & dict_b.keys() 计算两个字典共有键)时,显式调用 keys() 会使语义更加清晰。
2. values():只提取字典的值
当只需要对数据进行数值统计、累加、判断状态,完全不在意对应的数据键名时,使用 values()。
scores = {"Alice": 95, "Bob": 88, "Charlie": 92}

total_score = 0
for score in scores.values():
    total_score += score

average = total_score / len(scores)
print(f"全班平均分为: {average:.1f}")
使用 values() 可以避免通过键二次索引的开销。但需要牢记:values() 返回的值没有键绑定,且值本身可以重复;如果需要根据值反推对应的键,在 values() 中是无法直接做到的。
3. items():同时提取键和值
在实际开发中,items() 是使用频率最高的方法之一。每次迭代时,它都会返回一个形如 (key, value) 的双元素元组。通过 Python 的序列解包机制,可以直接将两个值分别赋给不同的变量。
scores = {"Alice": 95, "Bob": 88, "Charlie": 92}

# 推荐写法:通过 items() 直接解包键和值
for student, score in scores.items():
    print(f"{student} 的得分是 {score}")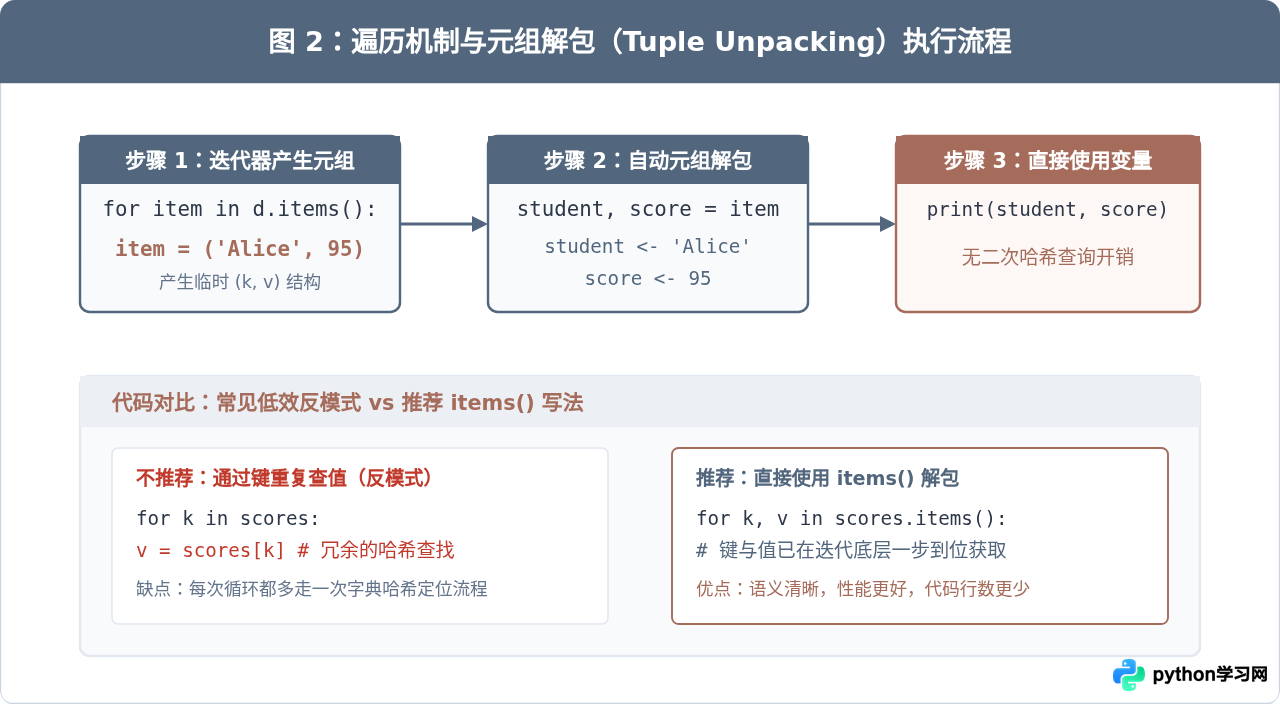
三、三者在性能与特性上的多维对比
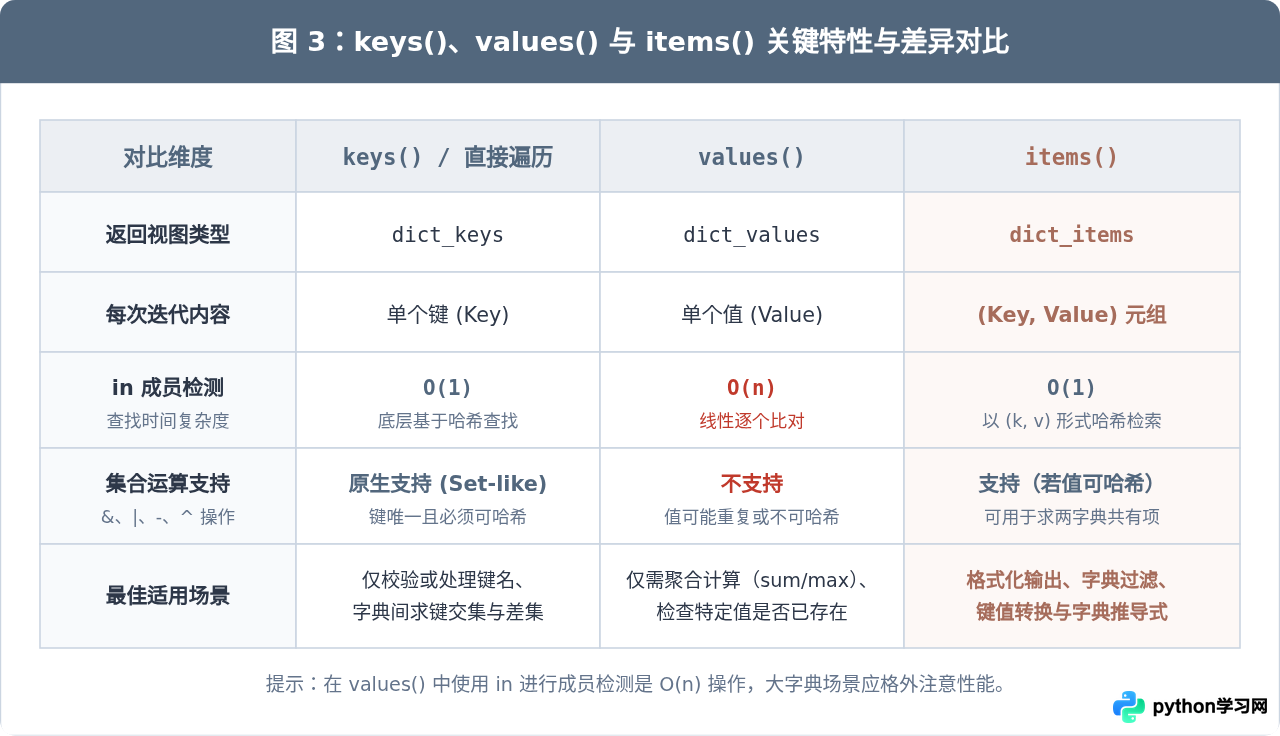
为了让不同场景下的技术选型更加明确,我们可以从返回值类型、单次迭代内容、成员查找复杂度以及集合运算支持等维度进行全面对比。
值得警惕的性能细节:成员检测(in 操作)
很多开发者习惯写 if x in d.keys() 或 if x in d.values()。这里隐藏着一个经常被忽略的性能差异:
x in d或x in d.keys():时间复杂度是 O(1)。因为字典键具有唯一的哈希映射,Python 可以瞬间判断键是否存在。y in d.values():时间复杂度是 O(n)。因为字典并不为值维护哈希索引,值可能重复甚至包含不可哈希对象,Python 只能从头到尾线性扫描每个值。当字典包含数十万条数据时,这个判断会导致显著的性能瓶颈。
四、遍历过程中修改字典的陷阱与规避方案
在使用任何方法遍历字典时,一个极为常见的报错是:RuntimeError: dictionary changed size during iteration。
这是因为视图对象与原字典是动态绑定的。如果在循环体内部直接执行 d[new_key] = val 或者 del d[key],原字典的哈希表大小或结构发生改变,正在运行的底层迭代器就会检测到版本失配并立即抛出异常。
试图在遍历过程中删除不符合条件的元素:
data = {"a": 1, "b": -2, "c": 3}
# 错误写法:会直接触发 RuntimeError
for k, v in data.items():
    if v < 0:
        del data[k]
解决此类问题的标准解法通常有两种:
- 使用
list()对键进行浅拷贝:通过list(data.keys())或list(data)在循环前固定一份静态的键名列表,遍历列表来安全删除原字典元素。# 正确写法一:冻结键列表 for k in list(data.keys()): if data[k] < 0: del data[k] - 使用字典推导式创建新字典:如果内存允许,使用推导式不仅语义明确,且运行速度通常快于逐个
del。# 正确写法二:字典推导式重新生成 data = {k: v for k, v in data.items() if v >= 0}
五、选型决策指南与总结
为了在实际编码中不假思索地写出正确、高效的代码,可以参考以下决策路径:
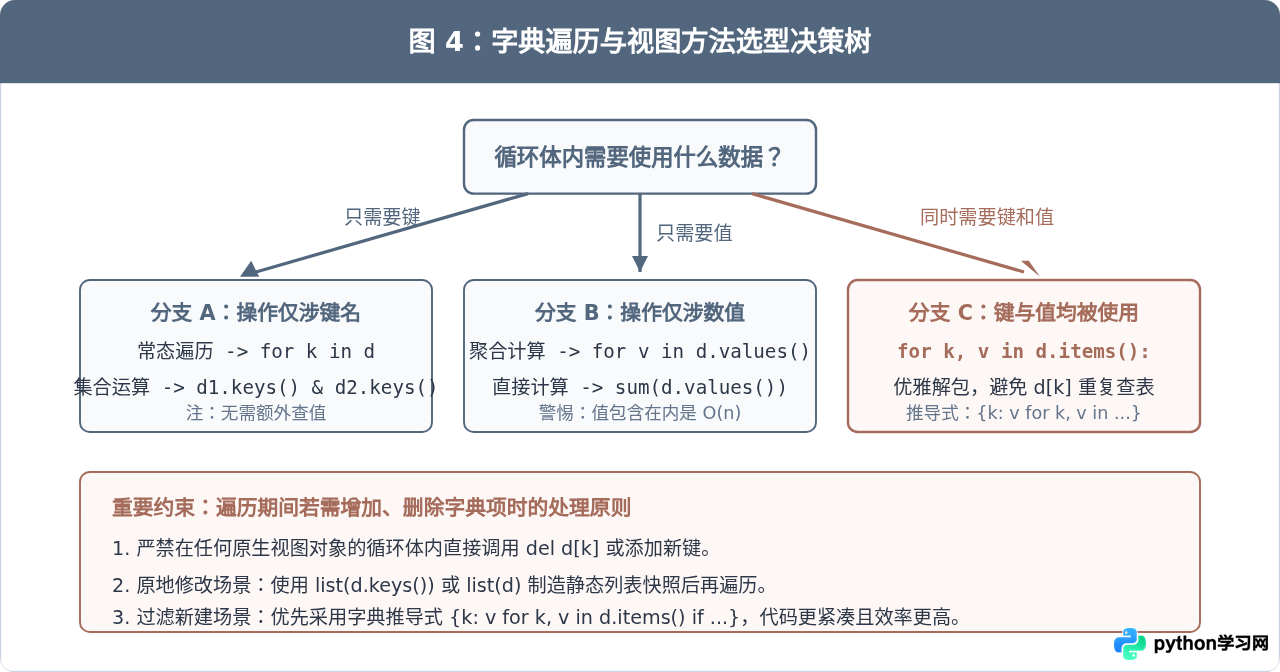
归纳起来,掌握这三个方法的核心在于明确数据需求:只要键,直接 for k in d 最地道;只要值,for v in d.values() 省开销;两个都要,for k, v in d.items() 兼具优雅与效率。理解底层的动态视图特性,不仅能帮助我们写出地道的 Pythonic 代码,也能在面对大容量数据和复杂业务时,有效避开性能损耗与并发修改的隐患。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









