

Python使用items()同时遍历字典键和值的解包写法

在 Python 中同时获取字典的键(Key)和对应的值(Value)时,标准且高效的解包写法为 for key, value in d.items():。该写法借助 d.items() 返回的视图对象,在每次循环迭代时产生一个包含 (key, value) 的二元元组,并通过序列解包机制直接赋给两个目标变量,从而兼顾了代码语义的高可读性与单次遍历的执行效率。
一、为什么需要 items() 与解包遍历?
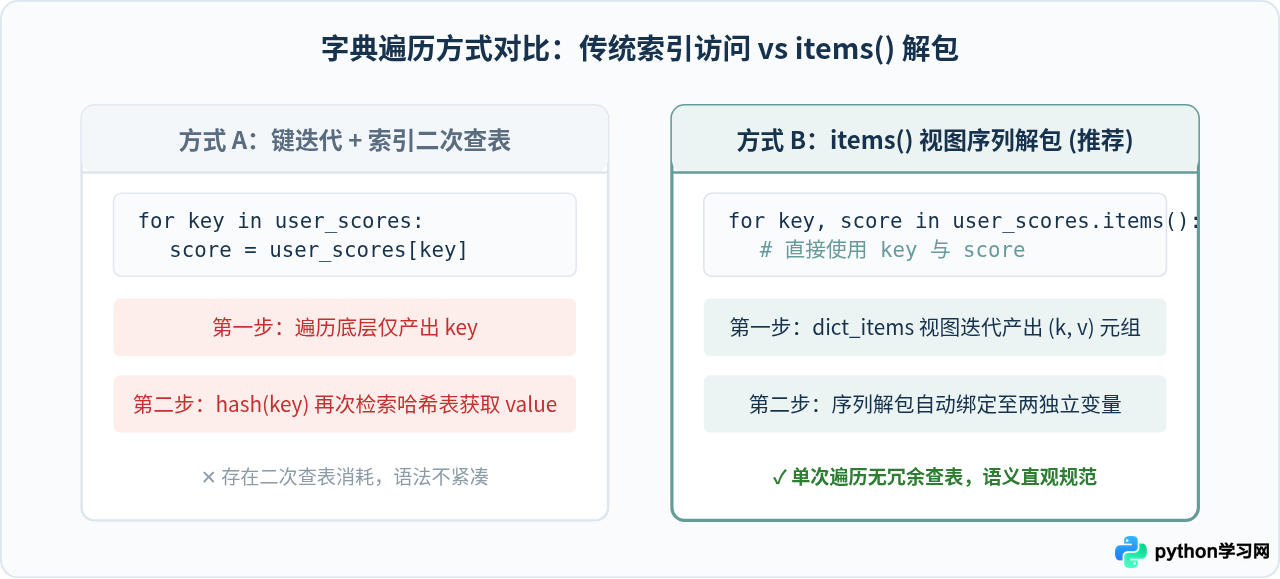
在 Python 开发中,遍历字典是极高频的操作。初学者往往习惯先通过常规的 for key in d: 取出键,再在循环体内部使用下标访问 value = d[key] 来获取对应的值。这种做法虽然可行,但在工程实践中存在明显的弊端:
- 多余的哈希查找开销:每次通过
d[key]取值,Python 底层都需要重新计算键的哈希值并在哈希表中检索槽位。当字典规模较大或处于高频循环中时,会造成额外的性能损耗。 - 代码冗余且意图模糊:多写一行
value = d[key]不仅增加了代码行数,而且无法在循环头部一眼看出“本循环同时依赖键和值”的业务意图。 - 解包写法的直接优势:使用
for key, value in d.items():时,字典迭代器会直接在底层打包并产出键值对,无需二次查表,同时将键和值分别绑定到语义明确的变量中。
二、items() 与解包语法的底层运行机制
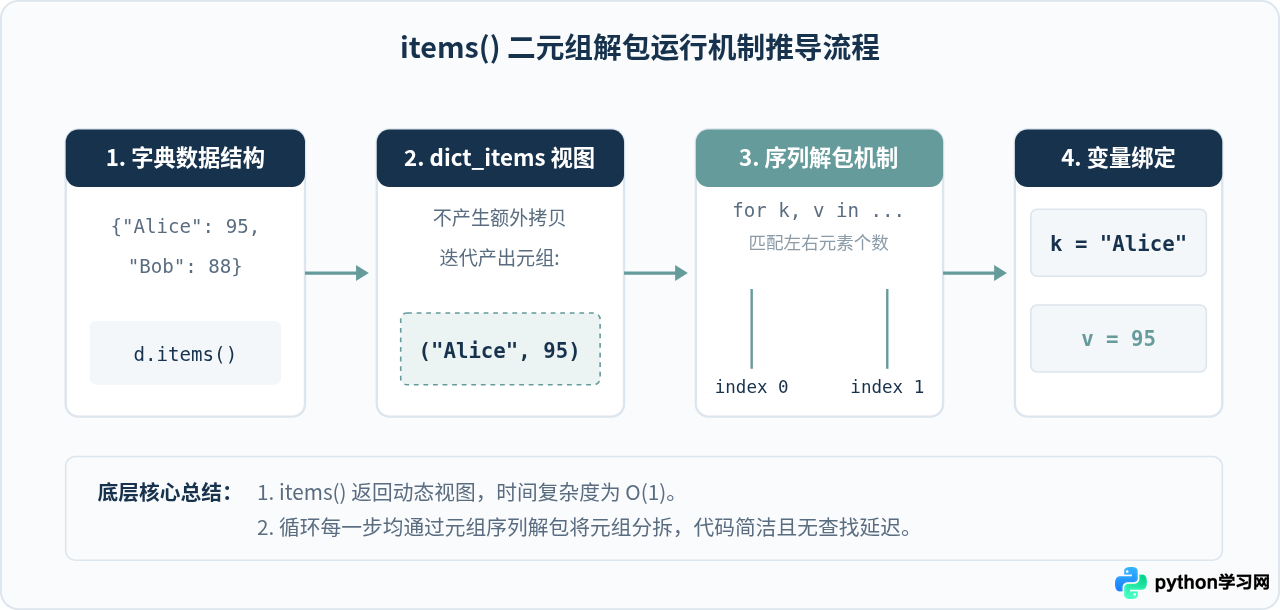
为了透彻掌握该写法,需要理解 items() 的本质以及 Python 中的元组解包(Tuple Unpacking)原理:
- dict_items 视图对象:在 Python 3 中,调用
d.items()并不像 Python 2 那样返回一个完整的列表,而是返回一个名为dict_items的动态视图对象。该视图不复制底层数据,仅提供对字典键值对的迭代接口,因此具有常数级别的空间开销 \(O(1)\)。 - 二元元组产出:当
dict_items被for循环消费时,其迭代器每次返回一个两元素的元组(key, value)。 - 序列解包绑定:Python 允许在赋值语句或
for循环头部省略元组括号。for key, value in ...本质上是for (key, value) in ...的简写。Python 虚拟机(通过UNPACK_SEQUENCE指令)检测到右侧是一个长度为 2 的元组,便依次将其第 0 个元素赋给key,第 1 个元素赋给value。
三、标准操作步骤与典型应用场景
掌握了基本原理后,我们通过具体步骤和代码场景来展示如何在日常开发中编写规范的解包代码。
1. 基础解包遍历:格式化输出
这是最常见的使用场景,遍历包含简单键值的配置或映射字典:
# 示例字典:用户服务器端口映射
service_ports = {
    "http": 80,
    "https": 443,
    "ssh": 22,
    "database": 5432
}

# 使用 items() 解包遍历
for service, port in service_ports.items():
    print(f"服务名称: {service:<10} 对应端口: {port}")
示例输出:
服务名称: http       对应端口: 80
服务名称: https      对应端口: 443
服务名称: ssh        对应端口: 22
服务名称: database   对应端口: 5432
2. 嵌套结构深层解包
当字典的值本身也是固定长度的元组或列表时,Python 支持在 for 循环中直接使用嵌套解包模式,一步到位提取深层字段:
# 示例字典:城市名称对应 (纬度, 经度)
city_coords = {
    "Beijing": (39.9042, 116.4074),
    "Shanghai": (31.2304, 121.4737),
    "Tokyo": (35.6762, 139.6503)
}

# 嵌套解包写法:同时解包键和包含两个坐标值的元组
for city, (lat, lon) in city_coords.items():
    print(f"{city} 坐标 -> 纬度: {lat}, 经度: {lon}")
3. 字典推导式中的解包应用
items() 解包同样是字典推导式(Dict Comprehension)的核心组成部分。例如实现键值翻转、条件过滤或数据转换:
# 原始成绩表
scores = {"Alice": 92, "Bob": 58, "Charlie": 78, "David": 45}

# 1. 过滤及格学生
passed_students = {name: score for name, score in scores.items() if score >= 60}

# 2. 键值互换(注意确保值是唯一且可哈希的)
inverted_scores = {score: name for name, score in scores.items()}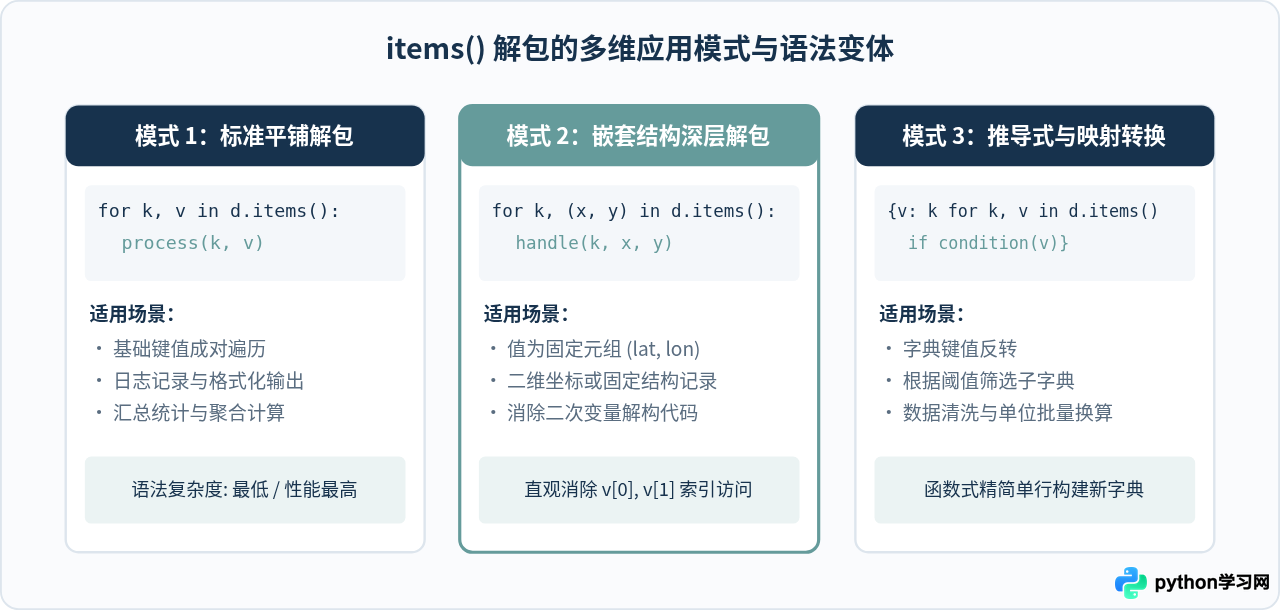
四、常见陷阱与避坑指南
在编写 items() 解包代码时,有两处极其高频的运行期错误需要重点防范:
1. 变量数量不匹配:ValueError
序列解包的前提是左侧变量数量与右侧元组元素数量严格相等。d.items() 产出的二元组固定包含 2 个元素。如果书写错误,将会触发异常:
# 错误示例 A:只提供单个变量时,不会触发解包,而是接收整个元组
for item in d.items():
    print(item)  # 输出为元组: ('Alice', 95)

# 错误示例 B:提供了 3 个变量接收二元组
for k, v, extra in d.items():
    # 抛出异常: ValueError: not enough values to unpack (expected 3, got 2)
passfor k in d:;若只需值,请使用 for v in d.values():。2. 遍历中增删键:RuntimeError
因为 d.items() 返回的是字典的实时视图,如果在循环过程中对字典进行增加键或删除键操作,Python 会主动终止循环并抛出异常:
data = {"a": 1, "b": 2, "c": 3}

# 错误示范:在遍历视图时直接删除键
for k, v in data.items():
    if v > 1:
        del data[k]  # 抛出: RuntimeError: dictionary changed size during iteration
正确解决方式有两种:
- 方案一(构建静态副本):使用
list(data.items())强行转为列表快照,由于列表与原字典相互独立,此时原字典增删不会影响列表迭代:for k, v in list(data.items()): if v > 1: del data[k] # 安全执行 - 方案二(推导式生成新字典):推荐函数式思想,保留符合条件的数据构成新字典,避免原地破坏性变更:
data = {k: v for k, v in data.items() if v <= 1}
五、知识总结与实践速查
为了帮助在实际编码中快速做出合理选择,我们将字典常用遍历手法的语义与适用场景归纳如下:
| 遍历写法 | 产出对象 | 底层开销 | 最适合的使用场景 |
|---|---|---|---|
for k in d: |
字典键(Key) | 极低(视图迭代) | 只关注键的存在性,或不需要使用值 |
for v in d.values(): |
字典值(Value) | 极低(视图迭代) | 仅对所有值求和、统计,完全不关心对应键 |
for k, v in d.items(): |
键值对(Key, Value) | 极低(解包直达) | 绝大多数同时依赖键和值的业务场景(推荐标准) |
for k, v in list(d.items()): |
静态键值列表 | 需分配列表内存 \(O(N)\) | 循环体内部必须动态删除或新增原字典键 |
综上所述,for key, value in d.items(): 融合了 Pythonic 语法哲学的优雅与执行效率,是处理字典键值遍历任务的首选范式。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









