

在线运行Python 3出现超时或报错的解决方法
针对在线运行Python 3时频繁遭遇的超时拦截(Time Limit Exceeded)、交互输入卡死及各类环境报错,系统分析产生根因并提供从代码自查到环境迁移的完整解决方法。
在各大在线编译器或轻量评测平台中运行 Python 3 代码时,最常遇到的两类阻碍是“运行超时(Execution Timed Out / Time Limit Exceeded)”与“运行时异常(Runtime Error / EOFError)”。在线平台为了保证服务器集群的多租户稳定性,通常会在底层容器中对每个任务强加极严格的执行时限(普遍在 3 秒到 10 秒之间)以及固定的虚拟内存额度。解决这类问题的核心路径,在于先厘清是代码陷入死循环、缺少预置输入,还是触发了无权限的外部资源调用,再依序通过精简规模、补齐标准输入或迁移环境来恢复执行。
一、运行超时(Timeout)的核心诱因与针对性解法
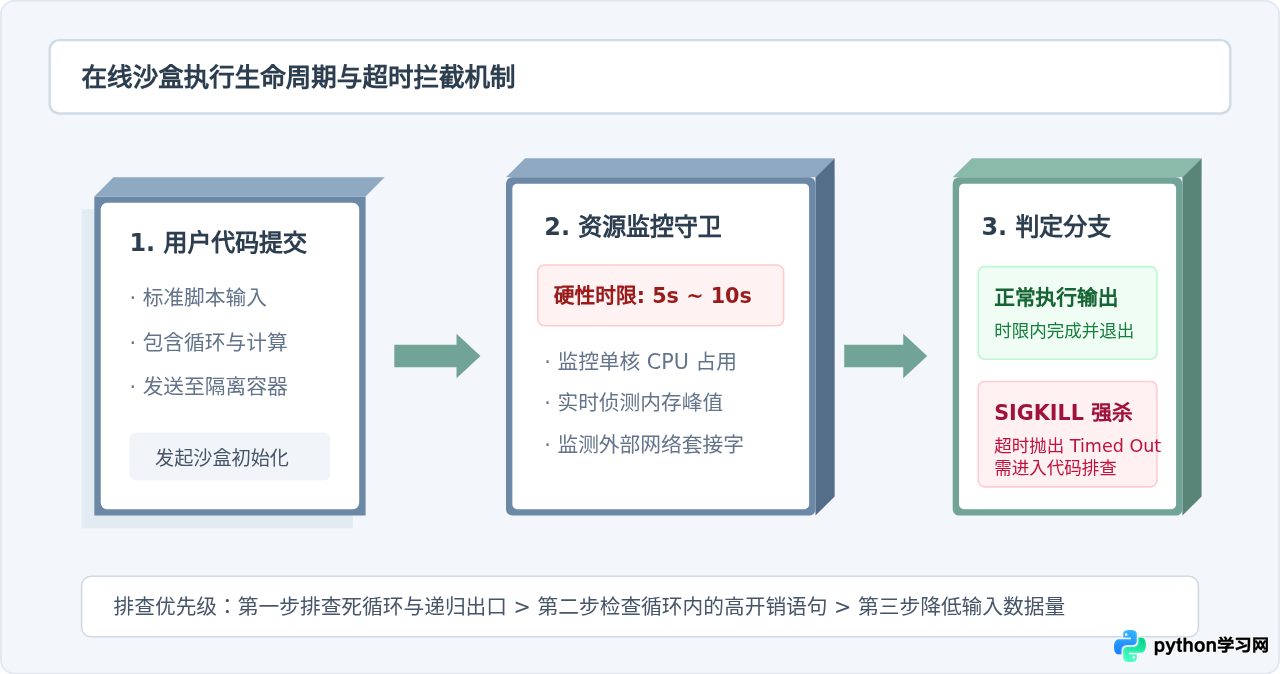
在线环境提示“Time Limit Exceeded”或“Process killed after 5000ms”,并不一定代表网络卡顿,绝大多数情况下是代码触发了平台设置的单次执行最长时间阈值。排查时应主要关注以下三种情况:
1. 无限循环与递归未正确收敛
在本地机器上运行代码时,如果不小心写出死循环,终端通常会持续运行,直到手动按下 Ctrl + C 强行中断;但在线沙盒环境无法进行人工交互,平台监控守护进程会在倒计时归零后直接向容器发送 SIGKILL 信号杀掉进程,页面随之弹出超时报错。
最易出错的场景是 while 循环条件始终为真,或者在递归计算中缺少基础出口条件:
# 典型死循环示例:索引递增逻辑放错缩进或条件恒为真
total = 0
i = 0
while i < 10:
    total += i
    # 若遗漏 i += 1 或因缩进导致未执行,循环将永久运行导致在线环境强行超时
    i += 1
解决方法:检查每个循环与递归分支,确保关键计数变量在每次迭代中都朝向终止边界前进。如果在调试复杂算法,可以在循环内部增加计数器熔断阈值(例如 if step > 100000: break),防止失控跑满时间配额。
2. 算法时间复杂度过高与数据规模超限
在线运行环境分配给单一执行脚本的 CPU 资源极其微弱,往往只有共享物理核心的十分之一到几分之一。如果代码中包含两层以上的嵌套循环,或者在数万次循环中执行高开销的列表查找、字符串频繁拼接,代码运行所需时间会迅速突破数秒上限。
解决方法:先在在线环境中将测试数据规模缩小 10 倍到 100 倍进行验证。例如,将 range(1000000) 先改为 range(1000),确认功能逻辑完全正确后,再评估是否需要优化数据结构(如使用 set 或 dict 代替大列表的成员查找),或直接移入本地完整环境运算。
二、标准输入交互挂起与 EOFError / Timeout 的排查
许多初学者在线运行包含 input() 的代码时,常遇到界面一直无响应最终提示超时,或者直接抛出 EOFError: EOF when reading a line。这是由于在线运行器的标准输入机制与本地命令行终端存在本质区别。
1. 为什么 input() 会导致挂起或报错?
在本地终端执行 name = input("请输入名字: ") 时,Python 解释器会暂停线程,交出控制权等待键盘敲击和回车信号。但是大部分在线运行器采用的是无状态批处理模式,底层根本没有分配交互式 TTY 伪终端。此时系统面临两种处理方案:
- 直接到达流末尾:标准输入流没有任何内容输入,系统直接读取到 EOF(文件结束符),触发
EOFError崩溃。 - 无限挂起等待:在线系统尝试从标准输入管道中等待数据,但前台没有任何输入注入,直到沙盒守卫判定进程超时并强行击杀。
2. 两种稳妥的解决方式
方法一:在界面的 STDIN / 预置输入框中提前填入数据。 绝大多数在线代码平台(如各在线答题平台、部分轻量在线运行网页)都会在代码编辑区旁边或下方提供一个名为“标准输入(Custom Input / STDIN)”的文本框。每一行 input() 调用对应预置框中的一行文字。在点击运行前,必须把需要输入的所有内容按行一次性填入。
方法二:用固定变量或列表 pop() 临时替代 input()。 如果所使用的平台纯粹不支持任何形式的标准输入注入,应该直接在代码中通过字面量变量完成赋值,绕过系统调用:
# 改造前(易在线挂起或报 EOFError):
# name = input("请输入姓名:")
# age = int(input("请输入年龄:"))

# 改造后(纯代码驱动,安全跨平台):
mock_inputs = ["张三", "25"]
name = mock_inputs[0]
age = int(mock_inputs[1])

print(f"处理完成:姓名={name},年龄={age}")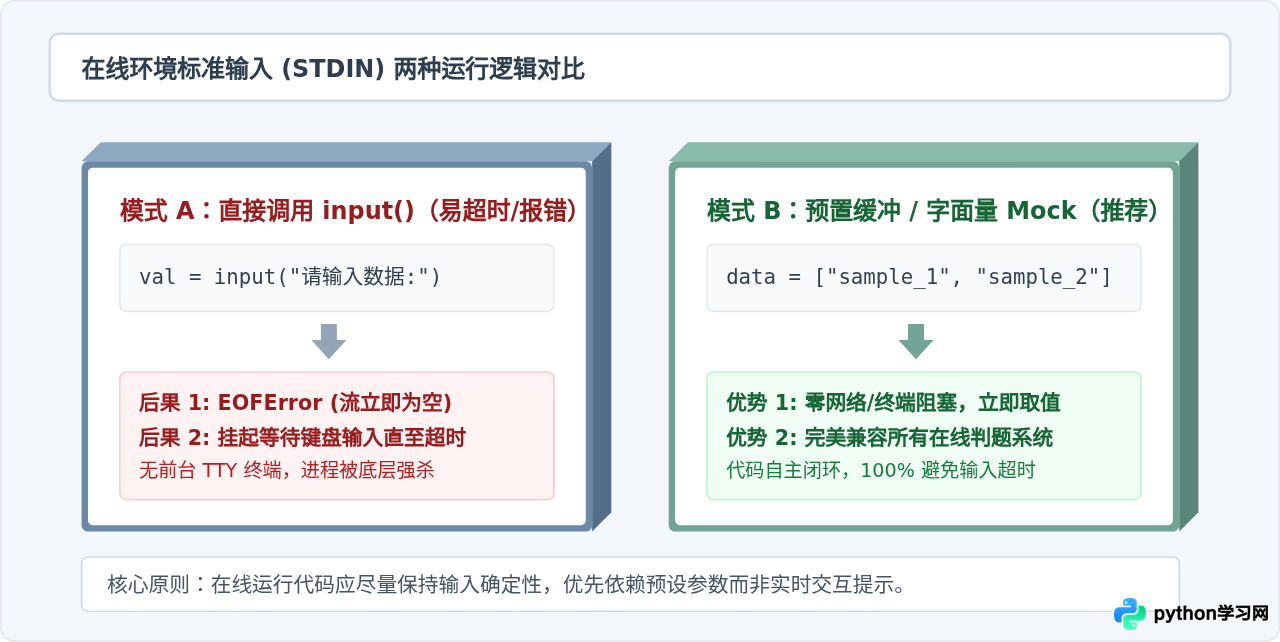
三、环境报错的类型识别与具体解决方案
除了超时之外,在线运行 Python 3 时还会遇到各类因沙盒限制或依赖缺失引起的报错。针对报错信息,按以下步骤定位和处理:
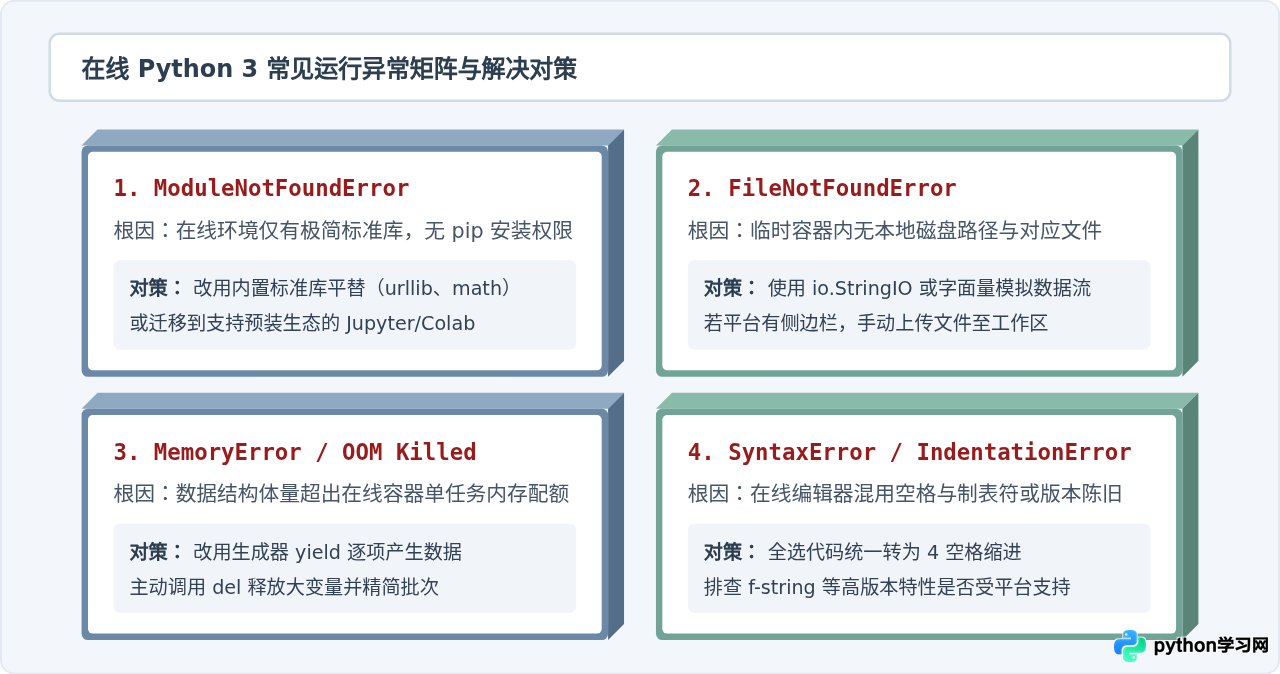
1. 依赖缺失:ModuleNotFoundError
当代码中执行了类似 import requests、import numpy 或 import pandas 时,页面可能提示 ModuleNotFoundError: No module named '...'。轻量在线运行器只包含 Python 3 官方标准库,不支持直接在终端执行 pip install。
解决办法:
- 如果只是要验证基础逻辑,使用 Python 内置库平替。例如,用标准库的
urllib.request代替requests,用内置的math、statistics或列表推导式代替numpy。 - 如果必须依赖第三方复杂科学计算库,需更换到功能完整的在线集成开发平台(例如 Google Colab、Kaggle Kernels 或 Replit),这些平台预装了主流常用库并支持通过命令行安装扩展包。
2. 本地文件缺失:FileNotFoundError
执行 open("data.csv", "r") 报错 FileNotFoundError: [Errno 2] No such file or directory。在线运行器的容器实例是临时生成的,服务器文件系统中默认不存在你个人电脑中的文件。
解决办法:
- 改用代码动态构建数据:利用内置模块
io.StringIO将数据写在多行字符串中,模拟文件对象供后续代码读取。 - 如果平台提供左侧“文件管理树”,先将对应文件上传至在线沙盒的当前运行目录中,再调用同名文件。
# 使用 io.StringIO 模拟在线环境中的外部数据文件
import io
import csv

# 将测试数据直接以内嵌字符串形式定义
mock_csv_data = """id,name,score
101,Alice,92
102,Bob,88
"""

# 使用 StringIO 将字符串封装为文件类对象,无须实际读写磁盘
csv_file = io.StringIO(mock_csv_data.strip())
reader = csv.DictReader(csv_file)
for row in reader:
    print(f"解析成功:学号={row['id']}, 成绩={row['score']}")
3. 内存被强行回收:MemoryError 或 Exit Code 137
当代码一次性申请了数千万个元素的列表,或递归层级过深时,在线平台通常会返回 MemoryError 或直接退出(状态码为 137,代表因 OOM Out-Of-Memory 被操作系统杀掉)。
解决办法: 使用生成器(generator)替代全量列表。例如将列表推导式 [x * 2 for x in range(10000000)] 改为生成器表达式 (x * 2 for x in range(10000000)),按需流式取值,将内存开销从几百兆压缩到几千字节。
四、在线运行排查的规范化四步流程与环境选型
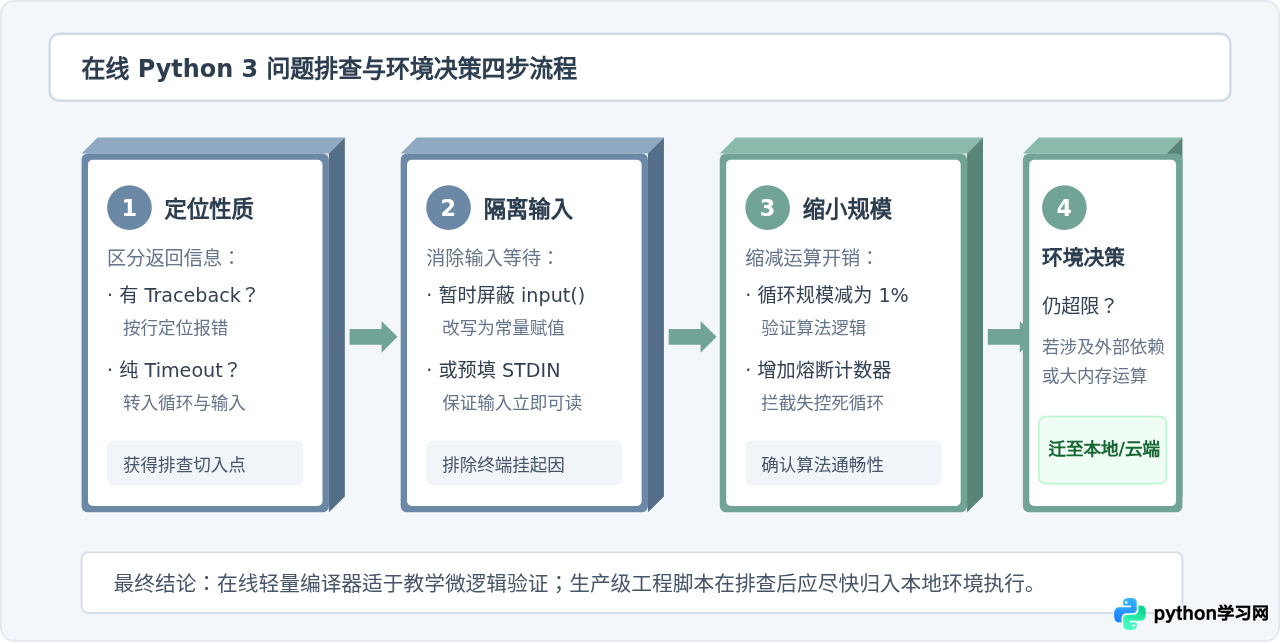
当面临一个出现超时或异常的在线脚本时,不推荐毫无目的地反复盲目点击“运行”。按照下面这套自查流程逐步排查,可以在两到三轮内迅速锁定并解决问题:
- 第 1 步:区分超时类型与错误类型。 观察返回值是系统强退给出的
Timed Out / 137,还是由 Python 解释器抛出的完整 Traceback 回溯信息。如果有具体的错误代码行号,优先跳至该行处理语法与对象类型;若只有纯粹的超时提示,立即将检查重点转向循环与输入。 - 第 2 步:剥离交互式 input()。 检查代码是否调用了
input()。如果调用了,在 STDIN 框中填入数据,或直接换成测试列表和字面量,再次点击运行。 - 第 3 步:最小可运行切片验证。 将大规模数组、多层大循环或深层递归直接注释掉,只保留核心逻辑框架,验证代码在极小规模数据(如只跑 3 次循环)下能否在 1 秒内正常输出。
- 第 4 步:环境边界决策。 评估当前业务是否超越了轻量在线运行器的承载极限。如果你的程序需要拉取外部 API 接口(在线沙盒通常禁止网络出站)、读写几十兆的大文件,或必须安装特定的机器学习库,则应果断脱离基础轻量编译器,转至本地 Python 解释器或功能齐备的云端 Notebook 运行。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









