

Python遍历字典键值对:使用items()方法的标准写法
详解在Python中使用items()方法遍历字典键值对的标准写法,涵盖基础语法、元组解包原理、dict_items视图特性、常见业务场景及遍历修改字典的避坑指南。
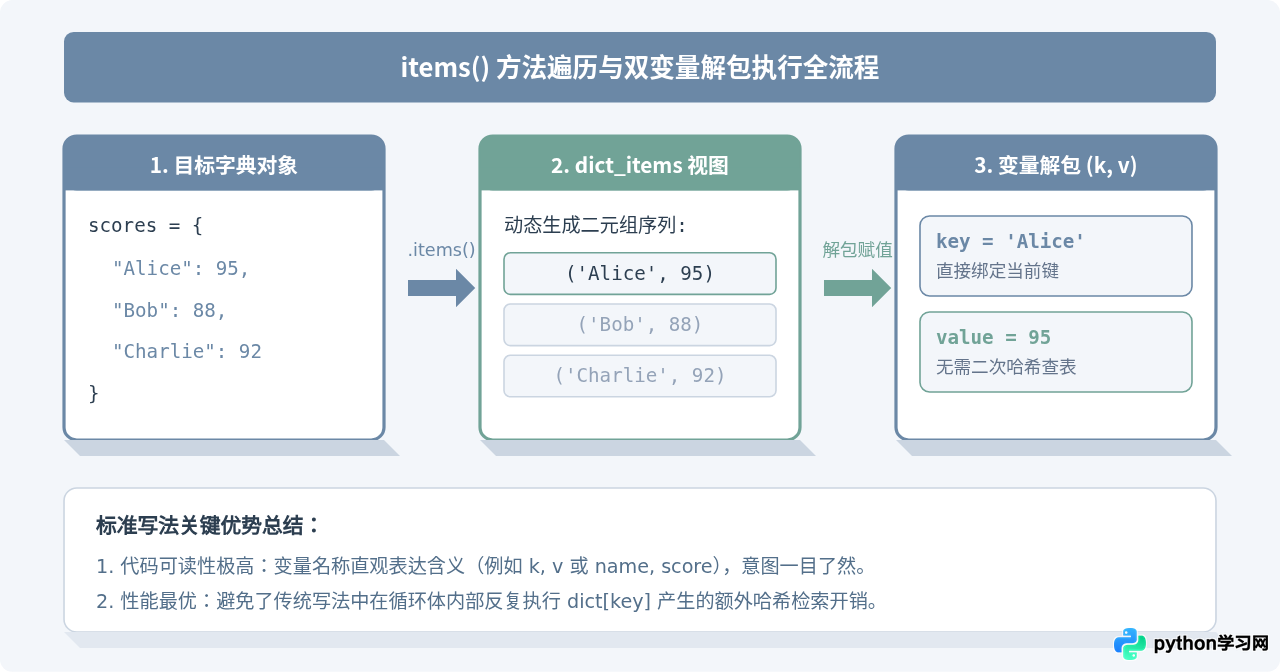
在 Python 中遍历字典并同时获取每个元素的“键(Key)”与“值(Value)”,最标准且符合惯用语法(Pythonic)的写法是直接使用 for key, value in dictionary.items():。这种写法利用元组解包机制,在每次迭代时直接将键和值分别赋给两个变量,不仅代码意图清晰,而且避免了在循环体内多次使用 dictionary[key] 进行重复哈希寻址带来的额外开销。
一、标准写法的语法结构与基本示例
字典是一种基于哈希表实现的键值对映射集合。当业务场景中既需要用到键的名字(如员工姓名、配置项名称),又需要用到对应的值(如员工薪资、配置参数)时,调用字典的 .items() 方法即可一步到位。
以下是标准写法的基本结构:
# 标准遍历模版
user_roles = {
    "alice": "Administrator",
    "bob": "Developer",
    "charlie": "Auditor"
}

for username, role in user_roles.items():
    print(f"用户:{username},对应权限角色:{role}")
示例输出:
用户:alice,对应权限角色:Administrator
用户:bob,对应权限角色:Developer
用户:charlie,对应权限角色:Auditor在上面的代码中,username 和 role 分别对应字典中的键和值。变量名可以根据具体业务场景自由命名(如 key, value、name, score 或 k, v),以保持上下文语义清晰。
二、核心机制:dict_items 视图与元组解包
要深刻理解为什么 for k, v in d.items(): 是标准做法,需要理清 Python 解释器在背后执行的两项机制:
1. 动态视图对象(dict_items)
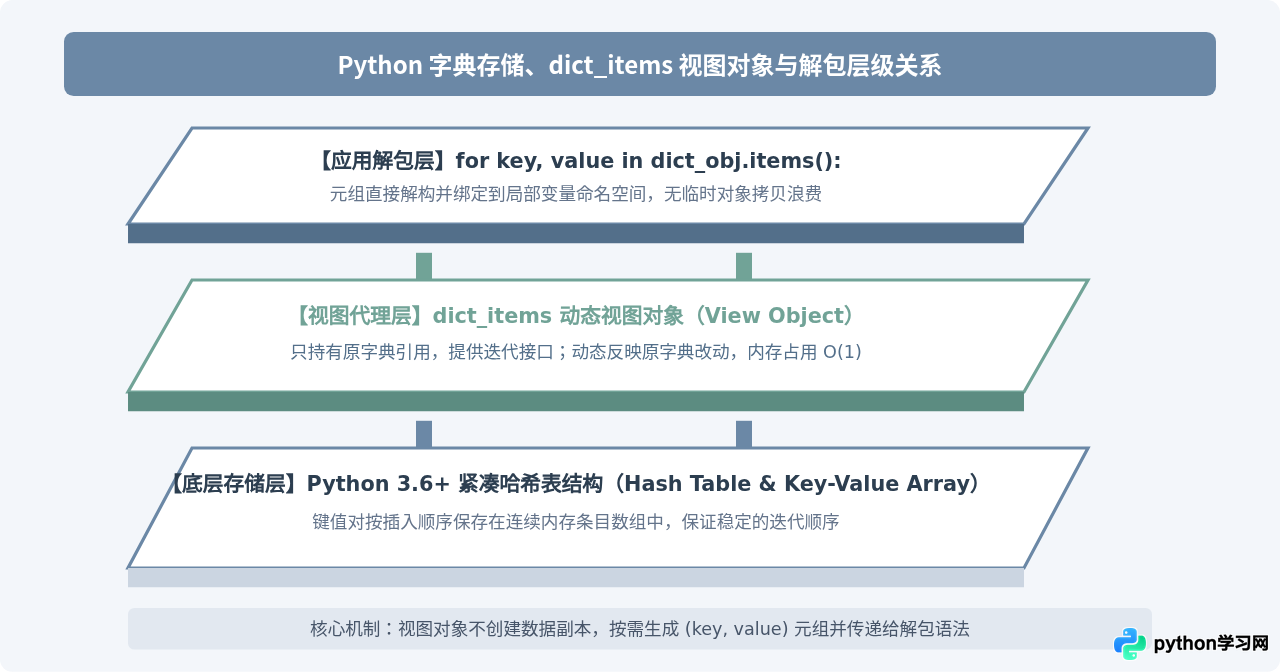
在 Python 3 中,调用 d.items() 并不像 Python 2 那样立即分配一块新内存生成完整的列表(list),而是返回一个 dict_items 视图对象(View Object)。该视图具备以下关键特征:
- 内存占用极低:无论字典包含 10 个键值对还是 1000 万个键值对,
d.items()本身占用的内存始终是恒定的 O(1)。 - 动态联动性:视图对象直接链接到底层字典。如果在未开启迭代的前提下字典内容发生改变,视图中的内容会自动反映最新改动。
- 支持集合操作:由于字典键具备唯一性和可哈希性,
dict_items视图还支持交集(&)、并集(|)等集合级运算。
2. 元组解包(Tuple Unpacking)
每次循环迭代时,dict_items 产生一个形如 (key, value) 的二元元组。Python 语法允许在 for 循环声明中直接写两个变量:for key, value in ...。解释器会自动把元组里的第 0 项赋给 key,第 1 项赋给 value。这避免了编写 item[0] 和 item[1] 这种晦涩难读的代码。
三、典型应用场景与实用范例
1. 场景一:带条件筛选的数据提取(字典推导式)
结合字典推导式(Dictionary Comprehension)和 items(),可以用一行声明式代码过滤出符合条件的键值对:
# 筛选出及格的学生(成绩 >= 60)
raw_scores = {"Tom": 58, "Jerry": 92, "Spike": 76, "Tyke": 45}

passing_scores = {name: score for name, score in raw_scores.items() if score >= 60}
print(passing_scores)
示例输出:
{'Jerry': 92, 'Spike': 76}2. 场景二:键值反转(Inverting a Dictionary)
在确保值唯一的前提下,若需要根据值反查键,可以使用 items() 快速构造反转字典:
code_to_country = {"CN": "China", "US": "United States", "JP": "Japan"}

country_to_code = {country: code for code, country in code_to_country.items()}
print(country_to_code["China"])
示例输出:
CN3. 场景三:处理嵌套字典
在解析复杂的 JSON 配置或接口响应时,常遇到字典的值依然是字典的情况。此时可以在内层循环中嵌套使用 items():
servers = {
    "web-01": {"ip": "192.168.1.10", "status": "online"},
    "db-01": {"ip": "192.168.1.20", "status": "offline"}
}

for host, info in servers.items():
    print(f"主机: {host}")
    for prop, val in info.items():
        print(f"  - {prop}: {val}")
示例输出:
主机: web-01
  - ip: 192.168.1.10
  - status: online
主机: db-01
  - ip: 192.168.1.20
  - status: offline
四、关键陷阱与避坑指南
items() 的循环过程中删除或新增键!
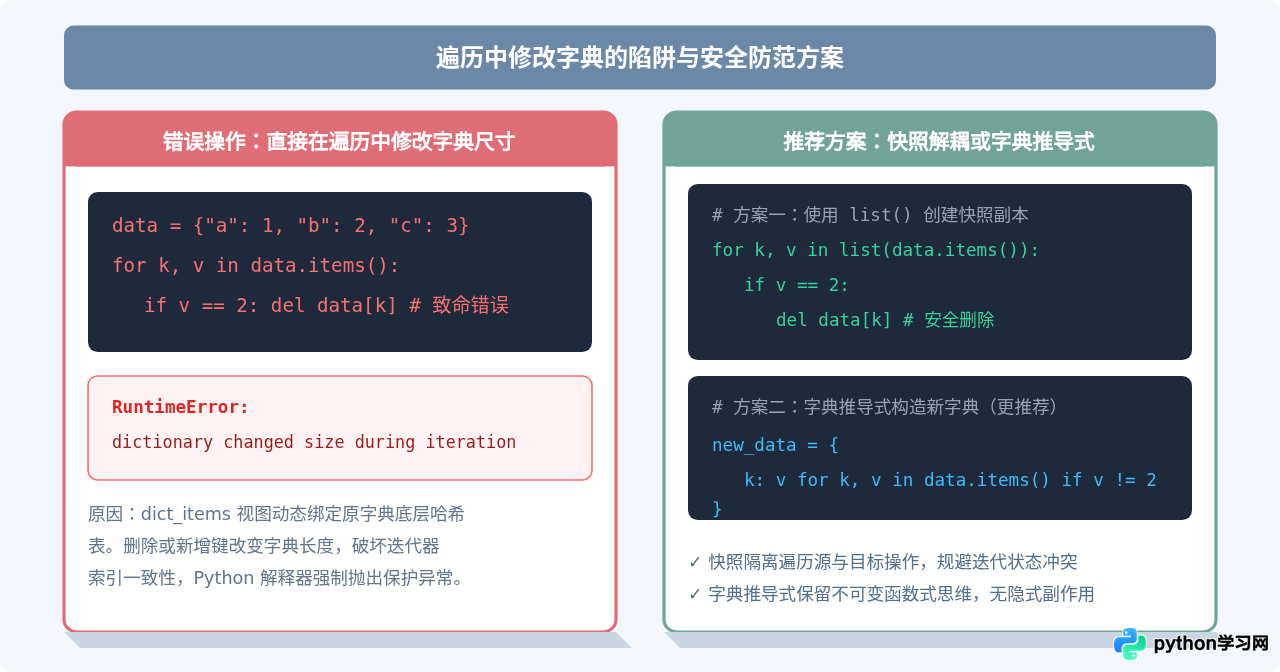
很多初学者会写出如下代码,试图在遍历时把不合格的数据就地删除:
data = {"a": 1, "b": 2, "c": 3}
for k, v in data.items():
    if v == 2:
        del data[k]  # 触发异常!
运行这段代码时,Python 会立即中断并抛出:
RuntimeError: dictionary changed size during iteration(字典在迭代过程中改变了大小)。
根本原因:前文已提到,items() 返回的是字典的实时视图。遍历时,迭代器内部维持着对哈希表物理结构的索引指针。如果中途执行 del、pop() 或添加新键,字典的内部哈希桶与键数组长度发生改变,继续按原索引读取将产生错位或内存未定义行为。Python 解释器通过内部版本计数器检测到了这种变更,为了防止静默数据破坏,主动引发 RuntimeError。
安全解决办法:
- 方案 A(浅拷贝快照):使用
list(data.items())。将视图固化为一个静态的列表副本,遍历此独立列表,修改原字典:for k, v in list(data.items()): if v == 2: del data[k] - 方案 B(构造新字典):使用字典推导式筛选保留项,不原地修改原对象。这在绝大多数工程实践中更加安全可维护:
data = {k: v for k, v in data.items() if v != 2}
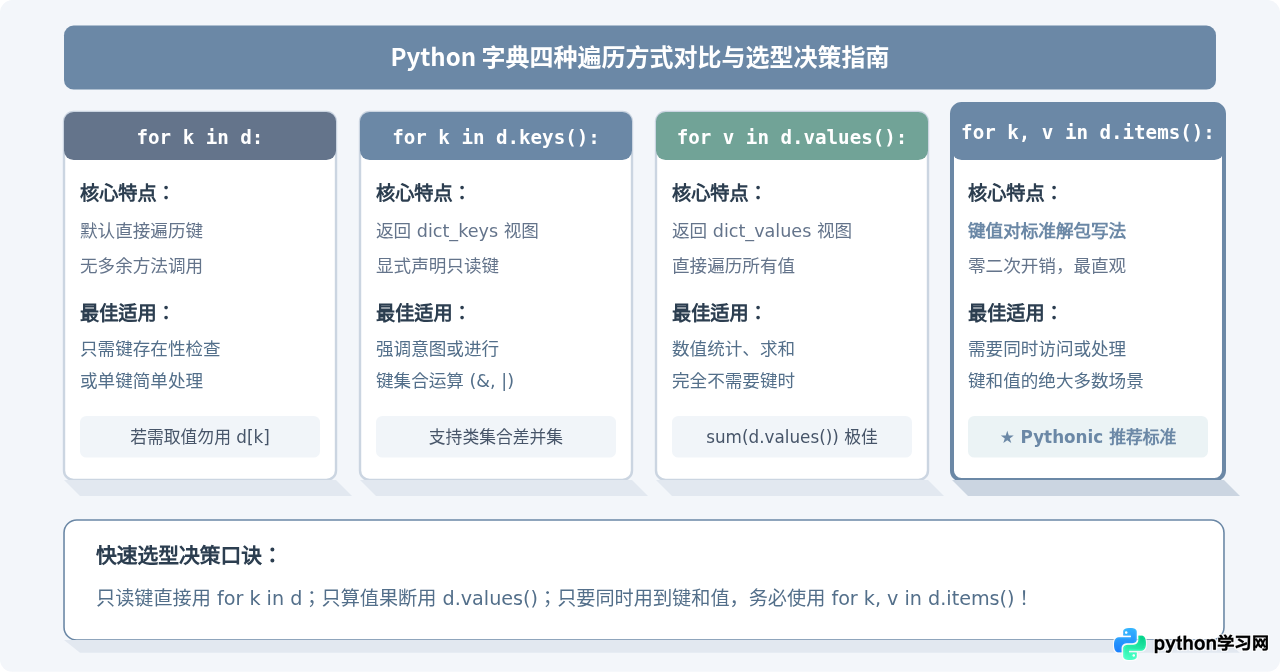
五、字典四种遍历方式对比与选型决策
Python 提供了多种访问字典的方法,每种方法都有明确的分工:
六、总结
掌握 items() 方法的标准写法是编写地道、健壮 Python 代码的基本功。在实际开发中牢记以下准则:
- 标准模式:只要同时需要键和值,一律写成
for key, value in dict_obj.items():,拒绝使用for k in d: ... d[k]的低效写法。 - 内存无忧:Python 3 的
items()产生的是轻量级视图,无需担心大数据集下的内存拷贝负担。 - 严禁就地修改:遍历字典时绝对不要增加或删除键。若需剔除元素,优先使用字典推导式生成新字典,或使用
list(dict_obj.items())建立快照副本。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









