

Python怎么同时遍历字典的键和值

在 Python 中,同时遍历字典的键(Key)和值(Value)最标准且高效的方法是调用字典的 .items() 方法,并结合双变量解包:for key, value in my_dict.items():。这种写法无需额外检索字典,不仅语义明晰,而且运行速度最快。
一、核心写法:使用 dict.items() 配合解包
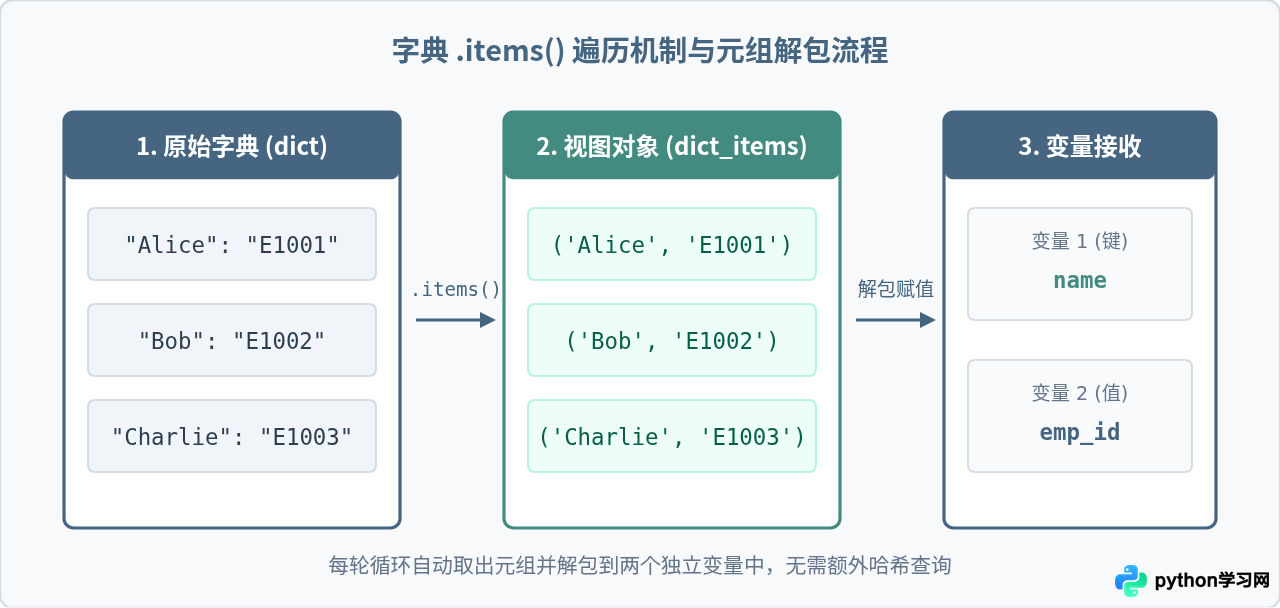
Python 字典对象内置了 items() 方法。当遍历 my_dict.items() 时,循环的每一次迭代都会返回一个包含当前键和对应值的二元元组 (key, value)。通过在 for 语句中使用两个变量,可以直接将元组内的键和值分别赋给这两个变量。
# 示例字典:记录员工与其对应的工号
employees = {
    "Alice": "E1001",
    "Bob": "E1002",
    "Charlie": "E1003"
}

# 同时遍历键和值
for name, emp_id in employees.items():
    print(f"员工姓名: {name}, 工号: {emp_id}")
示例输出:
员工姓名: Alice, 工号: E1001
员工姓名: Bob, 工号: E1002
员工姓名: Charlie, 工号: E1003在上面的代码中,name 接收键字符串,emp_id 接收值字符串。变量名可以根据具体业务场景灵活命名,例如 k, v 或 key, val,但选择表达清晰的名称有助于提高代码可维护性。
二、底层原理:为什么 items() 优于键检索
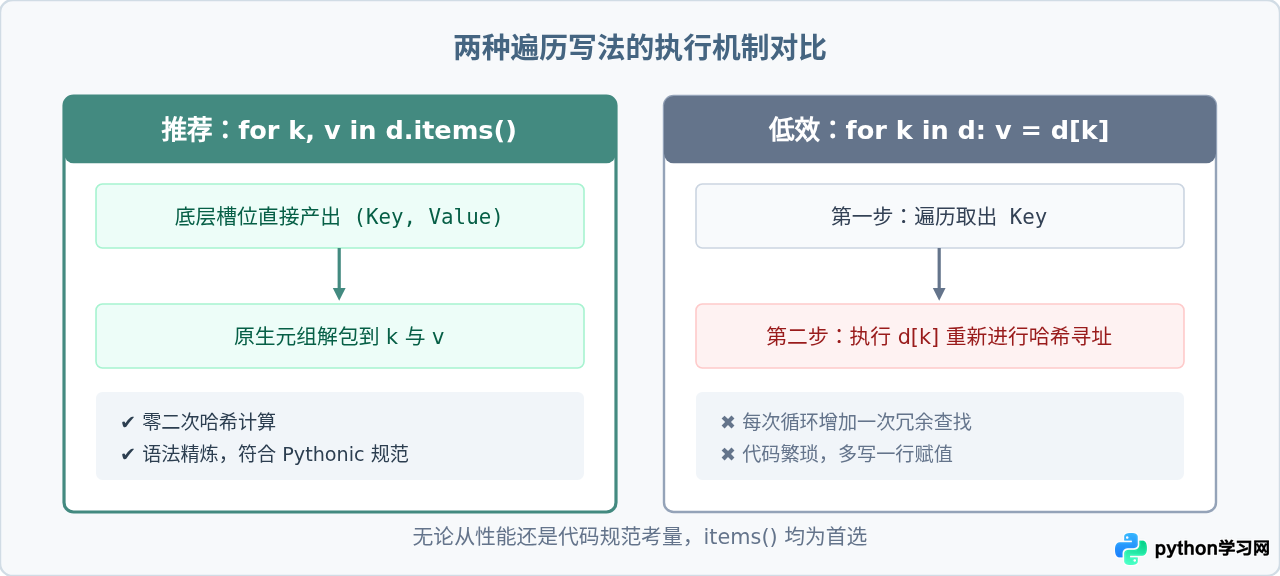
部分初学者在刚接触字典遍历时,会习惯先遍历字典的键,再通过 dict[key] 取出对应的值:
# 不推荐的繁琐写法
for key in my_dict:
    value = my_dict[key]  # 存在额外的哈希查表开销
    print(key, value)
虽然这种写法能够得到正确的运行结果,但它存在两个明显的缺点:
- 产生多余的哈希查找:在 Python 内部,字典是基于哈希表实现的。虽然哈希查找的平均时间复杂度为 O(1),但每一轮循环都执行一次
my_dict[key]仍然会带来额外的哈希计算和寻址成本。而在items()中,键和值已经成对存储在底层哈希槽位中,遍历时直接将它们打包输出,避免了二次检索。 - 代码冗余且意图不直观:同时写出
for key in ...和value = my_dict[key]增加了行数,也削弱了代码可读性。
动态视图对象 (dict_items) 的特性
在 Python 3 中,items() 返回的并不是静态列表,而是一个视图对象(View Object)。视图对象具备以下关键特性:
- 内存占用极低:无论字典包含 10 个元素还是 1,000,000 个元素,调用
items()都不会复制一份完整的键值对列表,而是按需动态迭代,显著节省了内存分配开销。 - 动态反映原字典变更:如果原字典发生变更,未消费的视图会即时反映最新数据。这一特性在带来便利的同时,也引出了遍历中需要特别留意的安全规则。
三、实际开发中的衍生操作
在掌握基础的键值遍历后,实际工程开发中常会结合其他内置工具实现更丰富的需求。
1. 带索引序号遍历:结合 enumerate
如果需要在遍历键值对的同时获取当前迭代的数字序号(如打印排序列或计数),可以将 items() 嵌套进 enumerate() 中:
fruits = {"苹果": 5.5, "香蕉": 3.2, "橙子": 4.8}

# 注意:enumerate 返回 (index, element),解包时需要对 (k, v) 加括号
for index, (name, price) in enumerate(fruits.items(), start=1):
print(f"序号 {index}: 水果={name}, 单价={price}元/斤")enumerate 会将原迭代对象的每一个元素包装成 (索引, 元素),而 items() 产生的元素本身就是二元组 (k, v),因此必须写作 index, (name, price)。若省略小括号写成 index, name, price 会抛出 ValueError: not enough values to unpack 异常。
2. 边遍历边过滤:字典推导式
如果目标是在遍历过程中筛选出符合特定条件的键值对并组装成一个新字典,使用字典推导式最为紧凑优雅:
scores = {"Alice": 92, "Bob": 58, "Charlie": 84, "David": 45}

# 仅保留成绩大于等于 60 的及格学生
passed_scores = {k: v for k, v in scores.items() if v >= 60}
print(passed_scores)
# 输出: {'Alice': 92, 'Charlie': 84}
3. 按值或按键排序后遍历
字典本身在 Python 3.7+ 保证维持插入顺序。如果希望按照键的大小或值的数值进行排序后再遍历,可以结合 sorted():
inventory = {"monitor": 12, "keyboard": 45, "mouse": 30}

# 按照库存数量从高到低排序后遍历
for item, count in sorted(inventory.items(), key=lambda x: x[1], reverse=True):
    print(f"物品: {item:10} | 库存: {count}")
四、避坑指南:遍历中修改字典的安全策略
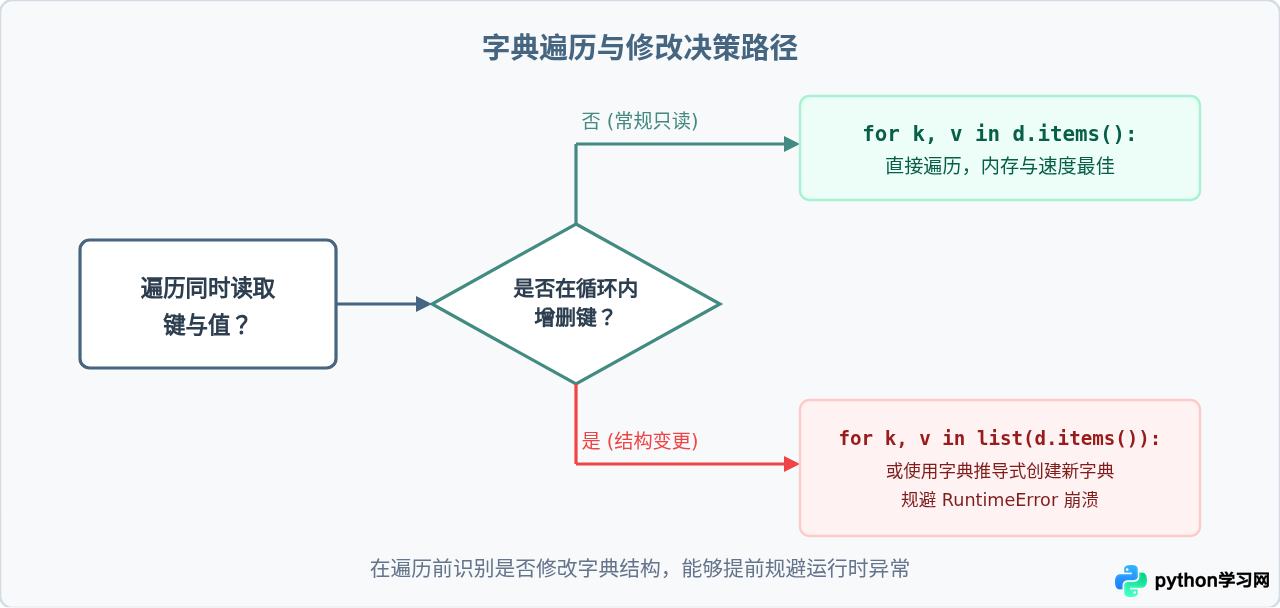
初学者容易踩中的经典陷阱是:在遍历字典的过程中直接新增或删除字典的键。例如以下代码:
data = {"a": 1, "b": 2, "c": 3}

# 错误示范:在遍历过程中直接删除元素
for k, v in data.items():
    if v == 2:
del data[k] # 抛出 RuntimeError: dictionary changed size during iterationRuntimeError: dictionary changed size during iteration,防止出现死循环或未定义行为。
解决该问题有两种安全标准的途径:
- 通过 list() 对 items() 建立快照副本:利用
list(data.items())在内存中生成当前键值对的独立列表,此时遍历的是独立快照,在循环体内删除原字典元素不会引发冲突。# 正确方案一:使用快照副本遍历 for k, v in list(data.items()): if v == 2: del data[k] - 利用推导式重构新字典:如果只是为了按条件剔除元素,通常直接构建新字典更安全清晰:
# 正确方案二:保留符合条件的项并替换
data = {k: v for k, v in data.items() if v != 2}
五、字典常用遍历模式速查与总结
为了帮助读者根据不同的业务诉求快速选择合适的遍历语句,下表对 Python 字典的三种基础遍历方法及复合场景进行了汇总:
| 遍历需求 | 推荐语法 | 返回类型 | 典型应用场景 |
|---|---|---|---|
| 同时获取键和值 | for k, v in d.items(): |
键值对元组解包 | 格式化展示、数据映射转换、键值比对 |
| 只获取键 (Key) | for k in d: |
键对象(字符串/数值等) | 判断键是否存在、收集所有字段名 |
| 只获取值 (Value) | for v in d.values(): |
值对象 | 数值累加汇总、统计均值、值有效性校验 |
| 带索引的键值遍历 | for i, (k, v) in enumerate(d.items()): |
序号 + 键值元组 | 分页展示、控制台带行号输出、进度提示 |
| 条件过滤重构 | {k: v for k, v in d.items() if ...} |
新字典对象 | 过滤无效数据、去除特定配置项 |
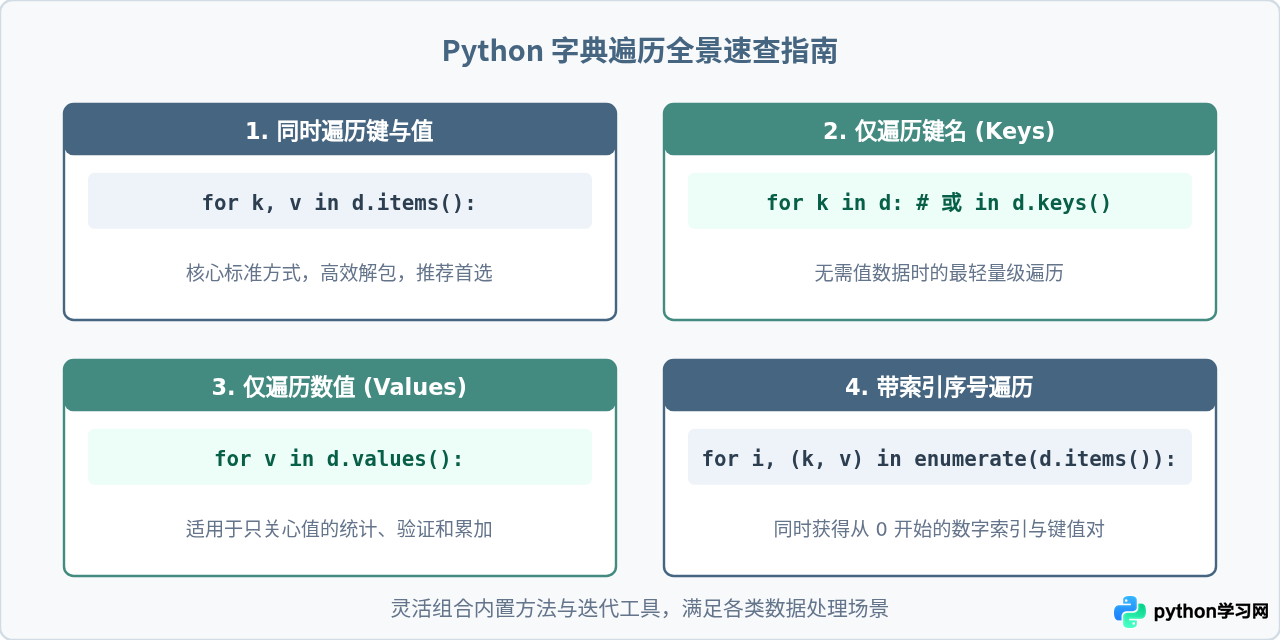
综上所述,当你的业务目标需要同时利用字典的键和值时,请牢记使用 for k, v in my_dict.items(): 这一语法范式。它兼顾了清晰的表达与出色的底层效率,是编写高质量 Python 代码的基础技能。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









