

Python将txt数据导入为列表或字典的常用代码模板
本文系统整理了使用Python将纯文本txt数据解析并导入为列表(List)或字典(Dict)的高频实用代码模板,覆盖一维列表、二维矩阵、键值字典、分组字典及异常处理方案。
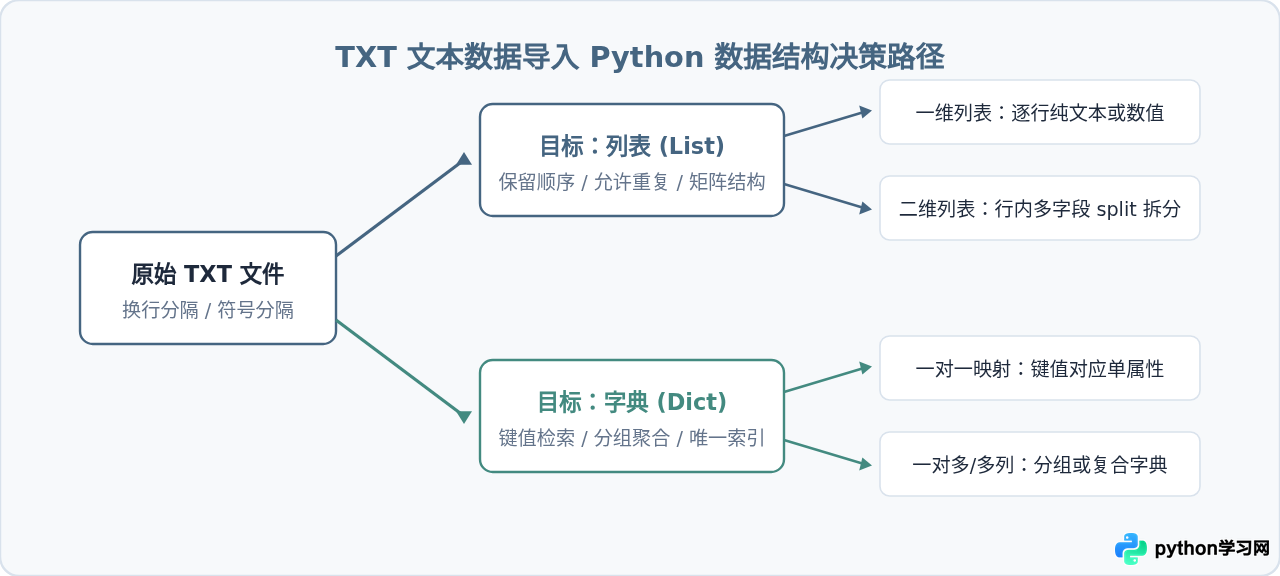
在日常数据清洗与程序开发中,纯文本(.txt)文件是最轻量且常见的数据载体之一。将 txt 中的文本行准确提取并构造成 Python 内置的列表(List)或字典(Dict),是开展后续数据计算、索引与业务处理的第一步。本文针对不同行组织形式与业务需求,提供直接可用的代码模板,并解析关键参数与边界防错技巧。
一、文件读取基础规范与核心方法
无论最终导入的目标容器是列表还是字典,底层的 I/O 规则是统一的。现代 Python 代码应当始终使用 with open(...) 上下文管理器,确保文件操作完毕或出现异常时自动释放系统文件描述符。
核心读取要素包含以下两点:
- 指定显式字符集编码:中文系统建议优先使用
encoding="utf-8",避免因系统默认编码(如 Windows 下的 GBK)不一致导致UnicodeDecodeError。 - 去除行尾换行符:使用
line.strip()清理行末的\n或\r\n,若仅需剔除换行保留前导空白,可使用line.rstrip("\r\n")。
二、txt 数据导入为列表(List)的常用模板
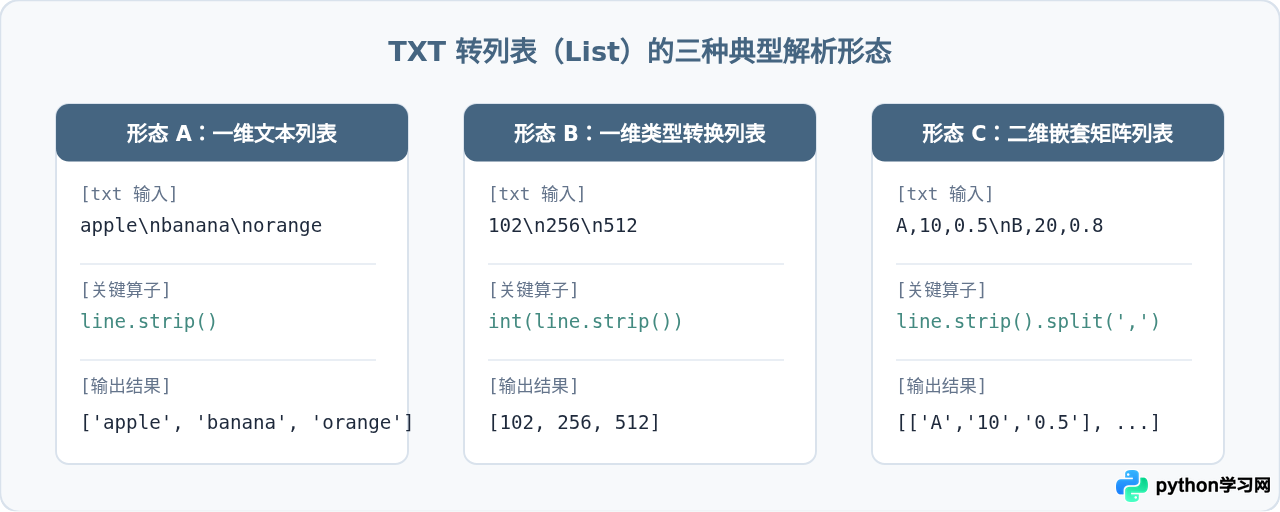
列表适合保存具有先后顺序、允许元素重复或表示多维矩阵结构的数据。
模板 1:逐行读取为一维字符串列表
适用于每一行是一个独立词条、路径或名称的文本文件,结合列表推导式可写出简洁且高效的导入逻辑:
def txt_to_list(file_path):
    with open(file_path, mode="r", encoding="utf-8") as f:
        # 使用列表推导式,去除换行符并自动跳过纯空行
        data_list = [line.strip() for line in f if line.strip()]
    return data_list

# 示例调用
# 假设 data.txt 内容为:
# apple
# banana
#
# cherry
result = txt_to_list("data.txt")
# 示例输出: ['apple', 'banana', 'cherry']
模板 2:数值型 txt 转数值列表(带数据类型转换)
当文本行全为数字(如传感器采样点、IDs 或坐标)时,可以在推导阶段直接进行 int() 或 float() 转换:
def txt_to_numeric_list(file_path, value_type=float):
    result = []
    with open(file_path, mode="r", encoding="utf-8") as f:
        for line in f:
            clean_line = line.strip()
            if not clean_line:
                continue
            try:
                result.append(value_type(clean_line))
            except ValueError:
                # 遇到非合法数字时记录或跳过
                continue
    return result

# 示例输出: [102.5, 204.8, 301.2]
模板 3:多列分隔数据导入为二维嵌套列表(Matrix)
文本中每行包含多个被逗号、空格或制表符(\t)分隔的字段时,结合 split() 将每行转换为子列表:
def txt_to_nested_list(file_path, delimiter=","):
    with open(file_path, mode="r", encoding="utf-8") as f:
        matrix = [
            [item.strip() for item in line.strip().split(delimiter)]
            for line in f
            if line.strip()
        ]
    return matrix

# 示例数据(逗号分隔):
# ID,Name,Score
# 101,Alice,95
# 102,Bob,88
# 示例输出: [['ID', 'Name', 'Score'], ['101', 'Alice', '95'], ['102', 'Bob', '88']]
三、txt 数据导入为字典(Dict)的常用模板
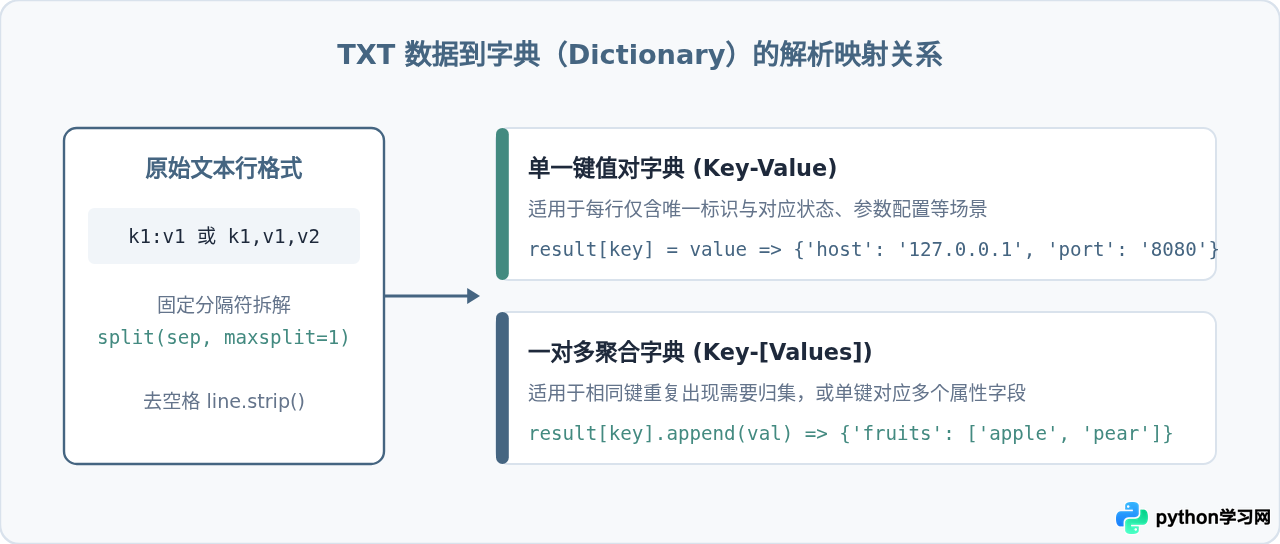
字典适用于需要根据特定字段进行 O(1) 快速检索,或进行分类聚合的场景。此时文本每一行通常包含键(Key)与值(Value)的对应信息。
模板 1:双列键值对直接导入为字典
适用于形如 key:value、key=value 或 key,value 的配置文件与映射表。建议在 split() 中设置 maxsplit=1,防止值本身包含分隔符而发生异常切分:
def txt_to_kv_dict(file_path, delimiter=":"):
    kv_dict = {}
    with open(file_path, mode="r", encoding="utf-8") as f:
        for line in f:
            clean_line = line.strip()
            # 过滤空行以及以 # 开头的注释行
            if not clean_line or clean_line.startswith("#"):
                continue
            if delimiter in clean_line:
                # 仅切分第一个分隔符,确保值中的符号不被截断
                k, v = clean_line.split(delimiter, 1)
                kv_dict[k.strip()] = v.strip()
    return kv_dict

# 示例数据 config.txt:
# host: 127.0.0.1
# port: 8080
# # 数据库配置
# db_url: mysql://root:pass@localhost:3306/db
# 示例输出: {'host': '127.0.0.1', 'port': '8080', 'db_url': 'mysql://root:pass@localhost:3306/db'}
模板 2:多列数据以首列为键、其余列为值字典
若文本有多列属性,通常以第一列(如 ID 或用户名)作为唯一键,后续列组织为列表或嵌套字典:
def txt_to_record_dict(file_path, delimiter=","):
    records = {}
    with open(file_path, mode="r", encoding="utf-8") as f:
        for line in f:
            clean_line = line.strip()
            if not clean_line:
                continue
            parts = [p.strip() for p in clean_line.split(delimiter)]
            if len(parts) >= 2:
                key = parts[0]
                values = parts[1:]
                records[key] = values
    return records

# 示例数据:
# user_101,Beijing,Engineer,18000
# user_102,Shanghai,Designer,16000
# 示例输出: {'user_101': ['Beijing', 'Engineer', '18000'], 'user_102': ['Shanghai', 'Designer', '16000']}
模板 3:一键多值导入为分组字典(聚合列表)
当文本中相同 key 会在不同行中反复出现时,使用 collections.defaultdict(list) 可直接聚合所有关联条目:
from collections import defaultdict

def txt_to_group_dict(file_path, delimiter="\t"):
    group_dict = defaultdict(list)
    with open(file_path, mode="r", encoding="utf-8") as f:
        for line in f:
            clean_line = line.strip()
            if not clean_line:
                continue
            parts = clean_line.split(delimiter, 1)
            if len(parts) == 2:
                category, item = parts[0].strip(), parts[1].strip()
                group_dict[category].append(item)
    # 可转换为标准 dict 输出
    return dict(group_dict)

# 示例数据(制表符分隔):
# Fruit	Apple
# Animal	Dog
# Fruit	Banana
# Animal	Cat
# 示例输出: {'Fruit': ['Apple', 'Banana'], 'Animal': ['Dog', 'Cat']}
四、工程实践中的异常防御与性能控制
在面对生产环境中格式不规范、字段残缺或体积庞大的 txt 文件时,需引入防错过滤机制,防止程序在解析中途崩溃。
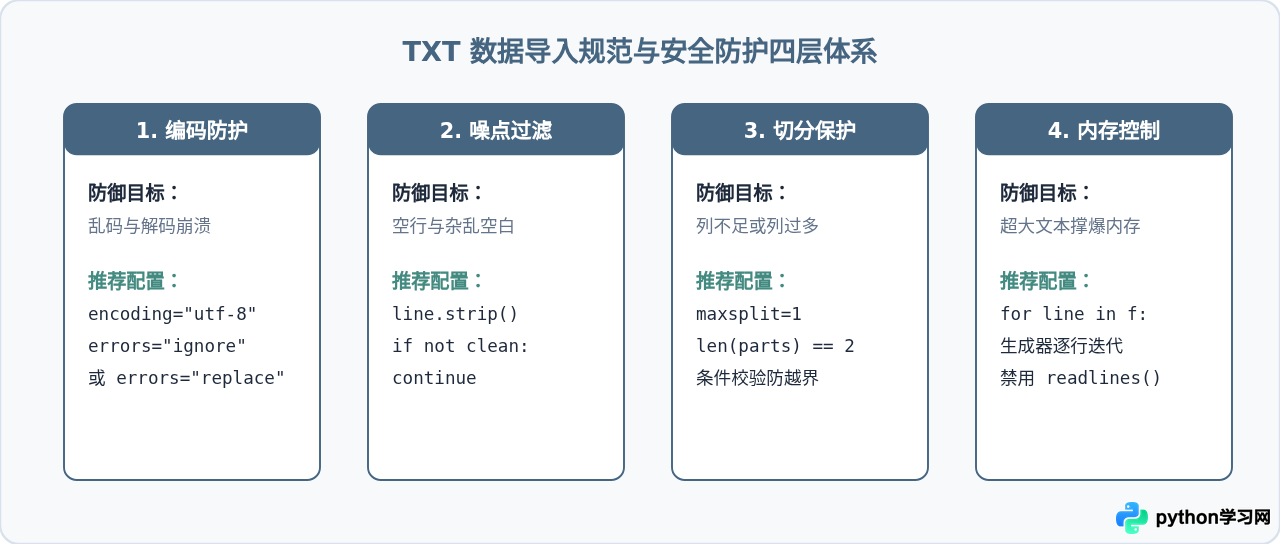
f.readlines() 会立即将文件所有行一次性读入内存列表。如果 txt 文件体积达到数 GB,这会导致内存瞬间激增甚至触发 OOM 崩溃。直接通过 for line in f: 迭代文件对象,Python 会借助内置缓冲区按需逐行读取,内存占用维持在常数级。
五、代码模板快速选择与场景对比
| 目标数据类型 | 源文件格式特征 | 推荐解析函数与方法 | 适用典型场景 |
|---|---|---|---|
| 一维列表 (List[str]) | 单行单条目(如纯名称、路径列表) | [line.strip() for line in f if line.strip()] |
词表导入、URL爬取队列、批处理文件名 |
| 数值列表 (List[int/float]) | 纯数值行(可含浮点数) | [float(line.strip()) for line in f ...] |
信号时域数据采样、数值模拟输入参数 |
| 二维列表 (List[List[str]]) | 单行多列(逗号、空格或Tab分隔) | line.strip().split(delimiter) |
轻量二维表格、矩阵运算、无表头文本 |
| 单值字典 (Dict[str, str]) | 清晰 key-value 对,键名唯一 | line.split(delimiter, 1) |
系统配置文件(.ini/.conf)、账号映射表 |
| 分组字典 (Dict[str, List]) | 相同键多次出现,需按类别归纳 | collections.defaultdict(list) |
分类归档、同名用户行为汇聚、多对一聚类 |
掌握以上模板与核心规则后,面对绝大多数纯文本数据导入需求时,只需根据分隔符与目标结构套用相应逻辑,即可在兼顾代码可读性的同时,保障导入过程的高效与稳健。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









