

Python列表反向排序:reverse参数与切片法对比
深入对比Python列表反向排序的多种实现方式,全面解析sort(reverse=True)、sorted()函数与切片法[::-1]在排序本质、原地修改机制、内存开销及实际场景选型上的核心差异。
假设你正在处理一批用户积分或订单金额数据,需要将无序数据从高到低排列展示;或者手里已经有一份按时间排好的数据,需要倒着浏览最新记录。初学 Python 时,很多开发者往往会把 reverse=True 参数与切片表达式 [::-1] 当作同义词交替使用。然而,这两者在计算本质、内存机制以及对原对象的影响上存在根本差异:一个是依据元素大小的“降序排序”,另一个则是单纯依据索引位置的“首尾颠倒”。本文将从语法表现、内部机制、性能开销和选型准则四个维度,深入解析这两种常见写法的具体异同。
一、本质区别:数值降序排序 vs 索引位置翻转
理解两种方式的前提,是厘清“排序”(Sorting)与“翻转”(Reversing)的不同定义:
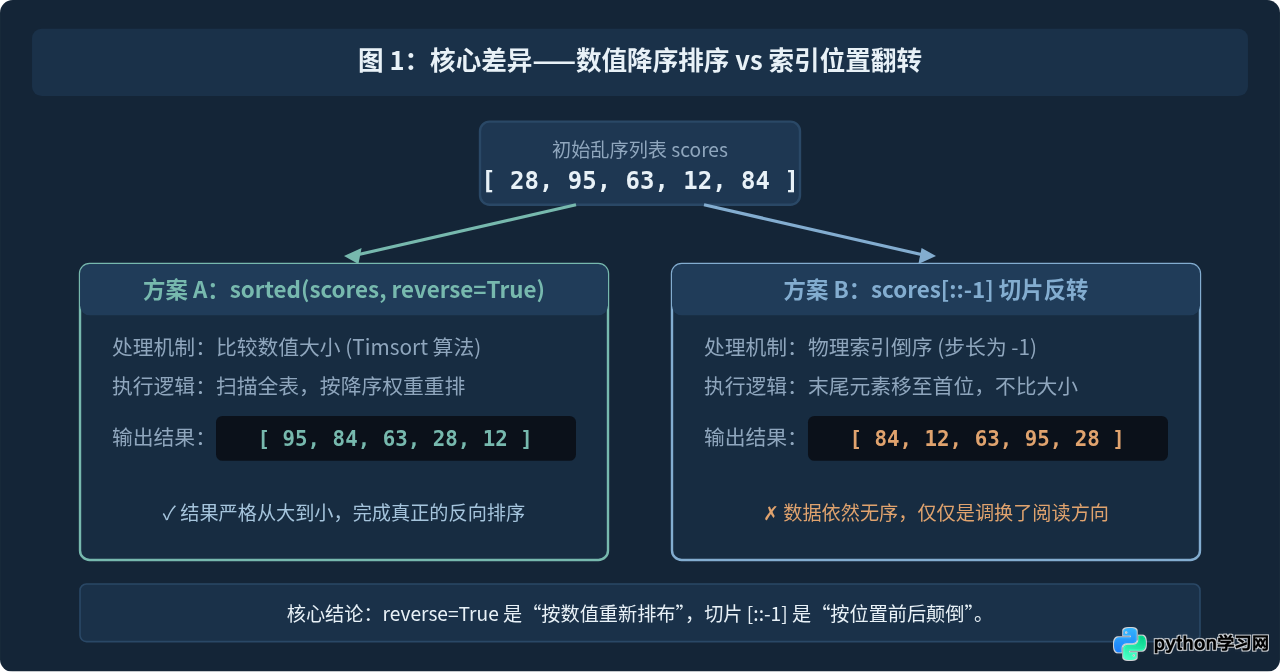
reverse=True参数(属于sort()或sorted()):其本质是排序算法的排序规则。程序会逐个比较列表中的元素大小,使用 Timsort 算法计算排列权重,最终将元素按照从大到小的规则重新安放。无论输入列表原本是升序、降序还是杂乱无章,输出结果必然是严格按值递减的。- 切片法
[::-1](以及list.reverse()):其本质是索引序列的物理镜像。它的步长为-1,意味着 Python 解释器从列表最后一个下标向前读取到第零个下标,它完全不关心元素本身的大小、类型或权重。
下面的代码直观展现了当输入是一个乱序列表时,两者的不同行为:
# 准备一个无序列表
scores = [28, 95, 63, 12, 84]

# 方式 1:使用 sorted() 配合 reverse=True
sorted_desc = sorted(scores, reverse=True)
print("降序排序结果:", sorted_desc)
# 输出: [95, 84, 63, 28, 12] -> 严格从大到小排列

# 方式 2:使用切片 [::-1]
sliced_rev = scores[::-1]
print("切片翻转结果:", sliced_rev)
# 输出: [84, 12, 63, 95, 28] -> 仅仅将原顺序前后对调,依然不是有序序列!
避坑核心点:切片 [::-1] 只有在原列表已经严格按升序排列的前提下,得到的结果才等价于降序排序;一旦输入存在无序数据,直接使用切片会导致严重的逻辑错误。
二、内存机制与副作用:原地修改 vs 浅拷贝新对象
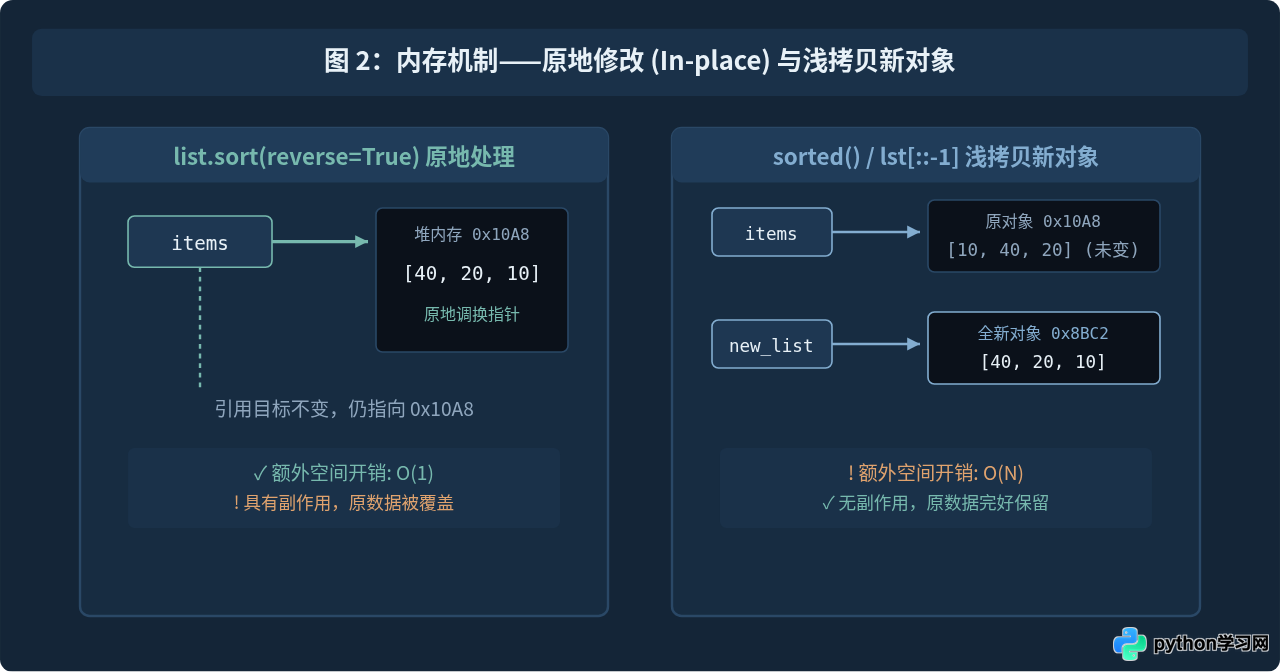
在 Python 中,不仅要关注得到的数据是什么,还要关注底层内存地址是否发生了变动。围绕反向处理,Python 提供了三个核心工具,它们的内存特征截然不同:
1. list.sort(reverse=True):原地修改(In-Place)
该方法是列表对象的固有方法。它直接在原有内存连续块中移动对象引用指针,不会创建新的列表对象。执行完毕后,原变量所指向的列表已经被彻底更改,并且该方法返回 None。
items = [10, 40, 20]
print("排序前内存地址:", id(items))

result = items.sort(reverse=True)
print("排序后内存地址:", id(items)) # 地址完全相同
print("方法返回值:", result)       # 输出: None
2. sorted(iterable, reverse=True) 与切片 lst[::-1]:创建新对象
与 list.sort() 相对,内置函数 sorted() 和切片语法 lst[::-1] 均属于纯函数式调用。它们不会触碰原列表的内容,而是在堆内存中开辟一段全新的空间,并将元素指针浅拷贝进去:
original = [10, 40, 20]
new_sorted = sorted(original, reverse=True)
new_sliced = original[::-1]

print("原列表保持不变:", original)     # [10, 40, 20]
print("原列表地址:", id(original))
print("sorted 新地址:", id(new_sorted)) # 全新内存块
print("切片新地址:", id(new_sliced))    # 全新内存块
三、语法、性能与资源消耗深度评测
在面对大量级数据(如百万级数据分析)或高性能后端系统时,执行时间与内存峰值是决定选择哪种方式的核心指标。以下从算法复杂度和底层开销两方面进行量化比对:
| 对比维度 | list.sort(reverse=True) |
sorted(lst, reverse=True) |
切片法 lst[::-1] |
|---|---|---|---|
| 核心动作 | 数值大小降序排序 | 数值大小降序排序 | 物理下标位置倒序 |
| 原列表变动 | 原地修改(直接改变) | 保持不变 | 保持不变 |
| 返回值 | None |
全新的排序列表 | 全新的翻转列表 |
| 时间复杂度 | O(N log N) | O(N log N) | O(N) |
| 额外空间复杂度 | O(1)(极省内存) | O(N) | O(N) |
| 适用入参类型 | 仅限 list 实例 |
任何可迭代对象 (tuple, dict等) | 支持切片序列 (list, str, tuple) |
由表可知:
- 如果数据原本已经保证递增有序,仅仅需要按降序提取,那么执行
lst[::-1]只需遍历复制一次(时间复杂度 O(N)),比重新进行一次 Timsort 排序(O(N log N))要轻量得多。 - 如果列表元素规模达到千万级别,内存极度敏感,且后续无需保留原数据,那么
list.sort(reverse=True)是唯一不会导致内存瞬间翻倍的选择。
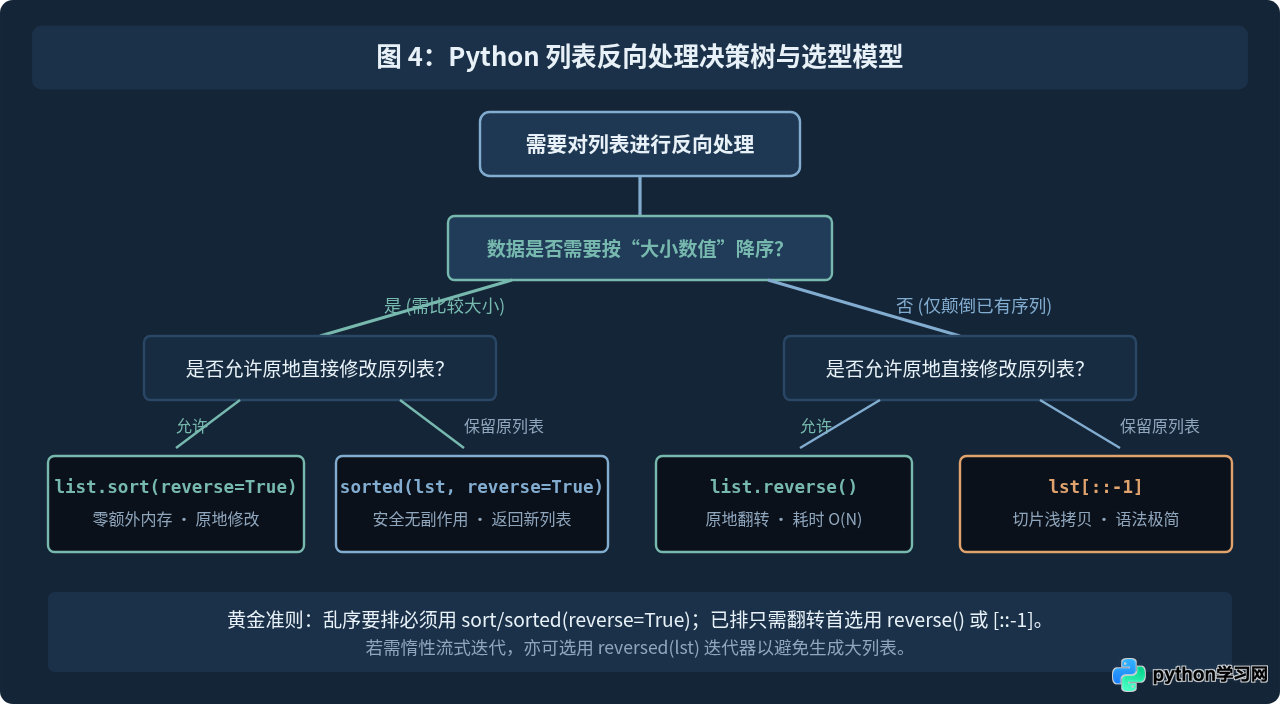
四、常见场景选型指南与决策树
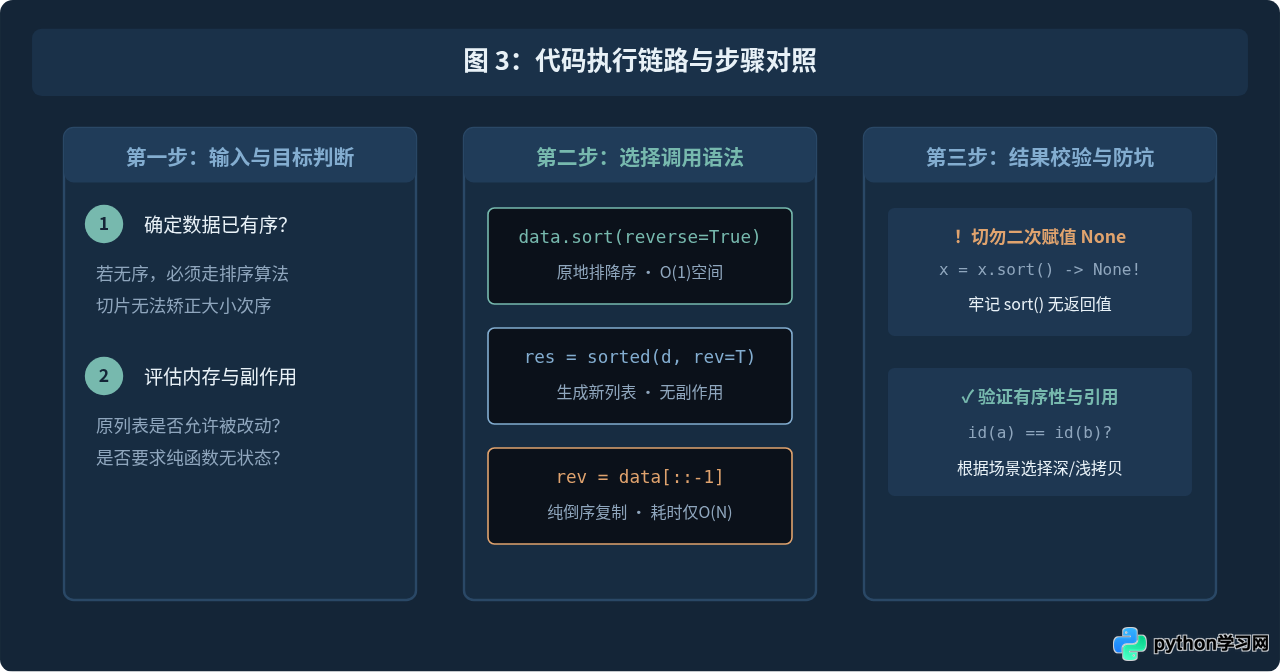
在实际开发编码中,可以根据以下三项核心标准快速决定使用哪种实现方案:
场景 1:无序原始数据,需要按指标降序排布
推荐方案:list.sort(reverse=True)(若原列表可改)或 sorted(iterable, reverse=True)(若原列表需保留)。
原因:此时数据的物理顺序与数值权重完全不相关,只有排序算法才能提供正确的数学有序性保障。
场景 2:数据本身已有序(如升序时间戳),需要倒序消费
推荐方案:list.reverse()(原地反转)或切片 lst[::-1](产生新副本)。
原因:已有序的数据无需重复投入 O(N log N) 的比较开销。直接利用反转操作以 O(N) 的极快速度完成翻转,是性价比最高的写法。
场景 3:链式表达式、列表推导式或函数参数传递
推荐方案:sorted(lst, reverse=True) 或切片 lst[::-1]。
原因:list.sort() 和 list.reverse() 返回的都是 None,无法参与链式表达式。例如在 ",".join(...) 或字典推导中,必须使用具有返回值的表达形式。
五、总结与编码自查清单
在编写涉及列表反向操作的代码前,快速核对以下四条要点,即可彻底避免常见陷阱:
- 排查排序必要性:如果列表未排序,切勿试图通过
[::-1]达到从大到小的排序效果。 - 防范
None陷阱:牢记nums.sort(reverse=True)是原地操作,永远不要写出nums = nums.sort(...)这样的覆盖代码。 - 内存敏感场景:在超大列表中,若原数据允许废弃,优先选用
list.sort(reverse=True)以节省宝贵的运行内存。 - 浅拷贝对象嵌套:无论
sorted()还是切片[::-1],生成的都是第一层浅拷贝。如果列表元素是可变对象(如嵌套字典或嵌套子列表),修改新列表内部的元素仍然会同步波及原列表对应元素。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









