

Python能做什么?Web开发、数据分析与自动化应用场景简介
系统介绍Python在Web后端开发、数据分析与日常任务自动化三大核心应用场景中的具体能力、主流工具栈、工作流示例与实践选型建议。
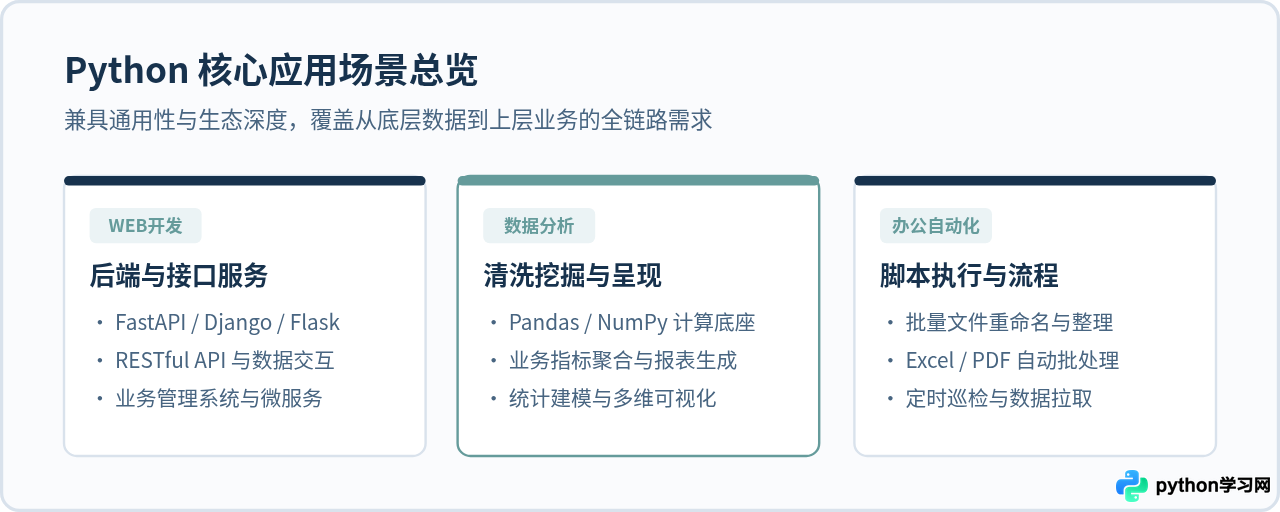
一、Web 开发:构建高性能后端与 API 接口服务
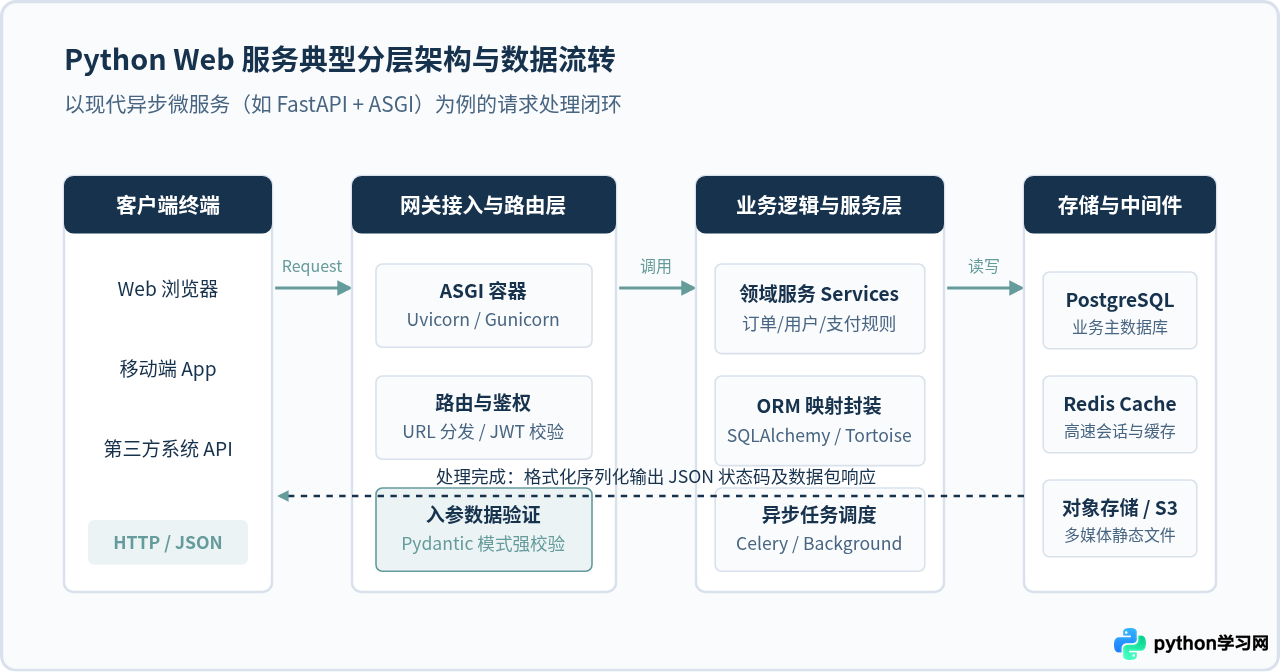
在 Web 技术栈中,Python 主要承担服务端(Back-end)角色。它负责监听来自浏览器、手机 App 或其他系统的 HTTP/WebSocket 网络请求,执行身份鉴权、业务逻辑运算与数据库读写,最终将规范化数据(通常为 JSON)或渲染好的 HTML 页面返回给客户端。
1. 常见业务场景与技术选型
Python 在 Web 开发中的应用主要分为三类,不同框架针对不同业务规模提供了明确的分工:
- RESTful API 与微服务构建:以 FastAPI 为代表。它基于 Python 原生类型提示(Type Hints)与 ASGI 异步标准,能够自动生成符合 OpenAPI 规范的交互式文档,同时具备极高的网络 I/O 吞吐能力,非常适合为现代前后端分离项目(React/Vue/移动端)提供数据接口。
- 大型企业级综合业务系统:以 Django 为代表。采用“开箱即用”哲学,自带 ORM(对象关系映射)、权限管理系统、数据库迁移机制和现成的管理后台(Admin),适合需求繁杂、需快速落地完整业务闭环的系统。
- 轻量级微服务与概念验证:以 Flask 为代表。核心小巧克制,开发者可自由搭配数据库扩展或中间件,适合数十行到数百行代码的独立小工具或内部微服务。
2. 典型工作示例:FastAPI 快速发布服务
下面是一个使用 FastAPI 编写的极简接口示例,展示如何接收客户端查询并返回受类型校验保护的数据。
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel

app = FastAPI(title="用户状态查询服务")

# 1. 定义数据结构模型,具备自动类型转换与校验能力
class UserInfo(BaseModel):
    user_id: int
    user_name: str
    is_active: bool

# 模拟数据库内存字典
DB = {
    101: {"user_name": "张三", "is_active": True},
    102: {"user_name": "李四", "is_active": False},
}

@app.get("/api/users/{user_id}", response_model=UserInfo)
def get_user(user_id: int):
    # 2. 路由处理业务逻辑
    if user_id not in DB:
        raise HTTPException(status_code=404, detail="未找到该用户记录")
    return {"user_id": user_id, **DB[user_id]}
在终端中运行服务启动命令:
uvicorn main:app --host 127.0.0.1 --port 8000 --reload当客户端向 http://127.0.0.1:8000/api/users/101 发送 GET 请求时,收到的响应结果示例如下:
{
  "user_id": 101,
  "user_name": "张三",
  "is_active": true
}二、数据分析:从数据清洗、指标聚合到报表可视化
在数据分析领域,Python 是当前实际意义上的行业标准底座。无论是运营人员统计月度销售波动,还是工程师处理千万级日志记录,Python 提供了涵盖数据摄取、缺失值清洗、多维汇总计算直至图表生成的完整生态。
1. 核心工具链与能力分工
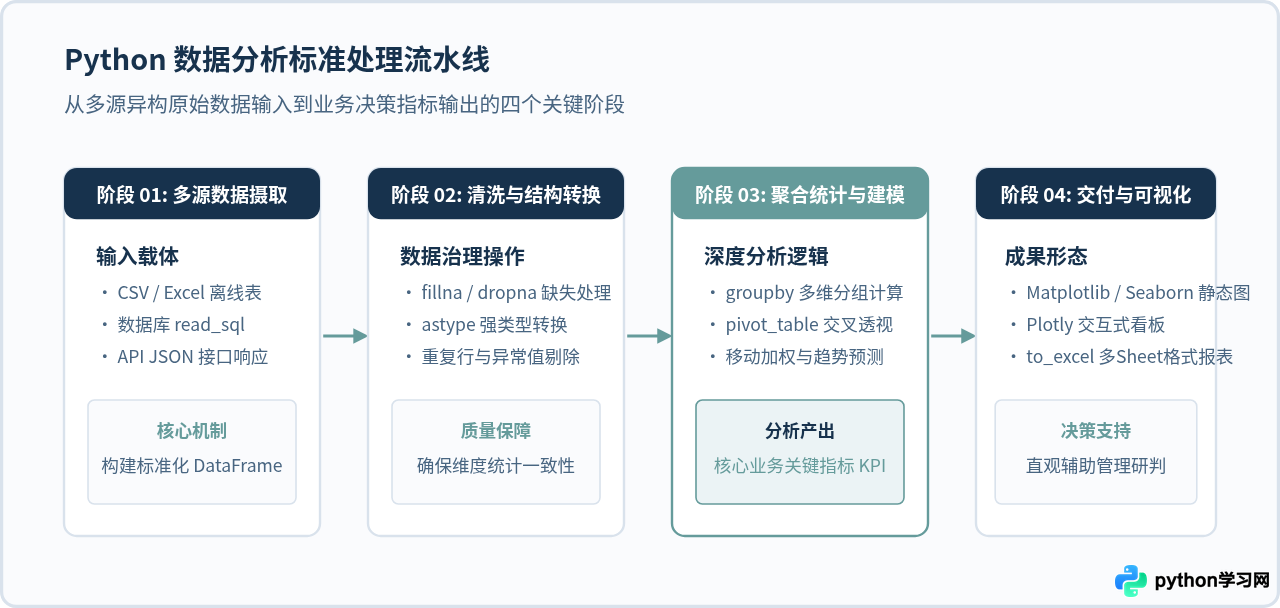
- 计算与表格抽象(Pandas 与 NumPy):NumPy 在底层通过连续 C 内存块提供高效的向量化计算;Pandas 则建立在 NumPy 之上,提供了名为 DataFrame 的双轴表格结构,支持类似 SQL 的过滤、关联(merge)、分组(groupby)与透视计算。
- 图形与可视化(Matplotlib 与 Seaborn):将冰冷的数字矩阵转化为折线图、柱状分布图、热力图或散点图,直观展现数据集中趋势与离散规律。
- 多源连接器:Python 可直接对接 CSV、Excel、Parquet 文件,或通过 SQLAlchemy/PyMySQL 驱动直接与 MySQL、PostgreSQL 等关系型数据库交互。
2. 典型工作示例:销售数据清洗与分组统计
现实中的原始数据经常存在字段空缺或格式错误。以下示例演示如何用 Pandas 加载原始表格、过滤无效行并计算各品类的销售总额与均价。
import pandas as pd

# 1. 模拟原始数据(含缺失值与脏数据)
raw_records = [
    {"order_id": "A01", "category": "电子办公", "price": 299.0, "amount": 2},
    {"order_id": "A02", "category": "生活用品", "price": 45.5,  "amount": 5},
    {"order_id": "A03", "category": "电子办公", "price": None,  "amount": 1},  # 单价缺失
    {"order_id": "A04", "category": "生活用品", "price": 88.0,  "amount": 3},
    {"order_id": "A05", "category": "电子办公", "price": 120.0, "amount": 4},
]

df = pd.DataFrame(raw_records)

# 2. 清洗处理:剔除单价缺失的无效行,并计算各单总金额
df_clean = df.dropna(subset=["price"]).copy()
df_clean["total_sales"] = df_clean["price"] * df_clean["amount"]

# 3. 分组聚合:按品类统计订单量、销售总金额与平均客单额
summary = df_clean.groupby("category").agg(
    order_count=("order_id", "count"),
    gross_revenue=("total_sales", "sum"),
    average_order_value=("total_sales", "mean")
).reset_index()

# 4. 输出计算结果
print(summary.to_string(index=False))category order_count gross_revenue average_order_value
电子办公 2 1078.0 539.0
生活用品 2 491.5 245.75借助以上几行代码,混乱的离散订单瞬间被梳理为可用于汇报的关键经营指标。如果结合 df.to_excel(),还可以一键导出为带样式的标准 Excel 报表。
三、自动化:文件批处理、流程调度与运维提效
自动化的核心目标是“让代码接管机械、高频且容易出错的人工操作”。在非开发岗位的日常办公以及运维工程师的基础设施巡检中,Python 是性价比极高的效率工具。
1. 常见自动化应用方向
- 本地文件与目录自动化:使用内置模块 pathlib 与 shutil,可以瞬间重命名成千上万个杂乱文件、按日期/部门分类归档到指定目录,或者批量解压缩归档包。
- 办公文档自动化生成:使用 openpyxl 读取并合并数百张 Excel 表格;使用 python-docx 根据模板自动批量填充合同;使用 PyPDF2 合并与拆分 PDF。
- 网络与数据抓取:利用 requests 请求公开接口,或利用 Playwright / Selenium 驱动无头浏览器自动登录系统、下载日常报表。
- 定时巡检与报警:搭配 schedule 或系统级 crontab,定时检查服务器端口存活状态、磁盘剩余空间,并在异常时自动向钉钉、企业微信机器人发送通知。
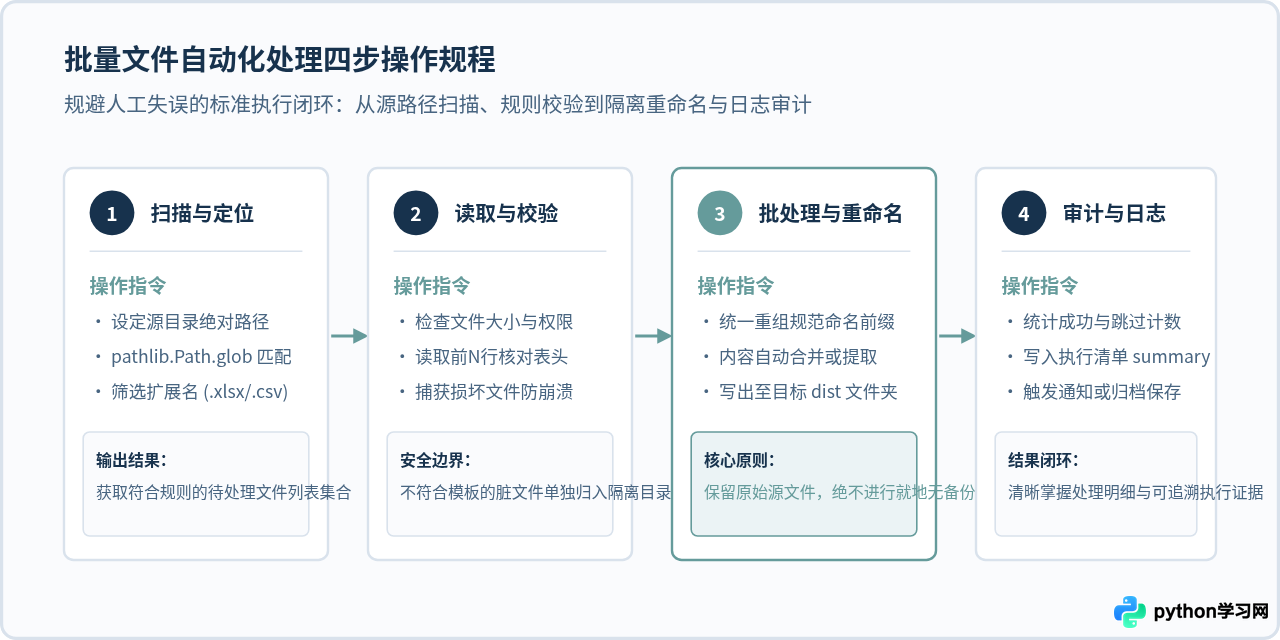
2. 典型工作示例:按规则批量扫描与备份归档
以下代码演示一个典型的办公自动化脚本:扫描指定目录下的全部 Excel 汇总文件,按照创建日期和统一命名规范整理备份到目标目录,并输出执行清单。
import shutil
from pathlib import Path
from datetime import datetime

def archive_reports(source_dir: str, target_dir: str):
    src = Path(source_dir)
    dst = Path(target_dir)
    dst.mkdir(parents=True, exist_ok=True)

    # 步骤 1:扫描源目录中所有以 .xlsx 结尾的文件
    matched_files = list(src.glob("*.xlsx"))
    print(f"[{datetime.now().strftime('%H:%M:%S')}] 找到待处理文件:{len(matched_files)} 个")

    processed_count = 0
    for file_path in matched_files:
        # 步骤 2:校验与解析文件名,规避以 ~$ 开头的 Office 临时锁文件
        if file_path.name.startswith("~$"):
            continue

        # 步骤 3:生成标准化归档文件名(添加当前日期前缀)
        today_str = datetime.now().strftime("%Y%m%d")
        new_filename = f"ARCHIVE_{today_str}_{file_path.name}"
        target_file = dst / new_filename

        # 步骤 4:安全复制(不删除源文件),保留原文件元数据
        shutil.copy2(file_path, target_file)
        processed_count += 1
        print(f" -> 已归档: {file_path.name} => {new_filename}")

    print(f"处理完成!成功归档 {processed_count} 个文件。")

# 执行示范(假定当前目录下有 input_data 文件夹)
if __name__ == "__main__":
archive_reports(source_dir="./input_data", target_dir="./archive_dist")[10:15:30] 找到待处理文件:3 个
-> 已归档: 华北区9月报表.xlsx => ARCHIVE_20261101_华北区9月报表.xlsx
-> 已归档: 华东区9月报表.xlsx => ARCHIVE_20261101_华东区9月报表.xlsx
-> 已归档: 华南区9月报表.xlsx => ARCHIVE_20261101_华南区9月报表.xlsx
处理完成!成功归档 3 个文件。四、三大场景技术选型与综合对比
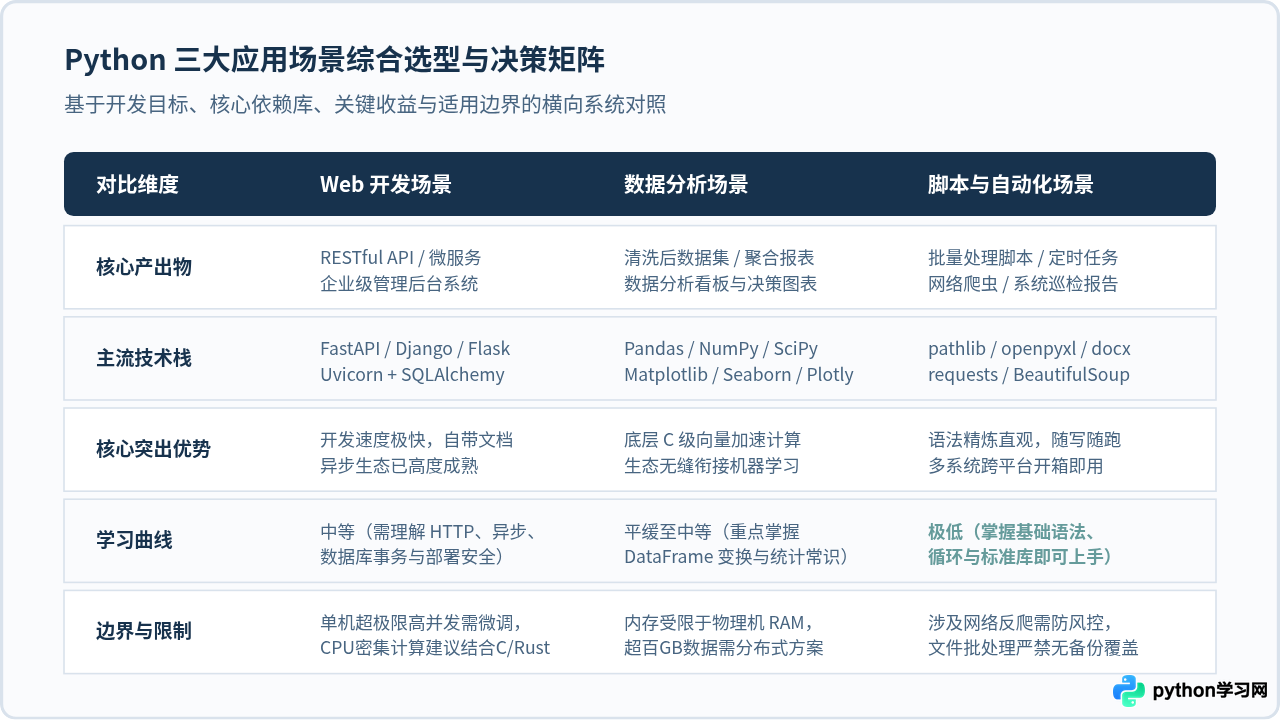
了解 Python 能做什么之后,初学者或技术选型者通常会面临“该从哪个方向切入”或“如何根据项目性质选择工具”的疑问。下表从核心产出物、技术门槛、收益场景等维度进行横向归纳:
五、实践建议:新手如何起步?
为了在实际运用中少走弯路,建议遵循以下两条基本工程习惯:
- 务必使用虚拟环境(Virtual Environment):无论是开发 Web 应用还是做数据分析,切忌直接在系统全局 Python 环境下无脑 pip install。使用 Python 自带的 python -m venv my_env,能为不同项目隔离依赖包版本,彻底避免依赖冲突。
- 从最小可工作的具体需求开始:不要试图一开始就通读框架文档。如果是为了提效,就从整理桌面的几十个乱序文件开始写起;如果是为了学习数据分析,就下载一份真实的公开消费账单写出统计;如果是为了做网站,先跑通一个打印 JSON 的单路由服务。在解决真实问题的过程中,对语法的理解最为深刻扎实。
核心总结
Python 的核心价值在于以极低的语法摩擦力,调用各专业领域的成熟工业级库。在 Web 端,它提供从轻量接口到复杂系统的敏捷交付;在数据分析端,它构建了从清洗挖掘到决策图表的标准工作流;在自动化端,它充当随时随地解放双手的数字螺丝刀。根据实际业务目标选择对应的技术栈,便能最大化释放 Python 的工程生产力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









