

Python运维开发与DevOps方向要学什么
针对企业生产环境实际需求,系统解析Python运维开发与DevOps方向的核心技能树、分阶学习路径、自动化脚本标准规范、运维平台架构及云原生可观测性落地实践。
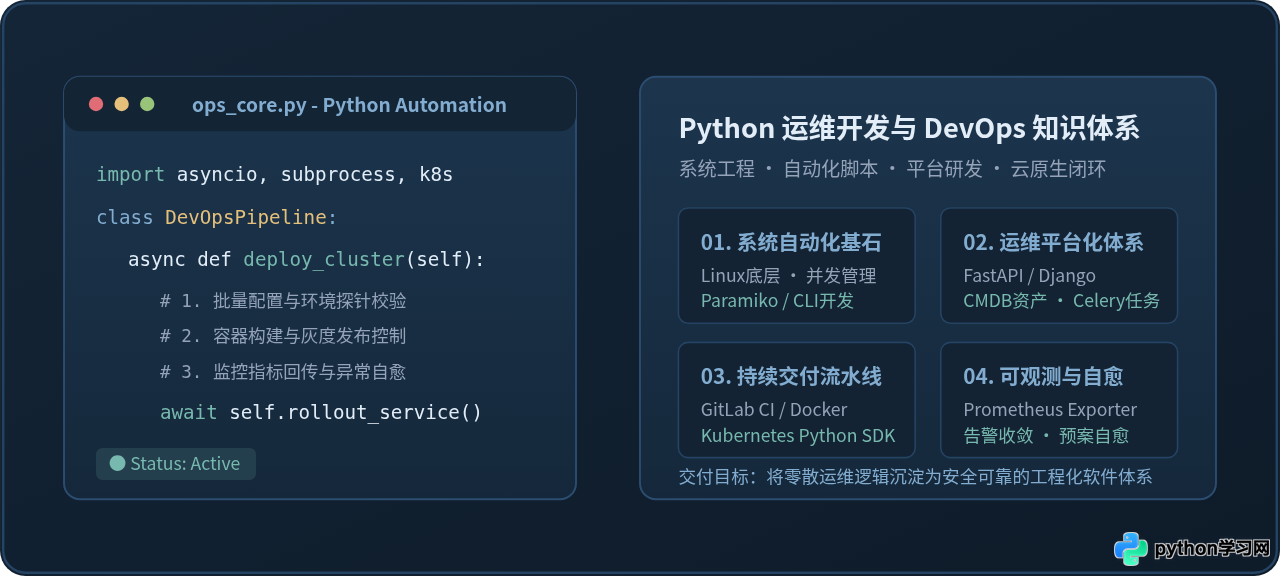
图 0:Python 运维开发与 DevOps 核心知识全景缩略导读
设想这样一个排障场景:凌晨线上集群出现异常,值班人员登录几十台服务器翻看日志,手动执行 grep 和 awk 过滤关键错误,再通过群消息反复确认各节点状态;而白天部署新版本时,又依赖容易敲错参数的长串脚本与手工执行。如果一直停留在这种“手动操作与离散脚本拼接”的阶段,运维团队将始终处于被动响应状态。转向 Python 运维开发与 DevOps,核心目标是将日常运维经验沉淀为可靠的自动化工具,进而构建覆盖配置管理、发布控制、指标监控与故障自愈的工程化平台。本文立足企业生产实际,系统解答该方向必须掌握的核心技能、分阶段学习路径、实用代码规范与架构设计方法。
一、核心定位:运维开发究竟解决什么问题
在厘清学习内容之前,首先需要明确 Python 运维开发(DevOps / SRE 开发工程师)在团队中的角色定位:它既不是单纯编写业务功能的后端开发,也不是只负责机房硬件与手动执行命令的系统管理员,而是以软件工程的方法解决系统稳定性与交付效率问题。
具体而言,日常工作围绕四个核心目标展开:
- 操作自动化与安全收敛:将单机命令与复杂流程抽象为脚本或命令行工具,提供统一的参数校验与安全防错机制。
- 集中化资产管理(CMDB):打破服务器、网络设备、云资源的信息孤岛,建立实时准确的资产配置数据库,作为所有运维动作的唯一真相源。
- 持续交付流水线建设:打通“代码提交 → 自动化测试 → 容器镜像构建 → 集群灰度发布”的自动化通道,缩短交付周期。
- 全链路可观测性与智能告警:基于监控指标、分布式链路与日志系统,开发自定义采集探针,并在指标异常时触发自动化排障预案。
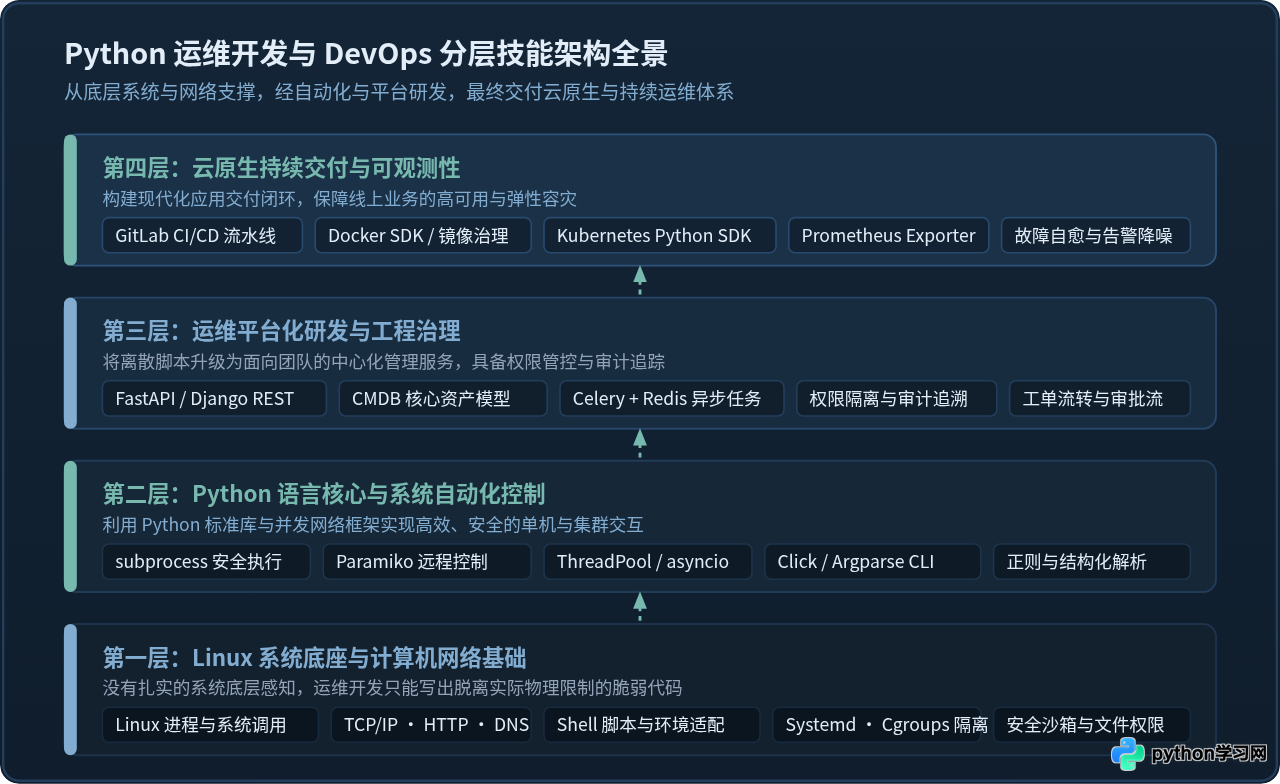
图 1:Python 运维开发与 DevOps 分层技能架构全景图
二、第一阶段:Linux 系统工程与 Python 自动化基石
很多初学者容易误以为学完 Python 语法就能直接做运维平台,却在面对复杂的进程调用、文件锁和并发网络时频繁踩坑。运维开发的根基依然是 Linux 操作系统本身,脱离了底层系统感知,写出来的代码往往十分脆弱。
1. Linux 操作系统底层能力
需要系统掌握的内容包括:Linux 进程模型(PID、PPID、僵尸进程与孤儿进程处理)、标准输入输出流与文件描述符(FD)、TCP/IP 协议栈基础(握手挥手状态分析、TIME_WAIT 与 CLOSE_WAIT 排查)、系统调用与日志轮转机制,以及 Systemd 服务单元的编写与管理。
2. Python 自动化标准库的核心用法
在日常运维脚本中,应严格规避使用危险且无法捕获异常的 os.system,全面转向现代化的 subprocess 模块。一个合格的生产级自动化调用必须满足:禁止 shell=True 带来的命令注入风险、具备严格的超时中断机制(防止子进程挂起阻塞主线程)、明确区分标准输出与错误输出,并对非零返回码进行主动捕获。
以下是企业级脚本中推荐的防御性命令执行封装范例:
import subprocess
import shlex
import logging

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

def safe_run_command(cmd_str: str, timeout: int = 15) -> str:
    """
    安全执行系统命令的标准函数
    :param cmd_str: 待执行的命令字符串
    :param timeout: 超时限制(秒)
    :return: 经过清洗的标准输出内容
    """
    # 1. 使用 shlex 安全切分命令与参数,杜绝 shell 注入
    cmd_args = shlex.split(cmd_str)

    try:
        logging.info(f"正在执行命令: {cmd_args}")
        # 2. 显式关闭 shell=True,捕获独立 stdout 与 stderr
        result = subprocess.run(
            cmd_args,
            shell=False,
            stdout=subprocess.PIPE,
            stderr=subprocess.PIPE,
            text=True,
            timeout=timeout,
            check=True  # 核心:命令返回非0状态码时主动抛出异常
        )
        return result.stdout.strip()
    except subprocess.TimeoutExpired as err:
        logging.error(f"命令执行超时 (超过 {timeout} 秒): {err}")
        raise
    except subprocess.CalledProcessError as err:
        logging.error(f"命令执行失败,退出码: {err.returncode},错误详情: {err.stderr.strip()}")
        raise
    except FileNotFoundError:
        logging.error(f"未找到目标可执行文件,请检查 PATH 环境变量")
        raise
3. 远程控制与并发执行
单机脚本只能解决单台机器的问题,而运维往往面对成百上千台节点:
- Paramiko 与 SSH 机制:基于公私钥认证实现远程主机命令下发与 SFTP 文件传输。
- 并发模型选择:针对批量巡检与远程执行(属于典型的 I/O 密集型任务),使用标准库
concurrent.futures.ThreadPoolExecutor或现代asyncio驱动异步网络库,将数千台节点的巡检耗时从数十分钟压缩到十几秒。 - 命令行界面交互(CLI):熟练使用
click或argparse库,为运维脚本提供清晰的--help参数说明、类型校验与彩色终端输出。
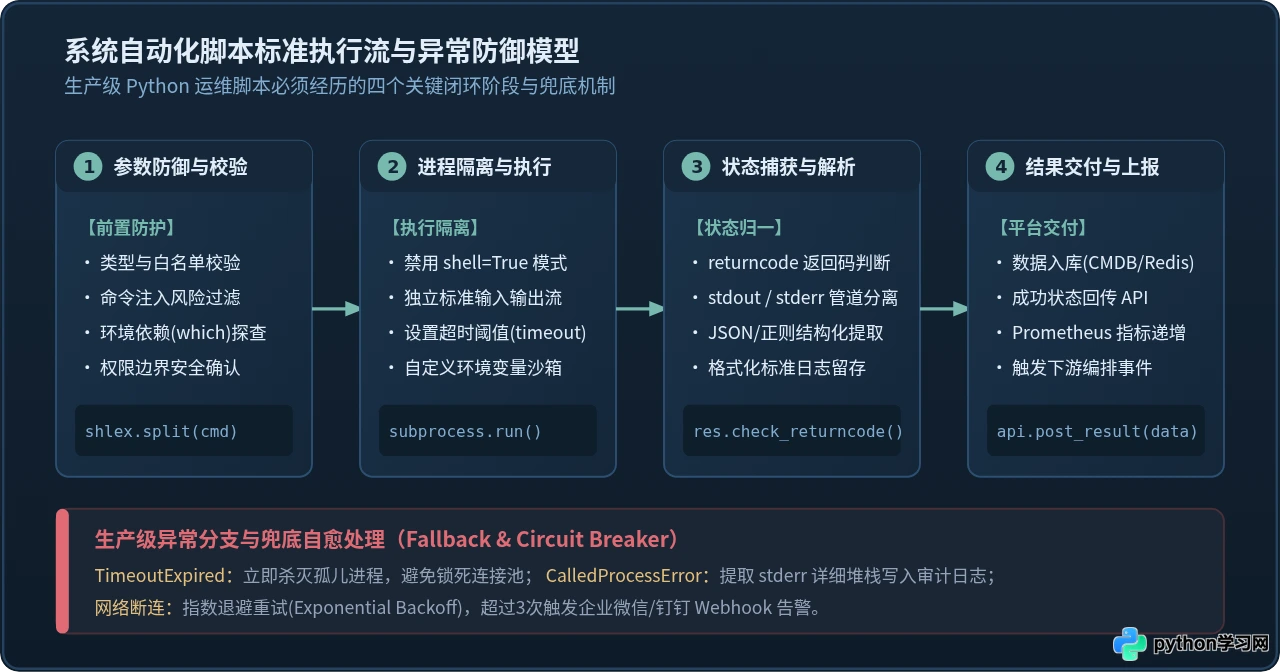
图 2:生产级系统自动化脚本执行流与异常防御机制
三、第二阶段:运维平台化开发——从离散脚本到 Web 运维系统
脚本虽然高效,但分散在运维人员的个人电脑上容易带来三大隐患:权限缺乏隔离(每个人都有 root 密码)、操作无法审计追溯、业务研发无法自助服务。因此,必须将脚本能力整合为平台化服务。
1. 现代化 Web 框架技术选型
在 Python 生态中,推荐掌握两大主流 Web 框架:
- FastAPI(首选推荐):基于 ASGI 的异步高性能框架,原生支持 Python 强类型注解(Pydantic),自动生成交互式 Swagger/OpenAPI 文档。非常适合编写轻量微服务、Agent 节点通信网关与供 CI/CD 调用的 Webhook 接口。
- Django(成熟大而全):内置完善的后台管理(Admin)、身份认证(Auth)与强大的 ORM。对于需要快速落地权限系统、审批流程与多表关联资产库的运维中台,Django 能大幅减少重复造轮子工作。
2. 运维平台三大核心子系统
初学者构建运维平台时,建议围绕以下三个业务抓手开展:
- CMDB(配置与资产管理系统):存储主机配置、机房机架、容器服务映射、业务线归属。通过自动化 Agent 探针定时采集软硬件信息,确保资产数据实时同步。
- 异步任务调度中心(Celery + Redis):Web 接口的生命周期通常在数百毫秒内,而执行一次集群基线巡检或全量发版可能需要几分钟。必须使用 Celery 异步任务队列解耦,由后台 Worker 异步消费,Web 前端通过轮询或 WebSocket 实时推送执行日志进度。
- 跳板机与操作审计系统:记录所有用户通过平台下发的命令日志,配置高危命令黑名单(如
rm -rf /、mkfs),实现风险动作二次审批阻断。
架构提示:运维平台切忌一上来就追求微服务分布式拆分。初创期推荐使用“FastAPI/Django + PostgreSQL + Redis + Celery”的单体架构,足以支撑上万台主机的日常自动化调度需求。
四、第三阶段:DevOps 持续交付与容器云原生生态
当平台能力具备后,下一步就是将其与现代软件研发流程深度结合,实现代码从开发机到生产环境的无人值守持续交付。
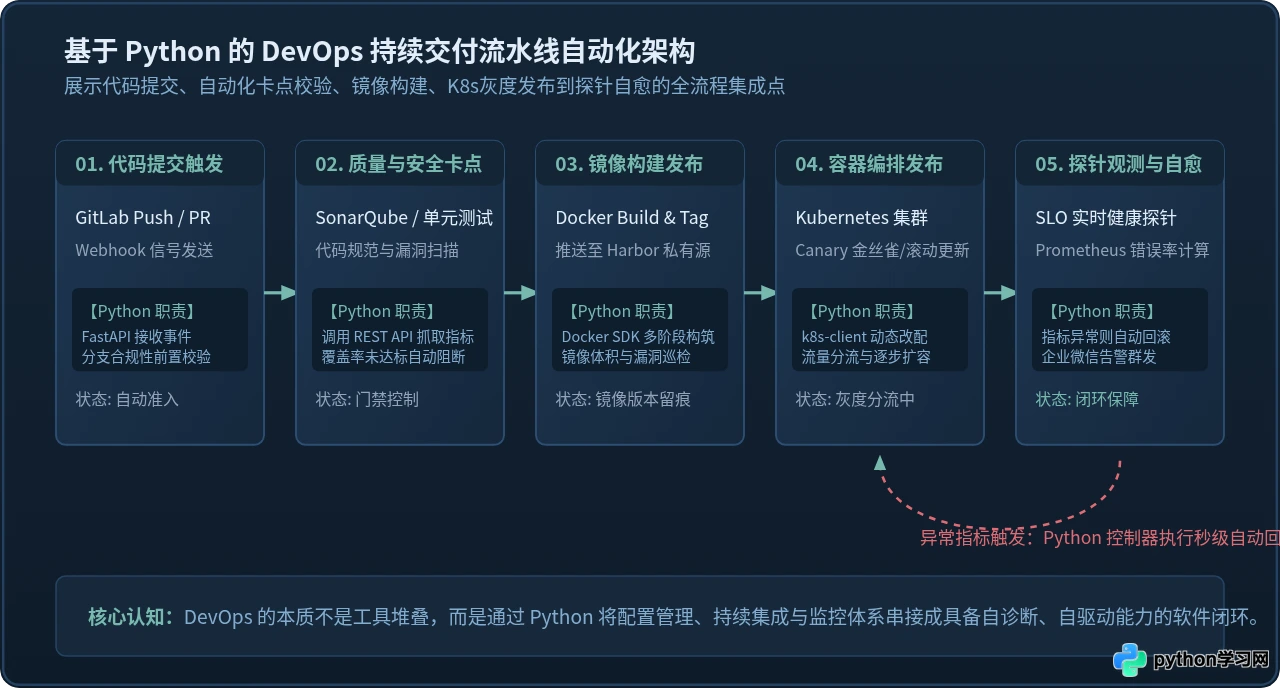
图 3:基于 Python 的 DevOps 持续交付流水线自动化架构
1. CI/CD 流水线深度集成
熟练掌握 GitLab CI、GitHub Actions 或 Jenkins Pipeline 的配置语法(YAML / Groovy),但更关键的是通过 Python 与它们的 API 进行交互。例如:通过 GitLab REST API 监听代码 Merge Request 事件,自动拉起临时测试环境;在自动化测试与 SonarQube 代码安全扫描通过后,自动在发布平台打上准入标签。
2. 容器与 Kubernetes(K8s)开发实战
当业务全面转向容器化后,Docker 与 K8s 成为运维事实上的底层平台:
- Docker SDK for Python:编写镜像瘦身校验脚本、无用镜像定期清理服务,以及自动化多阶段构建工具。
- Kubernetes 官方 Python 客户端(
kubernetes-client):通过代码与 K8s API Server 通信,动态更新 Deployment、获取 Pod 实时状态、自动扩缩副本数,甚至开发专用的 K8s 巡检 Operator。 - 基础设施即代码(IaC):学习使用 Terraform 管理多云资源,利用
ansible-runnerPython 库在后台无缝调用 Ansible Playbook。
以下示例展示如何使用官方 kubernetes Python 库列出集群中异常状态的 Pod:
from kubernetes import client, config
import logging

def inspect_unhealthy_pods(namespace: str = "default"):
    """
    检查指定命名空间内非 Running/Completed 状态的 Pod 实例
    """
    # 加载集群配置(如果在 Pod 内部执行则使用 load_incluster_config)
    config.load_kube_config()
    v1 = client.CoreV1Api()

    logging.info(f"开始巡检命名空间 [{namespace}] 的 Pod 状态...")
    pod_list = v1.list_namespaced_pod(namespace=namespace)

    unhealthy = []
    for pod in pod_list.items:
        phase = pod.status.phase
        # 筛选异常或重启次数过高的 Pod
        restart_count = sum(c.restart_count for c in pod.status.container_statuses or [])
        if phase not in ["Running", "Succeeded"] or restart_count > 5:
            unhealthy.append({
                "name": pod.metadata.name,
                "phase": phase,
                "restarts": restart_count,
                "node": pod.spec.node_name
            })

    return unhealthy
五、第四阶段:全链路可观测性与 SRE 故障自愈
运维系统的最高阶段,是让系统具备自我感知、自动决策和自动修复的 SRE(站点可靠性工程)能力。
1. 指标采集与 Prometheus 生态集成
开源的 Node Exporter 只能采集通用 CPU、内存和磁盘指标,企业业务中往往存在私有协议、特定的队列堆积或数据库连接池指标。掌握 prometheus_client 库,编写属于自己的自定义 Exporter,将内部数据转化为 Prometheus 规范的时序指标暴露出去。
2. 告警风暴治理与降噪算法
在大型基础设施中,某一台交换机故障可能会连带引发数百台服务器报警,导致运维群内每秒被成百条告警刷屏(即“告警风暴”)。运维开发需要通过 Python 编写告警网关,实现:
- 滑动窗口去重:在指定时间窗口(如3分钟)内对相同主机、相同事件的告警进行合并聚合。
- 依赖关系压制:若检测到上游机房核心网关断连,自动静默该机房所有子节点的主机存活告警。
- 多渠道按需路由:P0 级核心业务故障拨打电话与短信,低级别告警发送企业微信、飞书或钉钉群机器人。
3. 自动化故障自愈(Auto-Healing)
将常见排错步骤转变为自动化预案。例如:当监控系统捕捉到磁盘占用超过 90% 告警时,自愈系统自动匹配机器 IP,下发安全日志清理脚本;当应用节点频繁出现 FullGC 时,自动生成 HeapDump 并执行优雅摘流与重启,将平均故障恢复时间(MTTR)从数十分钟缩短至秒级。
六、学习路径规划、对比分析与避坑指南
学习 Python 运维开发切忌盲目追新。很多学习者一上来就试图死磕 Kubernetes 核心源码或分布式追踪算法,往往因缺乏系统实操经验而半途而废。
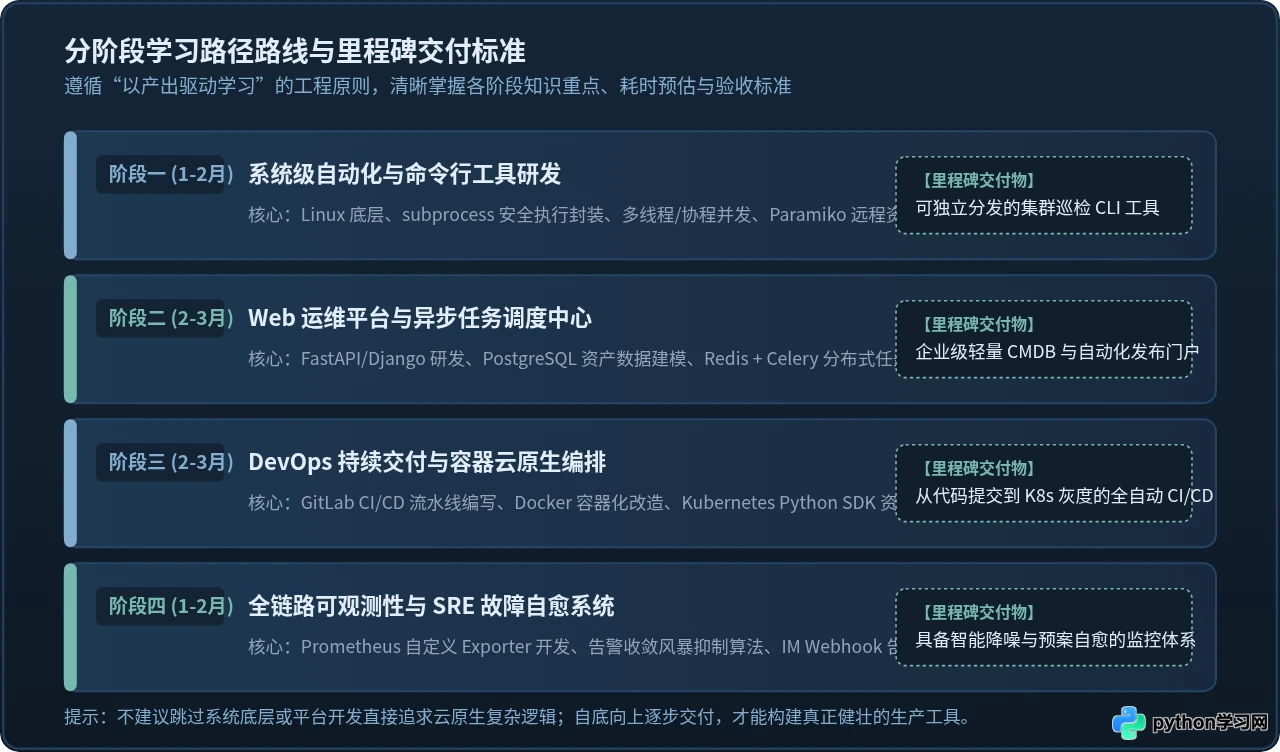
图 4:分阶段学习路线、时间规划与里程碑交付标准
1. 方向核心特质对比分析
下表对比了传统运维、Python 运维开发与纯后端开发的核心关注点与能力差异,帮助明确技能建设的侧重点:
| 对比维度 | 传统系统运维 | Python 运维开发 / DevOps | 业务后端开发 |
|---|---|---|---|
| 核心交付物 | 系统配置、手动排错、日常发布巡检 | 自动化脚本、运维平台、CI/CD流水线、自愈服务 | 业务需求功能接口、数据持久化存储 |
| 代码关注重点 | Shell 基础语法、命令拼接 | 鲁棒性、超时重试、系统底层安全、并发效率 | 业务领域逻辑、高并发高可用事务、业务缓存 |
| 关键技术栈 | Linux 命令、Nginx、MySQL、Shell | Python、FastAPI/Django、K8s SDK、Celery、Prometheus | Java / Go / Python、Spring、Redis、MQ |
| 价值衡量指标 | 保障不出故障、被动响应时间 | 运维自动化率、交付效率提升倍数、MTTR降低幅度 | 业务功能上线速度、订单处理吞吐量 |
2. 必须警惕的三大实战误区
避坑一:编写只管执行不管异常的“脆弱脚本”。生产环境中命令失败、网络抖动、磁盘满载是常态。切忌写出没有 try...except、不设超时阈值、忽略返回码的代码,否则自动化工具反而会成为引发故障的催化剂。
避坑二:硬编码密钥与忽视权限隔离。严禁在 Python 脚本或 Git 仓库中直接写死 root 密码、云厂商 AccessKey 或数据库凭证。应一律使用环境变量、Vault 密钥管理中心或临时 Token 进行身份验证。
避坑三:脱离真实场景,过度设计架构。只有几台服务器时不要强行上微服务和分布式编排。从最直接解决团队效率痛点的批量脚本与轻量 CLI 起步,待管理节点膨胀到数百台规模时,再自底向上自然演进出平台与自愈体系。
七、总结
Python 运维开发与 DevOps 的本质,是用软件工程师的严谨思维重塑基础设施的管理逻辑。学习该方向的关键在于坚持“以具体成果驱动进阶”:先打牢 Linux 与 Python 自动化基础,编写出具备防御特性的 CLI 工具;进而借助 FastAPI/Django 与 Celery 落地资产与发布平台;最终融入 Docker、Kubernetes 编排与 Prometheus 可观测性,打通研发到线上运维的自动化闭环。只要每一步都紧扣稳定性与交付效率这两大核心,就能构建起真正经得起生产考验的技术竞争力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









