

python必背源代码批量重命名文件代码
本文系统整理了Python批量重命名文件的必背核心源代码,涵盖数字对齐归档、前后缀提取、字符串替换、正则解析重组以及防止文件覆盖的两阶段安全重命名机制,提供完整可运行的工程级代码模板与注意事项。
一、批量重命名的核心底层与标准库选择
在 Python 语言中,处理文件重命名通常有两个标准库选择:传统的 os 模块以及现代面向对象的 pathlib 模块(Python 3.4+ 内置)。虽然 os.rename(src, dst) 在老旧代码中依然常见,但在批量处理场景下,pathlib.Path 具备显著优势。
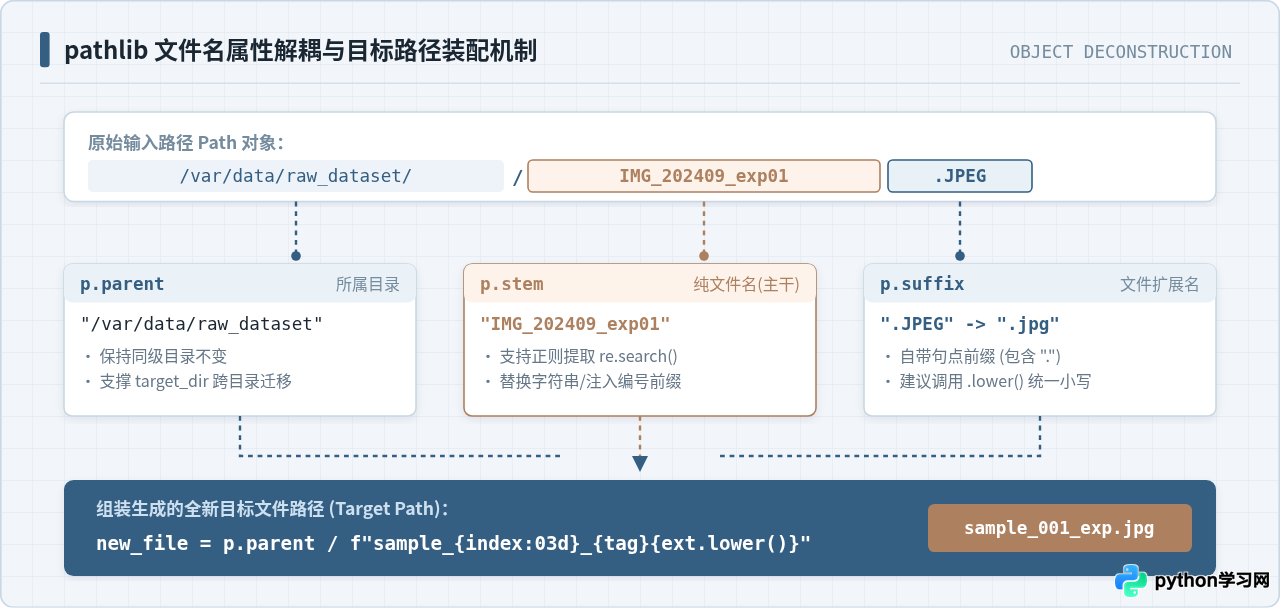
使用 pathlib.Path 时,路径被视为具备语义的对象,提供了 .stem(无后缀的主文件名)、.suffix(文件扩展名,自带句点)以及 .parent(所在父目录)等属性。开发者无需手动调用 os.path.splitext() 进行复杂的字符串切片,大幅降低了因多重扩展名(如 .tar.gz)或无扩展名文件导致的切片错误。
| 对比维度 | 传统 os 模块 (os.rename) | 现代 pathlib 模块 (Path.rename) |
|---|---|---|
| 对象类型 | 纯文本字符串 (str) | 面向对象的路径实体 (Path) |
| 提取主文件名 | os.path.splitext(os.path.basename(path))[0] |
path.stem(直观且语义清晰) |
| 提取扩展名 | os.path.splitext(path)[1] |
path.suffix(原生支持) |
| 跨平台路径拼接 | os.path.join(dir, new_name) |
path.parent / new_name(通过 / 运算符直观拼接) |
| 存在性判断 | os.path.exists(path) |
path.exists() |
一个标准的批量重命名执行过程由四个紧密相连的阶段构成:扫描定位目标文件、解析与重塑名称、重名冲突检测、物理落盘改名。执行逻辑如下图所示:
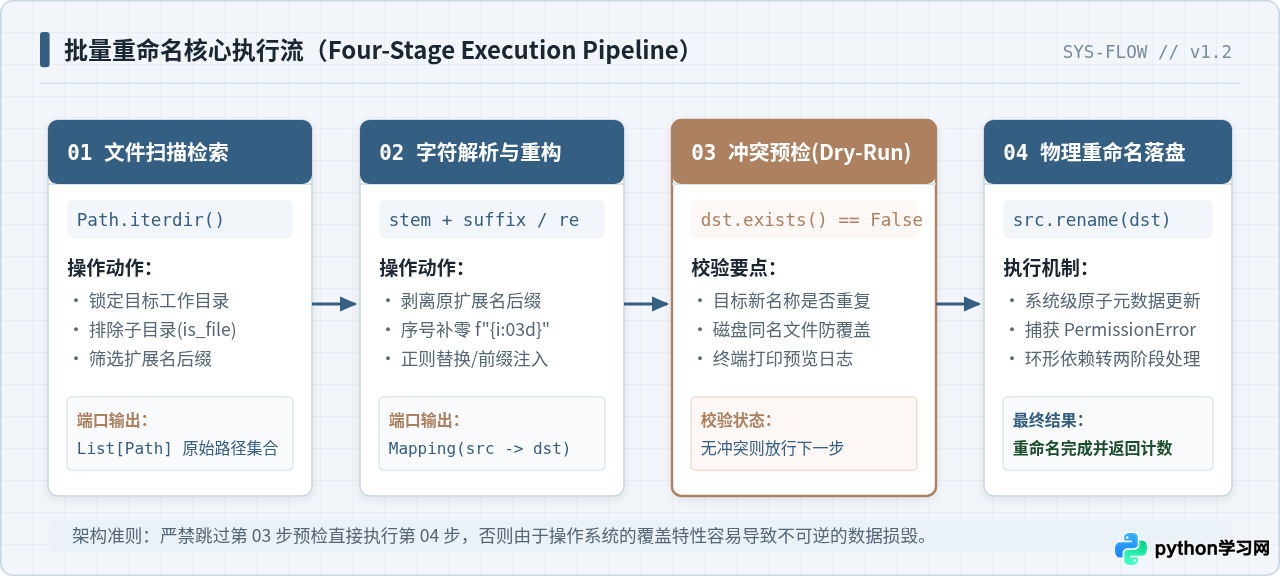
无论后续重命名逻辑如何变动,这四个步骤是编写自动化脚本的骨架。接下来将展示三套最实用、值得记忆并直接复用的经典代码实现。
二、经典必背代码实现:三大核心重命名模式
1. 模式一:格式化序号递增与自动对齐补零
此场景最常用于整理散乱的图片、测试日志、报告扫描件或机器学习数据集。关键做法是使用 enumerate() 获取递增计数,并通过 Python 的格式化字符串语法 {idx:03d}(或 :04d)在数字前方自动对齐补零。如果不补零,系统在按文件名 ASCII 码排序时会出现 10.jpg 排在 2.jpg 前面的错位现象。
from pathlib import Path

def rename_sequential(folder_path: str, prefix: str = "file", ext_filter: str = ".jpg") -> None:
    """按递增序号对指定目录下的特定文件进行批量重命名"""
    target_dir = Path(folder_path)
    if not target_dir.is_dir():
        raise NotADirectoryError(f"目标路径不存在或不是文件夹: {target_dir}")

    # 筛选出属于普通文件且扩展名匹配的列表,建议提前排序保证顺序固定
    files = sorted([p for p in target_dir.iterdir() if p.is_file() and p.suffix.lower() == ext_filter.lower()])

    for idx, file_path in enumerate(files, start=1):
        # :03d 表示数字宽度为3,不足3位高位自动补零(如 001, 002, ...)
        new_filename = f"{prefix}_{idx:03d}{file_path.suffix.lower()}"
        new_path = file_path.parent / new_filename

        if not new_path.exists():
            file_path.rename(new_path)
            print(f"[OK] {file_path.name} -> {new_filename}")
        else:
            print(f"[SKIP] 目标名称已存在,跳过: {new_filename}")

# 执行示例(调用前请确认路径)
# rename_sequential(r"/Users/project/photos", prefix="vacation", ext_filter=".jpg")
代码重点说明:在排序时显式调用 sorted() 至关重要。因为操作系统在读取目录索引项时返回的次序并不保证稳定,先排序能确保每次执行都能按照原始名称的固定顺序重新编排。
2. 模式二:统一追加前后缀与关键词精准替换
在日常归档或团队协作中,经常需要为一批文件增加项目标识前缀(如 v1.0_、Final_),或者剔除下载文件自带的广告网站后缀。此时的核心原则是只操作文件名主干 path.stem,保留原有 path.suffix 不变。
from pathlib import Path

def rename_replace_or_prefix(folder_path: str, add_prefix: str = "", add_suffix: str = "",
                             old_str: str = "", new_str: str = "") -> None:
    """对主文件名进行前缀添加、后缀添加或特定关键词替换"""
    target_dir = Path(folder_path)

    for file_path in target_dir.iterdir():
        if not file_path.is_file():
            continue

        stem = file_path.stem  # 获取去除扩展名后的主文件名

        # 执行内容替换
        if old_str:
            stem = stem.replace(old_str, new_str)

        # 组装前后缀
        new_stem = f"{add_prefix}{stem}{add_suffix}"
        new_filename = f"{new_stem}{file_path.suffix}"
        new_path = file_path.parent / new_filename

        if file_path != new_path and not new_path.exists():
            file_path.rename(new_path)
print(f"[OK] {file_path.name} -> {new_filename}")很多初学者直接写 file_name.replace("doc", "docx"),如果原文件名是 document_review.doc,会导致替换后变成 docxument_review.docx,不仅污染了主文件名,甚至误改了扩展名。务必分离 stem 与 suffix 分开处理。
3. 模式三:正则表达式高级捕获与模式重构
当文件命名格式复杂(例如含有拍摄时间、机身型号、版本标记等混合信息)且需要重排时,字符串的切片和简单替换就显得力不从心。此时引入 re 模块的捕获组(Capture Groups),可以精准提取所需字段并重新编排。
import re
from pathlib import Path

def rename_with_regex(folder_path: str, pattern: str, replacement: str) -> None:
    """
    使用正则表达式对主文件名进行模式匹配与重组
    示例 pattern: r"^(\d{4})-(\d{2})-(\d{2})_(.*)$"  (匹配 2024-05-18_report)
    示例 replacement: r"\g<4>_\g<1>\g<2>\g<3>"           (重组成 report_20240518)
    """
    target_dir = Path(folder_path)
    regex = re.compile(pattern)

    for file_path in target_dir.iterdir():
        if not file_path.is_file():
            continue

        # 仅对主文件名执行正则匹配与替换
        original_stem = file_path.stem
        if regex.search(original_stem):
            new_stem = regex.sub(replacement, original_stem)
            new_filename = f"{new_stem}{file_path.suffix}"
            new_path = file_path.parent / new_filename

            if not new_path.exists():
                file_path.rename(new_path)
                print(f"[REGEX-OK] {file_path.name} -> {new_filename}")
            else:
                print(f"[CONFLICT] {new_filename} 目标已存在,跳过")
三、工程级防御:防止文件覆盖与两阶段暂存机制
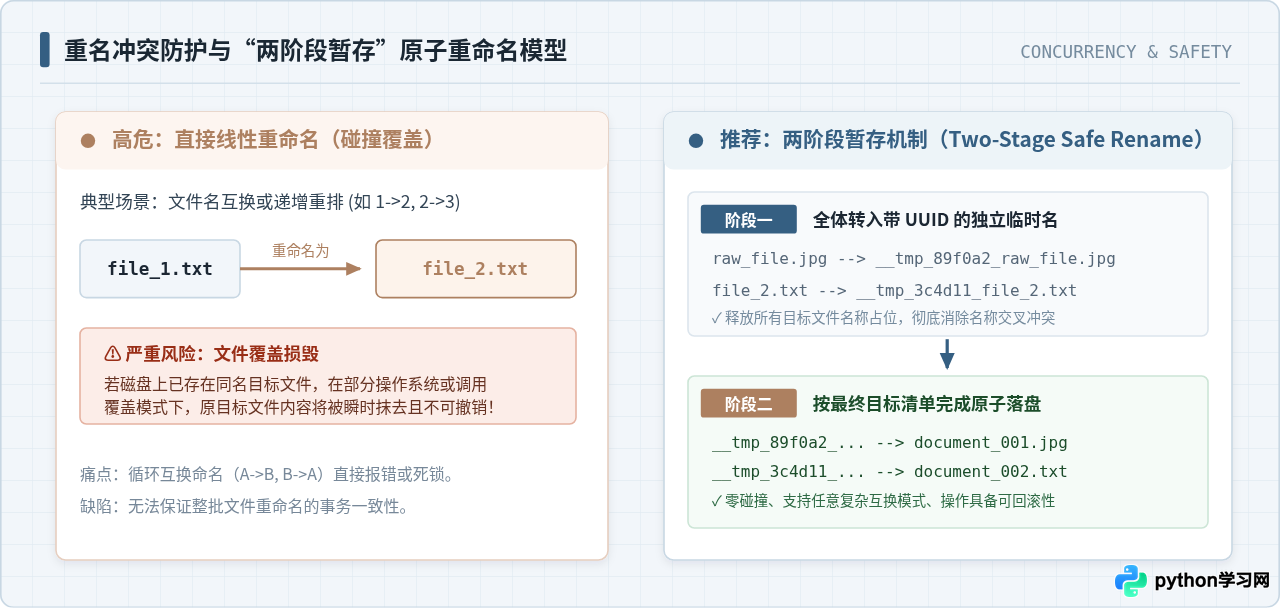
在本地开发或批量处理数万个真实文件时,最严重的事故是“意外文件覆盖导致数据永久损毁”。在许多 POSIX 系统中,若目标路径 new_path 已存在文件,直接调用系统底层 rename() 会直接将目标文件覆写并不产生任何警示。
1. 为什么直接线性重命名会产生碰撞与死锁?
设想一个经典场景:你想将 file_1.txt 改名为 file_2.txt,将 file_2.txt 改名为 file_3.txt。如果在循环中从前向后执行,当处理 file_1.txt 时,磁盘上的 file_2.txt 就会被覆盖;轮到原有的 file_2.txt 时,数据其实早已丢失。另一个更典型的死锁是两文件名称互换:A -> B 且 B -> A。
2. 两阶段暂存重命名法(Two-Stage Safe Rename)
工业级可靠性的解决范式是引入两阶段暂存重命名法:
- 第一阶段(隔离暂存):先将所有待重命名文件重命名为全局唯一的临时名称(例如在文件名前拼接包含
uuid4()或高精度时间戳的特殊前缀__tmp_uuid_...)。这一阶段彻底释放了原有的文件名占位,消除了相互碰撞的可能。 - 第二阶段(最终装配):遍历第一阶段的暂存映射字典,将每个临时文件逐一重命名为真正的最终目标名称。
import uuid
from pathlib import Path
from typing import List, Tuple

def safe_two_stage_rename(rename_plan: List[Tuple[Path, Path]]) -> None:
    """
    两阶段安全批量重命名
    :param rename_plan: 二元组列表 [(源路径Path, 最终目标路径Path), ...]
    """
    # 0. 前置严格冲突检查:检查计划输出中是否存在重复目标
    destination_set = set()
    for _, dst in rename_plan:
        if dst in destination_set:
            raise ValueError(f"重命名计划内部存在冲突目标: {dst}")
        destination_set.add(dst)

    temp_mappings: List[Tuple[Path, Path]] = []

    # 阶段一:批量转换为临时中间文件名
    print("--- [阶段一] 开始转入唯一隔离中间态 ---")
    for src, final_dst in rename_plan:
        if not src.exists():
            print(f"[WARN] 源文件不存在,跳过: {src}")
            continue
        # 构造带有随机 UUID 标记的中间文件名
        temp_name = f"__tmp_{uuid.uuid4().hex[:8]}_{src.name}"
        temp_path = src.parent / temp_name
        src.rename(temp_path)
        temp_mappings.append((temp_path, final_dst))

    # 阶段二:从临时文件名转为最终目标名称
    print("--- [阶段二] 从中间态转入最终目标 ---")
    success_count = 0
    for temp_path, final_dst in temp_mappings:
        if final_dst.exists():
            # 此时若已存在,说明是外部现有未纳入计划的文件,报错拦截
            raise FileExistsError(f"目标路径已被外部文件占用: {final_dst}")
        temp_path.rename(final_dst)
        success_count += 1
        print(f"[SUCCESS] -> {final_dst.name}")

    print(f"安全重命名完成,共成功落盘 {success_count} 个文件。")
四、批量重命名前的代码演练(Dry-Run机制)与综合选型
在任何真实环境执行批量重命名脚本前,强烈建议加入 dry_run 参数。所谓 Dry-Run,即“模拟演练”:代码会照常遍历文件、计算新文件名并进行冲突检测,并在终端完整打印变更对照表,但完全不调用任何实际的落盘修改操作。只有在肉眼核验无误后,再开启真实执行开关。
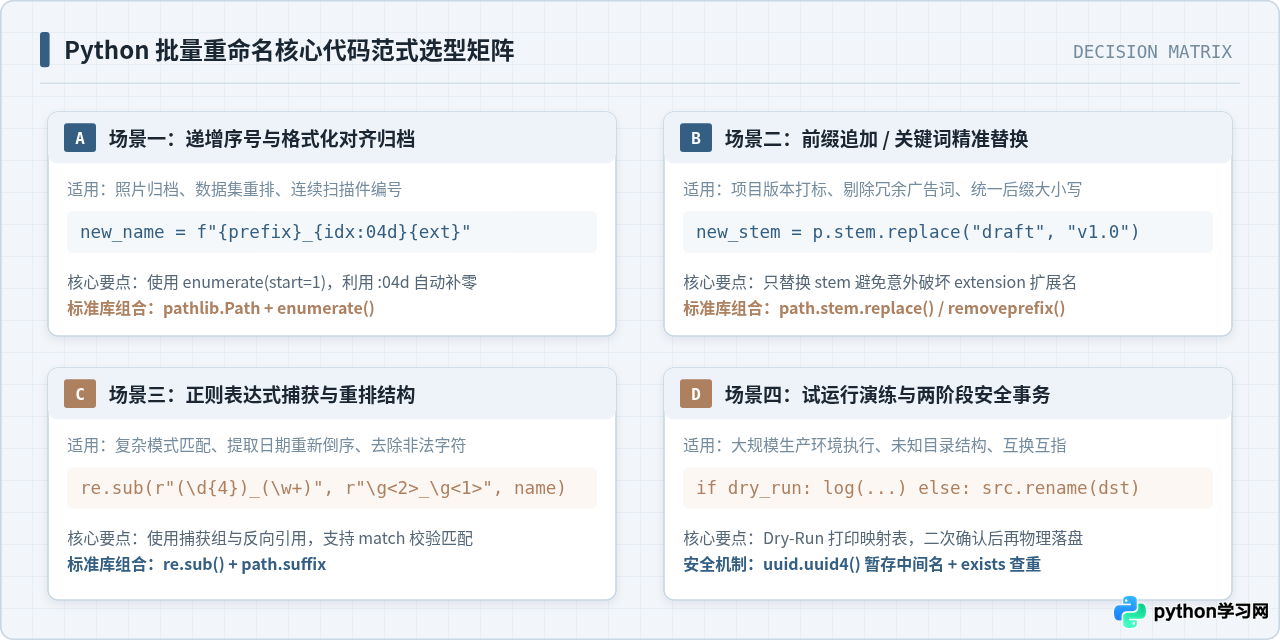
开箱即用通用代码模板
以下提供一个集成 dry_run 试运行开关、进度提示、计数统计以及异常保护的工业级开箱即用模板,适合直接保存到项目工程中或作为命令行小工具调用:
import sys
from pathlib import Path

def batch_rename_tool(
    folder: str,
    prefix: str = "",
    suffix: str = "",
    seq_start: int = 1,
    digits: int = 3,
    filter_ext: str = None,
    dry_run: bool = True
) -> None:
    """
    综合通用批量重命名主函数
    :param folder: 目标文件夹路径
    :param prefix: 新文件名前缀
    :param suffix: 新文件名后缀(放在编号之后,扩展名之前)
    :param seq_start: 递增序号起始值
    :param digits: 序号位数补零(例如 3 表示 001~999)
    :param filter_ext: 限定扩展名,如 '.pdf',为 None 时处理所有文件
    :param dry_run: 演练模式标志位(默认为 True,不修改磁盘)
    """
    target_path = Path(folder)
    if not target_path.exists() or not target_path.is_dir():
        print(f"错误: 目标路径不存在或非文件夹: {folder}", file=sys.stderr)
        return

    # 检索待处理文件
    files = [f for f in target_path.iterdir() if f.is_file()]
    if filter_ext:
        files = [f for f in files if f.suffix.lower() == filter_ext.lower()]

    files.sort(key=lambda x: x.name)
    total_files = len(files)
    if total_files == 0:
        print("未找到匹配的文件,流程终止。")
        return

    print(f"=== 批量重命名任务启动 (模式: {'【模拟演练 DRY-RUN】' if dry_run else '【真实执行 LIVE】'}) ===")
    print(f"工作目录: {target_path.resolve()}")
    print(f"匹配文件总数: {total_files}
")

    planned_moves = []
    has_conflict = False

    for i, f in enumerate(files, start=seq_start):
        idx_str = str(i).zfill(digits)
        new_name = f"{prefix}{idx_str}{suffix}{f.suffix.lower()}"
        destination = f.parent / new_name

        # 检测重名风险
        conflict_tag = ""
        if destination.exists() and destination != f:
            conflict_tag = " [⚠ 冲突:目标文件已存在]"
            has_conflict = True

        print(f"  [{i}] {f.name}  --->  {new_name}{conflict_tag}")
        planned_moves.append((f, destination))

    if has_conflict:
        print("
[警告] 检测到目标名称冲突!为保障安全,请修正规则或改用两阶段暂存机制。")
        if not dry_run:
            print("任务中止:未对磁盘做任何修改。")
            return

    if dry_run:
        print("
提示: 以上仅为模拟预览输出。确认无误后,将 dry_run 设置为 False 即可实际执行重命名。")
    else:
        print("
开始执行实际落盘...")
        done_cnt = 0
        for src, dst in planned_moves:
            if src != dst:
                src.rename(dst)
                done_cnt += 1
        print(f"执行完毕!已成功重命名 {done_cnt} 个文件。")

# 实际调用示例:先演练预览,确认无误再将 dry_run 改为 False
if __name__ == "__main__":
    # batch_rename_tool(r"./my_data", prefix="doc_", seq_start=1, digits=3, filter_ext=".pdf", dry_run=True)
    pass
五、开发与运行注意事项
在编写和运行 Python 文件批处理脚本时,以下几个工程细节经常被忽略,但在实际生产场景中至关重要:
- 操作系统大小写敏感性差异:在 Linux 系统下,
Image.jpg和image.jpg是两个不同的文件;而在 Windows 和 macOS(默认 APFS 不区分大小写配置)下,它们指向同一文件。如果仅仅想将文件名由大写改成小写(如DOC.TXT改为doc.txt),在 Windows 上直接rename可能会抛出异常或被系统判定无变化,此时必须借助两阶段暂存法或临时中转名完成。 - 特殊字符与转义保护:文件名中如果包含空格、方括号
[]、圆括号()、特殊符号等,在控制台直接执行 shell 命令极易出错,但 Python 的pathlib在底层直接向系统内核传递 Unicode 字符串,天然规避了命令行转义注入的问题。 - 文件占用与权限锁定:在 Windows 系统下,如果某个待重命名的文件正被 Excel、Word 或其他进程以独占方式打开,Python 会抛出
PermissionError: [WinError 32] 另一个程序正在使用此文件。在生产脚本中,应当使用try...except PermissionError包裹重命名调用,记录失败日志并允许重试。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









