

Python中使用set集合快速去重的原理与局限
深入解析Python中使用set集合进行快速去重的底层哈希机制,分析元素无序性、不可哈希类型及自定义对象处理等核心局限,并提供保序去重与工程选型建议。
在Python中去除序列里的重复元素时,最直接也是最常用的写法是 list(set(seq))。这种方法凭借底层的哈希表机制,能够在接近 O(n) 的时间复杂度内完成海量数据的去重处理。然而,快速去重的背后隐藏着元素必须可哈希、原始相对顺序丢失以及自定义对象判等特殊规则等一系列边界条件。本文将详细拆解 set 去重的执行过程与哈希底层原理,逐一剖析其实际局限,并提供保持原序及处理复杂对象的替代方案。
一、快速去重的标准用法与核心操作流程
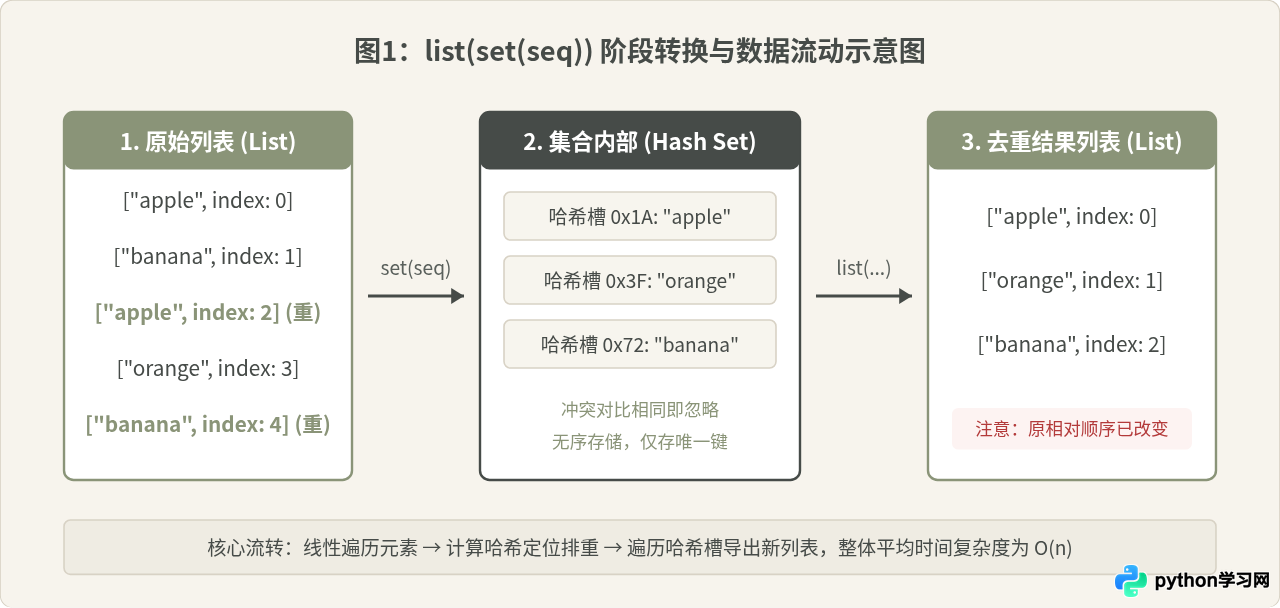
在Python中,对包含重复项的基础列表进行去重,只需将其作为参数传入 set() 构造器,再将生成的集合转回列表即可。这一过程简洁高效,属于典型的空间换时间策略。
# 基础去重示例
raw_data = ["apple", "banana", "apple", "orange", "banana"]
unique_data = list(set(raw_data))

# 示例输出(注意:元素顺序可能与原列表不同):
# unique_data: ['orange', 'banana', 'apple']
这段代码看似只有一行,实际在Python底层执行了两个完整阶段:首先由 CPython 的 set_add 逻辑逐个读取序列元素并构建哈希桶;随后列表构造函数再遍历哈希集合中的唯一元素,分配连续内存并组装成新列表。
二、底层原理:哈希表寻址与等值判定双重校验
为什么 set 去重能够如此迅速?如果使用传统的两层循环遍历比对,去重的时间复杂度为 O(n²);即便是使用辅助列表通过 if item not in unique_list 检查,其查找也是 O(n),总开销依然是 O(n²)。而 set 内部基于开放寻址法的哈希表(Hash Table)结构构建,单次元素查重的时间复杂度平均为 O(1)。
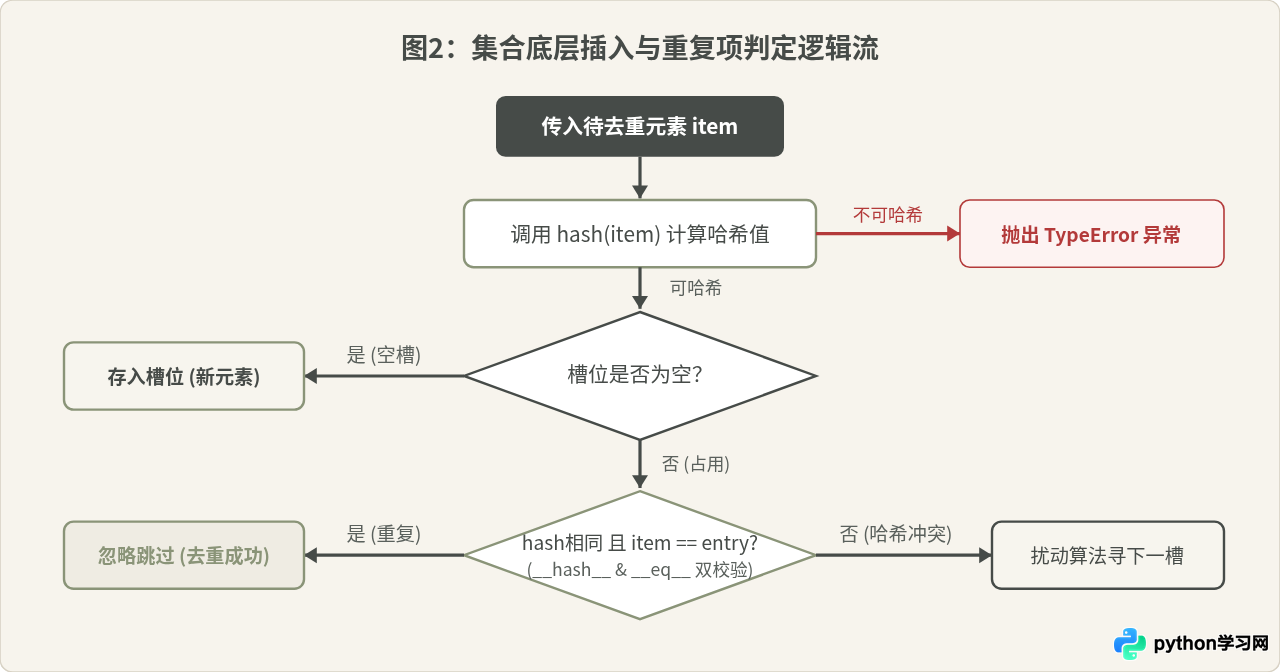
当一个元素试图存入集合时,Python 会依序执行两个关键检查步骤:
- 计算哈希值定位桶位(Hash Code): 调用元素内部的
__hash__()魔术方法,将其映射为整数,并对当前哈希表大小做掩码计算得出桶索引。如果目标槽位为空,直接存入。 - 哈希冲突与等值比较(Equality Check): 如果目标槽位已被占用,Python 不会盲目认定重复,而是先比对两者的哈希值是否一致;若哈希值相同,再调用
__eq__()检查内容是否相等。只有当哈希值相同且等值判断为真时,才确认为重复项并跳过写入;若等值判断为假(即发生哈希碰撞),则通过扰动算法(Perturbation)探测下一个可用槽位。
答案是会。在Python中,布尔类型 bool 是 int 的子类。hash(True) == 1 且 True == 1 恒成立。因此执行 list(set([1, True, 1.0])) 时,后进入集合的元素会被判定为与第一个元素重复而被略去,最终只会保留一个元素。
三、set去重的三大核心局限
尽管 set 处理去重极其高效,但在许多生产环境中不能直接无脑调用。忽视其底层原理往往会导致难以排查的 Bug。
1. 局限一:无法保留序列原本的先后顺序
由于 set 的存放位置取决于元素哈希值与当前分配桶掩码的计算结果,其存储顺序与元素在列表中的输入顺序完全无关。转换回列表后,元素的相对顺序会被彻底打乱。
有些开发者在测试小整数(如 [3, 1, 2, 1])时,可能会误以为“顺序没有乱”,这是因为小整数的哈希值与其数值本身直接关联,哈希表寻址碰巧保持了数字升序。但这只是特定实现下的偶然现象,在字符串、负数、大整数或带盐值哈希的环境下,顺序随机改变是必然结果。业务中若依赖原顺序(例如按发布时间排序的文章列表),绝对不能直接使用 list(set())。
2. 局限二:所有元素必须是可哈希对象(Hashable)
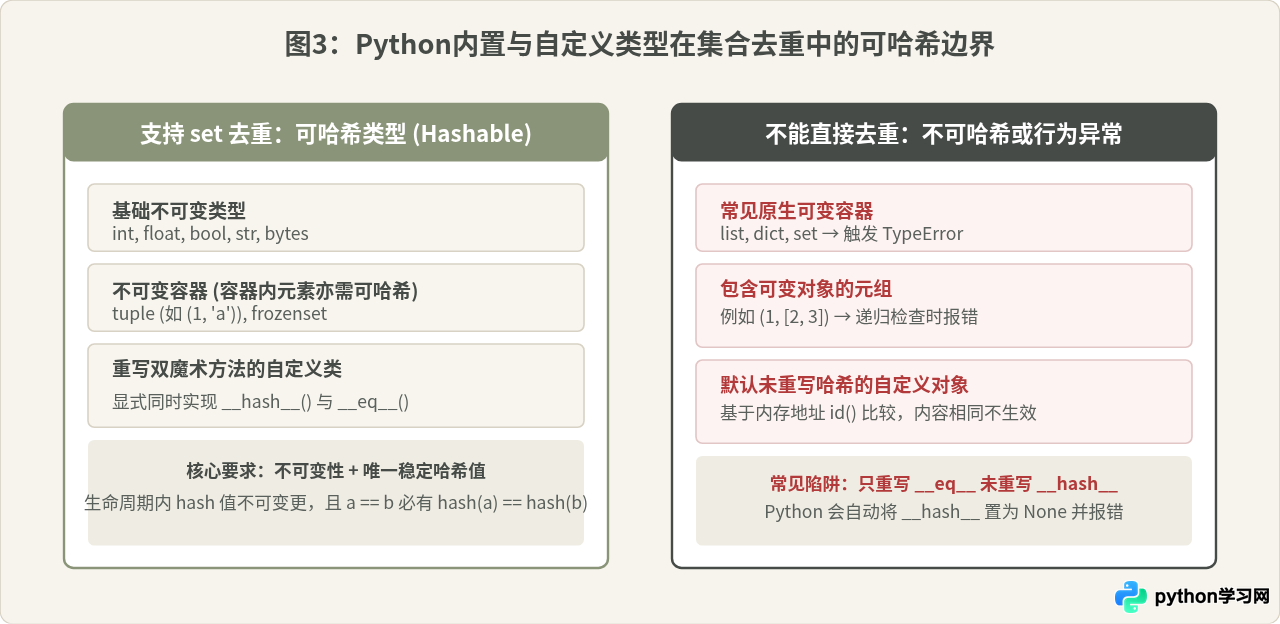
如果列表中包含可变容器(如子列表 list、字典 dict 或普通集合 set),执行 set() 会立即抛出 TypeError: unhashable type 异常。
# 包含不可哈希对象时的报错示例
nested_list = [{"id": 1}, {"id": 2}, {"id": 1}]
unique_items = list(set(nested_list))

# 运行结果:
# TypeError: unhashable type: 'dict'
可变对象由于其内部数据在生命周期内可以随时更改,无法提供一个稳定不变的哈希值,因此 Python 默认禁用了它们参与哈希计算的资格。
3. 局限三:自定义类的默认对象比较机制
对于自定义类的实例,Python 默认采用对象的内存地址(id())作为哈希基准,并以引用相同作为 __eq__ 的成立条件。这意味着:即使两个对象的各个属性完全一致,只要它们是分别实例化的,set 也会将它们视为两个截然不同的对象,从而导致去重彻底失效。
四、突破局限:保序去重与复杂数据场景的最佳实践
针对 set 的局限性,在实际工程中我们通常使用以下成熟的解决方案进行补充。
1. 保持原顺序去重:dict.fromkeys()
自 Python 3.7 起,标准字典(dict)在语言规范层面保证了插入顺序。利用字典键唯一且保序的特性,list(dict.fromkeys(seq)) 成为了当今最优雅、高效的保序去重方案。它与 set 一样基于底层的 C 实现,时间复杂度同样为 O(n)。
# 推荐:Python 3.7+ 保序去重
raw_items = ["b", "a", "c", "a", "b", "d"]
ordered_unique = list(dict.fromkeys(raw_items))

# 示例输出(严格保留各元素首次出现的顺序):
# ordered_unique: ['b', 'a', 'c', 'd']
2. 复合结构与字典列表去重:指定字段或辅助集合
当处理不可哈希的字典列表(例如从数据库或API获取的 JSON 记录)时,可以通过辅助集合 seen 记录已经出现过的唯一标识键(如主键 id),配合列表推导式实现过滤:
users = [
    {"id": 101, "name": "张三"},
    {"id": 102, "name": "李四"},
    {"id": 101, "name": "张三(重复)"},
    {"id": 103, "name": "王五"}
]

seen_ids = set()
unique_users = []
for item in users:
    if item["id"] not in seen_ids:
        seen_ids.add(item["id"])
        unique_users.append(item)

# 示例输出:
# [{'id': 101, 'name': '张三'}, {'id': 102, 'name': '李四'}, {'id': 103, 'name': '王五'}]
3. 自定义对象去重:正确重写魔术方法
如果希望业务模型对象(Model/Class)能直接支持 set() 去重,必须同时重写 __hash__ 和 __eq__,确保逻辑自洽:
class Product:
    def __init__(self, sku: str, name: str):
        self.sku = sku
        self.name = name

    def __eq__(self, other):
        if isinstance(other, Product):
            return self.sku == other.sku
        return False

    def __hash__(self):
        # 基于核心唯一标识生成哈希
        return hash(self.sku)

prods = [Product("P01", "鼠标"), Product("P01", "光电鼠标"), Product("P02", "键盘")]
unique_prods = list(set(prods))

# 示例输出:两个 P01 实例被成功识别为同一个商品,实现去重
五、去重技术选型总结
选择何种去重方式,本质上是在性能需求、顺序要求和数据结构特征三者之间做权衡。下表总结了各类常见方案的技术特性:
| 方案与写法 | 时间复杂度 | 空间复杂度 | 是否保序 | 适用数据类型 |
|---|---|---|---|---|
list(set(seq)) |
O(n) | O(n) | 否 | 基础可哈希类型(int, str等),对顺序无要求 |
list(dict.fromkeys(seq)) |
O(n) | O(n) | 是 | 基础可哈希类型,要求保留原顺序(Python 3.7+) |
seen = set() 循环/生成器 |
O(n) | O(n) | 是 | 复杂字典列表、对象序列、按特定属性过滤 |
双重循环 / item not in list |
O(n²) | O(1) 额外 | 是 | 极小规模数据(小于几十项)且不可哈希、无键可用 |
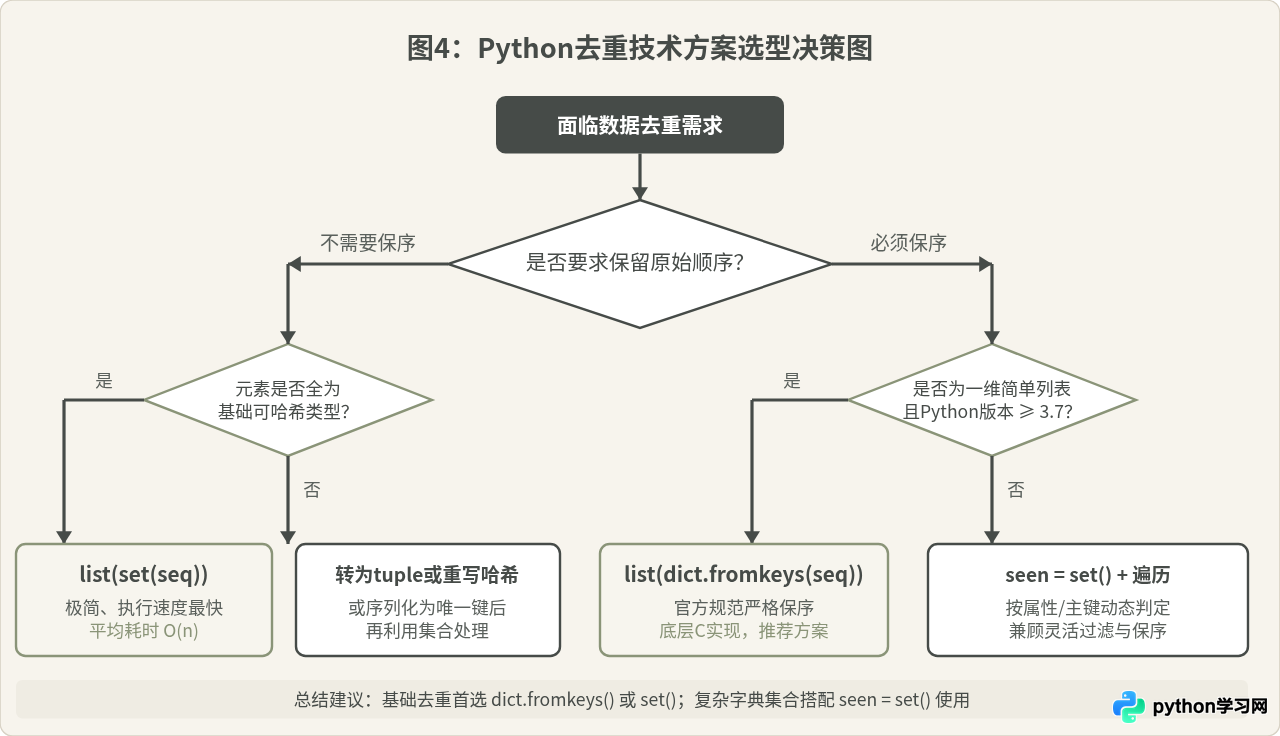
总的来说,list(set(seq)) 凭借简明的语法和卓越的哈希效率,在不关心序列顺序且元素均为不可变基础类型时是绝佳的选择。而在业务逻辑依赖元素初始相对顺序,或需要处理字典、自定义业务模型等复杂对象时,应当主动选择 list(dict.fromkeys(seq)) 或基于 seen = set() 的属性过滤模式,避免因无序性或哈希异常引发潜在的系统缺陷。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









