

Python集合实战:利用set方法进行数据清洗与去重
深入讲解如何利用Python集合(set)的高效哈希机制进行数据去重与清洗。涵盖底层原理、保序去重策略、多集合代数清洗(交集/差集/对称差集)、非哈希复杂对象处理以及生产级流式管道实战。
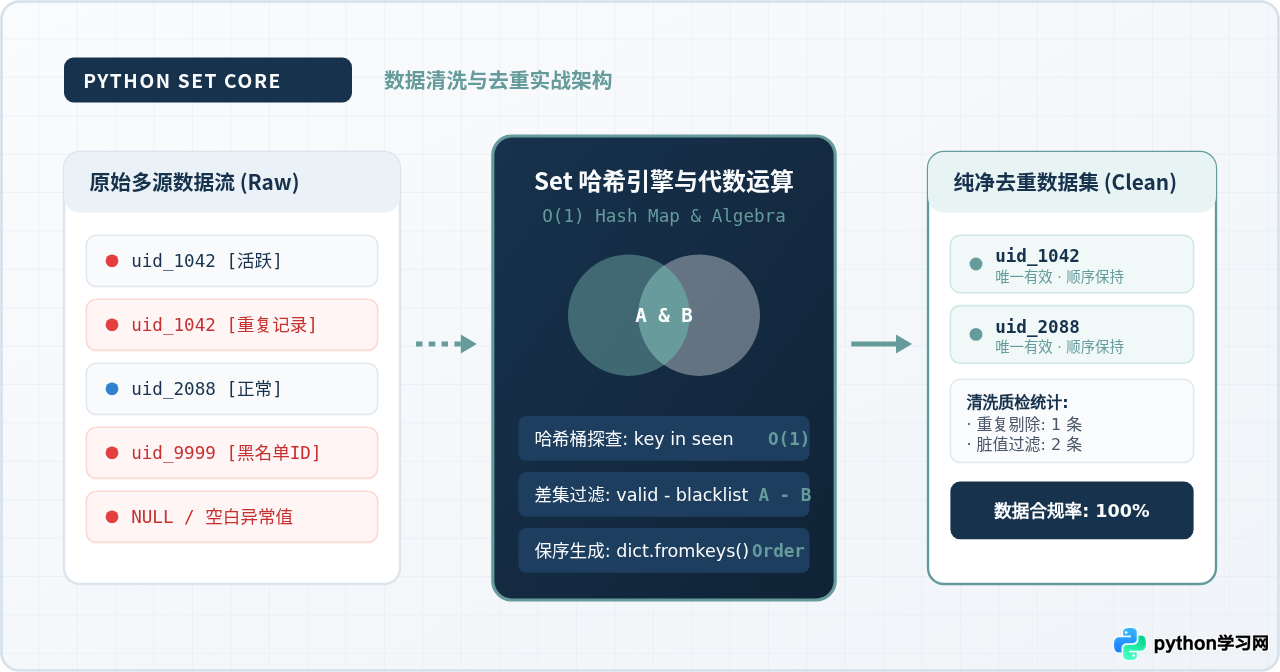
set(集合)基于哈希表(Hash Table)构建,拥有平均 O(1) 的元素查找与插入速度。直接使用集合不仅能在一行代码内剔除重复项,还能通过交集、差集、对称差集等集合运算精准实现黑名单过滤、异常漂移检测与多源融合。本文直接切入核心操作,讲解如何在不同数据结构与业务需求下,高效运用集合完成数据清洗与去重。
一、集合核心机制与基础去重
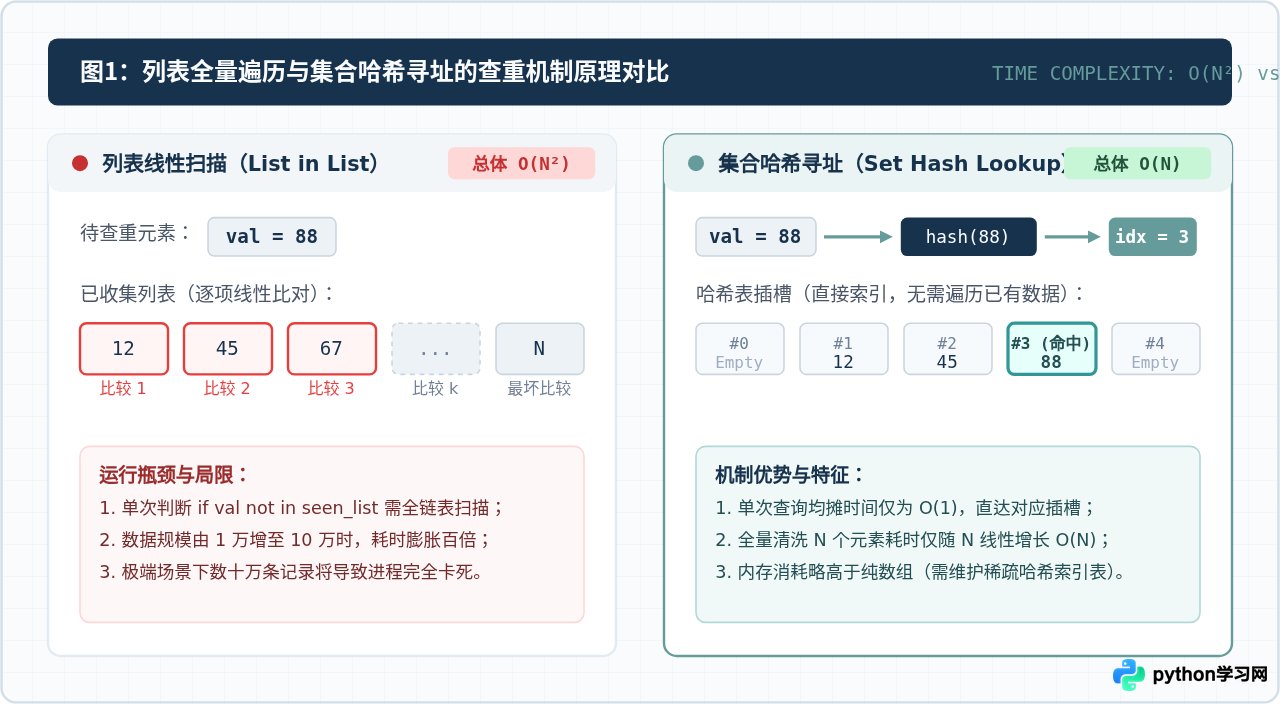
Python 的集合要求其包含的每一个元素都必须是可哈希(Hashable)的对象。当一个元素被加入集合或进行包含测试时,Python 内部会先调用该对象的 __hash__() 方法计算出哈希值,再映射到对应的存储插槽(Bucket)。若槽位发生碰撞,则进一步调用 __eq__() 核实内容是否完全相同。
这种哈希存储架构赋予了集合在查重时的天然优势:无论已有数据量是一百条还是一百万条,判断某个元素是否存在均可在常数时间 O(1) 内完成,避免了像列表(List)那样从头到尾进行 O(N) 的线性遍历。
1. 最简去重方案:list(set(data))
针对数字、字符串等不可变基本类型构成的列表,最快速的去重方式就是直接将其转换为集合再转回列表:
# 基础列表去重示例
raw_user_ids = ["usr_1002", "usr_1001", "usr_1002", "usr_1005", "usr_1001", "usr_1003"]

# 利用 set 进行无序去重
unique_user_ids = list(set(raw_user_ids))

print("去重前长度:", len(raw_user_ids))
print("去重后列表:", unique_user_ids)去重后列表: ['usr_1002', 'usr_1005', 'usr_1003', 'usr_1001']
核心局限与副作用:仔细观察上面的输出可以发现,元素的相对顺序已经被彻底打乱。由于集合在底层按照哈希散列分布,无法记录元素最初插入的先后次序。如果清洗的数据是时间序列日志、交易流水或排行榜等与时序紧密相关的内容,这种无序去重就会破坏原有业务逻辑。
二、保持原始顺序的高效去重策略
当业务场景对数据的“初次出现顺序”有严格要求时,不能简单调用 list(set(data))。此时有两种兼顾执行效率与保序要求的常用做法。
1. 使用 dict.fromkeys() 快速保序去重
自 Python 3.7 起,字典(dict)的插入顺序被正式作为语言规范提供保证。利用字典键(Key)的唯一性与有序性,可以写出兼备 C 语言底层速度与保序特性的紧凑代码:
# 保持初始顺序的极简去重
raw_event_stream = ["login", "view", "click", "view", "purchase", "login"]

ordered_unique_events = list(dict.fromkeys(raw_event_stream))

print("保序去重结果:", ordered_unique_events)2. 辅助集合 seen = set() 与生成器流式处理
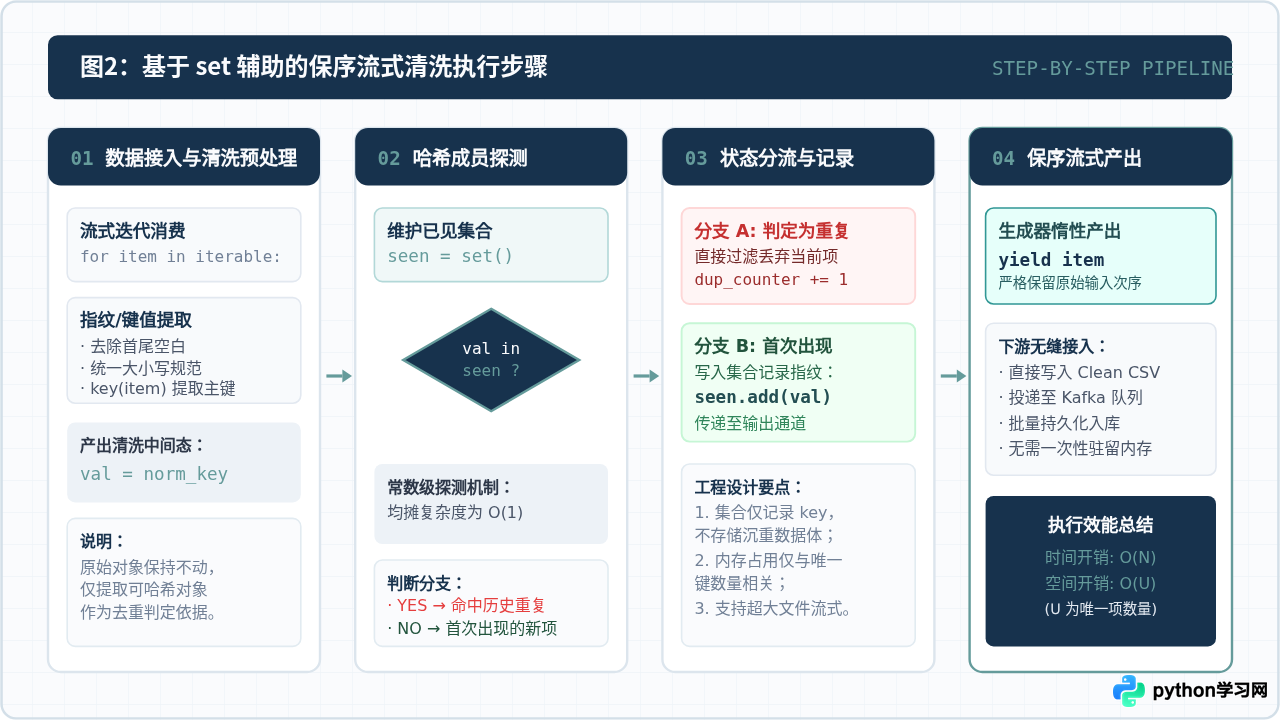
dict.fromkeys() 适用于可以直接读入内存的列表。而在处理大文件或流式数据时,更推荐编写带有辅助跟踪集合的生成器。这种做法内存占用低,且支持传入自定义的提取键(Key Function),以便对字段做格式归一化清洗后再去重:
def deduplicate_stream(iterable, key=None):
    """
    流式保序去重生成器
    :param iterable: 待处理的可迭代序列
    :param key: 用于计算唯一性指纹的函数(例如归一化大小写或取特定字段)
    """
    seen = set()
    for item in iterable:
        # 计算去重特征值;若未指定则直接比对元素本身
        val = item if key is None else key(item)
        if val not in seen:
            seen.add(val)
            yield item

# 实战:对混有空格与大小写差异的用户邮箱进行清洗和保序去重
raw_emails = [
    " Alice@Domain.com ",
    "bob@company.cn",
    "alice@domain.com",   # 格式化后与第1条重复
    "CHARLIE@TEST.ORG",
    "  bob@company.cn  "  # 格式化后与第2条重复
]

# 按统一规整后的字符串去重,同时保留原始项首现时的格式
cleaned_emails = list(deduplicate_stream(raw_emails, key=lambda x: x.strip().lower()))

print("清洗并去重后的邮箱列表:")
for email in cleaned_emails:
print(" ->", repr(email))-> ' Alice@Domain.com '
-> 'bob@company.cn'
-> 'CHARLIE@TEST.ORG'
三、集合代数运算在多源数据清洗中的场景实战
集合最强大的清洗能力体现在多数据集之间的交互操作上。Python 提供了原生的数学集合运算符:差集(-)、交集(&)、对称差集(^)与并集(|)。
1. 差集(A - B):剔除黑名单与脏标记
差集用于从集合 A 中剔除同时属于集合 B 的所有元素。在日志清洗中,常用于过滤爬虫 IP、失效账号或测试脏数据:
# 采集到的所有访问用户
all_visitors = {"user_101", "user_102", "user_103", "user_104", "user_105"}

# 风控与测试黑名单
blocked_users = {"user_102", "user_105", "user_999"}

# 通过差集获得合规有效用户
clean_visitors = all_visitors - blocked_users

print("差集过滤后有效用户:", sorted(clean_visitors))2. 交集(A & B):跨系统数据对齐与合规校验
交集提取两个集合中共有的元素。常用于核对不同业务系统是否均包含特定主键,例如验证 CRM 库与支付流水库的一致实体:
crm_active_ids = {"uid_1", "uid_2", "uid_3", "uid_4"}
payment_settled_ids = {"uid_2", "uid_4", "uid_5"}

# 提取既有激活档案又已完成结算的实体
verified_ids = crm_active_ids & payment_settled_ids

print("双系统对齐核验成功实体:", sorted(verified_ids))3. 对称差集(A ^ B):异常漂移与孤儿记录排查
对称差集返回只属于 A 或只属于 B、但不同时属于二者的元素。这在数据库同步核对、迁移对账时是定位数据漂移最直接的利器:
legacy_db_keys = {"order_A", "order_B", "order_C", "order_D"}
migrated_db_keys = {"order_A", "order_B", "order_C", "order_E"}

# 排查未对齐的单边孤立数据
unmatched_keys = legacy_db_keys ^ migrated_db_keys

print("数据库迁移异常不一致条目:", sorted(unmatched_keys))4. 并集(A | B):多通道增量合并与去重
并集将多个数据源的唯一项一次性汇聚并剔除重叠项。例如整合来自网页端、客户端及线下导入的客户线索:
web_leads = {"lead_01", "lead_02", "lead_03"}
app_leads = {"lead_02", "lead_04"}
offline_leads = {"lead_03", "lead_05"}

master_leads = web_leads | app_leads | offline_leads

print("合并去重后的客户总池:", sorted(master_leads))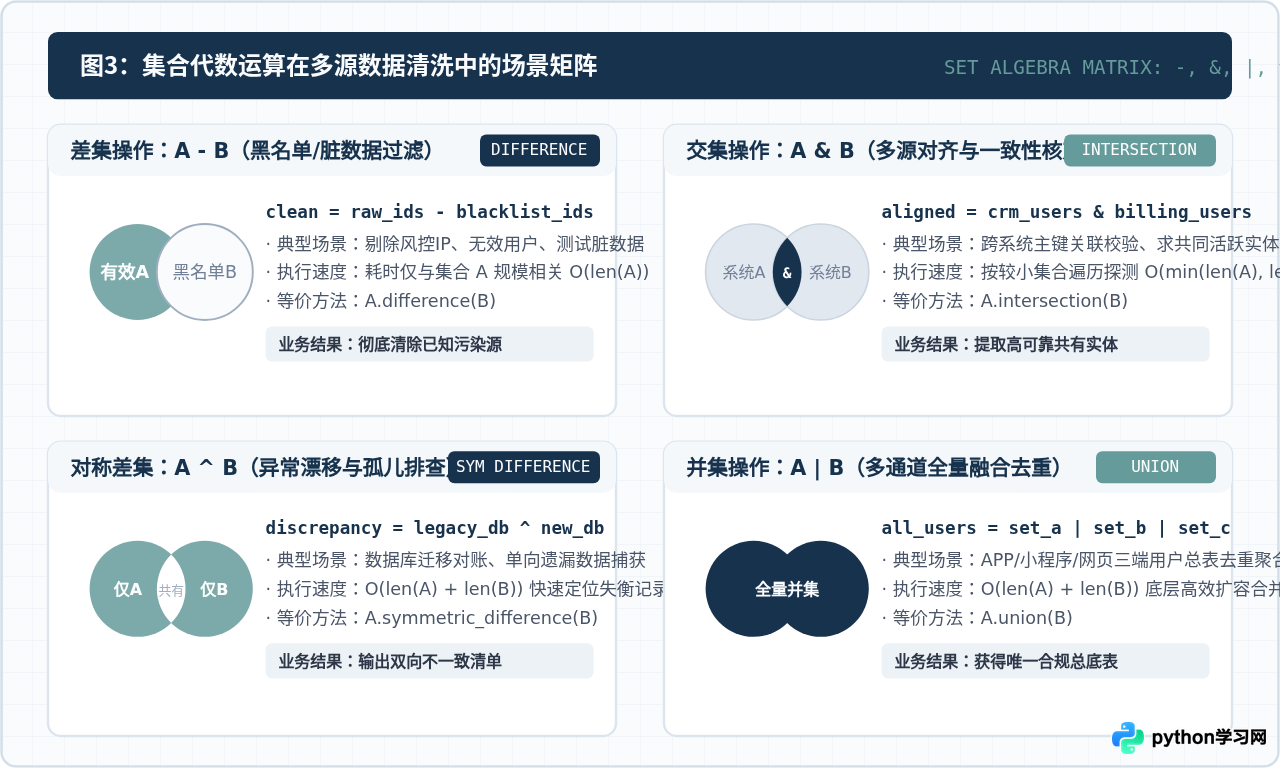
四、嵌套字典与非哈希(Unhashable)对象的去重处理
在调用 API 接口或解析 JSON 数据时,数据项通常是以字典(dict)或嵌套列表形式存储的。如果尝试直接将字典列表传入 set():
# 常见报错示例:
records = [{"id": 1, "name": "Tom"}, {"id": 1, "name": "Tom"}]
# set(records) 会抛出: TypeError: unhashable type: 'dict'
这是因为字典内部是可变的(Mutable),无法提供稳定不可变的 __hash__。清洗这类数据有以下两种可靠解法:
解法 A:将字典键值对转为可哈希的冻结元组
如果需要对字典的全量字段进行整行查重,可以把字典中的键值对按键排序后封装为不可变元组:
def freeze_dict(d):
    """递归将字典/列表转化为可哈希的元组形式"""
    if isinstance(d, dict):
        return tuple(sorted((k, freeze_dict(v)) for k, v in d.items()))
    if isinstance(d, list):
        return tuple(freeze_dict(x) for x in d)
    return d

dirty_records = [
    {"id": 101, "dept": "R&D", "tag": "dev"},
    {"id": 102, "dept": "Sales", "tag": "biz"},
    {"id": 101, "dept": "R&D", "tag": "dev"},  # 完全重复
    {"id": 103, "dept": "HR", "tag": "staff"}
]

# 去重并还原为字典列表
seen_tuples = set()
unique_records = []

for item in dirty_records:
    frozen = freeze_dict(item)
    if frozen not in seen_tuples:
        seen_tuples.add(frozen)
        unique_records.append(item)

print(f"原始记录 {len(dirty_records)} 条,去重后 {len(unique_records)} 条:")
for r in unique_records:
print(" ->", r)-> {'id': 101, 'dept': 'R&D', 'tag': 'dev'}
-> {'id': 102, 'dept': 'Sales', 'tag': 'biz'}
-> {'id': 103, 'dept': 'HR', 'tag': 'staff'}
解法 B:按业务主键或关键字段去重
更常见、开销更低的场景是:每条记录有明确的主键(如 order_id 或复合键 (user_id, event_time))。此时集合只负责记录主键指纹,无需序列化整个对象:
def deduplicate_by_key(records, key_func):
    seen_keys = set()
    for record in records:
        key = key_func(record)
        if key not in seen_keys:
            seen_keys.add(key)
            yield record

# 示例:根据 (user_id, date) 复合业务主键去重
logs = [
    {"user_id": "u1", "date": "2026-10-01", "action": "login", "duration": 12},
    {"user_id": "u2", "date": "2026-10-01", "action": "view", "duration": 45},
    {"user_id": "u1", "date": "2026-10-01", "action": "login_dup", "duration": 12}, # 复合键重复
    {"user_id": "u1", "date": "2026-10-02", "action": "login", "duration": 30}
]

clean_logs = list(deduplicate_by_key(logs, key_func=lambda x: (x["user_id"], x["date"])))
print("复合主键保序去重结果(保留首条):")
for l in clean_logs:
print(" ->", l)-> {'user_id': 'u1', 'date': '2026-10-01', 'action': 'login', 'duration': 12}
-> {'user_id': 'u2', 'date': '2026-10-01', 'action': 'view', 'duration': 45}
-> {'user_id': 'u1', 'date': '2026-10-02', 'action': 'login', 'duration': 30}
五、生产环境实操:构建端到端数据清洗管道
在实际生产中,去重往往与类型转换、空值规整、黑名单排查等任务紧密结合。下面通过一个完整的面向业务日志的管道类,串联上述所有技巧:
class AccessLogCleaner:
    def __init__(self, ip_blacklist=None, valid_status_codes=None):
        # 预加载黑名单与合规集合(哈希表支持高速判断)
        self.ip_blacklist = set(ip_blacklist or [])
        self.valid_status_codes = set(valid_status_codes or {200, 201, 204})
        self.stats = {"total": 0, "blacklisted": 0, "invalid_status": 0, "duplicated": 0, "clean": 0}

    def process(self, raw_logs):
        seen_requests = set()

        for log in raw_logs:
            self.stats["total"] += 1
            ip = log.get("ip", "").strip()
            status = log.get("status")
            request_id = log.get("req_id")

            # 1. 差集思想:快速过滤黑名单 IP
            if ip in self.ip_blacklist:
                self.stats["blacklisted"] += 1
                continue

            # 2. 集合成员检测:合规状态码校验
            if status not in self.valid_status_codes:
                self.stats["invalid_status"] += 1
                continue

            # 3. 跟踪集合去重:幂等性去重(依据请求 ID)
            if request_id in seen_requests:
                self.stats["duplicated"] += 1
                continue

            seen_requests.add(request_id)
            self.stats["clean"] += 1
            yield log

# 模拟原始脏数据流
raw_stream = [
    {"req_id": "req_001", "ip": "192.168.1.1", "status": 200, "url": "/index"},
    {"req_id": "req_002", "ip": "10.0.0.99", "status": 200, "url": "/login"},    # 黑名单IP
    {"req_id": "req_001", "ip": "192.168.1.1", "status": 200, "url": "/index"},    # 重复提交
    {"req_id": "req_003", "ip": "192.168.1.20", "status": 500, "url": "/pay"},    # 异常状态码
    {"req_id": "req_004", "ip": "192.168.1.35", "status": 200, "url": "/detail"}
]

cleaner = AccessLogCleaner(
    ip_blacklist=["10.0.0.99", "127.0.0.1"],
    valid_status_codes=[200, 201]
)

cleaned_stream = list(cleaner.process(raw_stream))

print("清洗质检报告:", cleaner.stats)
print(f"清洗后合规记录 (共 {len(cleaned_stream)} 条):")
for r in cleaned_stream:
print(" ->", r)清洗后合规记录 (共 2 条):
-> {'req_id': 'req_001', 'ip': '192.168.1.1', 'status': 200, 'url': '/index'}
-> {'req_id': 'req_004', 'ip': '192.168.1.35', 'status': 200, 'url': '/detail'}
六、常见陷阱与避坑指南
set 进行清洗时,有几个非常隐蔽但高发的陷阱需要特别留意:
-
浮点数 NaN 的比对特性:在 Python 中,
float('nan') != float('nan')。如果原始数据中包含通过不同途径产生的NaN,set([float('nan'), float('nan')])的长度可能会是 2。在清洗数值型数据前,应先通过math.isnan()或将缺失值替换为统一占位符(如None)再进行集合去重。 -
隐式字符串污染:
"admin"与"admin "(带空格)、"Admin"(大小写差异)的哈希值截然不同,集合会判定为互不相同的元素。因此在将字符串送入集合前,务必先统一执行strip()和lower()等归一化清洗。 -
遍历集合时修改元素:在迭代
for item in my_set:过程中直接执行my_set.remove(item)会抛出RuntimeError: Set changed size during iteration。如需在原集合上批量剔除,请先通过推导式收集待删除项,或直接使用差集原位操作my_set.difference_update(items_to_remove)。 - 内存开销预估:CPython 的集合为了保证常数级寻址速度,维持了较低的负载因子(通常在 2/3 以下),哈希表插槽会有较大的稀疏冗余。存储数千万个大型字符串指纹可能耗费数 GB 内存。若遇到超过单机可用内存的超大规模数据,应选用磁盘外部排序、布隆过滤器(Bloom Filter)或 DuckDB 等专为外存计算设计的工具。
七、总结
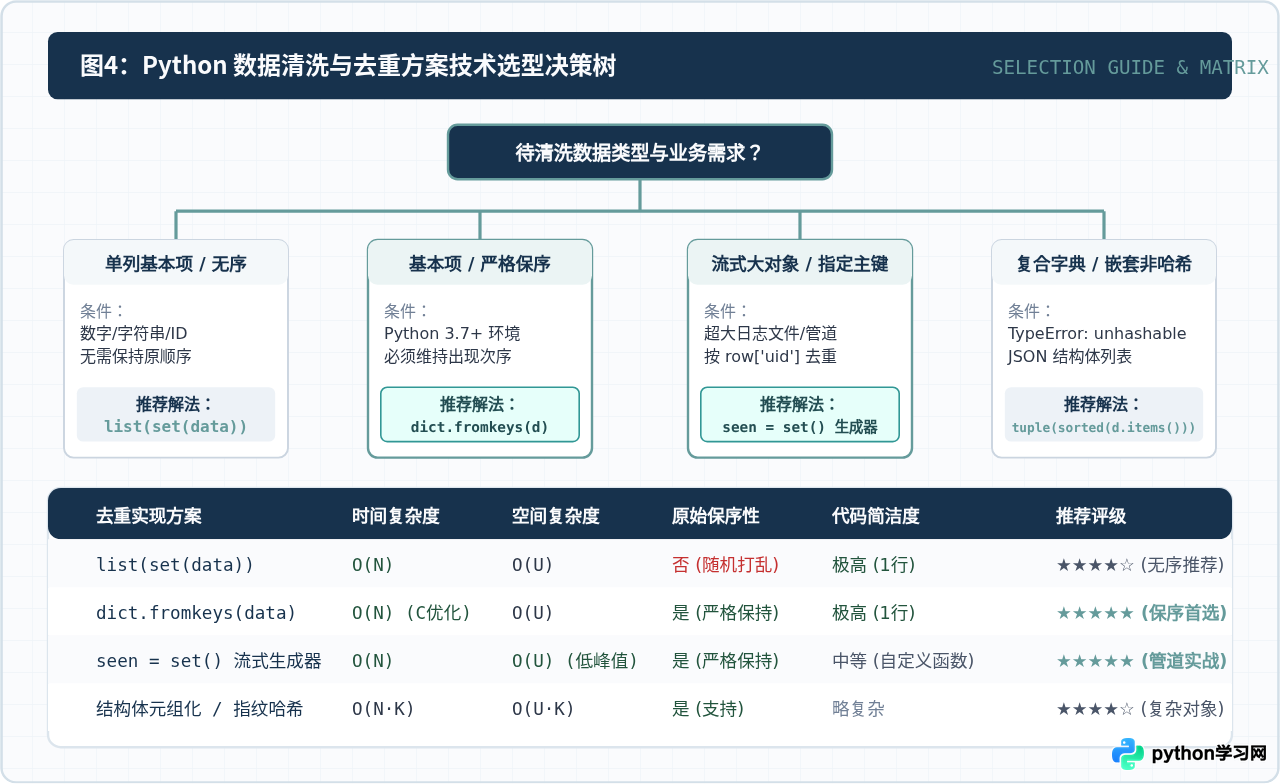
Python 的 set 是轻量级数据清洗利器。其核心逻辑可以归纳为三个选用原则:
- 只求去重且无序:直接采用
list(set(data)),代码极简,速度最快; - 严格保持出现次序:首选
dict.fromkeys(data);处理大文件或需字段过滤时,采用seen = set()生成器函数; - 复杂多源关系运算:善用
-过滤黑名单,用&对齐多源数据,用^发现同步差异,用|增量合并主数据。
掌握哈希查找原理并结合数据结构的不可变性转换,能够在绝大多数中小型数据清洗任务中写出运行高效、逻辑严密的工业级代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









