

Python字符串中字符去重并保留顺序的方法
详细讲解在Python中对字符串进行字符去重并完整保留原有相对顺序的高效方法,深入对比set与dict底层机制,分析常见性能误区及自定义扩展场景。
在 Python 中对字符串进行字符去重时,如果需要完整保留字符在原字符串中第一次出现的相对次序,最简洁高效的官方推荐写法是使用 "".join(dict.fromkeys(s))。本文将具体阐述这一常用解法的执行逻辑、为什么常规集合 set() 无法胜任、如何实现更复杂的自定义过滤去重,以及常见性能陷阱的规避方法。
一、核心解法:使用 dict.fromkeys() 一行搞定
处理字符串字符去重且要求不改变字符初次出现的排列顺序时,我们可以直接利用 Python 字典键的唯一定义与保序特性:
raw_text = "abracadabra"
# 使用 dict.fromkeys 构建键序列,再通过 join 重新拼接
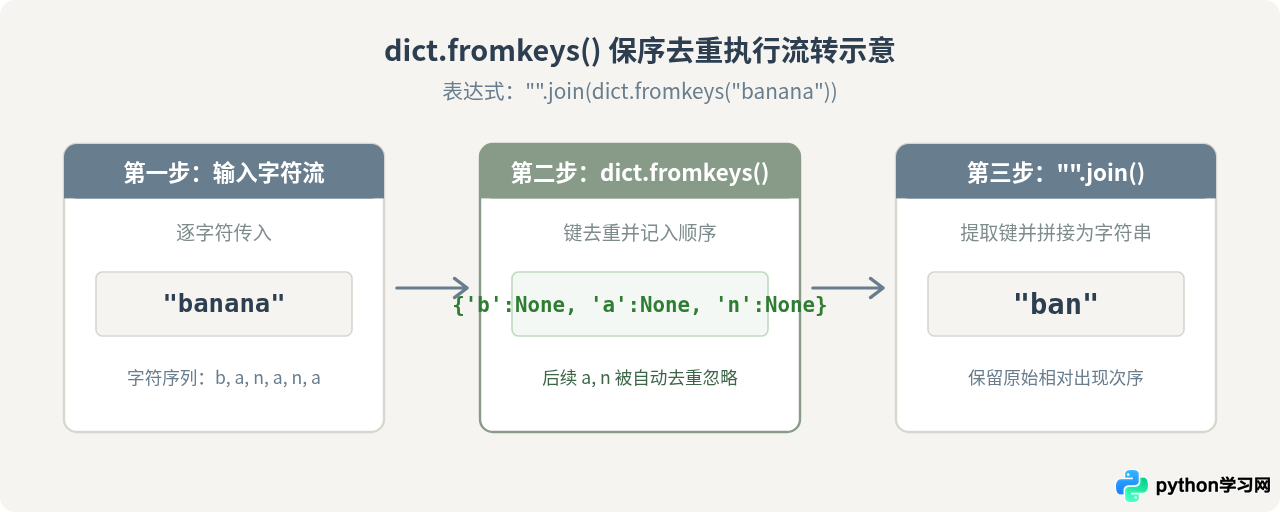
unique_text = "".join(dict.fromkeys(raw_text))

print("原始字符串:", raw_text)
print("去重结果:", unique_text)原始字符串: abracadabra去重结果: abrcd
该方法的核心原理十分清晰:
dict.fromkeys(raw_text):将字符串按字符迭代,依次作为字典的键(Key)插入。因为字典的键必须唯一,当遇到重复出现的字符时,字典会自动忽略后续重复项;- 保序依据:从 Python 3.7 开始(官方规范层面保证),Python 标准字典的内部实现严格按照元素插入的时间先后顺序来存储和遍历;
"".join(...):迭代字典的所有键并重新合并为一个新的去重字符串。
二、机制差异:为什么不能直接使用 set()?
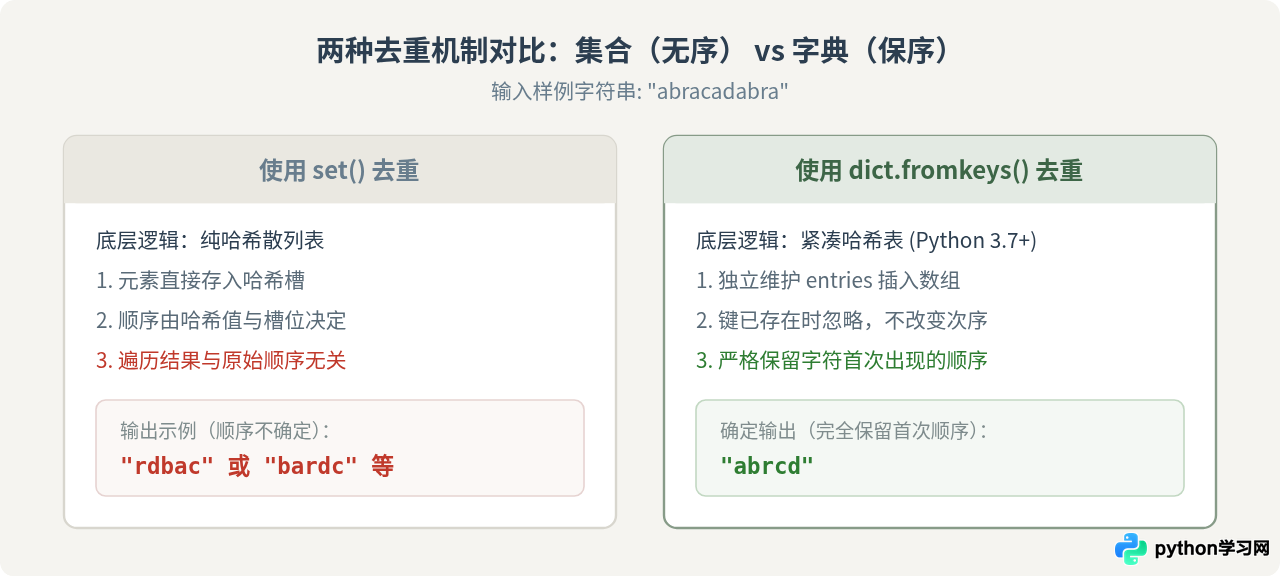
初学者常常会首先想到集合 set(),写出类似 "".join(set("abracadabra")) 的代码。虽然 set() 确实能完成去重,但它完全无法保证字符顺序。
这种差异源于两者在底层哈希数据结构上的不同设计:
- 集合(set):底层是离散哈希桶数组。字符被添加到集合时,根据字符的哈希码计算并落入对应槽位。遍历集合时,是按桶的物理索引依次读出,导致输出次序与原字符串中的排列完全无关,甚至在不同 Python 版本或不同进程中每次输出都可能改变。
- 现代字典(dict):底层采用了紧凑数组设计。它分别维护了“稀疏哈希索引表”与“致密元素列表(entries array)”。新键插入时严格按顺序追加到致密数组末尾,因此天然记住了插入的历史时间线。
三、扩展场景:结合 seen 集合的灵活去重
虽然 dict.fromkeys() 应对简单字符去重表现优异,但在实际业务中,我们常常需要加入额外的过滤逻辑。例如:忽略大小写去重(即字符大写或小写视为同一字符,保留最先出现的那个字面量)或者排除特定标点符号。
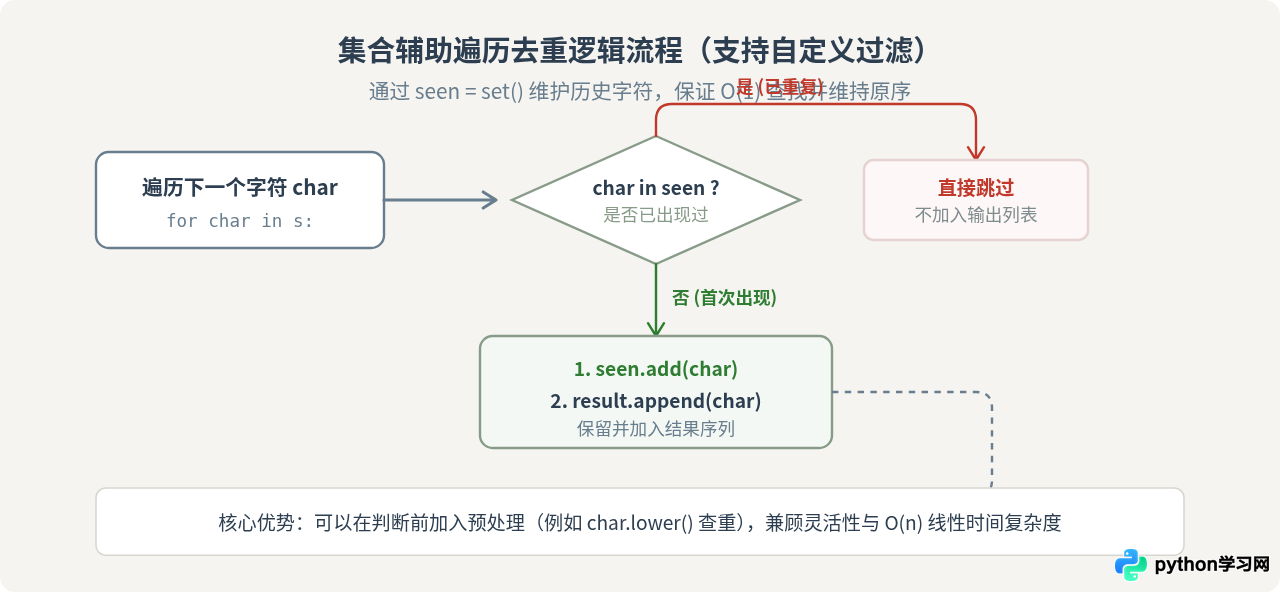
此时,可以通过一个辅助的 seen = set() 集合结合列表推导式来完成,这样既保留了遍历的顺序,又利用集合实现了 O(1) 的超快查重:
def deduplicate_ignore_case(text):
    seen = set()
    result = []
    for char in text:
        key = char.lower()  # 转换后用于查重判定
        if key not in seen:
            seen.add(key)
            result.append(char)  # 保留原始字符形式
    return "".join(result)

sample = "PyThOn python"
print("忽略大小写保序去重:", deduplicate_ignore_case(sample))忽略大小写保序去重: PyThOn
在该模式下,列表 result 负责按顺序收集元素,而辅助集合 seen 负责在均摊 O(1) 的时间内判断元素是否已存在。整体算法复杂度仍保持为 O(n) 的线性复杂度,效率极高且具备高度可定制性。
四、注意事项与避坑指南
1. 警惕使用列表成员检查导致 O(n²) 性能恶化
很多开发者初学时会写出如下代码:
# 不推荐的低效写法
res = []
for c in s:
    if c not in res:  # 注意:在 list 中使用 not in 是 O(k) 的线性扫描
res.append(c)在上述代码中,c not in res 会对已收集的列表进行线性逐个比对。如果输入字符串长度达到数万甚至更高,整体时间复杂度将飙升至 O(n²),引起严重的性能卡顿。使用 dict.fromkeys() 或 seen = set() 才能保持 O(1) 单步查找、O(n) 整体耗时的最优表现。
2. 历史版本兼容性(Python 3.6 之前)
如果维护的代码需要运行在 Python 3.6 之前的极旧版本中,原生的普通 dict 并不保证遍历次序。此时需要借助于标准库中的 collections.OrderedDict:
from collections import OrderedDict

# 适用于 Python 2.7 / 3.5 等旧版兼容场景
s = "abracadabra"
unique_s = "".join(OrderedDict.fromkeys(s))
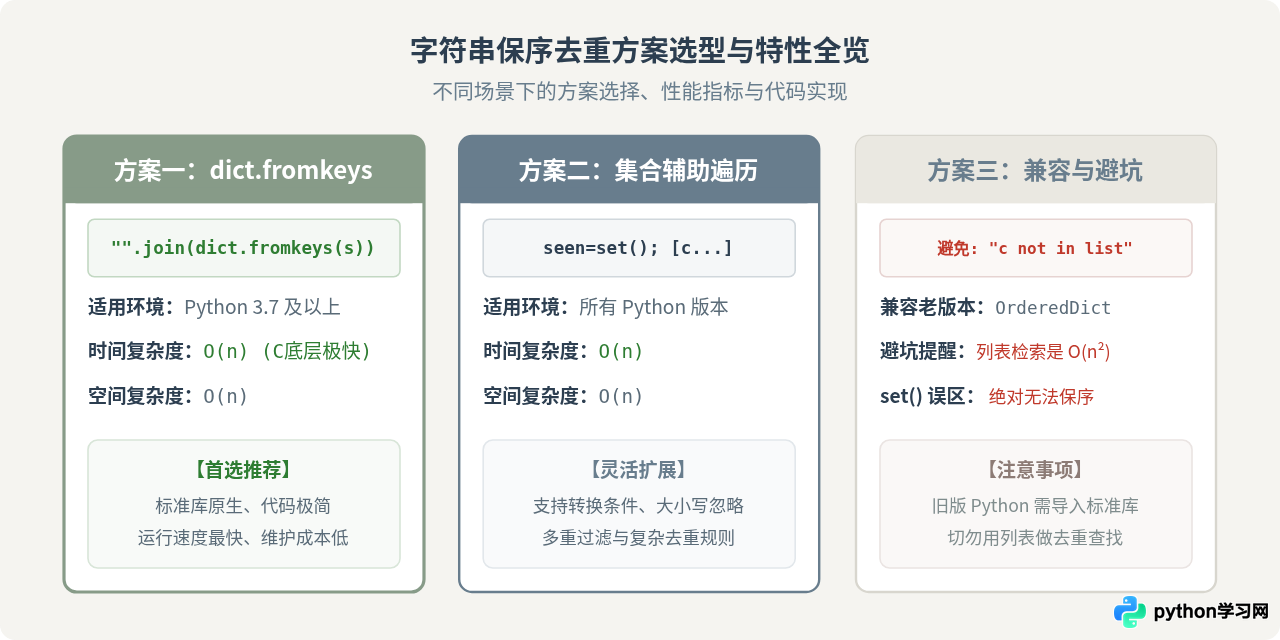
五、综合选型总结
根据具体的工程诉求,我们可以快速选定最合适的处理手段:
- 标准快速去重(首选):使用
"".join(dict.fromkeys(s)),代码简练、执行速度最快,充分利用 CPython 底层优化; - 自定义规则去重:使用
seen = set()配合循环,便于加入大小写忽略、非法字符过滤等中间转换; - 旧环境兼容:导入
collections.OrderedDict。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









