

怎么利用Python set对列表进行快速去重

在 Python 开发中,若需要对一个包含重复元素的列表进行快速去重,最精炼且执行效率最高的核心操作是将列表转换为集合后再转换回列表,即调用 list(set(raw_list))。该方法依托 Python 集合底层哈希表(Hash Table)键唯一的特性,能够在平均 O(n) 的线性时间复杂度内瞬间剔除全部重复元素。不过,这种快捷操作存在两个必须注意的边界特征:其一,列表中的所有元素必须是可哈希(Hashable)对象;其二,集合本身是无序结构,去重后原有元素的先后次序会被打乱。本文将详细拆解该操作的具体步骤、底层加速机制、常见问题排查以及需要保序时的替代实现方案。
一、利用 set 对列表去重的操作步骤与代码实现
利用集合去重的核心思路非常直接:Python 列表支持存储任意重复项,而集合(Set)在数学与语言规范中均严格要求元素的互异性。当将一个列表传入 set() 构造器时,解释器会自动遍历列表中的每一个元素,将其作为键存入底层哈希表,遇到已存在的相同键则直接忽略,最终只保留互不相同的元素副本。
具体操作包含三个关键阶段:
- 输入数据准备:明确待处理的原始列表,确保列表内各元素为整数、浮点数、字符串或元组等不可变标量;
- 构建集合对象:通过
set(raw_list)生成临时集合,由解释器完成 O(n) 均摊哈希散列与重复项过滤; - 封装回列表结构:使用
list(...)将去重后的集合重新包装回列表类型,以便继续使用索引访问或切片操作。
以下是标准的 Python 代码示例与控制台输出呈现:
# 1. 定义包含重复项的原始列表
raw_list = [10, 20, 10, 30, 20, 40, 50, 40]

# 2. 核心操作:转换集合去重并转回列表
deduped_list = list(set(raw_list))

# 3. 打印对比去重前后的结果
print("原始列表:", raw_list)
print("去重结果:", deduped_list)
执行上述代码后的标准输出如下所示:
原始列表: [10, 20, 10, 30, 20, 40, 50, 40]
去重结果: [40, 10, 50, 20, 30]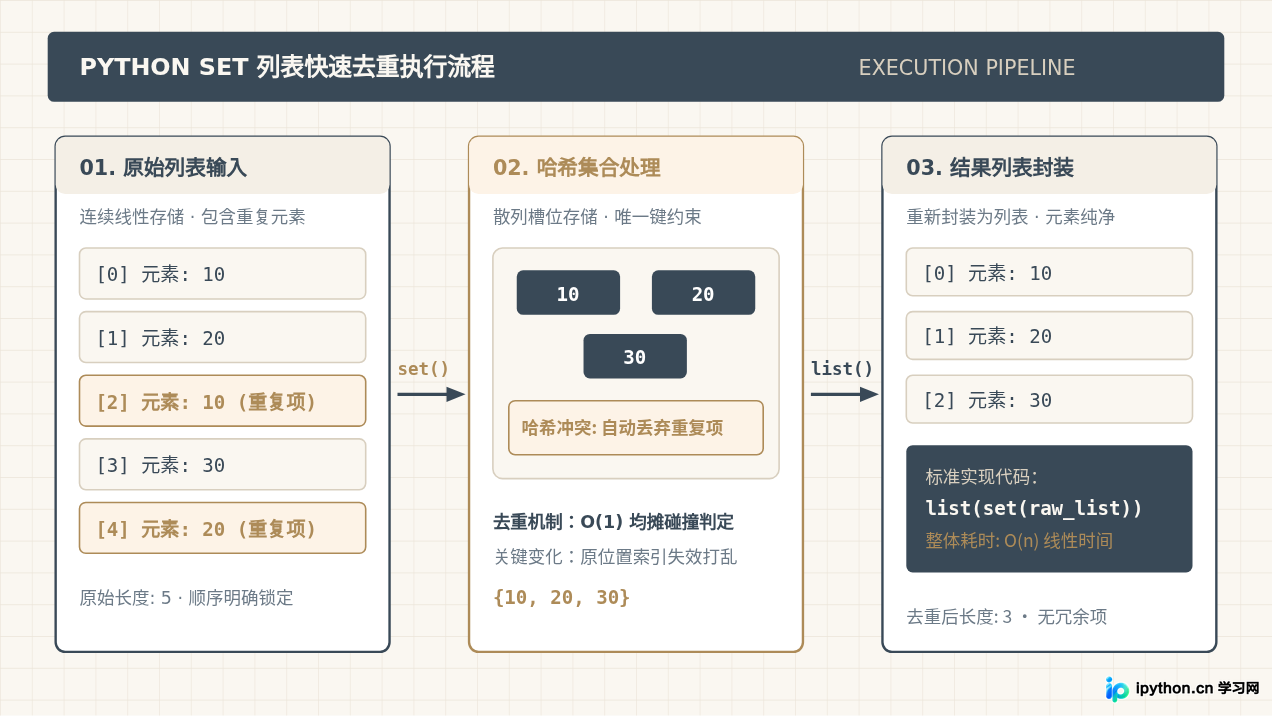
二、底层原理解析:为什么 set 去重如此极速?
在理解 list(set(raw_list)) 的优势时,有必要将其与传统的循环去重进行性能对比。如果初学者使用普通的 for 循环配合新列表判断:
# 朴素去重方案(耗时严重)
unique_items = []
for item in raw_list:
    if item not in unique_items:  # 此处每次都需要线性扫描 unique_items
unique_items.append(item)在上述朴素代码中,item not in unique_items 是对普通列表进行顺序查找,其单次查找时间复杂度为 O(k)(k 为当前已存元素个数)。当原始列表长度为 n 时,总计算量达到 O(n²)。若列表有一万条数据,最坏情况下需要进行数千万次比对,程序会出现严重的卡顿。
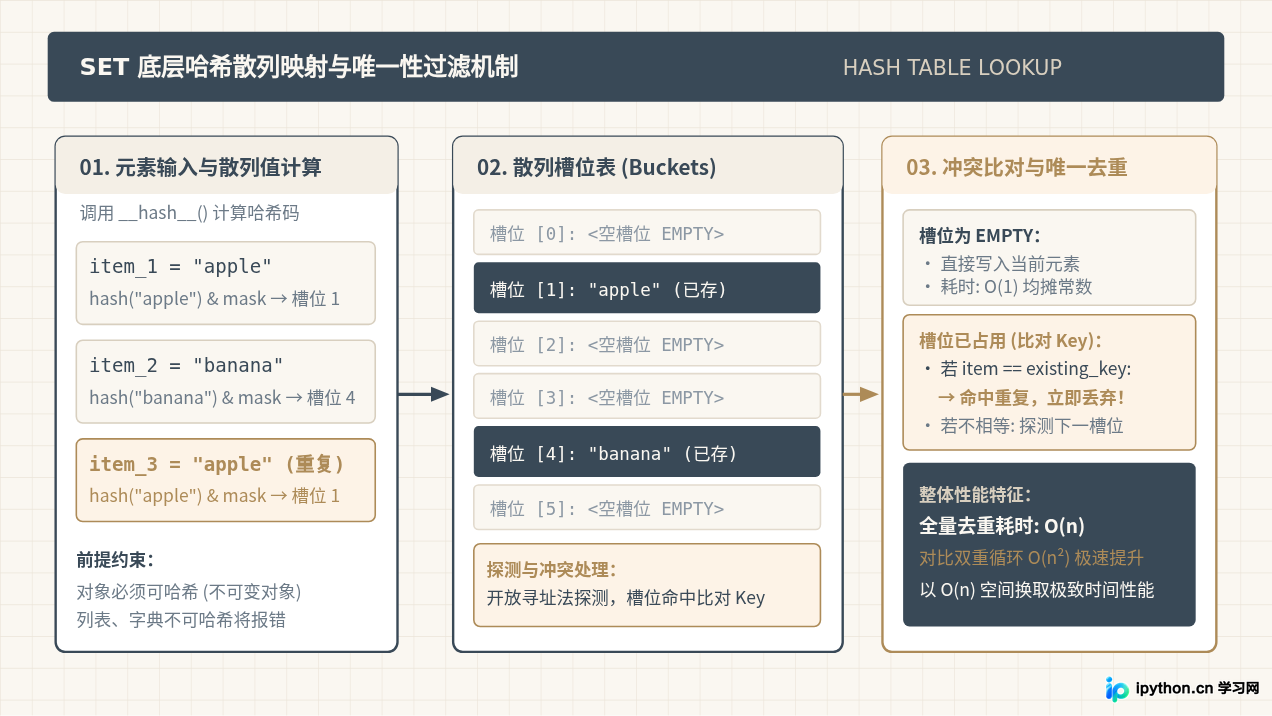
相比之下,Python 集合内部采用基于哈希表的散列数组。在集合中插入一个元素时,具体经历以下底层步骤:
- 哈希码计算:调用内置函数
hash(item)获取对应整数哈希值; - 掩码定位槽位:将哈希值与当前哈希表掩码进行位运算,计算出该元素对应的散列槽位(Bucket)索引;
- 常数级碰撞比对:如果目标槽位为空,直接存入;如果目标槽位已被占用,先比对内存地址或调用
__eq__()判定是否为同一对象。若判定相同,说明当前元素属于重复项,解释器直接略过写入,完成去重;若不相同则通过开放寻址法探测下一个空闲槽位。
由于哈希表的单次查找与插入平均时间复杂度仅为 O(1),因此遍历处理整张长度为 n 的列表只需要 O(n) 的均摊时间。即使面对数十万甚至百万级别的标量数据,去重操作也能在毫秒级内瞬间完成。
三、关键特性与限制:元素无序性及保序解决方案
观察前文示例的输出结果可以发现,原始列表中元素的先后顺序是 10, 20, 10, 30, ...,但去重后的列表可能变成了 [40, 10, 50, 20, 30]。这是因为集合内部的存储槽位完全由元素的哈希散列值决定,并不记录任何与“插入先后”相关的次序信息。当重新执行 list() 时,输出顺序仅仅是哈希表中现有槽位的物理扫描次序。
在统计独立词频、计算无序标签交并集等场景下,乱序完全不会带来负面影响。但在商品流水记录、按优先级排序的 ID 队列、前端展示列表等业务中,打乱顺序会导致严重的数据逻辑错误。
1. 方案一(推荐):利用 dict.fromkeys() 实现现代保序去重
在 Python 3.7 及更高版本中,Python 官方正式将“字典保持插入顺序”纳为语言规范。字典与集合一样基于哈希表实现,键同样具有互异性,但字典内部维护了键的插入次序。因此,通过 dict.fromkeys() 可以极为优雅地实现保序快速去重:
raw_seq = ['B', 'A', 'B', 'C', 'A', 'D']

# 利用 dict.fromkeys 保留首次出现次序
ordered_deduped = list(dict.fromkeys(raw_seq))

print("保序去重结果:", ordered_deduped)
# 输出: ['B', 'A', 'C', 'D']
该语法不仅语法极简,而且在底层使用 C 语言原生实现,其时间复杂度依然严格保持在 O(n),内存开销略微多于集合,但完美化解了乱序问题。
2. 方案二:利用辅助集合的列表推导式
如果需要在去重过程中同时加入特定业务筛选逻辑(例如只去重特定前缀或满足条件的元素),可以借助外部辅助集合:
raw_seq = ['apple', 'banana', 'apple', 'orange']
seen = set()

# 在推导式中利用集合的高速 in 判定,同时保持原列表遍历次序
ordered_list = [x for x in raw_seq if not (x in seen or seen.add(x))]

print("推导式去重:", ordered_list)
# 输出: ['apple', 'banana', 'orange']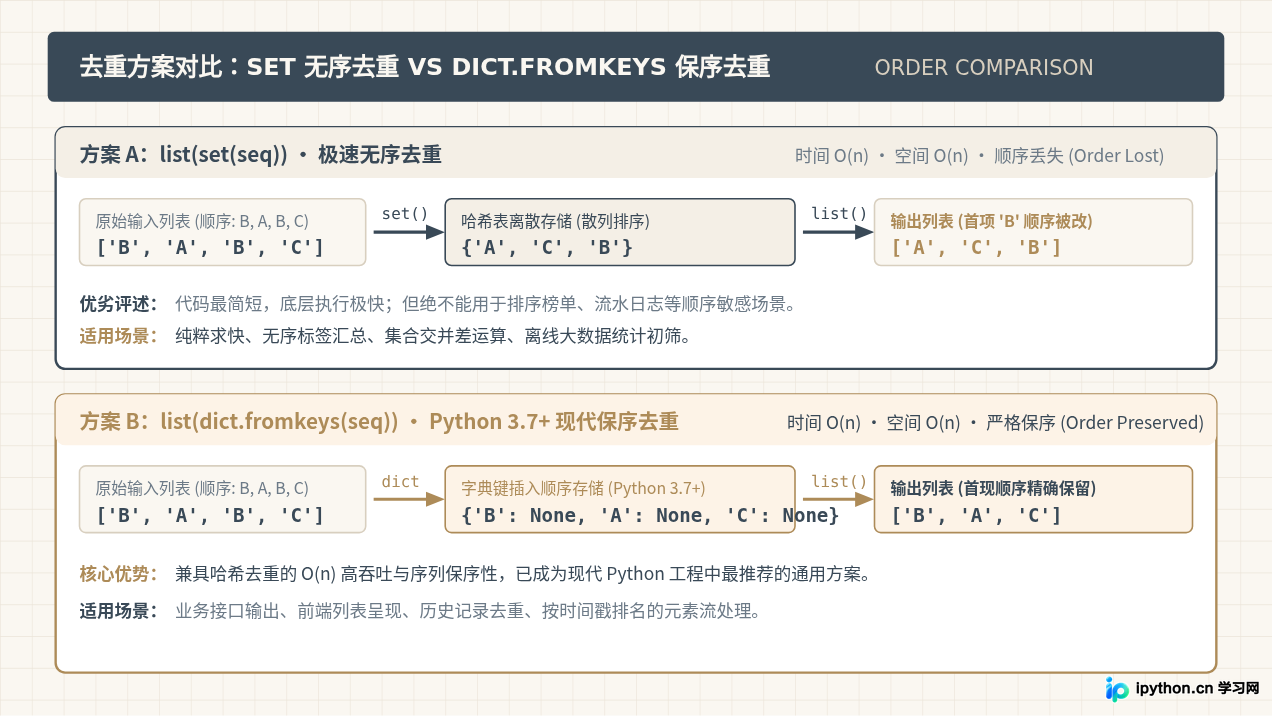
四、关键限制二:不可哈希(Unhashable)对象的报错排查
利用 set() 进行去重的另一个先决条件是:列表中的所有元素必须是可哈希对象(Hashable)。若列表中包含可变数据类型(如嵌套列表、普通字典、集合等),程序将直接抛出异常。
TypeError: unhashable type: 'list' 或 TypeError: unhashable type: 'dict'
产生该报错的原因在于:哈希表要求键的哈希码在其整个生命周期中保持恒定不变。列表和字典是可变容器,其内容随时可能被增删改动,哈希值一旦随内容变动就会导致哈希表索引永久失效。因此,Python 默认没有为可变类型实现 __hash__() 方法。
面对包含复杂对象的列表,需要采用以下两类处理方式:
- 嵌套列表去重:在进入集合前将内部子列表临时转为不可变元组
tuple,去重后再按需恢复:nested_data = [[1, 2], [3, 4], [1, 2]] # 转换为元组去重后还原为列表 deduped_nested = [list(item) for item in set(tuple(x) for x in nested_data)] print("子列表去重结果:", deduped_nested) - 字典列表按特定字段去重:业务中常见“按对象 ID 去重字典列表”。此时不能直接把字典放入 set,而应将字典的关键属性提取出来放入辅助集合进行过滤:
users = [
    {"id": 101, "name": "张三"},
    {"id": 102, "name": "李四"},
    {"id": 101, "name": "张三(重复)"}
]

seen_ids = set()
unique_users = []
for u in users:
    if u["id"] not in seen_ids:
        seen_ids.add(u["id"])
        unique_users.append(u)

print("用户去重结果:", unique_users)
五、方案选型矩阵与工程实践建议
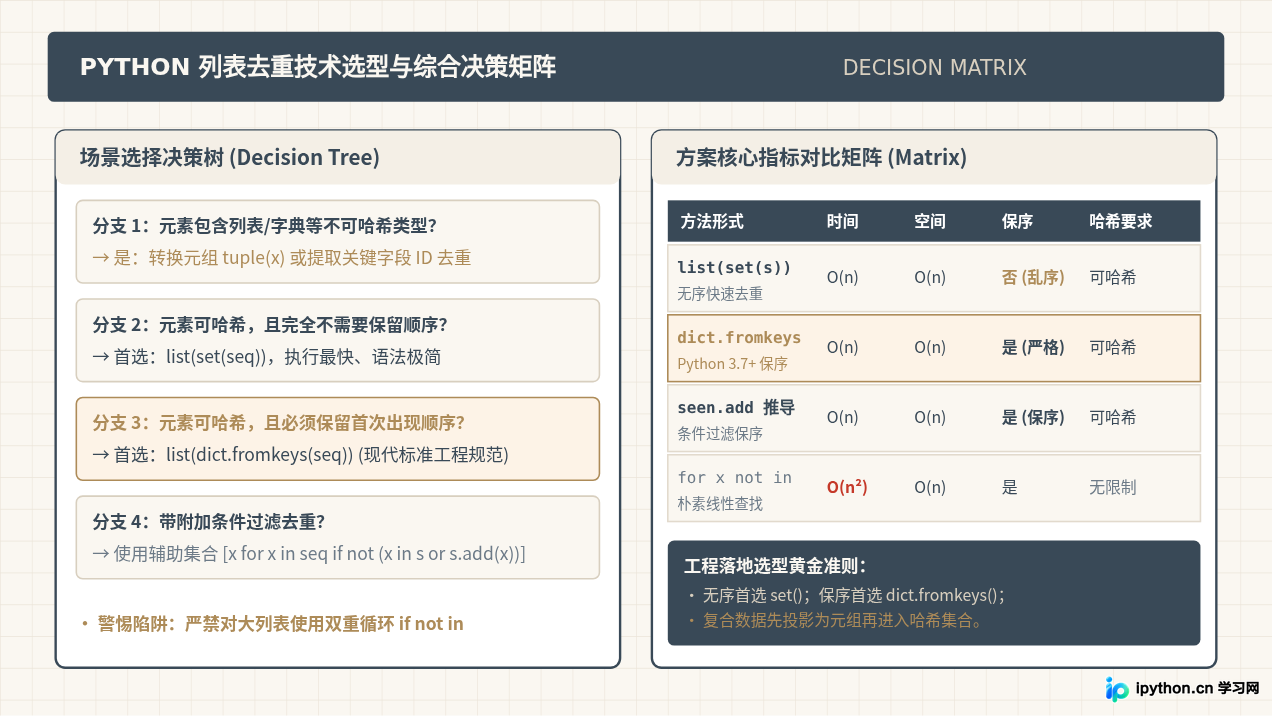
综合以上分析,在 Python 工程实践中对列表进行去重时,应根据数据特性与业务约束建立清晰的决策路径:
- 无序性能优先:当数据量较大(如十万级以上)、元素全为基础数据类型且业务完全不关心排列顺序时,
list(set(data))凭借最少代码量和极高执行效率是首选方案; - 保序业务标准:在日常绝大部分 Web 接口、数据报表与用户端交互中,推荐统一采用
list(dict.fromkeys(data)),既享受 O(n) 的高效处理,又规避了无序带来的隐蔽缺陷; - 复合结构处理:对嵌套结构和字典实体,务必先通过元组投影或字段提取转换为可哈希键,再利用集合的高速查找完成判定。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









