

Python读取Excel大文件时怎么只加载指定行列范围
详细讲解在Python中读取百兆级Excel大文件时如何仅加载指定行列范围。通过openpyxl只读流式迭代与pandas切片参数配置,避免内存溢出,提供完整代码示例、坐标对齐对照与选型指南。
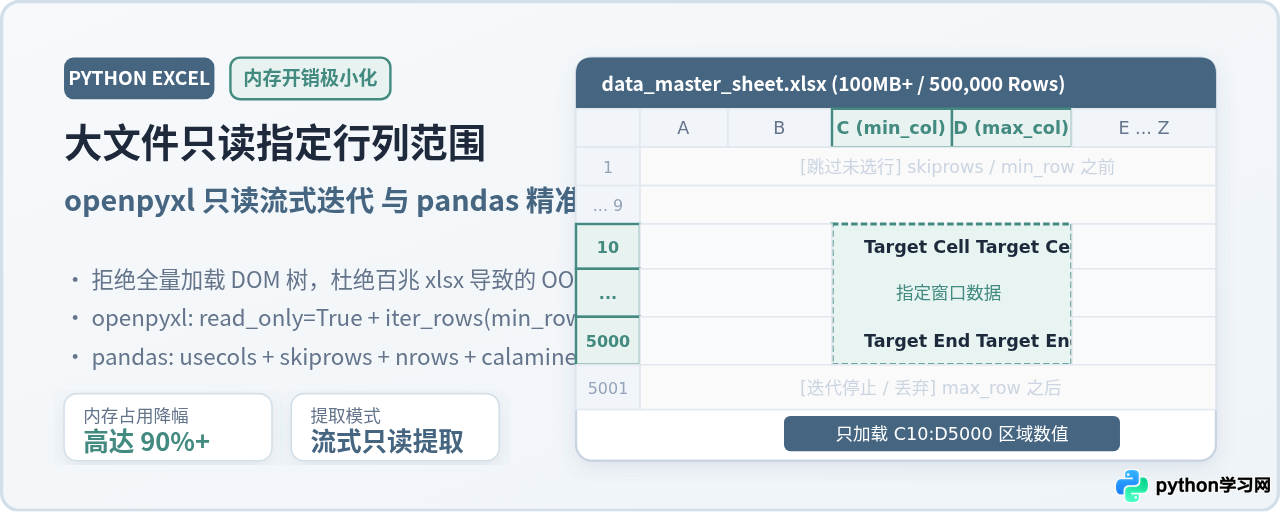
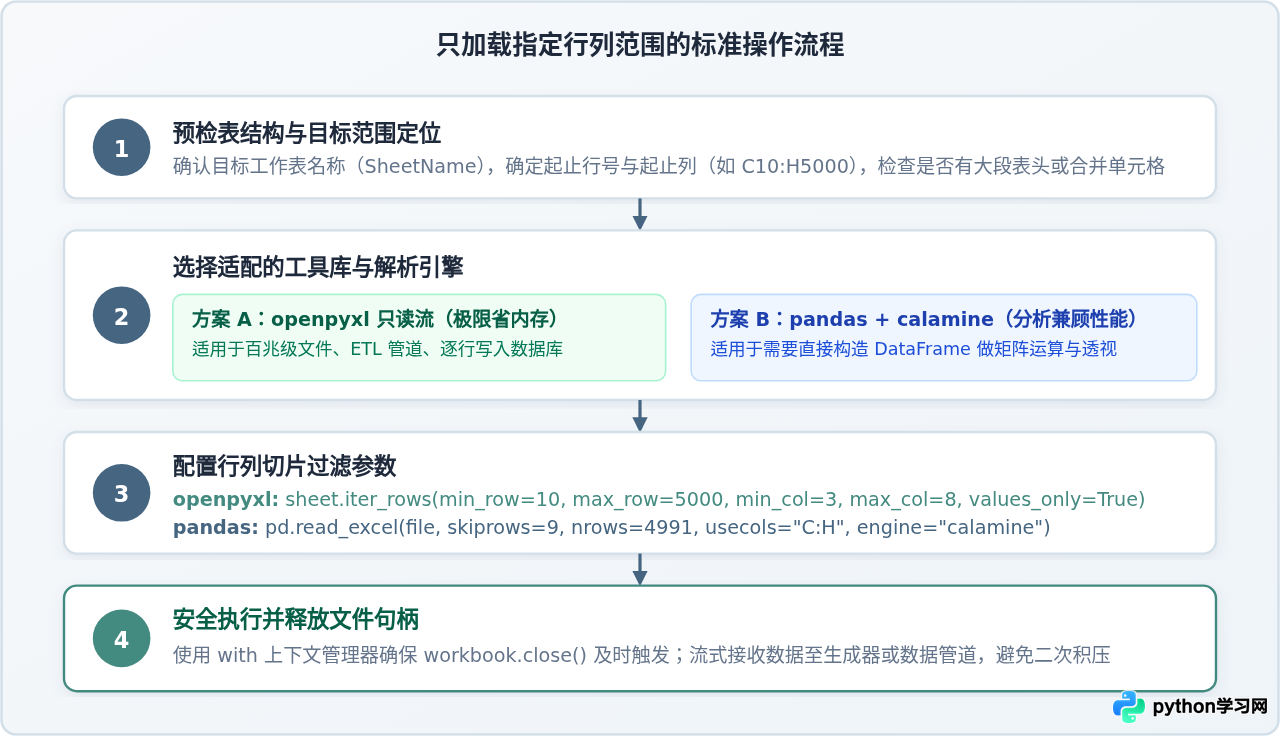
当 Excel 文件体积达到数十兆乃至数百兆、行数包含数十万行时,直接使用常规方法全量加载往往会导致系统内存急速暴涨甚至引发程序崩溃(OOM)。在 Python 中只加载指定行列范围,核心方案有两种:若对内存占用极其苛刻或文件在百兆以上,应采用 openpyxl 的只读流式模式(read_only=True)配合 iter_rows(min_row, max_row, min_col, max_col, values_only=True),将内存开销稳定在几十兆以内;若需要直接接入 Pandas 做统计与矩阵运算,则使用 pandas.read_excel() 搭配 usecols、skiprows 与 nrows 参数组,并优先搭配 calamine 底层引擎以获得更快的解析效率。
一、为什么常规加载大文件容易内存崩溃
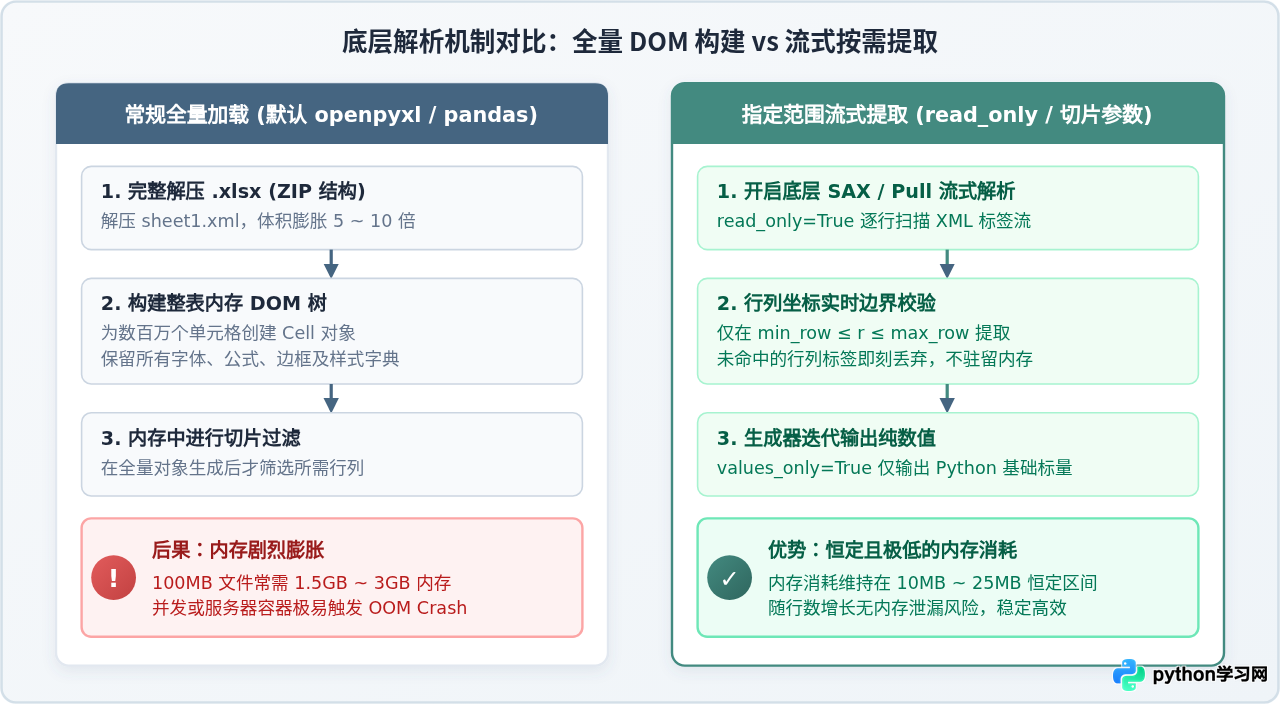
日常保存的 .xlsx 文件本质上是一个经过 ZIP 压缩的 XML 文件包。当使用默认参数执行 openpyxl.load_workbook("data.xlsx") 或未加切片参数的 pd.read_excel("data.xlsx") 时,解析器会先将压缩包内的 xl/worksheets/sheet1.xml 完整解压,并按 DOM 树的方式把每个单元格解析为独立的 Python 对象。
每个单元格对象不仅包含表面上的文本或数值,还保存着数据类型、字体配色、边框线型、对齐格式、数字掩码以及公式计算链。这种完整的对象图会产生 10 到 30 倍的内存膨胀:一个 150MB 的压缩 xlsx 文件解压并构建对象后,常需占用 2GB 到 4GB 以上的内存空间。如果只需读取其中某一块矩形区域(例如提取第 100 行到第 5000 行、C 列到 G 列的数据),把整个文件加载进内存再做切片是一种巨大的性能浪费。
二、使用 openpyxl 只读流式切片(极限低内存方案)
openpyxl 提供了专门面向大文件的 read_only=True 模式。在此模式下,底层的 XML 解析器切换为基于 SAX 的拉式(Pull Parser)流式解析器,逐行扫描并产出数据,完全不构建整表对象树。
1. 核心方法与参数说明
在只读工作表对象上,调用 iter_rows() 方法并传入四组边界参数即可精准锁定窗口:
min_row:起始行号(从 1 开始计数的物理行号)。max_row:终止行号(包含该行)。min_col:起始列号(整数,A 列为 1,B 列为 2,依此类推)。max_col:终止列号(整数,包含该列)。values_only=True:直接返回由单元格纯数值构成的元组,跳过创建只读 Cell 代理对象,进一步提升解析速度并削减内存开销。
2. 完整代码示例
以下示例从体积庞大的工作簿中,只提取 Sheet1 内物理坐标为 B10 至 F5000 的数据:
import openpyxl

# 必须启用 read_only=True,建议同时启用 data_only=True 读取公式计算后的静态值
excel_path = "large_dataset.xlsx"

target_rows = []
with openpyxl.load_workbook(filename=excel_path, read_only=True, data_only=True) as wb:
    sheet = wb["Sheet1"]

    # B 列对应 min_col=2,F 列对应 max_col=6
    # 仅扫描第 10 行至第 5000 行
    row_generator = sheet.iter_rows(
        min_row=10,
        max_row=5000,
        min_col=2,
        max_col=6,
        values_only=True
    )

    for row_values in row_generator:
        # row_values 为长度为 5 的元组,例如 (val_B, val_C, val_D, val_E, val_F)
        target_rows.append(row_values)

print(f"成功加载目标行数: {len(target_rows)},单行元素数: {len(target_rows[0])}")
print("前 2 行切片内容示例:", target_rows[:2])
前 2 行切片内容示例: [('2024-01-15', '华东分部', 'SKU-8021', 120, 4580.5), ('2024-01-15', '华北分部', 'SKU-8022', 45, 1720.0)]
read_only=True 模式下,底层维护着活跃的 ZIP 压缩包文件句柄与 XML 流游标。必须使用 with 上下文管理器或显式调用 wb.close(),否则可能导致句柄泄漏或临时文件未清除。此外,只读流只能单向正向遍历,不支持反向索引或随机回溯。
三、使用 pandas 精准切片(数据分析友好方案)
如果后续处理需要使用 Pandas 的 DataFrame 进行聚合、分组或机器学习建模,可以通过组合 read_excel 的三个核心参数实现按行列范围裁剪。
1. 核心参数配合机制
usecols:控制列范围。可以传入 Excel 列标字符区间(如"B:F")、列索引序号列表(如[1, 2, 3, 4, 5])、列名字符串列表或筛选函数。skiprows:跳过前置行数。若传入整数N,则直接略过文件开头的N行;若传入列表或可调用函数,则跳过指定行。nrows:自起始解析位置起向后读取的最大数据行数。注意该参数控制的是“有效读取条数”,并非物理行号。engine="calamine":针对大文件强烈建议安装python-calamine(基于 Rust 编写的高性能 Excel 解析引擎)。在 Pandas 中指定该引擎后,大文件的解析速度可达默认 openpyxl 引擎的 3 至 8 倍,且内存利用更为紧凑。
2. 完整代码示例
假定 Excel 表格前 3 行为无用的报表说明与空白行,第 4 行为真实表头,业务数据从第 5 行到第 2004 行(共 2000 行),目标列为 B 列到 F 列:
import pandas as pd

excel_path = "large_dataset.xlsx"

# skiprows=3 跳过前 3 行无关文字
# header=0 表示跳过后当前第 1 行(即物理第 4 行)作为列名表头
# nrows=2000 仅读取后续 2000 行数据记录
# usecols="B:F" 仅加载 B、C、D、E、F 这五列
df = pd.read_excel(
    excel_path,
    sheet_name="Sheet1",
    skiprows=3,
    header=0,
    nrows=2000,
    usecols="B:F",
    engine="calamine"  # 需要提前 pip install python-calamine
)

print(f"DataFrame 形状: {df.shape}")
print(df.head(3))
销售日期 区域 商品编码 销售数量 销售金额
0 2024-01-16 华南分部 SKU-1001 210 10500.0
1 2024-01-16 西南分部 SKU-1002 85 4250.0
2 2024-01-16 华北分部 SKU-1003 340 17000.0
四、行列坐标体系与参数换算规则
初学者在限定行列范围时最容易踩坑的地方是坐标系的定义差异:Excel 是面向物理表格的 1-based 字母索引体系,openpyxl 遵循物理坐标,而 Pandas 的底层列表机制往往是 0-based 偏移体系。
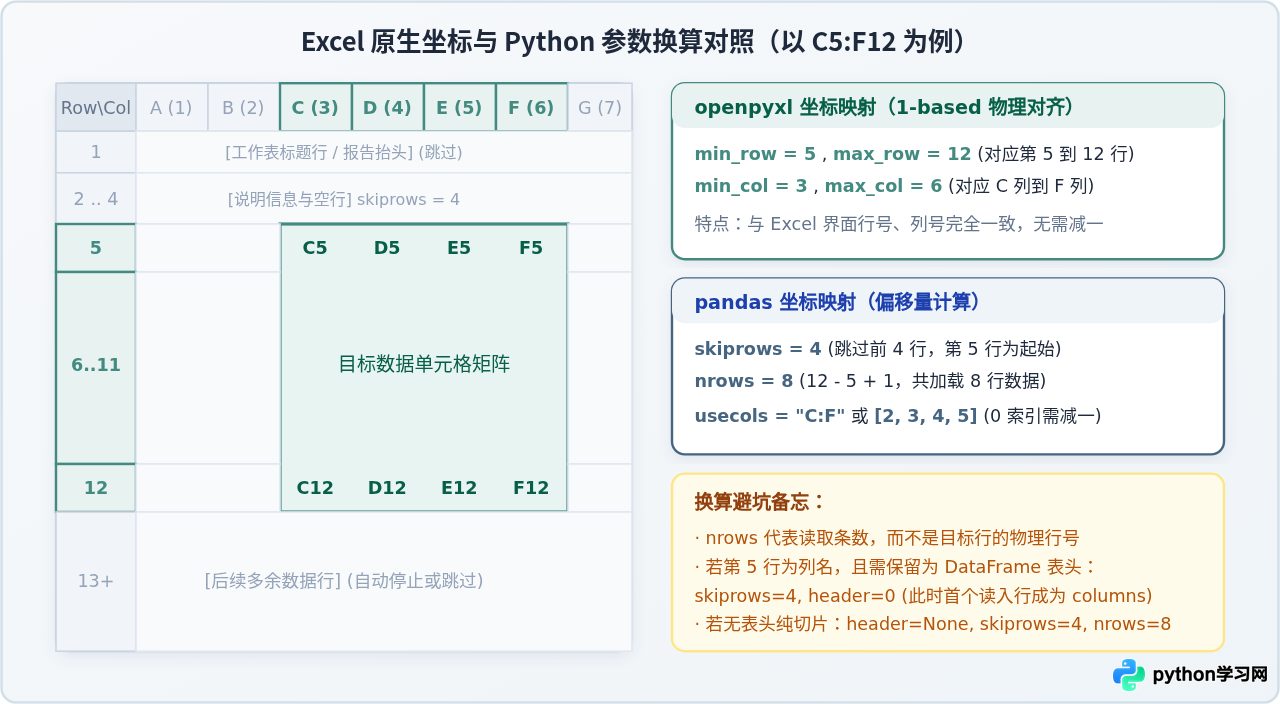
| 维度 / 目标区域 | Excel 物理坐标 | openpyxl 参数设置 | pandas 参数设置 |
|---|---|---|---|
| 起始行 (Row Start) | 第 5 行 | min_row=5 |
skiprows=4(跳过前 4 行) |
| 结束行 (Row End) | 第 12 行 | max_row=12 |
nrows=8(计算公式:12 - 5 + 1) |
| 起始列 (Col Start) | C 列 | min_col=3 |
usecols="C:F" 或 [2, 3, 4, 5] |
| 结束列 (Col End) | F 列 | max_col=6 |
包含在 usecols 区间内 |
| 索引基准机制 | 从 1 开始,列为 A-Z | 从 1 开始整数计数 | 切片条数计数,列表为 0 索引 |
nrows 永远表示“向下读多少条”,千万不要直接把 Excel 的结束行号填入 nrows。例如目标是读取第 100 行到第 150 行,正确配置是 skiprows=99、nrows=51。
五、常见问题排查与边界条件处理
1. 目标范围内包含合并单元格时取值为 None
在 Excel 的底层存储机制中,合并单元格(如 C5:E5 合并为一格)仅在左上角首个物理单元格(C5)中存储真实数据,其余被合并的区域(D5、E5)在 XML 中记录为空节点。在只读流式模式下,解析器不会前向填补空白。如果需要提取合并区域的数据,建议在业务代码中按需向前填充(Forward Fill),或使用辅助字典记录合并范围坐标。
2. skiprows 导致列名被误当做普通数据行
若数据表没有表头行,或者希望从第 10 行开始纯粹读取数值,在使用 pandas 时如果仅设置 skiprows=9,pandas 会默认将第 10 行作为列名(Columns)。此时应显式声明 header=None,通知 pandas 生成数字列索引 0, 1, 2...,避免第一条实际数据被吞噬。
3. 行数未知时的大文件分块读取(Chunking)
当面对不知道具体总行数、但单次处理无法容纳全量数据的超大表格时,可以通过 openpyxl 的生成器分批迭代,或者使用 pandas 分段加载:
def read_excel_chunks(file_path, sheet_name, chunk_size=5000, min_col=1, max_col=10):
    """分块流式读取超大 Excel 文件"""
    with openpyxl.load_workbook(file_path, read_only=True, data_only=True) as wb:
        sheet = wb[sheet_name]
        chunk = []
        # 从第 2 行跳过表头流式向后读取
        for row in sheet.iter_rows(min_row=2, min_col=min_col, max_col=max_col, values_only=True):
            chunk.append(row)
            if len(chunk) >= chunk_size:
                yield chunk
                chunk = []
        if chunk:
            yield chunk

# 消费分块生成器示例
for batch_idx, batch_data in enumerate(read_excel_chunks("large_dataset.xlsx", "Sheet1", chunk_size=10000)):
    # 在此执行批量写入数据库或特征计算,处理完毕后垃圾回收器立即释放内存
    pass
六、方案选型与决策总结
针对不同体积的 Excel 文件与业务应用场景,下表与决策图汇总了技术选型策略:
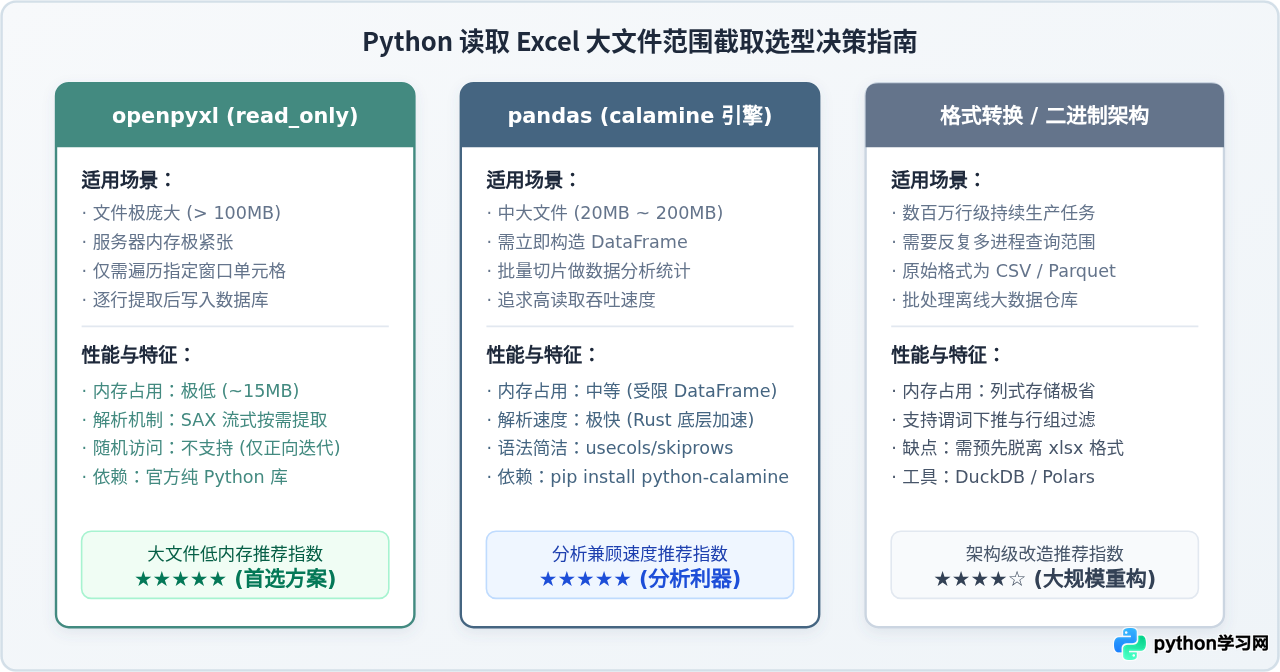
- 首选 openpyxl 只读模式:当 Excel 文件大于 100MB,或者运行环境(如云函数、容器、低配服务器)内存低于 1GB,且任务偏向 ETL 提取、转存或逐行入库时,
openpyxl(read_only=True)是绝对安全且内存恒定的最优解。 - 首选 pandas + calamine 引擎:当文件在 10MB 至 100MB 之间,且提取指定切片后需立即开展切片筛选、数学统计、透视表分析时,配合
calamine引擎可以在极短时间内完成切片并产出结构化的 DataFrame。 - 格式重构建议:如果某张 Excel 表格行数持续超过 50 万行且需要被频繁按范围查询,Excel 本身的 XML 结构已经不再适合作为高性能数据载体。建议在源头或首道工序将其转换为 Parquet、Feather 或 SQLite 数据库,以获得原生的列式裁剪与谓词下推能力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









