

Python怎么读取Excel指定Sheet、行和列范围的数据
详细讲解在Python中如何使用pandas与openpyxl精准读取Excel中指定工作表(Sheet)、特定行与列范围的数据,提供完整的代码示例、参数映射原理、运行结果与选型避坑指南。
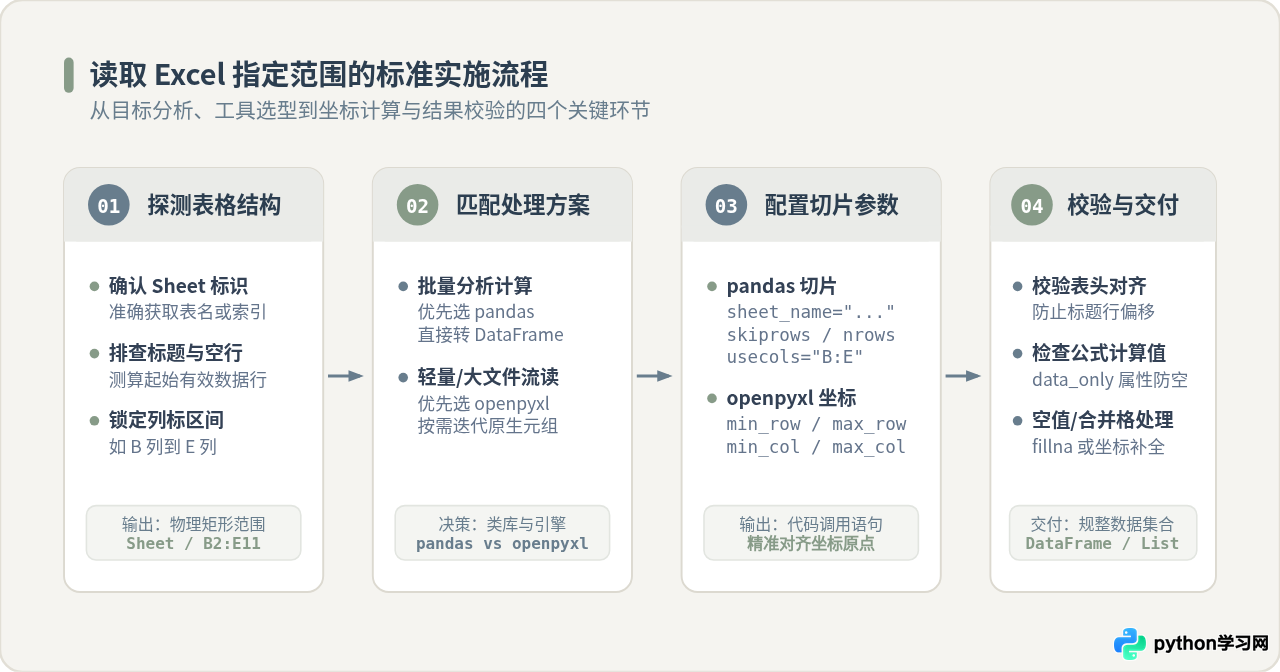
在 Python 中读取 Excel 指定工作表(Sheet)以及特定的行、列范围,核心在于准确传入工作表标识与行列定位参数。最常用的两套方案是 pandas 与 openpyxl:如果需要对数据进行批量计算、清洗或转为规整的二维结构,使用 pandas.read_excel() 搭配 sheet_name、usecols、skiprows 和 nrows 可以最快拿到规整的 DataFrame;如果只需要轻量提取、保留原单元格格式与公式属性,或按特定单元格坐标精准切片(如 B3:E15),使用 openpyxl 的 ws.iter_rows() 则是更为直接高效的选择。本文将分别介绍这两套方案的具体实现、参数映射原理、运行示例与选型差异。
一、读取前的准备工作与示例数据说明
在执行读取前,需要通过终端安装所需的解析库。pandas 内部处理 .xlsx 文件时依赖 openpyxl 作为解析引擎,因此在实际开发中通常建议同时安装两者:
pip install pandas openpyxl
为了让后续的代码示例与截取参数能够清晰对应,本文设定一个具有典型报表排布特征的 Excel 文件 sales_report.xlsx。该文件包含三个工作表:"Summary"、"2024年销售明细" 和 "员工名单"。
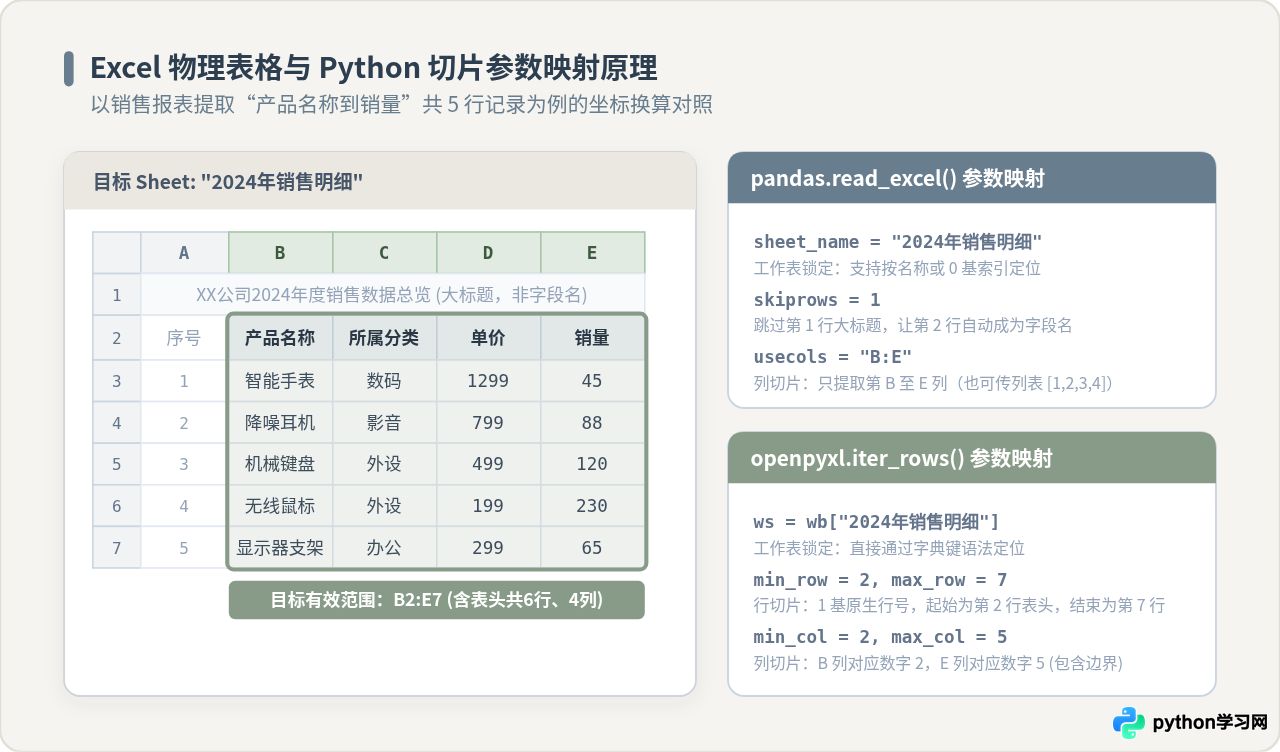
目标工作表为 "2024年销售明细",其内部网格结构呈现以下特点:
- 第 1 行:大标题居中合并行,内容为“XX公司2024年度销售数据总览”,并非实际的数据字段名。
- 第 2 行:真实的表头字段行,A 列至 F 列依次为:“序号”、“产品名称”、“所属分类”、“单价”、“销量”、“备注”。
- 第 3 行至第 50 行:逐笔销售业务记录。
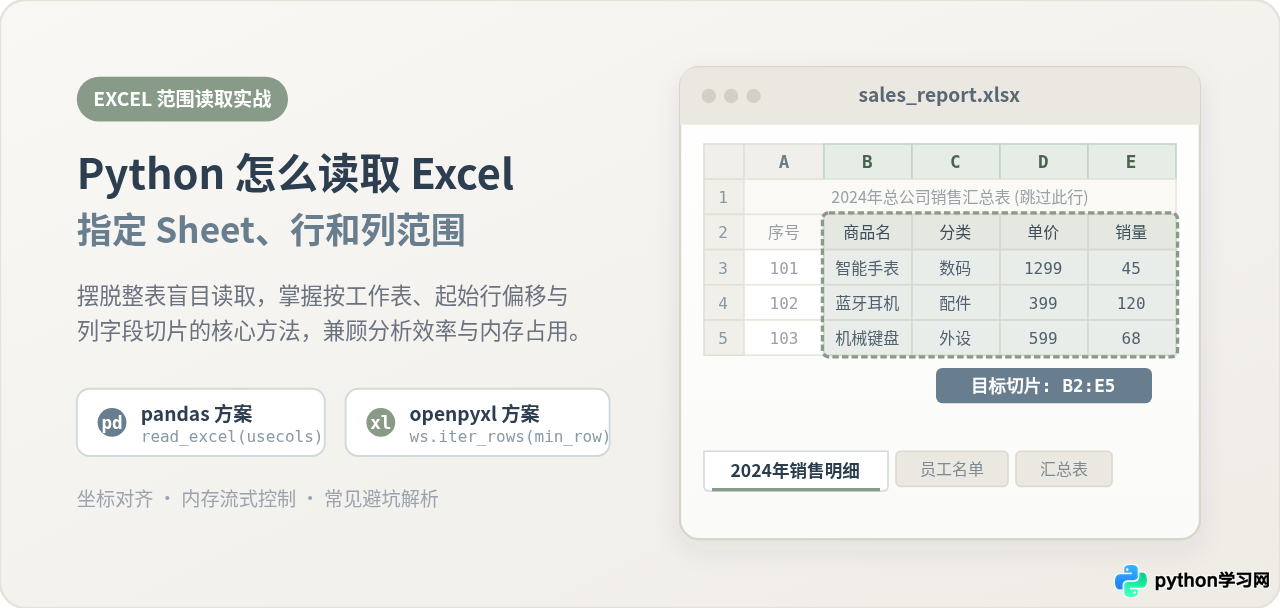
截取目标:只提取 "2024年销售明细" 工作表中,从“产品名称”到“销量”(即 B 列至 E 列),且只截取第 2 行表头及其后续的 5 行有效数据(即 Excel 物理范围 B2:E7),忽略第 1 行标题和无关的 A 列、F 列。
二、方法一:使用 pandas 快速读取指定范围
pandas.read_excel() 函数内置了丰富的切片参数,无需手动编写双重循环遍历单元格,可以在加载阶段就直接过滤出目标区域。
1. 核心参数说明
sheet_name:指定要读取的工作表。可以传入字符串工作表名(如"2024年销售明细"),也可以传入从0开始的整数索引(如1表示第二个 Sheet)。skiprows:跳过工作表开头的无关行数。因为第 1 行是大标题,设置skiprows=1会让 pandas 从 Excel 的第 2 行开始解析,并自动将第 2 行识别为 DataFrame 的列名(Header)。nrows:指定从有效数据起点开始向下读取的行数。若设定nrows=5,则读取表头之后的 5 行数据记录。usecols:指定需要保留的列。支持传入 Excel 原生列字母区间字符串(如"B:E")、列号列表(如[1, 2, 3, 4],注意列号从 0 计数)或目标列名列表。
2. 完整代码示例
Python 脚本 (pandas_read_range.py)import pandas as pd
file_path = "sales_report.xlsx"
# 通过指定参数完成 Sheet、行、列的三重精准截取
df = pd.read_excel(
io=file_path,
sheet_name="2024年销售明细", # 锁定指定工作表
skiprows=1, # 跳过第 1 行的报表大标题
nrows=5, # 仅读取表头后的 5 行数据
usecols="B:E" # 截取 B 列(产品名称)至 E 列(销量)
)
# 打印读取结果与维度
print("=== 读取到的 DataFrame 预览 ===")
print(df)
print(f"数据形状: {df.shape[0]} 行 x {df.shape[1]} 列")
print(f"字段列表: {list(df.columns)}")
可以看到,skiprows=1 让 pandas 避开了大标题干扰,准确将 Excel 的第 2 行识别为了字段名称;usecols="B:E" 剔除了无用的序号和备注列;nrows=5 使得提取的数据集精准停在第 7 行,产出的 DataFrame 可直接参与后续的数据统计与计算。
三、方法二:使用 openpyxl 进行精准单元格切片
如果开发环境不允许引入庞大的 pandas 依赖,或者任务属于轻量级脚本、批量模板填充,使用 openpyxl 能以更纯粹的原生方式读取目标区域。
1. 坐标切片的两种方式
在 openpyxl 中,坐标编号是基于 1 的物理序号(1-indexed),这与 Excel 界面上看到的行号、列号是一致的。获取指定范围主要有两种写法:
- 二维切片语法:
ws['B2:E7']。返回由 Cell 对象组成的嵌套元组,需要遍历单元格并读取.value属性。 - 迭代生成器语法:
ws.iter_rows(min_row=2, max_row=7, min_col=2, max_col=5, values_only=True)。该方法效率更高,通过传入values_only=True可以直接跳过 Cell 对象构造,直接输出纯数值元组。
2. 完整代码示例
Python 脚本 (openpyxl_read_range.py)import openpyxl
file_path = "sales_report.xlsx"
# data_only=True 确保读取公式单元格时获取计算结果而非公式表达式字符串
wb = openpyxl.load_workbook(filename=file_path, data_only=True)
# 1. 指定工作表
if "2024年销售明细" in wb.sheetnames:
ws = wb["2024年销售明细"]
else:
raise ValueError("未找到指定的 Sheet: 2024年销售明细")
# 2. 通过 iter_rows 指定行号范围 (2到7) 与列号范围 (2到5,即 B 到 E)
records = []
for row in ws.iter_rows(min_row=2, max_row=7, min_col=2, max_col=5, values_only=True):
records.append(row)
# 3. 解析表头与数据行
headers = records[0] # 第 2 行的内容充当表头
data_rows = records[1:] # 第 3 行到第 7 行的内容充当数据
print(f"提取字段: {headers}")
print(f"提取行数: {len(data_rows)} 条记录")
print("=== 逐行数据预览 ===")
for idx, row in enumerate(data_rows, start=1):
print(f"第 {idx} 行: {row}")
# 关闭工作簿释放文件句柄
wb.close()
使用 iter_rows 时,列号需将字母换算为对应数字:A 列对应 1,B 列对应 2,E 列对应 5。如果不想手动换算,可以引入 openpyxl 内置的辅助函数 from openpyxl.utils import column_index_from_string,通过 column_index_from_string('B') 动态获取列号。
四、同等条件下的关键差异与技术选型
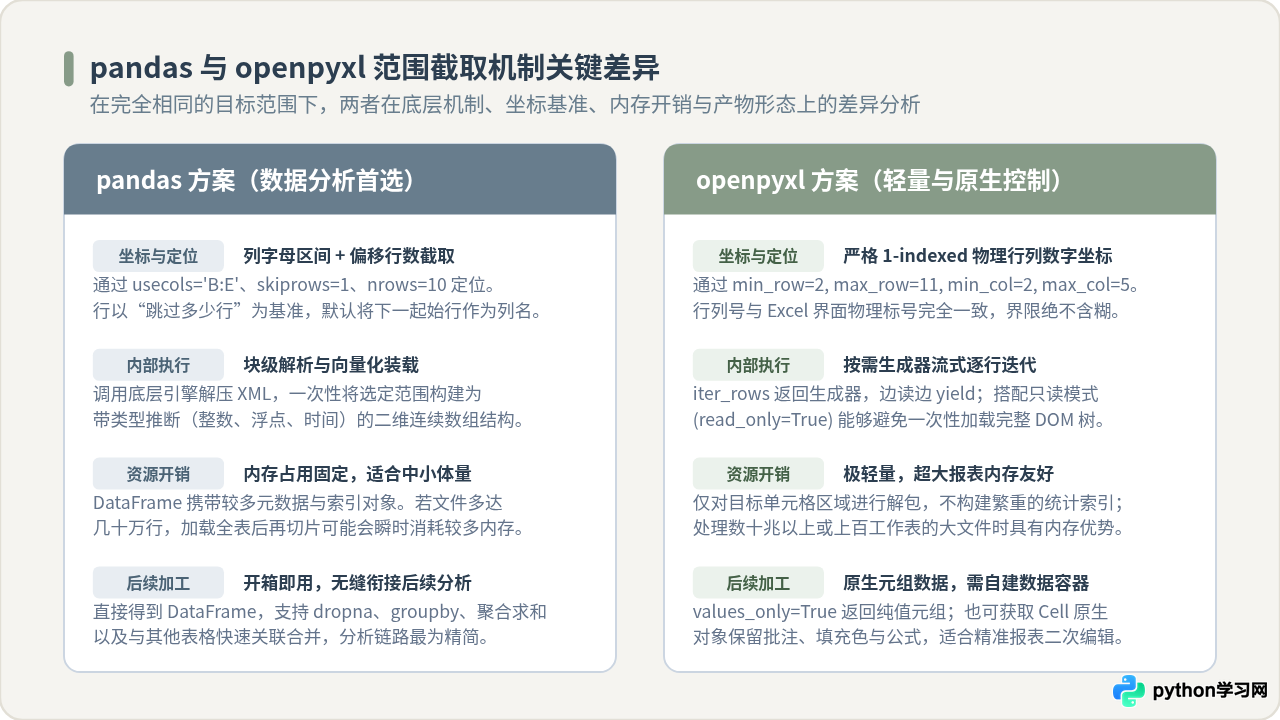
为了在不同业务场景下做出合理判断,下面在一致的目标条件(读取同样大小的指定矩形块 B2:E7)下,对比两者的核心差异:
| 对比维度 | pandas (read_excel) | openpyxl (iter_rows) | 差异带来的实际影响 |
|---|---|---|---|
| 坐标基准 | 跳过行数 (skiprows) + 列名/字母串 | 物理行列标号 (1-indexed) | openpyxl 与 Excel 界面视觉行号完全一致,不易算错;pandas 偏向于跳过头部无关行后的相对对齐。 |
| 内存与执行模式 | 整体解析并装载入 DataFrame | 生成器流式逐行迭代 (可配置 read_only 模式) | 中小型文件两者速度相当;超大 Excel(数万至数十万行)若只截取片段,openpyxl 流式只读模式内存极低。 |
| 数据类型推断 | 内置智能类型转换(自动识别日期、浮点) | 保持 Excel 单元格存储的原生类型 | pandas 便于直接计算;openpyxl 保留了真实单元格结构,避免意料之外的类型隐式转换。 |
| 返回结构 | DataFrame 二维数据帧 | 纯值元组 (Tuple) 或 Cell 对象 | 需要进行数据清洗、去重、分组统计时,选 pandas 省去大量循环;需要修改保存特定单元格时选 openpyxl。 |
五、边界情况与常见问题排查
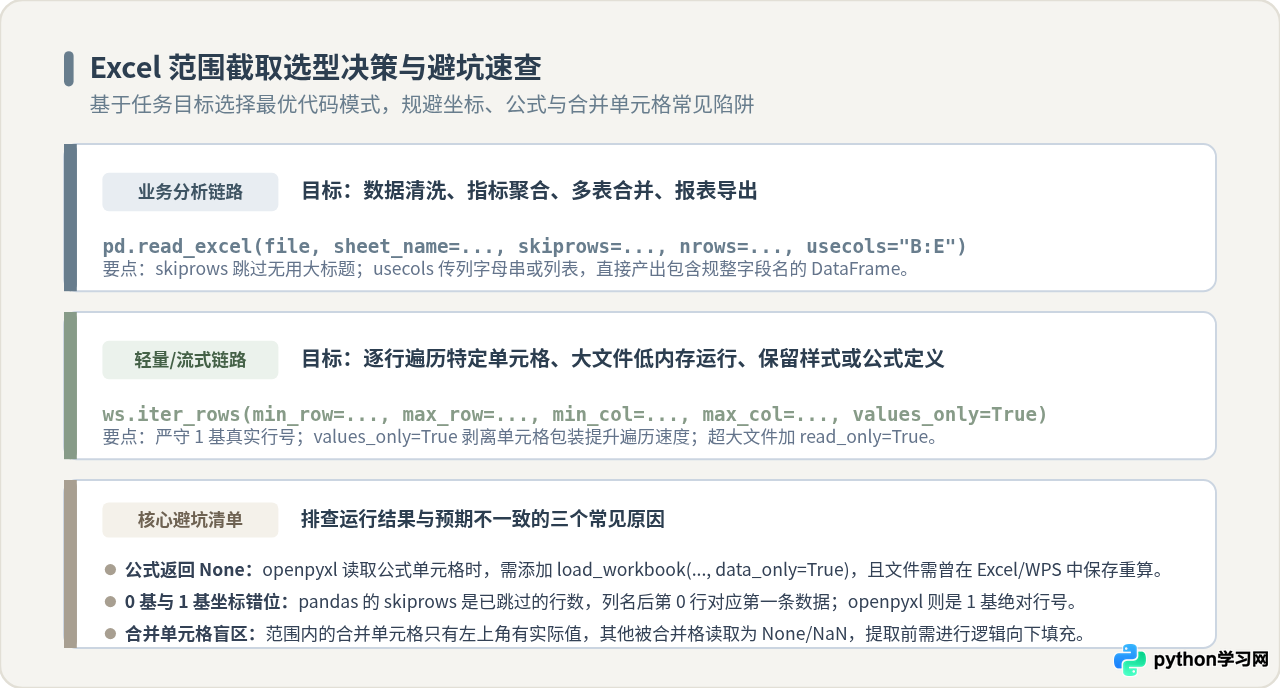
1. 公式单元格读出为 None 或公式文本
在 openpyxl 中,默认加载的是单元格内记录的公式字符串(如 =SUM(D3:D7)),而非其计算数值。如果要读取计算值,必须在 load_workbook 时传入 data_only=True。
data_only=True 后依然读取到 None,这是因为 Excel 文件的公式缓存未被刷新。openpyxl 自身不具备公式计算引擎,它读取的是 Excel 软件最后一次保存时写入的缓存结果。如果文件是由第三方程序直接生成而未在 Microsoft Excel 或 WPS 中打开并保存过,缓存可能为空。
2. 合并单元格的范围提取陷阱
若指定的截取范围中包含合并单元格(例如某两行的“所属分类”合并为了“外设”),在 openpyxl 和 pandas 中:
- 只有合并区域左上角的首个单元格保留其实际值。
- 其余被合并的从属单元格在 openpyxl 中读取为
None,在 pandas 中读取为NaN。 - 解决方案:在使用 pandas 读取后,可以对特定列执行
df['所属分类'] = df['所属分类'].ffill()(前向填充),恢复被合并格原本代表的分类信息。
3. 动态确定行范围与末尾边界
在不知道表格确切有多少行时,若需要从第 2 行一直截取到末尾,可以动态获取边界:
- pandas 做法:省略
nrows参数,只保留skiprows=1和usecols="B:E",pandas 会自动读取到包含有效数据的最后一行。 - openpyxl 做法:使用
ws.max_row取得末行行号,但需注意如果原表格底部存在空白格式刷残留,max_row可能会虚高。可以通过倒序检查行中是否存在非空单元格来准确定位末行。
总结
Python 读取 Excel 指定 Sheet、行和列范围的核心是明确坐标基准与选准库工具:
当任务面向数据分析与批量处理时,选用 pandas.read_excel(io, sheet_name=..., skiprows=..., nrows=..., usecols=...) 是效率最高的方式,几行配置即可直接输出标准 DataFrame;
当任务面向轻量抽取、大文件低内存遍历或单元格属性保留时,选用 openpyxl 配合 iter_rows(min_row=..., max_row=..., min_col=..., max_col=..., values_only=True),能够以严格对应的 Excel 物理坐标,稳定且可控地提取出目标数据。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









