

Python读取Excel指定Sheet和特定行列的方法
详细讲解在Python中使用Pandas与OpenPyXL读取Excel指定工作表(Sheet)以及精准提取特定行、特定列的具体方法与代码示例,并对比两种方案在索引机制与内存占用上的关键差异。
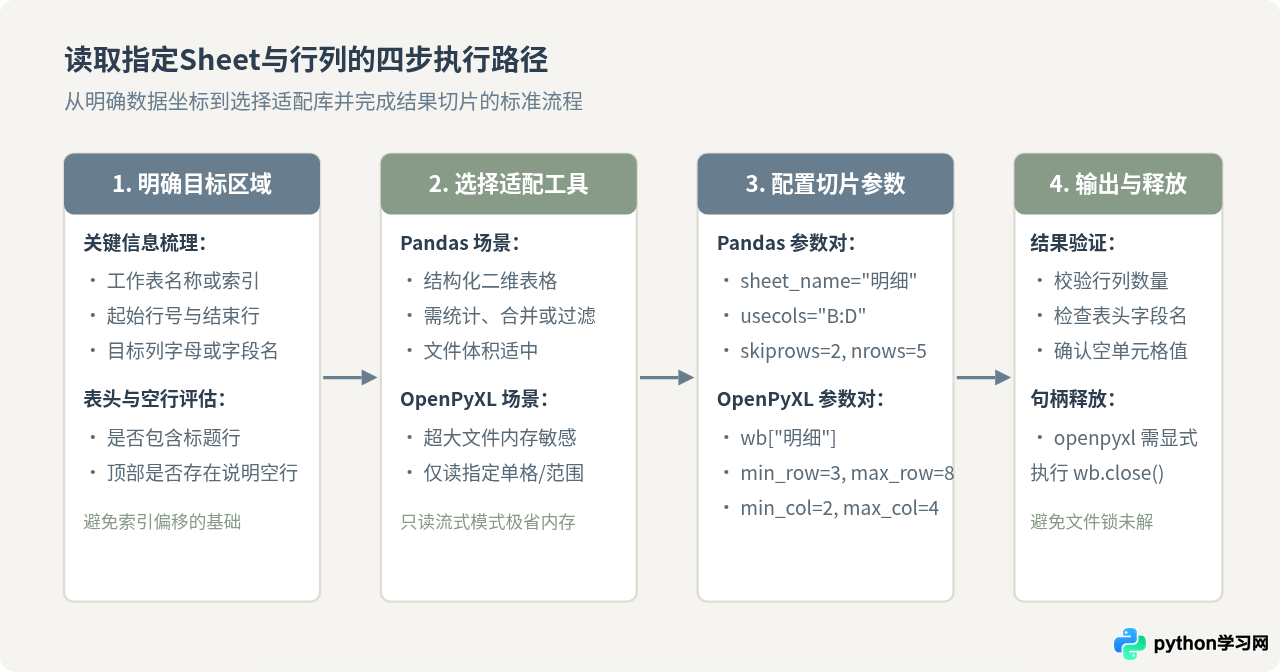
在 Python 中读取 Excel 指定工作表(Sheet)以及提取特定行、特定列的数据,核心路径主要分为两种:如果后续需要开展数据分析、清洗或复杂矩阵计算,首选 pandas 库的 read_excel 函数,通过配置切片参数一步到位;如果处理的是上百兆的大体积文件、仅需抽取少量零散单元格,或者希望尽量减少科学计算库依赖,则推荐使用 openpyxl 库的只读流式模式直接按单元格坐标提取。
一、使用 Pandas 定位 Sheet 与精确切片行列
pandas 提供了顶层函数 pd.read_excel(),它内部借助引擎(现代 .xlsx 文件通常依赖 openpyxl)将表格数据转换为结构化的 DataFrame。通过组合四个核心参数,可以直接在读取阶段完成区域剪裁,避免将无关行列全部载入内存:
sheet_name:用于指定要读取的工作表。可以是字符串名称(如"2024季度表")、从 0 开始的整数序号(如0代表第一个 Sheet)、序号或名称列表(返回字典),或者设置为None读取全量 Sheet。usecols:用于指定读取的列。支持传入 Excel 标准列字母范围(如"B:D"或"A, C, E")、从 0 开始的整数列表(如[1, 2, 3])、字符串列名列表,或自定义函数。skiprows:用于跳过表格顶部的行数。例如前两行为报表大标题和更新日期时,设置skiprows=2即可从第 3 行开始读取。nrows:用于限制读取的最大数据行数(不包含表头自身)。例如读取跳过表头后的前 10 行数据。
代码示例:使用 Pandas 读取指定区域
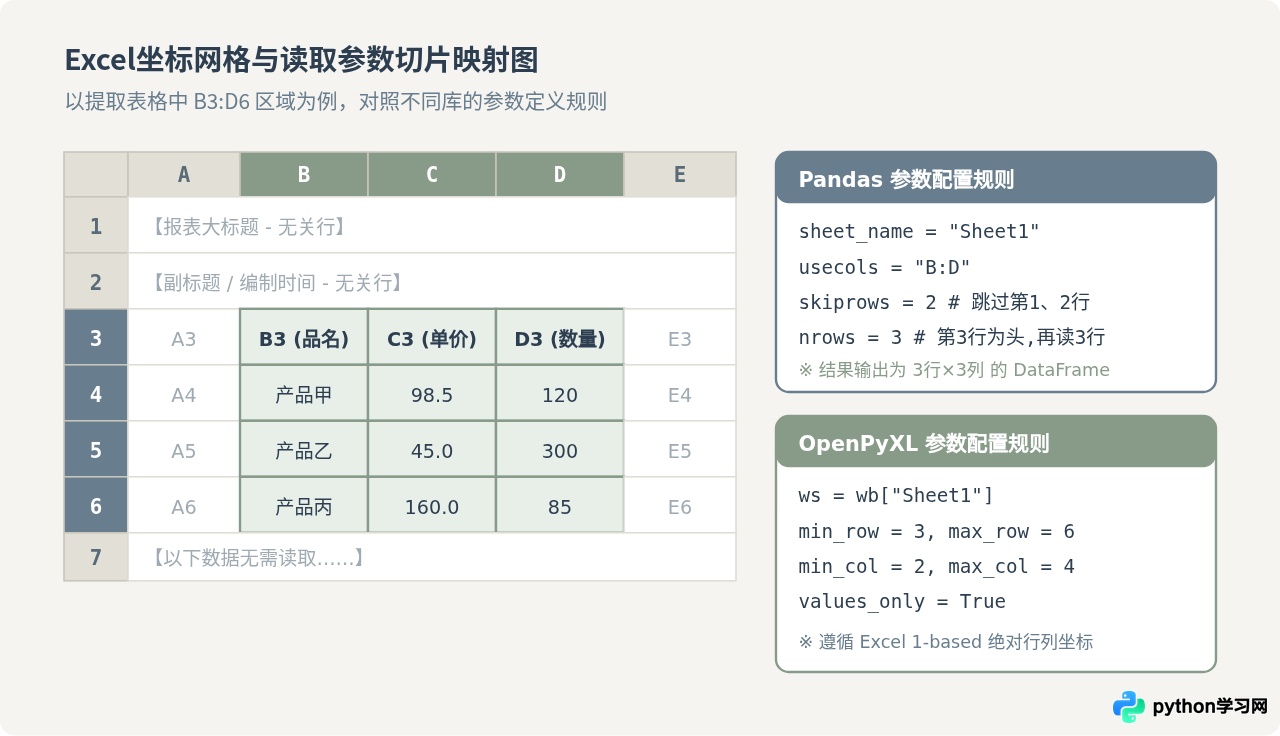
假设我们有一个名为 data.xlsx 的工作簿,需要读取名为 "Sales2024" 的 Sheet,提取第 3 行到第 6 行(其中第 3 行为列名),并且只获取 B、C、D 三列的数据:
import pandas as pd

file_path = "data.xlsx"

# 目标参数配置
df = pd.read_excel(
    file_path,
    sheet_name="Sales2024",  # 指定工作表名称(也可传索引,如 0)
    usecols="B:D",           # 仅提取 B、C、D 三列
    skiprows=2,              # 跳过前两行(第 1 行与第 2 行)
    nrows=3                  # 读取表头(第 3 行)下方的 3 行数据
)

# 打印读取到的结构化数据
print(df)
skiprows=2 时,原工作簿的第 3 行会被 Pandas 默认识别为列名(header=0)。若第 3 行本身就是纯数据而不是列名,需额外添加参数 header=None,此时 nrows=4 才会完整读取 4 行数据。
二、使用 OpenPyXL 按坐标逐行或按区域流式提取
openpyxl 是 Python 操作 .xlsx 文件的原生底层库。与 Pandas 将全表载入为数据帧不同,OpenPyXL 允许开发者通过工作表的网格索引直接遍历单元格,特别是在开启 read_only=True 模式后,能大幅减少大体积表格的内存占用。
1. 单元格范围切片方式
OpenPyXL 原生支持类似 Excel 公式的范围语法,例如 ws["B3:D6"]。返回的结果是由每一行单元格对象组成的元组集合:
from openpyxl import load_workbook

# 加载工作簿(若数据只读,开启 read_only 可显著降低内存并加快解析)
wb = load_workbook(filename="data.xlsx", read_only=True, data_only=True)

# 定位指定 Sheet
ws = wb["Sales2024"]

# 使用 Excel 区域标签读取特定单元格切片
for row in ws["B3:D6"]:
    row_values = [cell.value for cell in row]
    print(row_values)

# 操作完毕后及时关闭文件句柄
wb.close()
2. 使用 iter_rows 精确传递边界参数(推荐做法)
在编写自动化脚本或动态函数时,使用纯数字坐标更加通用。通过 iter_rows 方法,可以显式指定最小与最大行列数,并配合 values_only=True 直接返回 Python 原生数值:
from openpyxl import load_workbook

wb = load_workbook(filename="data.xlsx", read_only=True, data_only=True)
ws = wb["Sales2024"]

# min_row=3, max_row=6 代表读取第 3 至第 6 行
# min_col=2, max_col=4 代表读取第 2 至第 4 列(即 B 列至 D 列)
for row_values in ws.iter_rows(min_row=3, max_row=6, min_col=2, max_col=4, values_only=True):
    print(row_values)

wb.close()
三、关键差异解析:为什么索引基准与内存模式很重要
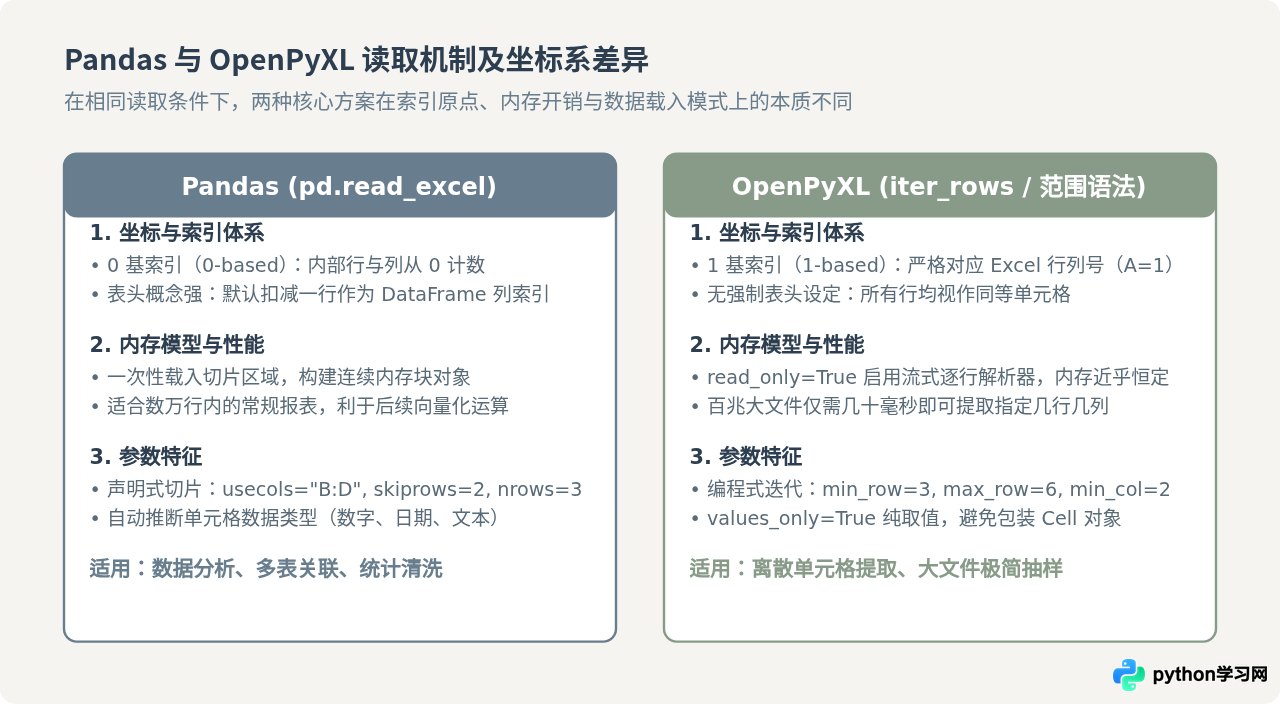
在实际编码中,很多读取错误(例如数据行错位、少读一行、读入全为 NaN)都源于没有分清这两个库在坐标体系与数据映射上的底层设计差异:
| 对比维度 | Pandas (read_excel) | OpenPyXL (iter_rows) |
|---|---|---|
| 起始行与列基准 | 0 基索引(编程思维)。如果传整数列表,第 1 列是 0。 | 1 基索引(Excel 自然思维)。第 1 行是 1,A 列是 1。 |
| 表头与数据行切分 | 默认把切片第一行识别为列名,不计入 nrows。 |
不区分表头与数据,严格按照物理行号 min_row 到 max_row 截取。 |
| 列指定方式 | 支持字符串列名 ["单价"]、字母范围 "B:D" 或序号。 |
直接指定列号数字 min_col=2, max_col=4 或坐标 "B3:D6"。 |
| 内存占用机制 | 即使指定了 usecols,底层引擎仍需解析 XML 流生成 DataFrame。 |
在 read_only=True 下为纯生成器迭代,几乎不占用多余内存。 |
| 公式单元格处理 | 默认直接提取公式上一回计算后缓存的数值。 | 默认读取到公式字符串本身;若需数值须指定 data_only=True。 |
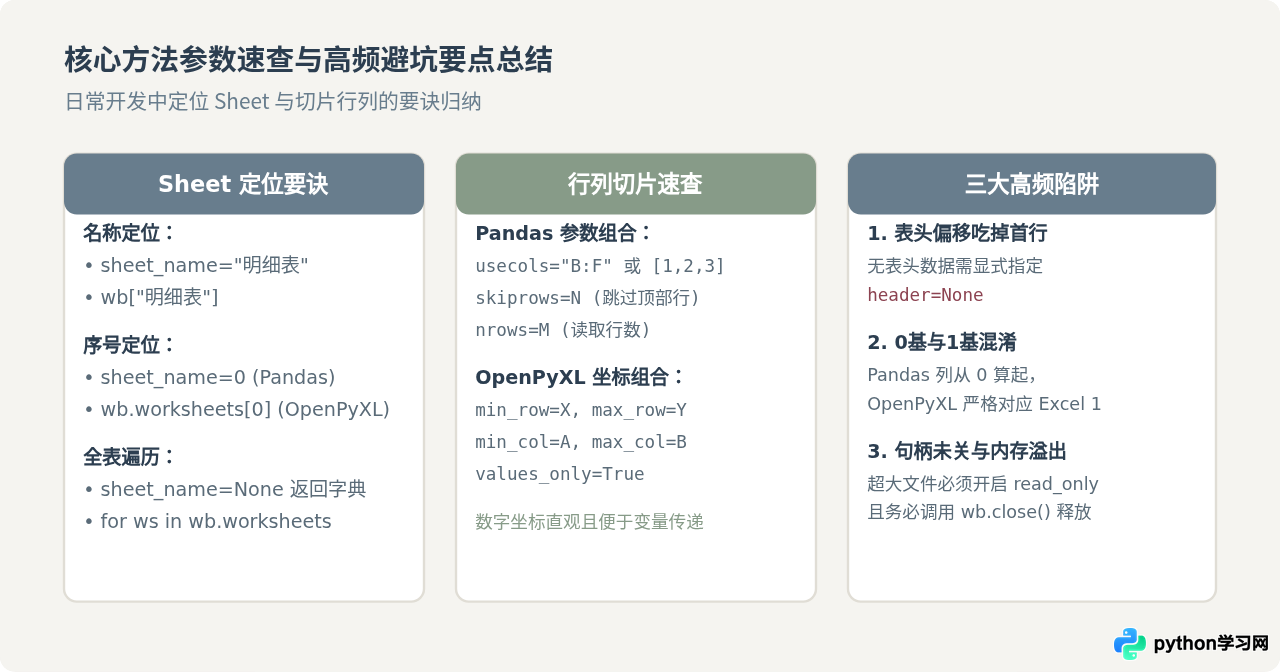
四、常见问题排查与避坑要点
- 使用
usecols="B:D"报错或未生效:在 Pandas 中,列字母切片必须采用连续闭区间(如
"B:D")或逗号分隔列表(如"B, C, D")。如果指定了不存在的列字母或混用了带空格的不规范格式,可能会抛出ValueError或返回空列。 skiprows与header联合使用导致少读数据:如果表格前两行是空行或报表标题,第 3 行是列名,第 4 行才是具体数据,应配置
skiprows=2(直接跳过前 2 行),此时 Pandas 会自动将第 3 行作为表头。如果此时又误加了header=2,Pandas 会在跳过 2 行的基础之上再往后数 2 行,把第 5 行当作表头,导致严重的数据错位。- OpenPyXL 读取大文件时未关闭文件句柄:
开启
read_only=True模式时,底层会保持对 Excel 压缩包内 XML 文件的打开句柄。如果在循环遍历结束后没有显式调用wb.close(),在 Windows 系统或多进程环境下可能导致文件被永久锁定无法覆写。 - 读取公式单元格返回
None或字符串:在 OpenPyXL 中,如果表格刚被某些第三方库生成而从未在 Excel 软件中打开保存过,其公式计算缓存可能为空。使用
data_only=True读取此类单元格时会返回None;若需要在没有 Excel 软件的环境中实时运算公式,需借助外部计算工具链。
五、结语
掌握指定 Sheet 和特定行列的读取方法,是编写高质量 Python 数据处理脚本的基本功。对于大多数表格处理需求,利用 pandas.read_excel 的 sheet_name、usecols、skiprows 与 nrows 即可优雅完成;而在处理海量流水记录或执行快速单元格抽样时,利用 openpyxl 的 read_only 与 iter_rows 能在保证极低内存开销的同时达成精确的坐标级提取。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









