

Python pandas读取Excel指定Sheet:sheet_name参数用法详解
详细讲解使用Python pandas的read_excel函数读取指定Sheet的方法,解析sheet_name参数接收字符串、整数、列表及None时的不同行为与返回类型,并提供工作表预检与多表合并的最佳实践。
pandas.read_excel() 函数读取数据时,决定具体读取哪一个或哪几个工作表的核心设置项是 sheet_name 参数。本文将全面拆解 sheet_name 接收字符串、整数索引、列表以及 None 时的具体用法,剖析单表与多表返回类型的本质差异,并给出规范的排查与合并实践。
一、核心机制:sheet_name 的参数定位与数据载入逻辑
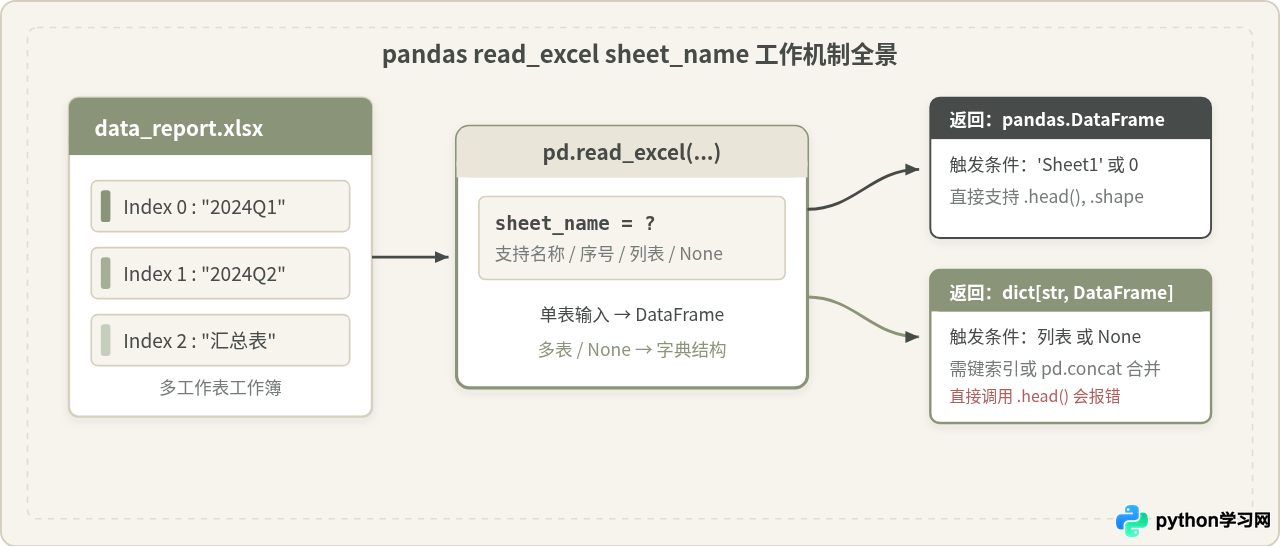
在调用 pandas.read_excel(io, sheet_name=0, ...) 时,io 指定文件路径或文件对象,而 sheet_name 决定读取的范围与返回的数据结构。初学者最容易产生的误解是认为“read_excel 永远返回一个 DataFrame”。实际上,pandas 会根据 sheet_name 传参类型的不同,动态改变返回值的数据类型。
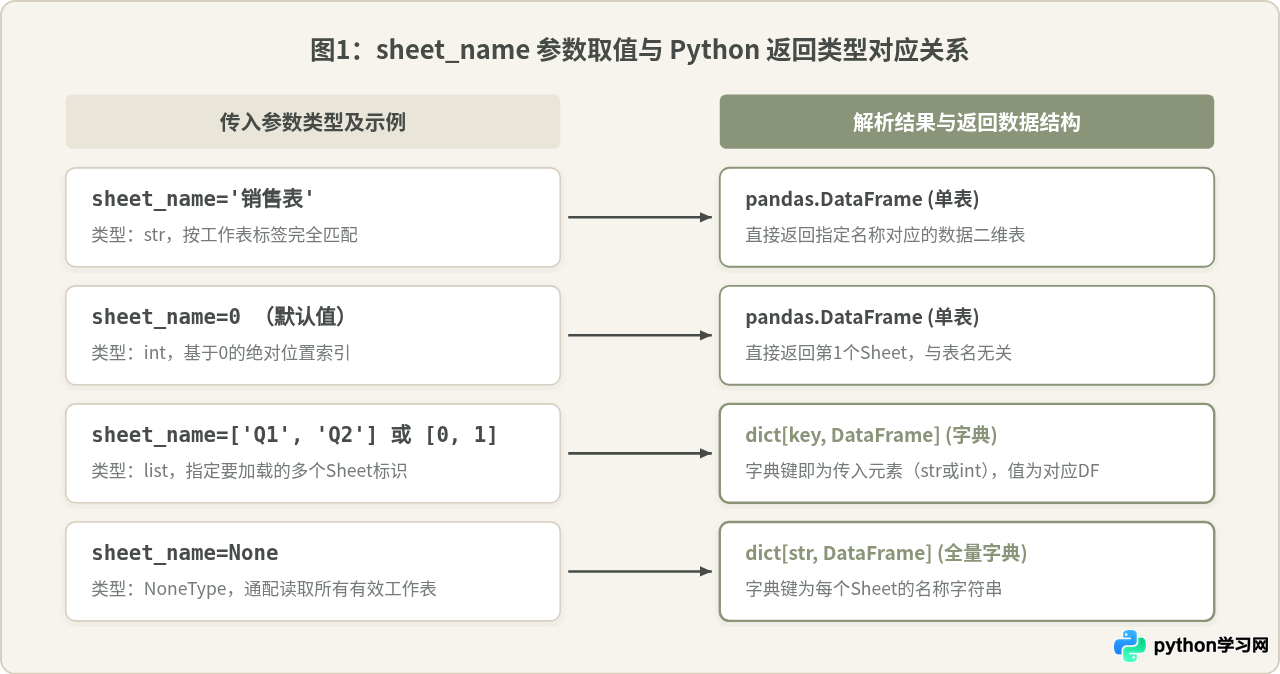
当传入单个工作表标识(表名字符串或单个整数索引)时,函数直接返回一个 pandas.DataFrame;而当传入列表或 None 时,函数会返回一个 Python 原生字典 dict,字典的键为工作表名称或序号,值为对应的 DataFrame。理解这种映射关系,是后续数据清洗与分析流程不出现类型错误的前提。
二、基础操作:读取单个工作表(按名称与按索引)
日常任务中最常见的需求是仅提取工作簿中的某一特定表格。读取单表有两种主要策略:基于工作表标签名称(字符串)和基于工作表显示排列位置(从 0 开始的整数索引)。
1. 按工作表名称读取(推荐用于名称固定的正式环境)
如果 Excel 表的业务名称非常明确(例如 '2024Q1' 或 '月度销售汇总'),直接将表名作为字符串传入是最具自解释性的做法。这种方式即使未来有人在 Excel 中插入或挪动了工作表的前后顺序,代码依然能精准读取同名表格。
import pandas as pd

# 按工作表确切名称读取单一表格
file_path = "financial_report.xlsx"
df_q1 = pd.read_excel(file_path, sheet_name="2024Q1")

print(f"数据类型: {type(df_q1)}")
print(df_q1.head(2))订单编号 销售大区 销售金额
0 ORD-1001 华东 24500.0
1 ORD-1002 华北 18200.0
字符串匹配是完全严格匹配的。如果 Excel 标签名中带有首尾空格(例如 "2024Q1 "),传入 sheet_name="2024Q1" 会抛出 ValueError: Worksheet named '2024Q1' not found。遇到报错时,应首先核对标签中是否包含隐藏的空格或特殊字符。
2. 按索引位置读取(适用于表名动态变化或取首表的场景)
pandas 中 sheet_name 默认为 0,表示读取 Excel 底部标签栏从左往右数第 1 个工作表。若需要读取第 2 个工作表,则传入 sheet_name=1,依此类推。
# 读取工作簿中的第一个工作表(与默认参数行为一致)
df_first = pd.read_excel(file_path, sheet_name=0)

# 读取第三个工作表
df_third = pd.read_excel(file_path, sheet_name=2)
按索引读取的优势在于无需关心表名具体叫什么(比如导出的系统报表表名每天都带有随机时间戳)。但缺点是如果人工在 Excel 内部拖动了标签页顺序,原本处于第 2 位的表格移动到第 3 位,代码读取的数据就会发生错位。
三、进阶操作:批量加载多个工作表(按列表与全量读取)
当一个 Excel 文件中存储了不同月份、不同部门或不同区域的同构数据时,逐个编写代码读取不仅繁琐,而且容易产生重复逻辑。此时可以利用列表批量指定,或传入 None 直接载入全簿。
1. 传入列表:定向提取多个指定表格
将需要的工作表标识组合成 Python 列表传给 sheet_name。列表内部元素可以全部为字符串,也可以全部为整数,甚至支持混合类型。此时函数返回一个以列表元素为键、对应 DataFrame 为值的字典。
# 仅读取 Q1 和 Q2 两个工作表
target_sheets = ["2024Q1", "2024Q2"]
sheets_dict = pd.read_excel(file_path, sheet_name=target_sheets)

print(f"返回值类型: {type(sheets_dict)}")
print(f"字典包含的键: {list(sheets_dict.keys())}")

# 通过字典键提取具体的 DataFrame 进行单表观察
df_q2 = sheets_dict["2024Q2"]
print(df_q2.shape)字典包含的键: ['2024Q1', '2024Q2']
(150, 6)
2. 传入 None:动态读取工作簿中的所有有效表格
在不预先知道表格数量与具体命名的情况下,设置 sheet_name=None 是最优雅的解决方案。pandas 会扫描 Excel 文件的整个工作簿,将每一个未损坏的工作表读取并封装进字典中,字典的键即为各工作表的原始名称字符串。
# 载入工作簿中的全部工作表
all_sheets = pd.read_excel(file_path, sheet_name=None)

# 遍历字典打印每个表的行列维度
for sheet_title, df_data in all_sheets.items():
print(f"工作表 [{sheet_title}] 包含 {df_data.shape[0]} 行,{df_data.shape[1]} 列")工作表 [2024Q2] 包含 150 行,5 列
工作表 [2024Q3] 包含 145 行,5 列
工作表 [汇总表] 包含 3 行,5 列
四、常见陷阱与辨析:为什么我的 .head() 会抛出 AttributeError?
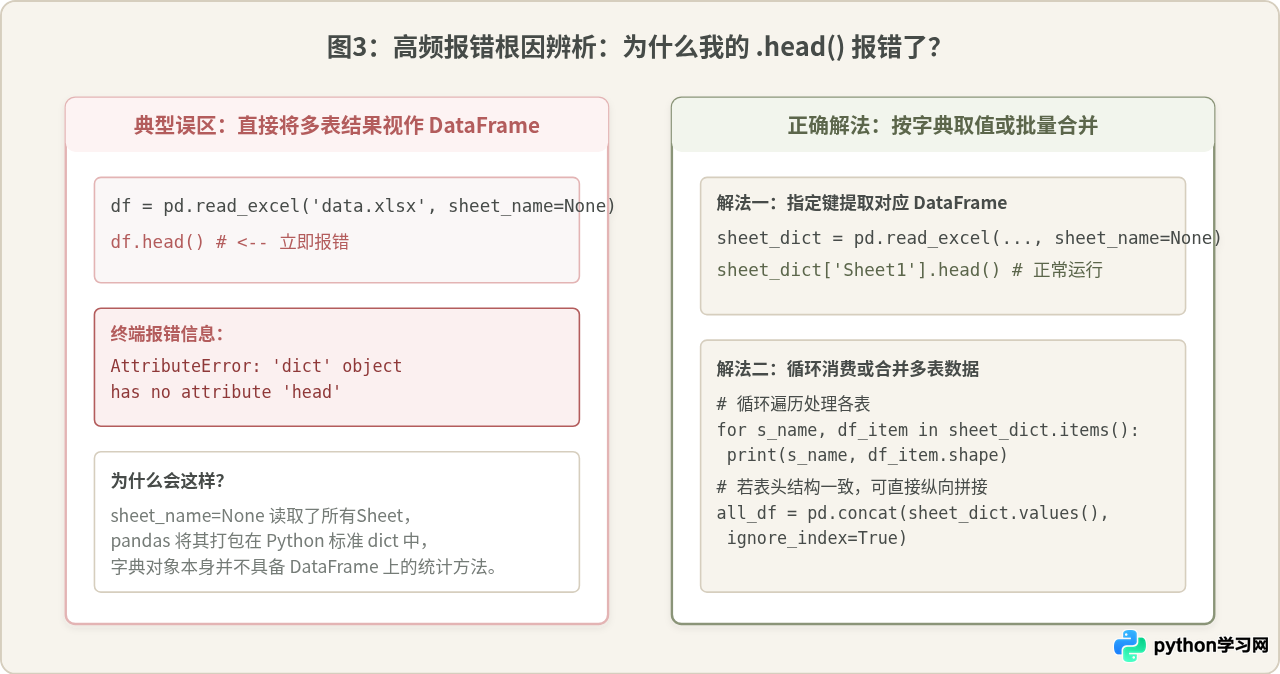
很多开发者在初次尝试 sheet_name=None 时,往往会直接书写如下代码:
# 常见错误写法
data = pd.read_excel("data.xlsx", sheet_name=None)
print(data.head())  # 触发崩溃!
运行后控制台会给出明确的报错:AttributeError: 'dict' object has no attribute 'head'。
产生这个问题的根源在于意识惯性。我们习惯了 read_excel 产出 DataFrame,但由于 sheet_name=None 代表多个并列的数据集,任何通用的表格操作(如 .head()、.info()、.describe())都无法直接作用在字典容器上。要消费这些数据,通常有两种标准处理方式:
- 按需索取:使用键访问对应表,例如
data['Sheet1'].head()。 - 表格合并:若各 Sheet 结构统一(如 12 个月的月度明细),可使用
pd.concat将字典内的所有DataFrame纵向堆叠为一个完整的大表。
多表纵向堆叠的标准代码模版
在合并多表时,如果希望保留数据来自哪个工作表的信息,建议将字典的 keys() 作为新增的层级索引,再通过 reset_index() 将其转化为常规数据列:
# 载入全部表格并合并,同时记录来源 Sheet 名
all_data = pd.read_excel(file_path, sheet_name=None)

# 纵向拼接并赋予层级名称
merged_df = pd.concat(all_data, names=["来源工作表", "行号"]).reset_index(level=0)
merged_df.reset_index(drop=True, inplace=True)

print(merged_df.head(4))0 2024Q1 ORD-1001 24500.0
1 2024Q1 ORD-1002 18200.0
2 2024Q2 ORD-2001 31000.0
3 2024Q2 ORD-2002 12800.0
五、工程最佳实践:使用 pd.ExcelFile 进行轻量预检
直接在生产脚本中执行 sheet_name=None 会一次性将所有工作表装载入内存。对于包含数十个工作表、体积极大的 Excel 文件,这会引起严重的 IO 开销甚至触发内存溢出(OOM)。
更为稳妥且专业的工程做法是:利用 pd.ExcelFile 对象先进行元数据嗅探。pd.ExcelFile 在初始化时仅快速读取文件目录与表名清单,不会立刻解析每一个 Sheet 的具体数据单元格。
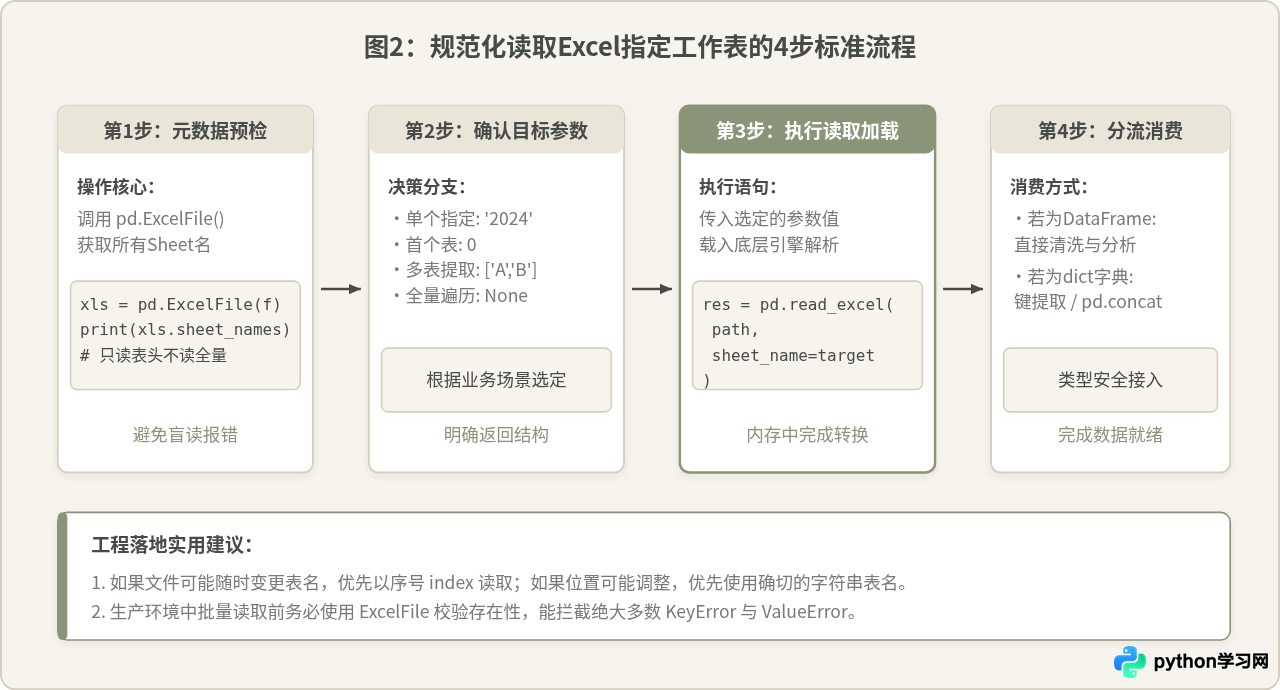
import pandas as pd

excel_path = "large_business_data.xlsx"

# 1. 仅载入工作簿元数据结构,不解析全部数据单元格
with pd.ExcelFile(excel_path) as xls:
    available_sheets = xls.sheet_names
    print(f"工作簿包含的有效工作表: {available_sheets}")

    # 2. 编写防御性过滤逻辑,例如只读取包含 '2024' 的业务表,排除 '说明' 和 '草稿'
    target_sheets = [s for s in available_sheets if "2024" in s]

    # 3. 复用 ExcelFile 对象定向解析目标表,避免重复开启文件流
    clean_dict = {s: pd.read_excel(xls, sheet_name=s) for s in target_sheets}

print(f"成功安全载入 {len(clean_dict)} 个目标表格")
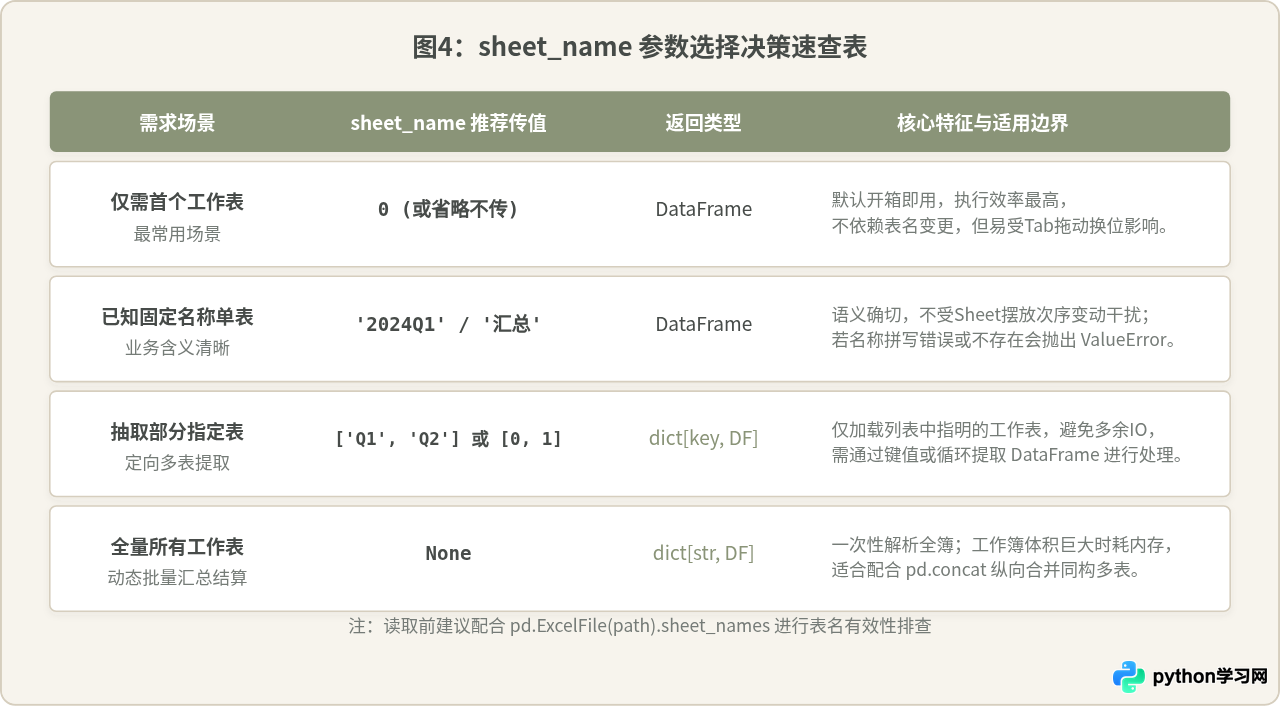
六、sheet_name 参数取值决策速查
为了方便在实际开发中快速选用合适的参数,以下整理了 sheet_name 的各种传参场景与行为对比:
| 传参形式 | 典型代码示例 | 返回对象类型 | 适用业务场景与优缺点 |
|---|---|---|---|
| 默认缺省 / 0 | sheet_name=0 |
DataFrame |
读取首个工作表;书写简洁但易受 Excel 标签拖拽换位影响。 |
| 整数序号 | sheet_name=2 |
DataFrame |
按物理位序读取指定表;适用于表名动态生成但排位固定的场景。 |
| 字符串表名 | sheet_name="明细" |
DataFrame |
语义明确,排位变动不影响匹配;若表名拼写错误会报 ValueError。 |
| 名称/序号列表 | sheet_name=["A", "B"] |
dict[key, DataFrame] |
定向抓取多张特定工作表,按需获取避免冗余 IO。 |
| None | sheet_name=None |
dict[str, DataFrame] |
全量提取所有工作表;适合未知表名或需要全表聚合时使用,注意控制内存。 |
七、总结
pandas.read_excel 中的 sheet_name 参数虽小,但承载了 Excel 单表与多表解析的核心分支。掌握其核心规律只需牢记两点:
- 单输入得单表:传入单个字符串或单个整数,得到的是单个
DataFrame,可直接调用链式数据处理方法。 - 多输入得字典:传入列表或
None,得到的是包含多个DataFrame的字典,需要解包或通过pd.concat合并后再行分析。
在面对大型自动化流程或团队协作文件时,结合 pd.ExcelFile.sheet_names 进行先期名称嗅探与校验,能够将许多不易察觉的路径与格式错误消灭在数据加载阶段。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









