

Python读取Excel文件:pandas与openpyxl库的选择与基础用法
全面讲解Python读取Excel文件的核心方法,对比pandas与openpyxl库的设计定位与适用场景,提供完整的代码示例、常用参数详解、遍历技巧及避坑指南。
一、两个库的核心差异与技术选型依据
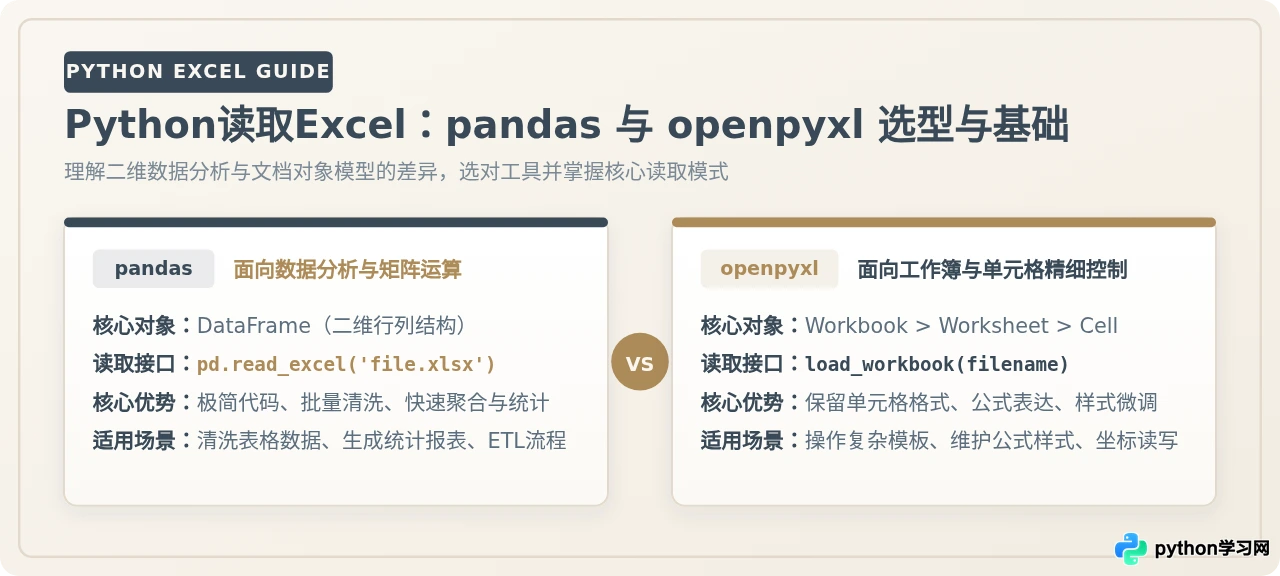
初学者在面对 Excel 文件(尤其是主流的 .xlsx 格式)时,常困惑于为何同一个需求既能搜到 pd.read_excel,又能搜到 load_workbook。根本原因在于两者的设计目标与底层数据模型完全不同。
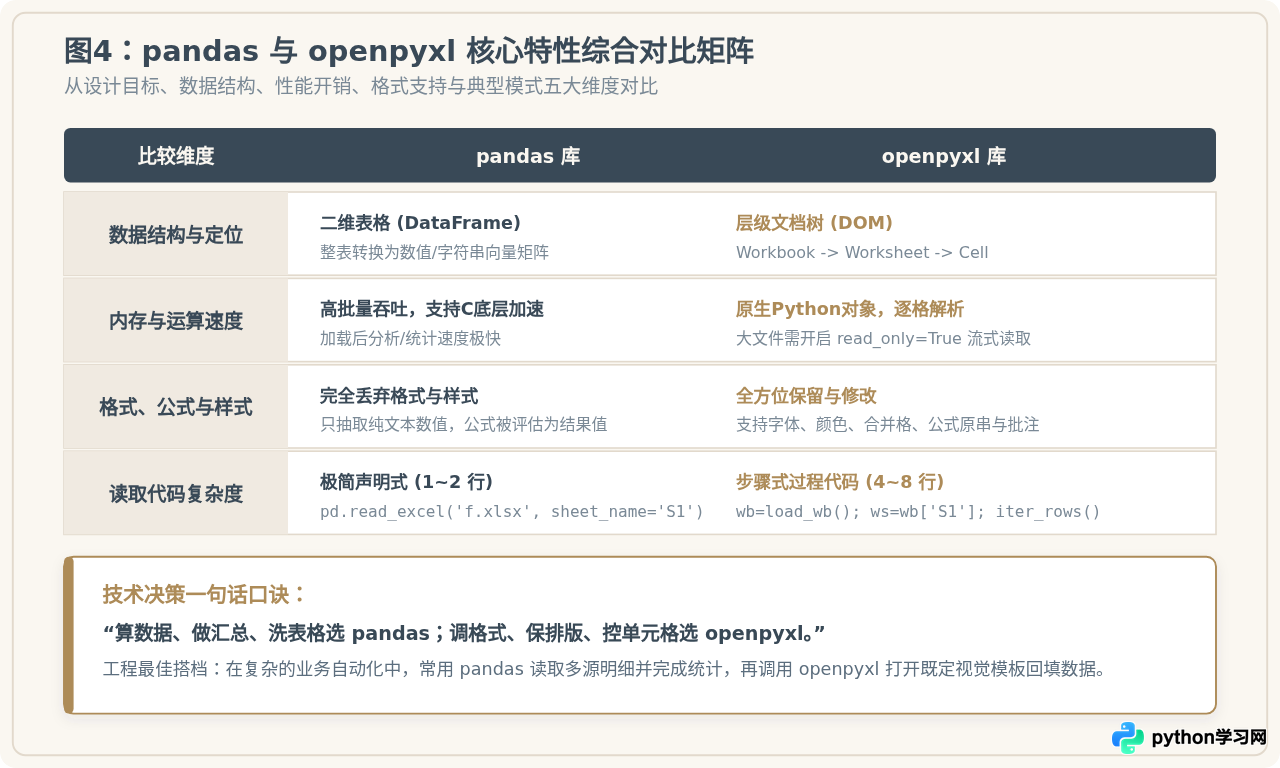
pandas 是面向数据科学设计的分析库。它将 Excel 视作纯粹的“二维关系型数据表”,读取时自动把行列内容打包为 DataFrame 对象。在这一过程中,所有视觉修饰(包括单元格背景色、边框样式、字体大小、冻结窗格)都会被主动剥离,只保留结构化的行列值与列名。这赋予了 pandas 极高的批量统计与过滤效率。
openpyxl 则是严格遵循 Office Open XML 标准实现的文档对象模型(DOM)库。它把工作簿看作一棵完整的对象树(Workbook > Worksheet > Cell)。每一个单元格不仅是一个数值,还包含了数据类型、公式字符串、边框、填充以及批注。openpyxl 的优势在于“精准控制与格式保真”,但对逐个单元格的 Python 原生对象封装也带来了相对较高的内存与遍历开销。
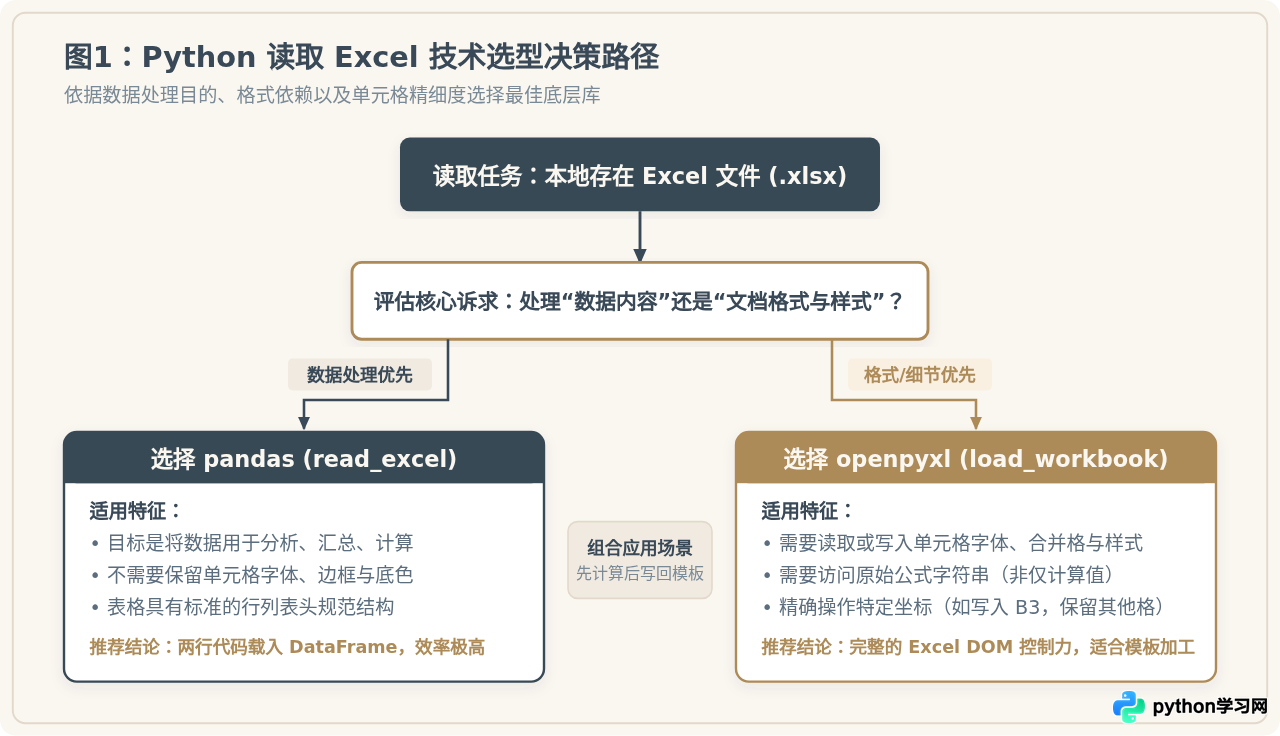
- 选择 pandas:需要从表里提取数据、求均值、按字段分组(groupby)、过滤异常行,或者与其他数据表进行拼接(merge)。
- 选择 openpyxl:需要在固定格式的报表模板里读取某个指定位置的数据(如仅读取
B3与F10),需要识别单元格公式(如=SUM(A1:A10)),或者读取后还要带着原样排版样式回写并发送给他人。
二、运行环境准备与依赖关联
现代 Excel 的主流格式为 .xlsx。在 Python 环境中,pandas 在调用 read_excel() 处理 .xlsx 文件时,底层其实默认调用了 openpyxl 作为解析引擎。因此,最稳妥的实践是同时安装这两个库。
# 在终端或命令行环境安装必要依赖库
pip install pandas openpyxl
安装完成后,可在 Python 代码中分别导入模块:
import pandas as pd
from openpyxl import load_workbookopenpyxl 仅支持 Excel 2007 及更新版本的 .xlsx 和 .xlsm 文件,不支持老旧的二进制 .xls 格式(Excel 97-2003)。若确实需要读取老版本 .xls 文件,需要额外安装 xlrd(且仅限低版本支持)或在 Excel 软件中先转存为 .xlsx。
三、使用 pandas 读取 Excel 的基础用法与核心参数
使用 pandas 读取 Excel 的核心函数是 pd.read_excel()。默认情况下,只需传入文件路径即可快速加载数据:
import pandas as pd

# 最基础的读取方式:默认加载第一个工作表,并将首行作为列索引
df = pd.read_excel('sales_data.xlsx')

# 打印前 5 行数据(示例观察)
print(df.head())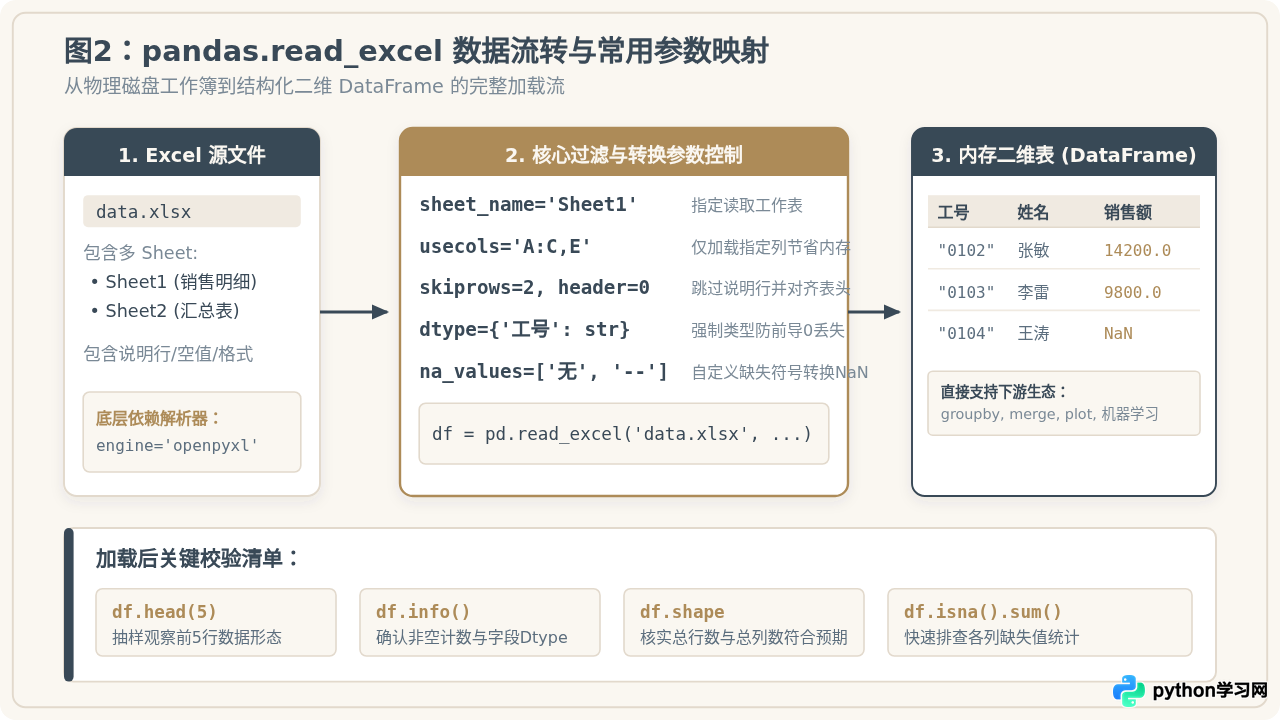
常用关键参数详解
现实中的 Excel 文件往往存在多表混合、首行说明文字、前导零字段被吞等问题。通过配置以下关键参数,可以实现对输入数据的精准把控:
| 参数名 | 典型取值示例 | 功能与解决的实际问题 |
|---|---|---|
sheet_name |
'2026年销售明细' 或 0 或 None |
指定工作表。传入字符串按表名选;传入整数按索引选;传入 None 则把所有 Sheet 读取为一个包含多个 DataFrame 的字典。 |
usecols |
"A:D,F" 或 ['员工工号', '销售额'] |
指定读取列。避免读取全表几十列无用字段,显著降低内存开销。 |
skiprows |
2 或 [0, 1] |
跳过表头前面的多余说明行。例如前两行是“公司内部保密资料”,从第3行才是列标题。 |
header |
0 或 None |
指定哪一行作为列名。若文件本身无表头,应设为 header=None。 |
dtype |
{'工号': str, '身份证号': str} |
强制指定字段类型。防止以 0 开头的编号(如 00123)被自动推导为整数而丢失前导 0。 |
na_values |
['暂无', '待补', '--'] |
自定义缺失值映射。将表格中的特定业务占位字符直接解析为 NaN(缺失值)。 |
典型生产级读取代码示例
import pandas as pd

# 规范化加载:指定工作表、选取指定列、跳过顶部2行、强制指定文本类型
df = pd.read_excel(
    'sales_data.xlsx',
    sheet_name='11月明细',
    skiprows=2,
    usecols='B:F',
    dtype={'员工工号': str, '联系电话': str},
    na_values=['N/A', '--', '暂无']
)

# 数据加载后的质量校验
print("表格维度 (行数, 列数):", df.shape)
print("
各列字段与数据类型概览:")
df.info()
四、使用 openpyxl 读取 Excel 的基础用法与细节控制
当需要感知工作簿的元数据、提取特定单元格坐标、读取计算公式本身时,应当采用 openpyxl。openpyxl 遵循面向对象的层次化操作。
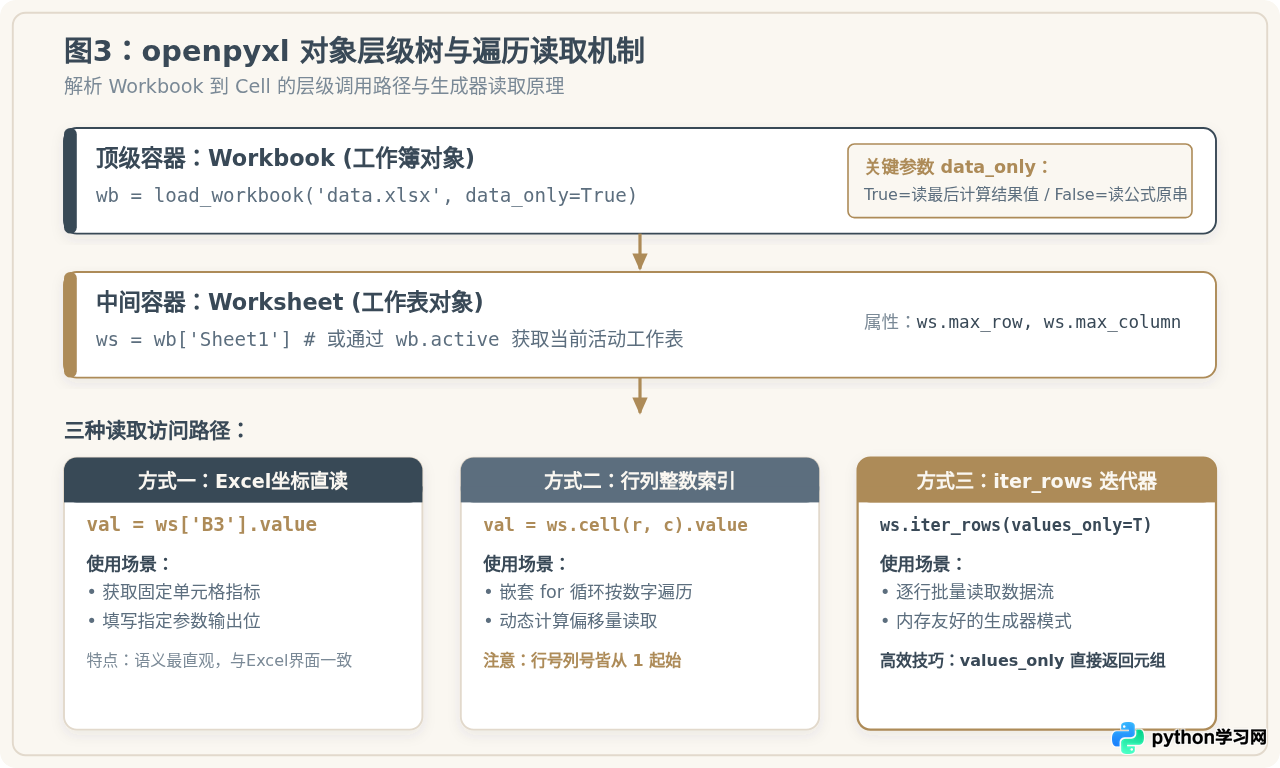
步骤一:加载工作簿与核心参数 data_only
读取工作簿使用 load_workbook() 函数。这里最关键的参数是 data_only:
data_only=False(默认):如果单元格中写有公式(如=SUM(A1:A5)),读取到的是公式表达式字符串。data_only=True:读取该单元格在 Excel 软件上一次保存时计算出的缓存结果值。
from openpyxl import load_workbook

# 载入工作簿,开启 data_only 获取计算值
wb = load_workbook('sales_data.xlsx', data_only=True)

# 查看全部工作表名称
sheet_list = wb.sheetnames
print("工作表列表:", sheet_list)

# 获取指定工作表或当前活动表
ws = wb['11月明细']  # 按照名称选取
# ws = wb.active  # 或直接选取当前活动工作表
步骤二:访问单元格的三种常用方法
1. 按 Excel 坐标直接访问:这是最符合人脑直觉的方式,适合读取离散的固定指标。
cell_a1 = ws['A1']
print("A1的值:", cell_a1.value)
print("A1的数据类型:", cell_a1.data_type)
2. 按行号列号数字访问(基于1起始):适合配合 for 循环按行列步进。
# 注意:openpyxl 的 row 和 column 索引都是从 1 开始的,区别于 Python 常规的 0 起始切片
val = ws.cell(row=3, column=2).value
print("第3行第2列的值:", val)
3. 使用 iter_rows 批量生成器遍历:处理整片数据区域时,iter_rows() 是性能最高、代码最优雅的方案。配合 values_only=True 可以跳过 Cell 对象封装,直接获取纯数值元组。
# 遍历读取第2行到第10行、第1列到第4列的数据
for row in ws.iter_rows(min_row=2, max_row=10, min_col=1, max_col=4, values_only=True):
    # 每一行都是一个 Python 原生元组,如 ('0102', '张敏', '华东区', 14200.0)
    print(row)

# 养成良好习惯:完成读取后关闭工作簿句柄
wb.close()
五、综合对比与生产环境避坑指南
常见问题排查与注意事项
-
问题一:openpyxl 读取带公式的单元格返回
None
原因解释:设置了data_only=True时,openpyxl 并不会自行运行公式计算引擎,它读取的是 Excel 软件在上次保存文件时预存在 XML 缓存里的计算值。如果该文件是由某些第三方程序生成的,而从未在真实 Excel 中打开并点击“保存”,则该缓存值为空。
解决办法:在 Microsoft Excel 或 WPS 中打开该文件并按Ctrl+S重新保存一次;若无需计算值,改用data_only=False读取原始公式。 -
问题二:工号、手机号、身份证号前面的“0”丢失
原因解释:pandas 默认会根据列内数值尝试自动推断数据类型,纯数字组成的字符串容易被推断为int64。
解决办法:在pd.read_excel中明确通过dtype={'字段名': str}强制将其锁定为字符串类型。 -
问题三:超大 Excel 文件(数万行以上)读取缓慢甚至内存溢出
原因解释:openpyxl 默认构建全部单元格对象树,极为消耗内存。
解决办法:使用 openpyxl 时开启只读流模式:load_workbook(filename, read_only=True);或者使用 pandas 时利用参数nrows分段,或转向更底层的calamine引擎加速读取。
在复杂的自动化报表开发中,pandas 与 openpyxl 并不是互斥的,而是互补的。成熟的工程实践通常是:“用 pandas 读取原始明细并进行高速汇总计算,再用 openpyxl 打开预先设计好品牌视觉与排版格式的 Excel 模板,将计算结果填入指定单元格后输出”。这样既兼顾了计算效率,又保留了专业精美的排版效果。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









