

Python NumPy怎么处理含NaN值的数据统计
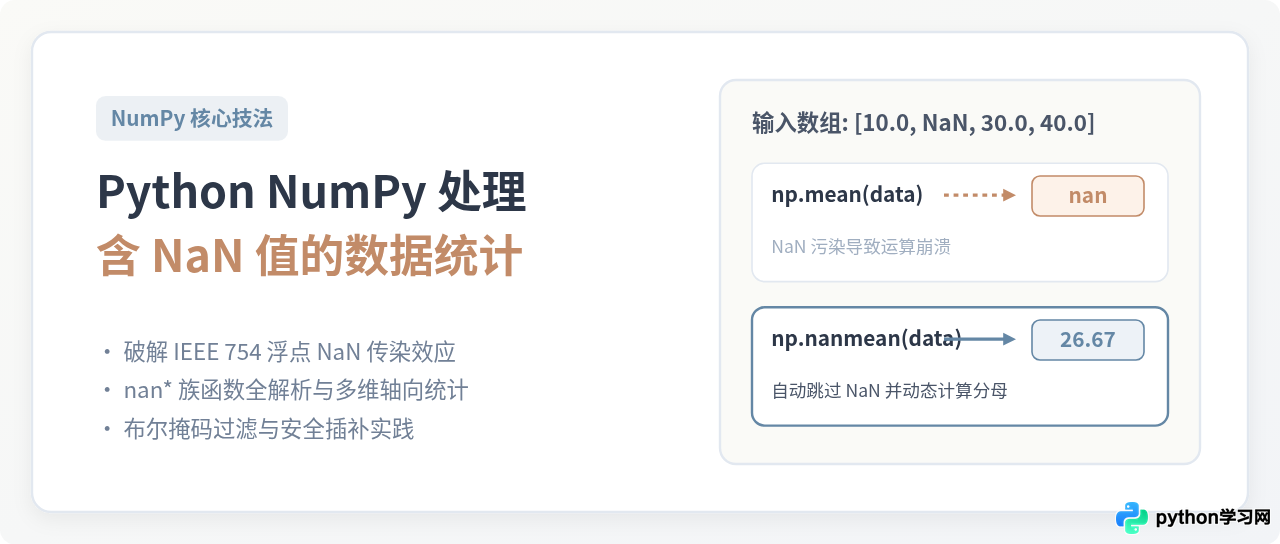
深入讲解Python NumPy处理含NaN值数组的数据统计方法,包括常规函数失效原因、nan*家族函数详解、多维轴向统计、布尔掩码与安全插补等工程实践技巧。
np.mean、np.sum、np.std)只要遇到一个 np.nan,计算结果就会全部变成 nan。最直接且高效的解决方案是使用 NumPy 专门提供的 nan* 系列安全函数(如 np.nanmean、np.nansum、np.nanstd 等),它们在底层会自动跳过缺失值并动态校正有效样本量;对于复杂管道或维度敏感运算,则可以结合 布尔掩码 np.isnan() 提取有效子集,或使用 np.nan_to_num() 进行受控插补。
一、为什么常规统计函数会输出 NaN?
很多刚使用 NumPy 的开发者会遇到一个困惑:原本几十万条正常的数据,仅仅因为混入了几个缺失值,调用 np.mean() 计算出的均值直接变成了 nan。这不是程序崩溃,而是遵循浮点数标准的严格结果。
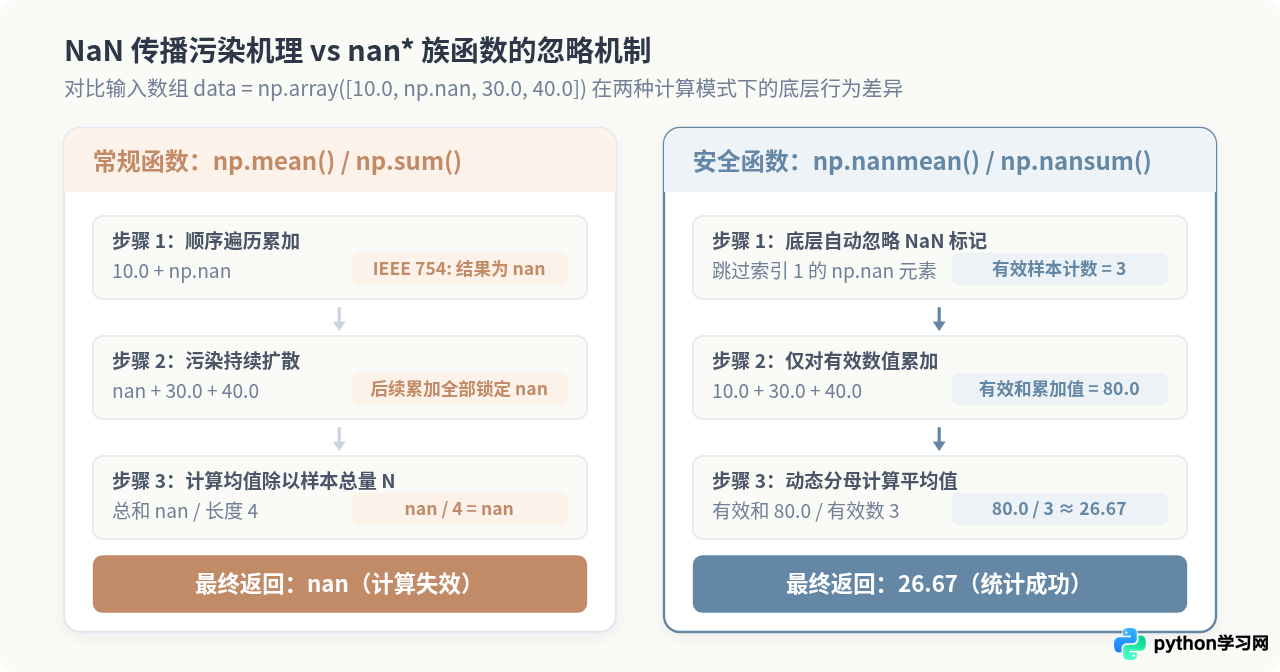
NumPy 中的 np.nan(Not a Number)遵循 IEEE 754 浮点数规范。在该规范中,NaN 具有严格的“污染传染性”(Propagation):任何包含 NaN 的算术运算(加、减、乘、除、比较等),结果一律定义为 NaN。例如:
import numpy as np

# NaN 的基本浮点算术行为
print(10.0 + np.nan)       # 输出: nan
print(np.nan == np.nan)    # 输出: False(根据规范,NaN 不等于自身)
print(np.isnan(np.nan)) # 输出: True(必须使用专用函数检测)False
True
因此,当调用传统的 np.sum() 或 np.mean() 时,底层循环一旦将累加器加上 np.nan,累加器的值便永久锁定为 nan,最终均值也只能得到 nan / N = nan。
二、核心解决方案:使用 NumPy 内置的 nan* 统计函数家族
NumPy 团队针对这类高频需求,在底层 C 扩展中实现了一整套带有 nan 前缀的统计函数。它们在执行聚合运算时,会自动忽略所有 NaN 元素,并且仅根据实际有效元素的数量来计算分母与权重,避免了内存二次拷贝与手动写循环的低效。
1. 求和与连乘:np.nansum 与 np.nanprod
np.nansum() 仅对非 NaN 值求和。如果传入的数组或某个切片全部都是 NaN,为了保持加法单位元的数学一致性,np.nansum 会安全返回 0.0。同理,np.nanprod() 全为 NaN 时返回乘法单位元 1.0。
data = np.array([10.0, np.nan, 30.0, 40.0])

total_sum = np.nansum(data)
total_prod = np.nanprod(data)

print("np.nansum 结果:", total_sum)
print("np.nanprod 结果:", total_prod)np.nanprod 结果: 12000.0
2. 均值与中位数:np.nanmean 与 np.nanmedian
算术平均值是最常受 NaN 影响的指标。np.nanmean() 计算时,分母并不是数组的总长度 len(data),而是实际有效数值的计数 count_valid。在本例中总和为 80.0,有效数据量为 3,均值为 80.0 / 3 ≈ 26.67。
mean_val = np.nanmean(data)
median_val = np.nanmedian(data)

print("np.nanmean 结果:", mean_val)
print("np.nanmedian 结果:", median_val)np.nanmedian 结果: 30.0
3. 标准差与方差:np.nanstd 与 np.nanvar
计算离散程度时,需要特别关注自由度参数 ddof(Delta Degrees of Freedom)。默认情况下 ddof=0,计算的是总体方差;如果要计算无偏样本方差或样本标准差,必须指定 ddof=1。此时分母为 有效样本量 - 1。
std_pop = np.nanstd(data, ddof=0)   # 总体标准差,分母为 3
std_sample = np.nanstd(data, ddof=1) # 样本标准差,分母为 3 - 1 = 2

print("总体标准差 (ddof=0):", std_pop)
print("无偏样本标准差 (ddof=1):", std_sample)无偏样本标准差 (ddof=1): 15.275252316519467
4. 极值与分位数:np.nanmin, np.nanmax 与 np.nanpercentile
在极值检索和箱线图分位数分析中,np.nanmin() 和 np.nanmax() 返回忽略 NaN 后的最小和最大值;np.nanpercentile() 则能准确给出指定百分位(如 25%、75%)的值。
min_val = np.nanmin(data)
max_val = np.nanmax(data)
p75 = np.nanpercentile(data, 75)

print(f"最小值: {min_val}, 最大值: {max_val}, 75分位数: {p75}")三、多维数组与轴向统计(axis 控制与全 NaN 切片)
在实际生产环境中,数据通常以二维表格矩阵或多维张量形式存在。NumPy 的 nan* 函数完全支持 axis 参数,允许我们沿着指定的轴向进行独立的切片降维统计。
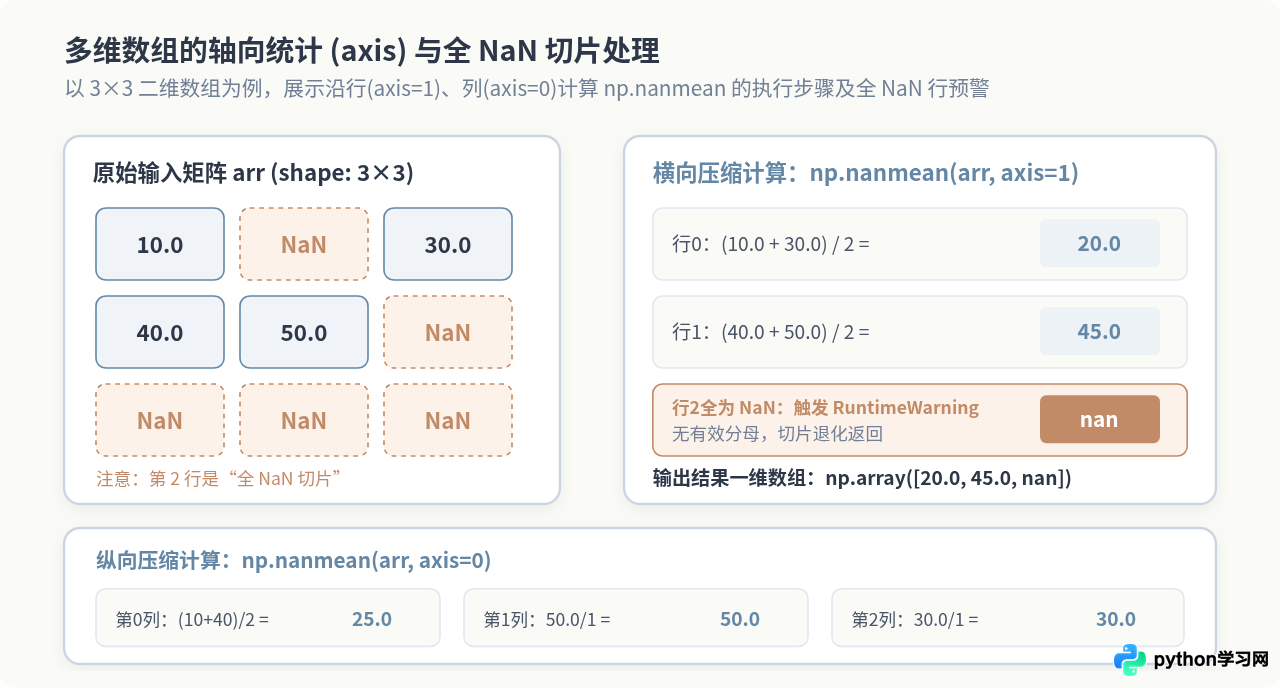
我们构建一个包含“部分缺失”和“整行全缺失”的 3×3 二维数组进行验证:
matrix = np.array([
    [10.0, np.nan, 30.0],
    [40.0, 50.0,   np.nan],
    [np.nan, np.nan, np.nan]  # 全 NaN 切片
])

# 沿 axis=0 (按列统计,跨行压缩)
col_means = np.nanmean(matrix, axis=0)
print("按列均值 (axis=0):", col_means)

# 沿 axis=1 (按行统计,跨列压缩)
row_means = np.nanmean(matrix, axis=1)
print("按行均值 (axis=1):", row_means)RuntimeWarning: Mean of empty slice
按行均值 (axis=1): [20. 45. nan]
np.nanmean 没有可供计算的有效数字,分母为 0。NumPy 会抛出一个 RuntimeWarning: Mean of empty slice(或 All-NaN slice encountered),并将该切片的统计值赋为 nan。如果下游流程不允许出现任何 nan,必须针对这种情况做好缺省值兜底(例如配合
np.nan_to_num)。
保持维度结构:keepdims=True
在做数据标准化或广播计算(Broadcasting)时,直接降维会导致形状从 (3, 3) 变成 (3,),从而无法直接做矩阵减法。此时传入 keepdims=True 可以保持原有轴数:
row_means_2d = np.nanmean(matrix, axis=1, keepdims=True)
print("保持维度的形状:", row_means_2d.shape)  # 输出: (3, 1)
四、进阶与替代方案:布尔掩码过滤与插补填充
虽然 nan* 函数覆盖了绝大多数基础统计场景,但在需要将纯净数据传递给第三方模型(例如 scikit-learn 或自定义复杂数学公式)时,我们需要对数据进行显式的过滤或插补。
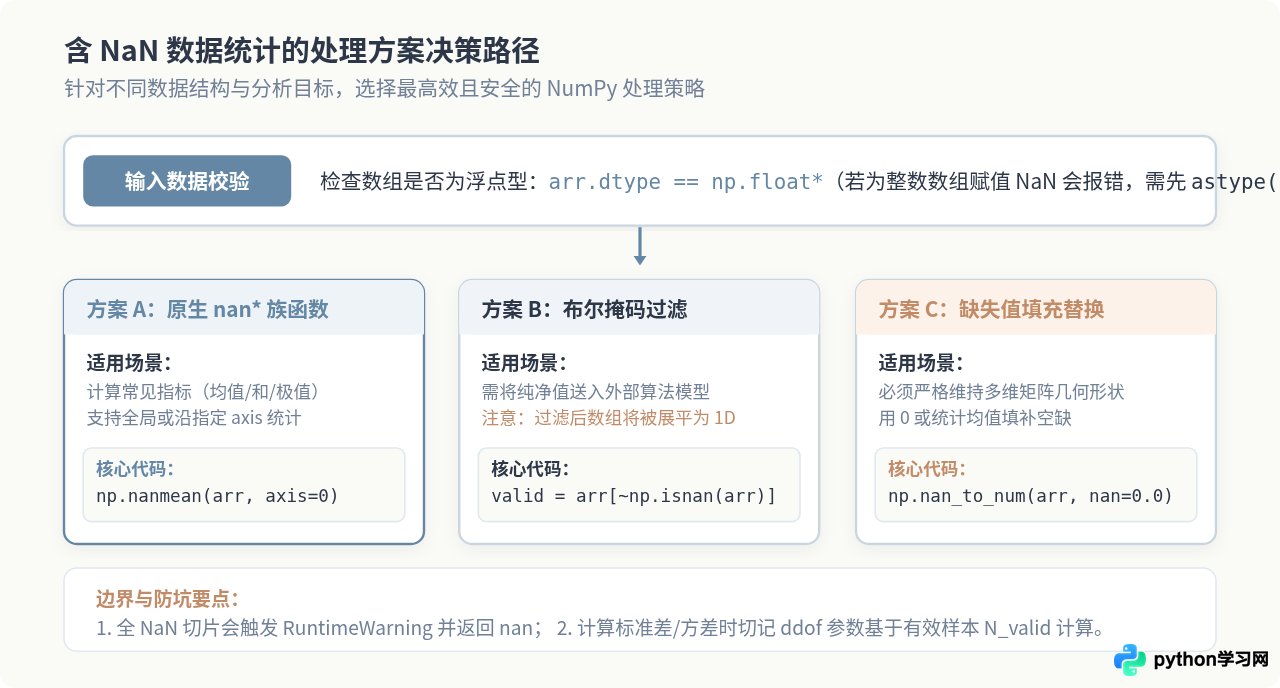
方案 1:布尔掩码过滤有效数据
根据前面提到的 IEEE 754 特性,千万不要写 data[data != np.nan],因为 np.nan != np.nan 永远为 True,这样写无法过滤掉任何 NaN。正确做法是使用 np.isnan() 配合波浪号取反符 ~:
raw_arr = np.array([12.0, np.nan, 25.0, np.nan, 60.0])

# 正确生成非 NaN 布尔掩码
valid_mask = ~np.isnan(raw_arr)
clean_data = raw_arr[valid_mask]

print("有效掩码:", valid_mask)
print("过滤后的纯净数据:", clean_data)
print("常规均值函数直接可用:", np.mean(clean_data))过滤后的纯净数据: [12. 25. 60.]
常规均值函数直接可用: 32.333333333333336
重要限制:在多维数组上应用布尔索引 arr[~np.isnan(arr)] 时,返回值会被强制展平(Flatten)为一维数组。如果业务需要严格保留多维矩阵结构,应采用下述填充方案。
方案 2:安全插补替换(np.nan_to_num 与 np.where)
当多维矩阵的行和列具有特定物理几何意义(如空间网格、图像像素),不能删除元素时,使用替换插补是标准做法:
# 1. 使用固定常数填充 (例如 0.0)
filled_zero = np.nan_to_num(raw_arr, nan=0.0)
print("0值填充:", filled_zero)

# 2. 使用有效均值进行条件插补 (np.where)
mean_val = np.nanmean(raw_arr)
filled_mean = np.where(np.isnan(raw_arr), mean_val, raw_arr)
print("均值填充:", filled_mean)均值填充: [12. 32.33333333 25. 32.33333333 60. ]
五、工程实践避坑指南与速查表
在实际数据处理工程中,关于 NaN 处理还有几个隐蔽的常见陷阱需要引起重视:
-
整数数组无法容纳 NaN:
np.nan是浮点类型(float)。如果尝试向int32或int64类型的 NumPy 数组中赋值np.nan,现代 NumPy 会直接抛出ValueError: cannot convert float NaN to integer。在接收未知数据源时,应确保先转换数据类型:arr = arr.astype(float)。 -
极值索引函数的崩溃边界:
np.nanargmin()和np.nanargmax()用于查找极值所在的下标位置。如果切片全为 NaN,它们不会返回 nan,而是直接抛出 ValueError: All-NaN slice encountered。在调用索引检索前,需先确认切片中至少存在一个有效值。 -
性能考量:在纯 NumPy 数组上,直接调用
np.nanmean(arr)比np.mean(arr[~np.isnan(arr)])运行速度更快,因为前者在底层的 C 循环中完成跳过与计数,不需要在 Python 层分配新的掩码布尔数组和临时切片内存。
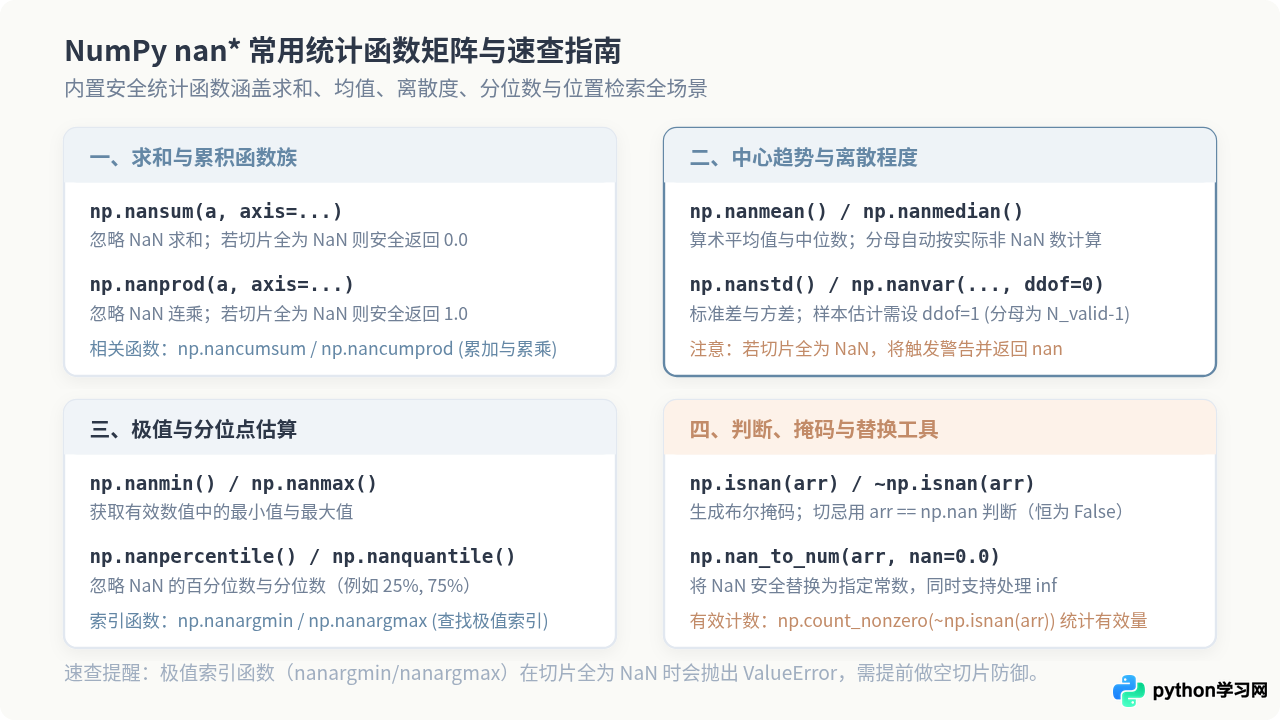
六、常用统计函数对照一览表
| 统计类别 | 标准易受污染函数 | 推荐安全 nan* 函数 | 全 NaN 切片返回值 | 关键参数/注意事项 |
|---|---|---|---|---|
| 求和 | np.sum |
np.nansum |
0.0 | 全空切片返回加法单位元 0.0 |
| 连乘 | np.prod |
np.nanprod |
1.0 | 全空切片返回乘法单位元 1.0 |
| 算术平均值 | np.mean |
np.nanmean |
nan (并抛 Warning) | 分母动态适配实际有效元素数 |
| 中位数 | np.median |
np.nanmedian |
nan (并抛 Warning) | 50% 分位点稳健估计 |
| 标准差 / 方差 | np.std / np.var |
np.nanstd / np.nanvar |
nan (并抛 Warning) | 无偏样本估计必须设置 ddof=1 |
| 极值 | np.min / np.max |
np.nanmin / np.nanmax |
nan (并抛 Warning) | 提取纯净数值范围 |
| 百分位数 | np.percentile |
np.nanpercentile |
nan (并抛 Warning) | 支持多维及指定分位点列表 |
| 极值索引 | np.argmin / np.argmax |
np.nanargmin / np.nanargmax |
抛出 ValueError 异常 | 调用前必须确保至少存在一个有效值 |
总结来说,处理含 NaN 值的 NumPy 统计问题,首选方案是根据统计目标直接选用对应的 np.nan* 函数族;多维矩阵沿 axis 运算时注意全空切片预警;如需送入后续算法管线,则通过 ~np.isnan(arr) 布尔掩码或 np.nan_to_num() 完成数据提纯与填充。掌握这些基础机制与工程细节,即可在绝大多数数值计算与数据分析任务中从容应对缺失值。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









