

scikit-learn1.6的ExtraTrees怎么处理缺失值?
scikit-learn 1.6 版本为 ExtraTrees(极端随机树)带来了原生的缺失值支持。本文深入解析其训练期切分与推理期路由原理、实操分类与回归代码示例、技术选型矩阵及注意事项。
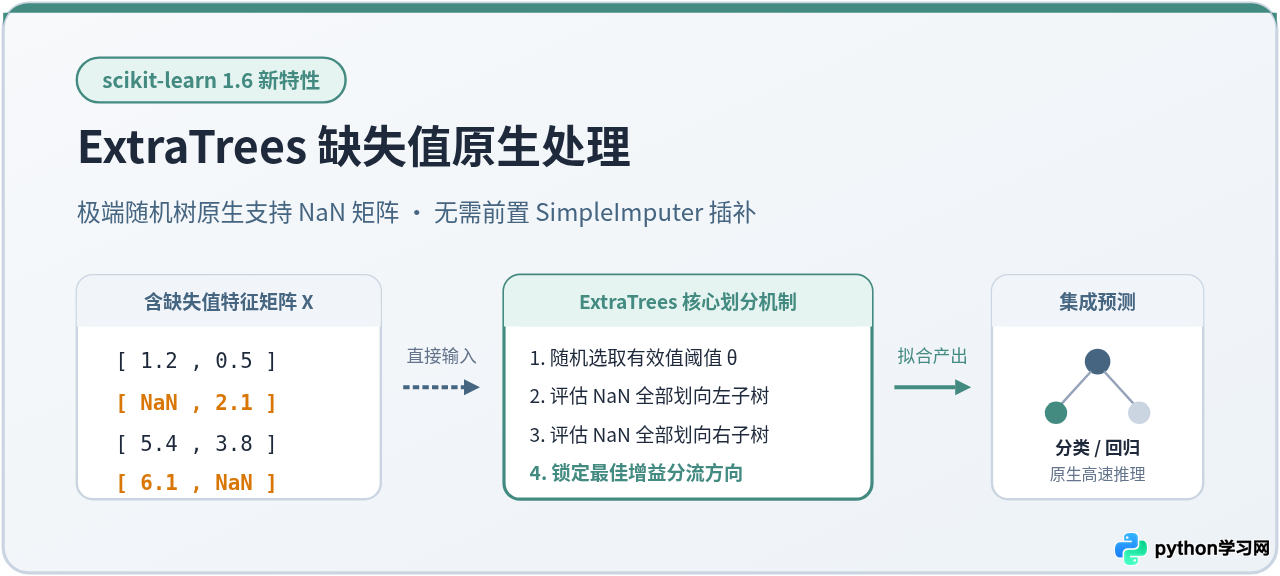
在 scikit-learn 1.6 版本中,极端随机树(ExtraTreesClassifier 与 ExtraTreesRegressor)正式引入了对缺失值(np.nan)的原生支持。这意味着在建模前无需强制使用 SimpleImputer 或 KNNImputer 等插补器,可以直接将含有缺失值的二维数值矩阵输入模型进行训练与预测。本文将具体阐明其背后的分裂评估机制、代码实现步骤、推理期路由规则以及实际项目中的技术选型边界。
一、核心机制:训练阶段的双向分配探索
在以往版本中,向 ExtraTrees 传入包含 np.nan 的特征数组会直接抛出 ValueError: Input X contains NaN。为了兼顾效率与准确性,scikit-learn 1.6 的实现并没有采用全局填充或插值,而是在每个树节点的局部划分阶段,结合 ExtraTrees 特有的“极端随机性”对缺失值进行动态导向。
具体来说,当 ExtraTrees 算法在某个特征上尝试构建切分规则时,完整的计算步骤如下:
- 有效值随机切分:算法首先提取当前节点中该特征的所有非缺失有效值,在其最大值与最小值之间随机抽取一个切分阈值 θ。有效数据据此被自然分成两批:小于等于 θ 的样本预备划向左子树,大于 θ 的样本预备划向右子树。
- 缺失值双向整体试探:对于包含在该特征中的全部
NaN样本,算法不会逐个拆分,而是将其作为一个整体进行两次试探:第一次将所有NaN全部并入左子树;第二次将所有NaN全部并入右子树。 - 增益对比与方向固化:分别计算上述两种尝试下的纯度评价指标(分类任务为基尼系数 Gini、信息增益 Entropy 或对数损失 Log-loss;回归任务为均方误差 Squared Error、弗里德曼均方误差 Friedman MSE 或泊松偏差 Poisson)。哪种试探带来的不纯度减少量(Impurity Gain)更大,就将该方向固化为该节点针对该特征的“最佳缺失走向”(
missing_dir)。若双向增益完全相同,则平局规则默认导向右子树。
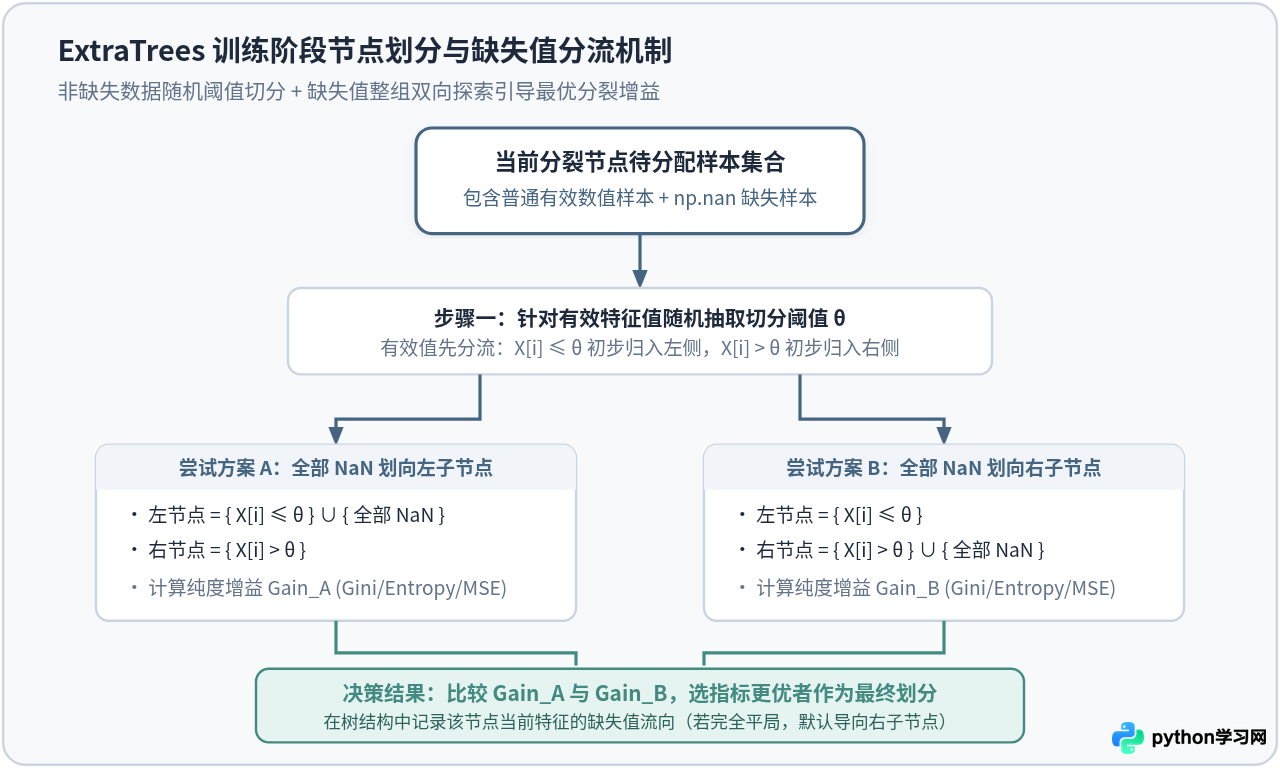
这种机制的优势在于,它将“数据是否缺失”本身视作一种潜在的判别信号。例如在现实业务中,缺失可能代表用户未填写、传感器故障或事件未发生,这种缺失往往带有强烈的倾向性。通过比较两种整体流向的纯度收益,模型能自适应地将缺失样本分配到信息纯度更高的一侧。
二、实践流程:从数据准备到模型推理
理解原理后,在实际项目中应用该特性非常直接。整个开发流程从原先繁杂的“特征清洗 → 插补转换 → 模型拟合”精简为四个紧凑的标准步骤。
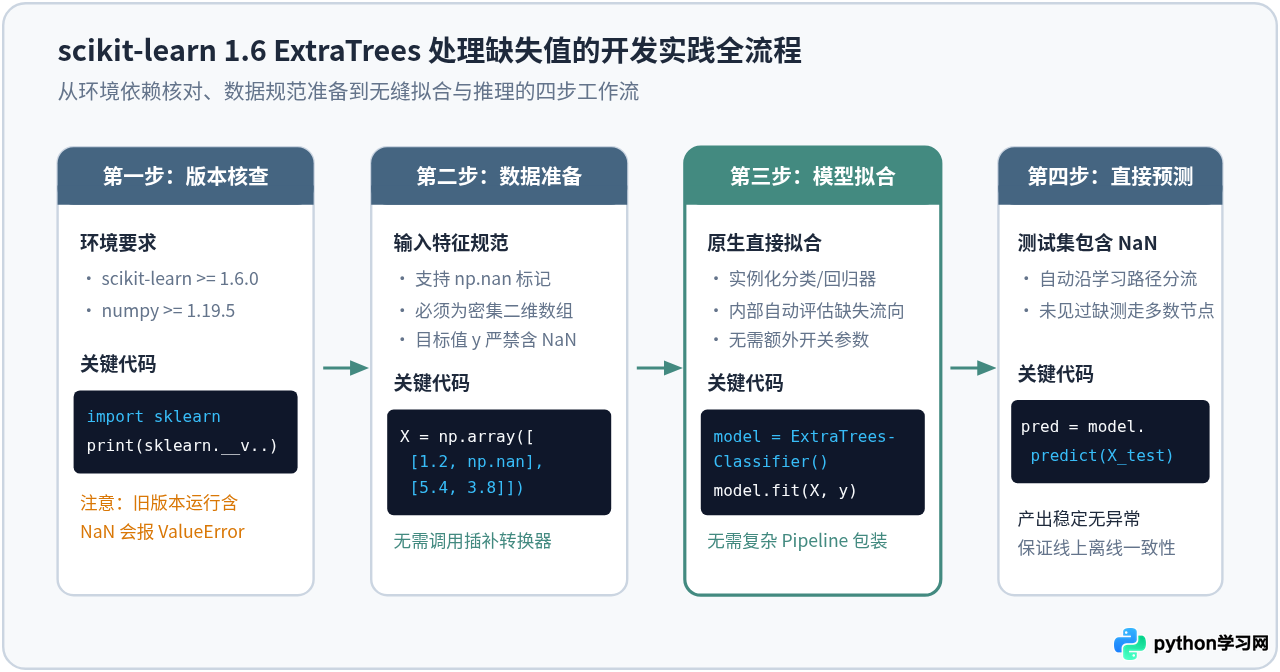
1. 环境要求与前置检查
在编写模型代码前,应首先在 Python 终端或脚本开头核对当前安装的 scikit-learn 版本,确保其不低于 1.6.0。
import sklearn

print("当前 scikit-learn 版本:", sklearn.__version__)
# 若版本低于 1.6.0,需使用 pip install --upgrade scikit-learn 进行更新
2. 分类任务代码示例(ExtraTreesClassifier)
以下代码演示了分类任务中含有 np.nan 的特征矩阵直接用于 ExtraTreesClassifier 拟合与预测的完整过程:
import numpy as np
from sklearn.ensemble import ExtraTreesClassifier

# 构建训练数据:包含 6 个样本、2 个数值特征,其中部分样本含 np.nan
X_train = np.array([
    [1.2, 0.5],
    [np.nan, 2.1],
    [5.4, np.nan],
    [6.1, 8.3],
    [np.nan, 7.9],
    [1.8, 1.1]
])
y_train = np.array([0, 0, 1, 1, 1, 0])

# 初始化分类器,直接拟合,无需配置额外缺失值开关
clf = ExtraTreesClassifier(n_estimators=10, random_state=42)
clf.fit(X_train, y_train)

# 构建包含缺失值的测试集
X_test = np.array([
    [np.nan, 0.8],
    [5.9, np.nan]
])

preds = clf.predict(X_test)
print("测试集分类预测标签:", preds)测试集分类预测标签: [0 1]
3. 回归任务代码示例(ExtraTreesRegressor)
在连续型回归预测任务中,ExtraTreesRegressor 的用法完全相同。模型在每个节点评估连续目标值在缺失样本分流后的均方误差增益:
import numpy as np
from sklearn.ensemble import ExtraTreesRegressor

# 复用特征数据 X_train,构建连续型目标值 y_reg
y_reg = np.array([12.5, 14.0, 35.2, 38.0, 36.5, 13.2])

reg = ExtraTreesRegressor(n_estimators=10, random_state=42)
reg.fit(X_train, y_reg)

reg_preds = reg.predict(X_test)
print("测试集连续值预测结果:", reg_preds)测试集连续值预测结果: [13.25 36.6]
三、推理阶段:测试集遇到缺失值如何流转?
训练好的模型在线上提供服务时,测试样本往往具有不可预知性。当一个新样本被送入树模型进行单步决策时,可能面临两种情形:该特征在训练时遇到过缺失值,或者在训练时完全没有出现过缺失值。ExtraTrees 在这两种情况下的路由规则各有明确定义。
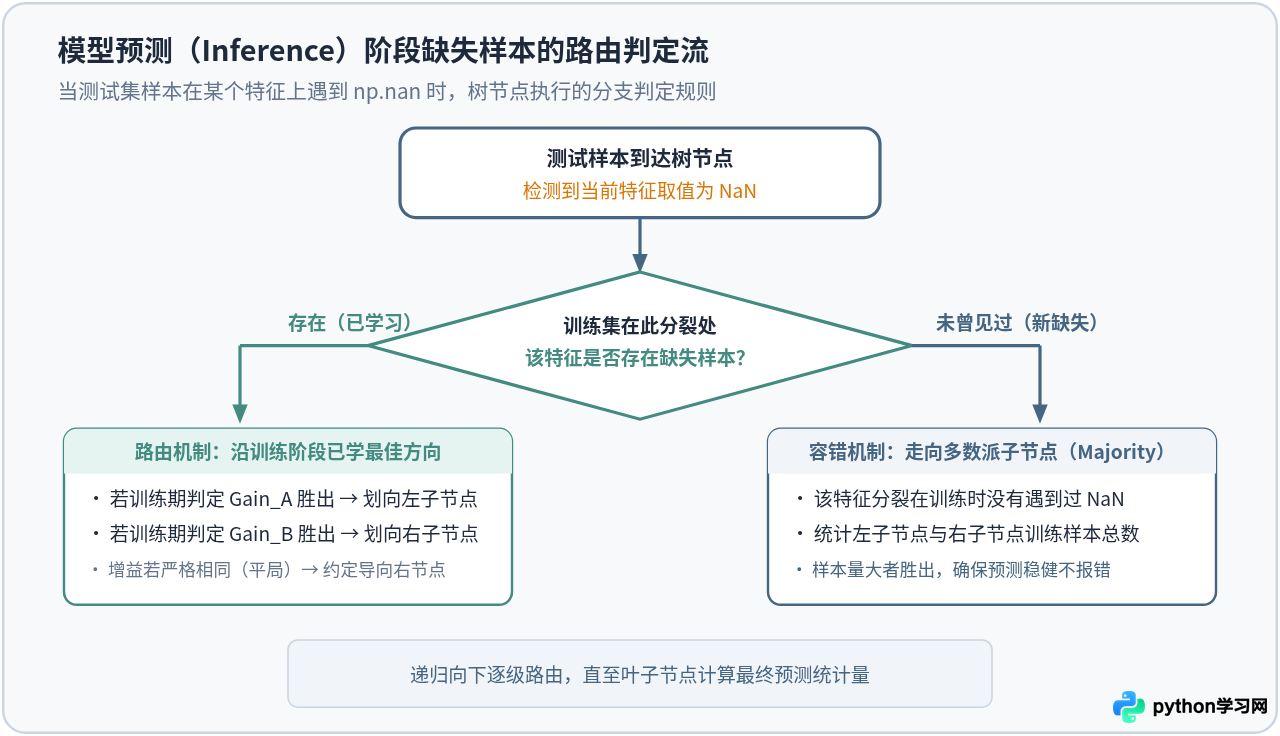
从流向图可以看出,系统设置了清晰的防错分支:
- 已知缺失(常规路径):若训练阶段当前节点的对应特征确实包含缺失样本,模型直接根据训练期记录的最优方向(
missing_dir)将该测试样本送入左子节点或右子节点。 - 未见缺失(多数派降级规则):如果训练时该特征在此节点完全没有缺失值(所有训练样本均为有效数值),树节点在训练期并未学习过
missing_dir。此时若测试样本在推理期出现np.nan,算法会自动启动兜底策略:将该样本导向训练期样本数量较多(Majority)的子节点。若左右子节点样本数一致,同样平局导向右节点。这一策略避免了传统模型遇到未预料缺失直接崩溃的问题。
四、方案对比:原生处理 vs 传统插补方案选型
虽然 scikit-learn 1.6 提供了原生缺失值处理能力,但在构建完整的生产级机器学习系统时,是否使用原生处理需要结合具体的系统架构和业务场景来评估。
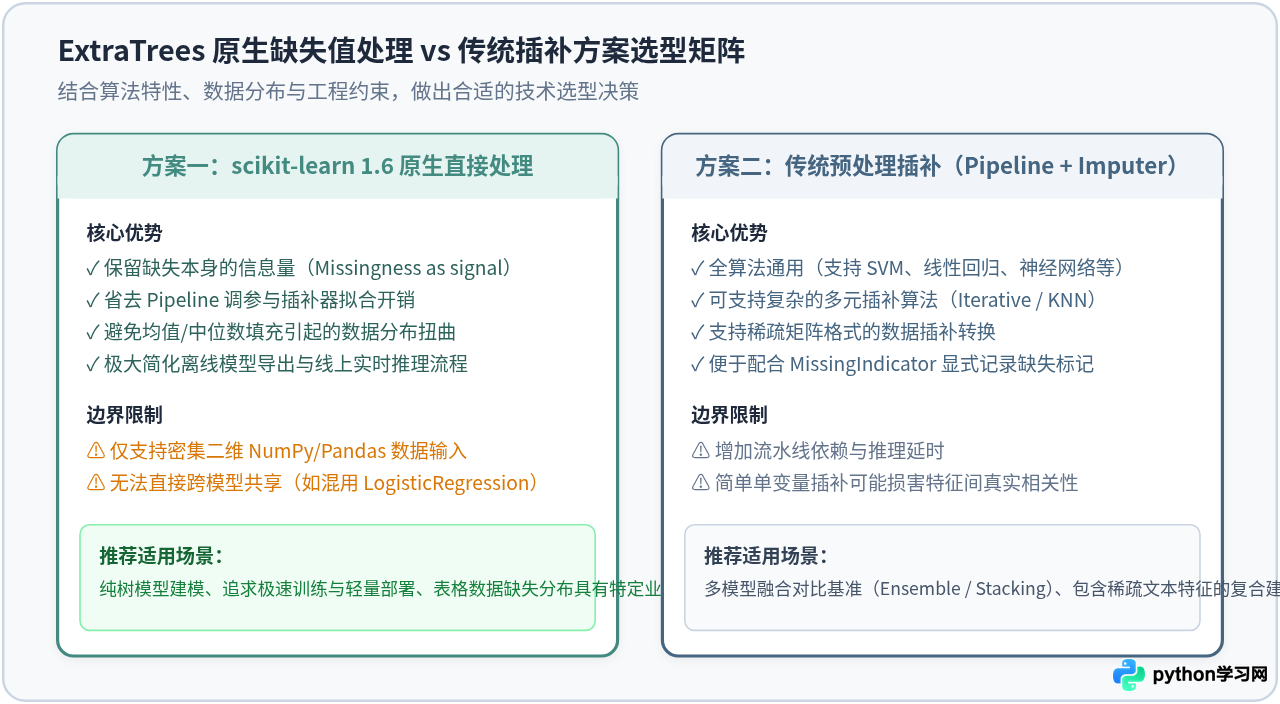
| 评估维度 | ExtraTrees 原生缺失值处理 (1.6+) | 传统预处理插补 (SimpleImputer / KNN) |
|---|---|---|
| 前置依赖 | 零前置依赖,直接传入含 NaN 的稠密矩阵 |
需在 Pipeline 中串联插补器,并对训练/测试集分别 fit/transform |
| 缺失语义保留 | 优秀。缺失值被当做独立分支信号探索纯度增益 | 一般。单一常数或均值填充会平滑数据分布,掩盖缺失本身的信息 |
| 计算开销与延迟 | 极低。仅在切分时做简单的整体分组评估 | 较高。复杂插补(如 KNNImputer、IterativeImputer)显著拖慢拟合速度 |
| 多模型共享能力 | 受限。仅当前树模型生效,无法喂给不支持 NaN 的线性分类器 | 通用。插补后的完整矩阵可供逻辑回归、SVM、神经网络等任意算法复用 |
| 稀疏矩阵支持 | 暂不支持。仅支持二维密集数值数组 | 支持良好。部分插补器可直接处理 scipy.sparse 结构 |
选型结论:
- 如果您的建模管道以 ExtraTrees(或包含 RandomForest / HistGradientBoosting)为主,追求开发极简、运行快速,且希望保留缺失状态本身的业务特征,优先采用原生处理。
- 如果您的系统是一个集成学习系统(Stacking / Voting),下游需要将同一组特征分发给逻辑回归、支持向量机等不具备 NaN 容忍能力的模型,建议继续保留显式预处理 Pipeline,或者仅在树模型分支上采用原生处理。
五、注意事项与易错排查
在实际编写代码和部署时,有几个边界细节需要特别注意,避免产生运行时错误:
原生缺失值支持仅适用于输入特征矩阵
X。无论是分类还是回归,标签 y 中若存在 np.nan 或 None,调用 fit(X, y) 时仍会立即抛出 ValueError。在进入模型前必须剔除标签缺失的样本。
ExtraTrees 原生支持只针对标准的 NumPy 密集数组或 Pandas DataFrame(内部转换为密集 float 数组)。对于文本挖掘等场景产生的
scipy.sparse 稀疏矩阵,如果其中夹带 NaN,底层 C 语言树构建器无法解析,需提前转为密集格式或先进行针对性处理。
如果数据来自 CSV 文件或数据库,可能存在空字符串
""、问号 "?" 或 None 等异构标记。树模型仅识别数值型 float(nan),应提前使用 pd.to_numeric() 或 df.replace() 完成标准化。
总结来看,scikit-learn 1.6 的 ExtraTrees 通过在切分阶段随机阈值下对比缺失样本整体划向左、右子树的纯度增益,实现了无缝且高效的原生缺失值处理。在推理阶段,通过“已学方向优先,未见缺失走向多数派”的容错闭环,彻底摆脱了过去对前置插补器的强绑定,大幅简化了机器学习实战工程代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









