

Python数据导入类的基础设计与实现步骤
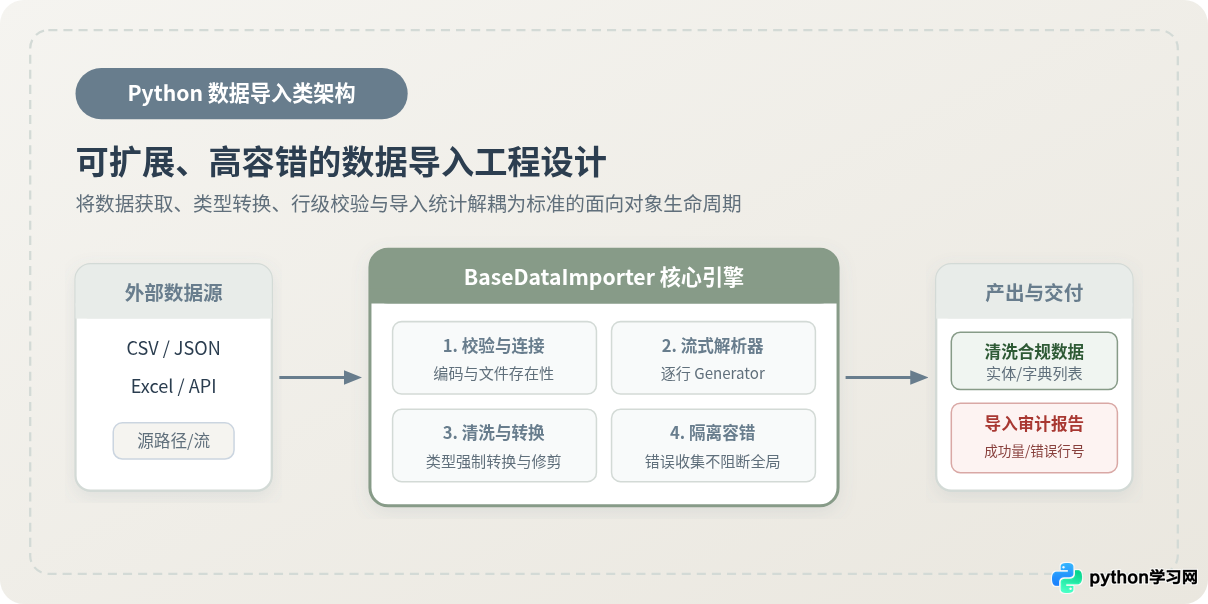
本文系统讲解如何使用面向对象方式设计并实现高内聚、低耦合的Python数据导入类。涵盖职责划分、流式迭代、行级容错、完整代码示例与常见避坑要点。
一、为什么需要将数据导入封装为独立的类
在许多初级项目中,数据导入往往是由一个几十行的函数完成:从 open() 打开文件,到使用 for 循环逐行转换字段,最后直接写入数据库或内存列表。当数据文件格式规范、无脏数据且体积较小时,这种做法确实能够快速完成任务;但随着业务演进,以下三类典型缺陷会迅速暴露:
- 状态混乱与副作用: 函数内部需要维护成功计数、跳过行数、错误详情等多个状态变量,使得函数难以复用或并发调用。
- 全盘崩溃风险: 一旦中间某一行出现空值转换异常(例如对空字符串执行
int("")),整个导入任务即刻中断,前期已解析的数据难以定位和恢复。 - 格式耦合度高: 若数据源从本地 CSV 调整为 JSON 流或远程对象存储,混合了业务清洗逻辑的脚本往往需要全量重写。
面向对象设计的价值在于关注点分离(Separation of Concerns)。通过将数据导入过程拆解为独立类,导入器自身只负责“读取源数据”、“格式归一化”、“字段映射与类型转换”以及“输出审计报告”,具体的持久化存储则交给消费端处理,从而实现高度的模块解耦与容错控制。
二、数据导入类的核心架构与职责划分
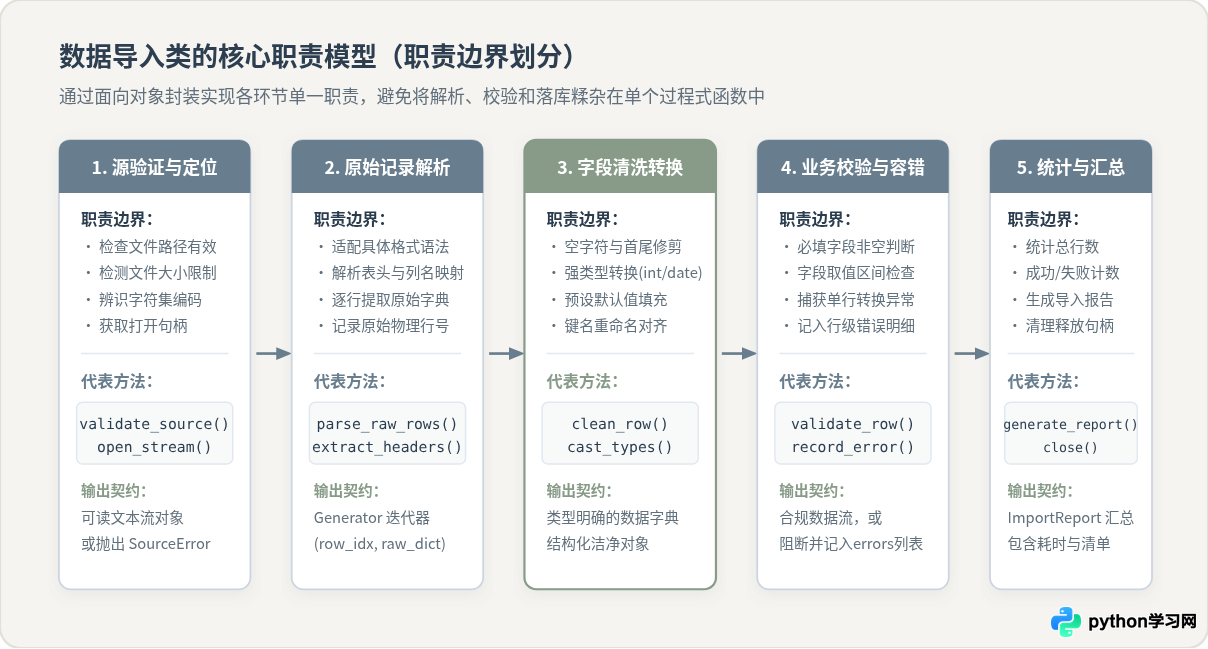
一个经过良好工程设计的 Python 数据导入类,在生命周期内应当严格划分为五个阶段,每个阶段对应一组专职方法:
- 数据源校验与连接(Source Validation): 负责检验输入路径有效性、文件可读权限,并识别文件编码格式(尤其是 Windows 导出的 UTF-8 带 BOM 头场景)。
- 原始记录解析(Raw Row Extraction): 屏蔽不同格式(CSV、TSV、JSON Lines)的底层句柄差异,利用 Python 生成器逐行产出原始字典或序列。
- 字段清洗与类型转换(Cleaning & Transformation): 去除字符串首尾空格、填充缺省值,并将文本类型精确转换为目标 Python 原生类型(如
int、float、datetime.date)。 - 业务规则校验与行级容错(Row Validation & Error Isolation): 执行必填项非空、数值区间等业务规则验证。遇不合规行时捕获异常并记入错误明细,坚决不打断后续行的读取。
- 统计汇总与资源释放(Reporting & Cleanup): 汇总导入总行数、合规行数与失败行数,生成结构化报告,并通过上下文协议确保句柄完全释放。
三、两种实现范式的关键差异:全量载入 vs 流式生成器
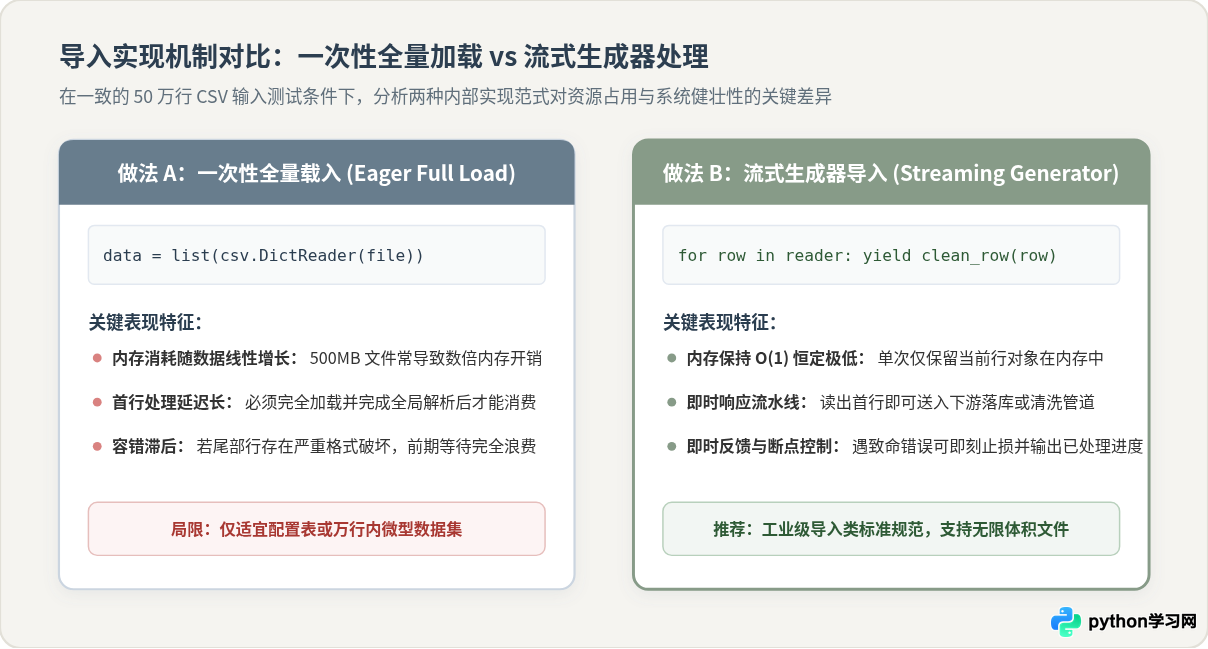
在确定导入类内部数据流时,开发者常常在“一次性载入全部行”与“基于生成器的流式消费”之间做出选择。理解两者的机制差异是设计高性能导入类的关键前提。
| 对比维度 | 做法 A:一次性全量载入 (Eager Full Load) | 做法 B:流式生成器导入 (Streaming Generator) |
|---|---|---|
| 内存开销 | 与文件体积呈严格线性正比。500MB CSV 常因 Python 对象包装膨胀至 1.5GB 以上。 | O(1) 恒定开销。内存中瞬时仅保存单行字典对象,开销通常低于 15MB。 |
| 首行处理延迟 | 高。必须等待整份文件被操作系统完全读入并解析成列表后,下游才能开始处理。 | 极低。打开文件解析第一行后立即 yield 交由下游,流水线即时启动。 |
| 错误排查与止损 | 若第 50 万行触发内存溢出(OOM)或严重格式破坏,前期等待时间全盘损失。 | 遇不可恢复的致命源损坏可立即中断,已处理的行可选择保留或有序回滚。 |
| 适用场景 | 小规模配置文件、总行数在数千行以内且需在内存中进行双向交叉比对的场景。 | 生产级批量数据同步、未知大小报表导入、大数据量后台异步任务(推荐标准)。 |
四、数据导入类的分步实现
接下来,我们将以最常见的 CSV 业务数据导入为例,采用标准库 csv、dataclasses 和 typing,自底向上实现完整的 BaseDataImporter 与派生类 UserCsvImporter。
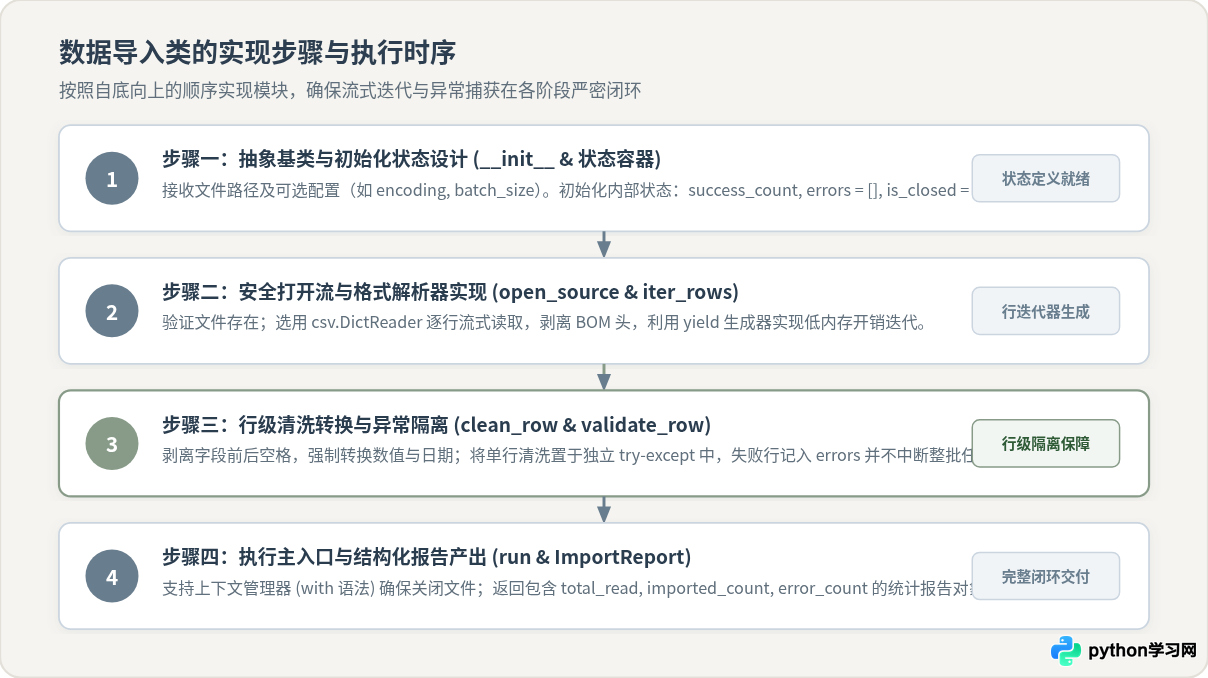
步骤 1:定义导入报告与异常实体
为了保证导入过程的结构化输出,首先定义承载执行结果的实体对象。通过 dataclass 封装每条失败记录的具体行号、原始输入和失败原因,便于调用方做持久化审计或导出错误报告。
from dataclasses import dataclass, field
from typing import Any, Dict, List, Optional
import os
import csv

@dataclass
class RowError:
    line_number: int
    raw_data: Dict[str, Any]
    error_message: str

@dataclass
class ImportReport:
    total_read: int = 0
    success_count: int = 0
    failed_count: int = 0
    errors: List[RowError] = field(default_factory=list)

    @property
    def is_success(self) -> bool:
        return self.failed_count == 0
步骤 2:构建导入器抽象基类与上下文协议
基类 BaseDataImporter 负责封装文件安全检验、打开关闭状态以及行级异常拦截的模版方法(Template Method)。
class BaseDataImporter:
    """数据导入器通用基类"""
    def __init__(self, file_path: str, encoding: str = "utf-8-sig"):
        self.file_path = file_path
        self.encoding = encoding
        self._file_handle = None
        self.report = ImportReport()

    def __enter__(self):
        self.open()
        return self

    def __exit__(self, exc_type, exc_val, exc_tb):
        self.close()

    def open(self):
        if not os.path.isfile(self.file_path):
            raise FileNotFoundError(f"导入源文件不存在: {self.file_path}")
        self._file_handle = open(self.file_path, mode="r", encoding=self.encoding, errors="replace")

    def close(self):
        if self._file_handle and not self._file_handle.closed:
            self._file_handle.close()

    def _read_raw_rows(self):
        """流式产生 (物理行号, 原始字典)"""
        reader = csv.DictReader(self._file_handle)
        for row in reader:
            yield reader.line_num, row

    def clean_and_transform(self, raw_row: Dict[str, str]) -> Dict[str, Any]:
        """由子类实现:清洗字段并转换强类型"""
        raise NotImplementedError

    def validate_row(self, cleaned_row: Dict[str, Any]):
        """由子类实现:业务规则校验,不合规抛出 ValueError"""
        pass
步骤 3:实现流式迭代器与行级异常隔离
在基类中实现 iter_imported_rows() 方法。核心在于:单行在 clean_and_transform 或 validate_row 抛出异常时,仅捕获该行错误并追加到 self.report.errors,随即继续处理下一行,确保整批任务不被打断。
    def iter_imported_rows(self):
        """核心处理管道:逐行清洗、验证并产生合规数据"""
        if not self._file_handle:
            self.open()

        for line_no, raw_row in self._read_raw_rows():
            self.report.total_read += 1
            try:
                # 步骤 A: 字段修剪与类型强转
                cleaned = self.clean_and_transform(raw_row)
                # 步骤 B: 业务规则验证
                self.validate_row(cleaned)

                self.report.success_count += 1
                yield cleaned
            except Exception as e:
                # 步骤 C: 行级隔离,记录错误继续前行
                self.report.failed_count += 1
                self.report.errors.append(RowError(
                    line_number=line_no,
                    raw_data=raw_row,
                    error_message=str(e)
                ))
步骤 4:根据业务扩展具体的导入子类
假设我们需要导入一份用户表格,包含 user_id、username、age 和 email 四个字段。子类只需继承 BaseDataImporter 并实现具体的字段规则:
class UserCsvImporter(BaseDataImporter):
    """具体业务导入类:用户数据导入"""
    def clean_and_transform(self, raw_row: Dict[str, str]) -> Dict[str, Any]:
        user_id_str = raw_row.get("user_id", "").strip()
        username = raw_row.get("username", "").strip()
        age_str = raw_row.get("age", "").strip()
        email = raw_row.get("email", "").strip()

        # 必填校验
        if not user_id_str:
            raise ValueError("user_id 不能为空")
        if not username:
            raise ValueError("username 不能为空")

        # 强类型转换
        try:
            user_id = int(user_id_str)
        except ValueError:
            raise ValueError(f"user_id 必须为整数,当前值: '{user_id_str}'")

        try:
            age = int(age_str) if age_str else 0
        except ValueError:
            raise ValueError(f"age 必须为有效整数,当前值: '{age_str}'")

        return {
            "user_id": user_id,
            "username": username,
            "age": age,
            "email": email.lower()
        }

    def validate_row(self, cleaned_row: Dict[str, Any]):
        if cleaned_row["age"] < 0 or cleaned_row["age"] > 150:
            raise ValueError(f"年龄超出合理范围(0-150): {cleaned_row['age']}")
        if cleaned_row["email"] and "@" not in cleaned_row["email"]:
            raise ValueError(f"电子邮箱格式不合规: {cleaned_row['email']}")
五、运行验证与使用示例
我们准备一份包含正常数据、类型错误数据与业务越界数据的测试文本,验证 UserCsvImporter 的容错与统计能力:
# 模拟测试数据创建与执行
sample_csv_content = \"\"\"user_id,username,age,email
1001,Alice,25,alice@example.com
1002,Bob,abc,bob@example.com
1003,Charlie,32,charlie_invalid_mail
1004,David,29,david@example.com
,Eve,22,eve@example.com
\"\"\"

with open("test_users.csv", "w", encoding="utf-8-sig") as f:
    f.write(sample_csv_content)

# 使用上下文管理器安全调用导入类
valid_users = []
with UserCsvImporter("test_users.csv") as importer:
    for user in importer.iter_imported_rows():
        valid_users.append(user)

# 打印导入结果与错误审计报告
print(f"读取总行数: {importer.report.total_read}")
print(f"成功导入: {importer.report.success_count} 行")
print(f"错误跳过: {importer.report.failed_count} 行")

for err in importer.report.errors:
    print(f"  [第 {err.line_number} 行错误]: {err.error_message} | 原始数据: {err.raw_data}")
执行输出示例:
读取总行数: 5
成功导入: 2 行
错误跳过: 3 行
  [第 3 行错误]: age 必须为有效整数,当前值: 'abc' | 原始数据: {'user_id': '1002', 'username': 'Bob', 'age': 'abc', 'email': 'bob@example.com'}
  [第 4 行错误]: 电子邮箱格式不合规: charlie_invalid_mail | 原始数据: {'user_id': '1003', 'username': 'Charlie', 'age': '32', 'email': 'charlie_invalid_mail'}
[第 6 行错误]: user_id 不能为空 | 原始数据: {'user_id': '', 'username': 'Eve', 'age': '22', 'email': 'eve@example.com'}六、实践中的常见问题与避坑要点
1. Windows CSV 文件的 BOM 字符问题
使用 Microsoft Excel 导出为 CSV 时,软件通常会在文件起始处写入三个字节的 UTF-8 签名(BOM 头:\\xef\\xbb\\xbf)。若在 Python 中使用常规 encoding="utf-8" 打开,第一个列名会变为 \\ufeffuser_id,导致 row["user_id"] 抛出 KeyError。
encoding="utf-8-sig"。Python 会自动检测并透明剥离开头的 BOM 标记,若文件不含 BOM 也会按标准 UTF-8 正常解码。
2. 空字符串与数值类型转换的区别
在 CSV 中,空单元格读出时是空字符串 "" 而非 None。如果直接调用 int(raw_val) 或 float(raw_val),将直接抛出 ValueError。必须显式定义缺失值处理策略:是赋予预设值(如 0 或 None),还是视为空值违规抛出异常。
3. 生成器多次迭代陷阱
生成器(Generator)一旦遍历完毕即耗尽。如果外部调用者既想执行 len(importer.iter_imported_rows()) 又想在随后的 for 循环中消费,第二次迭代将产出空序列。导入类应明确契约:iter_imported_rows() 为单向流式消费接口;若需要全量列表,调用方应显式执行 list(...) 保存,或通过内部 report 查看行数度量。
七、总结
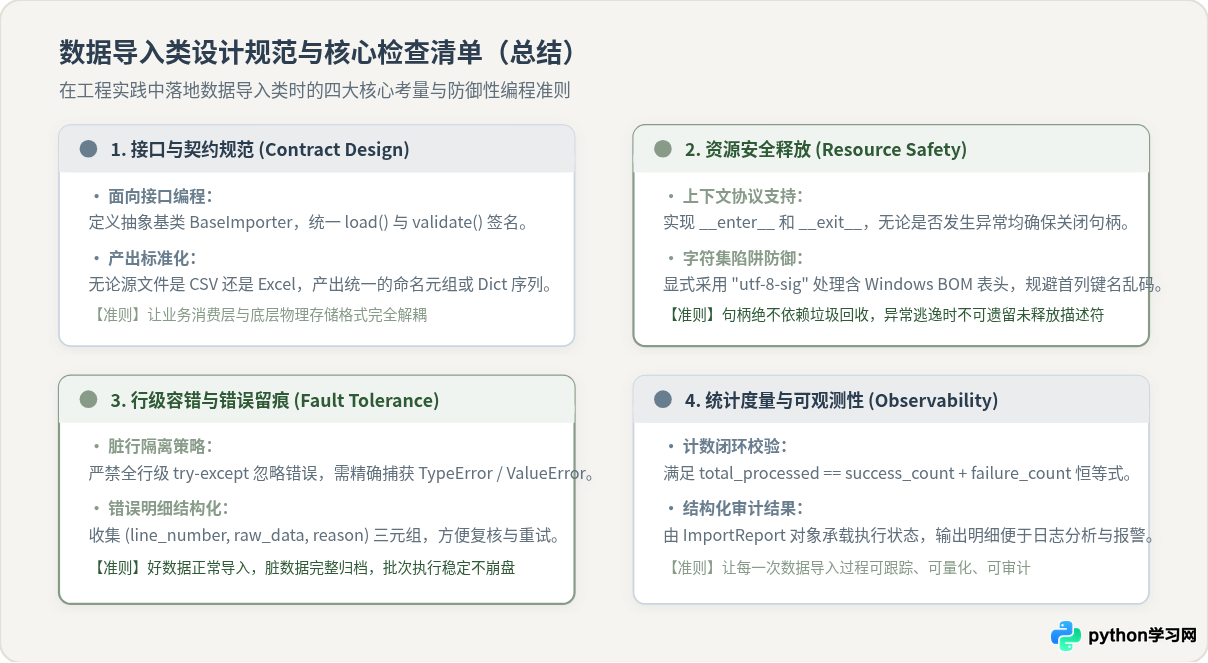
设计并实现一个高可用 Python 数据导入类的核心思路,在于用面向对象的方式确立契约与隔离:
通过 BaseDataImporter 统一生命周期与异常收集机制,使数据读取、业务清洗和审计跟踪各自独立。借助流式生成器将内存消耗稳定在常数级别,同时配合严格的行级异常隔离与上下文管理器,彻底杜绝单行错误导致全量崩溃或资源句柄泄漏的问题。掌握这套结构后,无论是对接 Excel 文件还是多批次消息队列,都能在此骨架上轻松拓展。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









