

Python数据分析常用库有哪些?NumPy、Pandas与Matplotlib分工解析

在构建Python数据分析工作流时,NumPy、Pandas与Matplotlib构成了最核心的基石体系。三者并非彼此替代的竞品,而是按照“底层数值计算、中层数据清洗与组织、顶层结果可视化呈现”形成了明确的上下游协作链条。理解三者的分工边界与调用逻辑,是写出清晰、高效数据分析代码的前提。
一、三大核心库的基础定位与职责分层
面对格式繁多的原始数据,Python原生数据结构(如列表和字典)在内存开销和计算速度上难以支撑大规模批量计算。为了解决性能瓶颈、数据对齐和图形展示问题,Python科学计算生态逐步沉淀出了层级分明的分工体系。
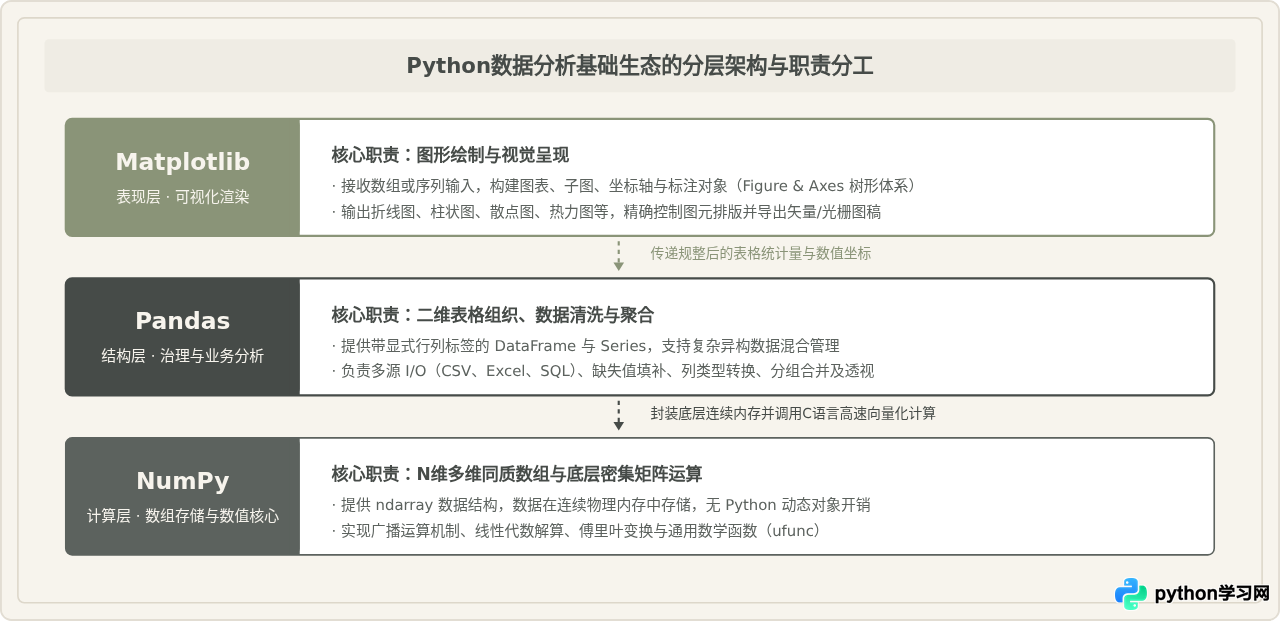
1. NumPy:高性能多维数值运算基石
NumPy 的核心是 ndarray(N-dimensional Array)。在 Python 原生环境中,一个存储整数的列表实际上是存储了一组指针,每个指针指向堆内存中独立的 Python 整数对象,这带来了高昂的内存寻址开销与缓存失效。NumPy 改变了这一模式:它在底层直接开辟一块连续的物理内存,只存放同一种具体类型的原始二进制数值。
这种内存紧凑型结构赋予了 NumPy 两个关键能力:一是支持 CPU 高速缓存与 SIMD 指令集;二是提供向量化计算(Vectorization)与广播机制(Broadcasting),开发者无需在 Python 层书写耗时的 for 循环,底层 C/Fortran 代码会直接执行全量批量运算。
2. Pandas:结构化表格与业务数据清洗专家
尽管 NumPy 运算极快,但在实际业务中,现实数据极少是纯粹的规则数值矩阵。日常业务数据通常具有表头、列名、日期索引、字符串属性与各类缺失标记。NumPy 要求所有数据必须是同质类型,遇到混合列或缺失数据时维护成本极高。
Pandas 正是为了填补这一空缺而生。它在 NumPy 数组之上封装了 DataFrame(二维异质表格)与 Series(一维带标签序列)。Pandas 引入了显式的行索引(Index)与列名标签,使得在处理数据对齐、缺失值填充、时间序列重采样、分组聚合(GroupBy)以及关系表合并(Merge/Join)时,具备直观且符合数据分析直觉的操作接口。
3. Matplotlib:底层图表构建与精准排版工具
经过 NumPy 和 Pandas 运算出的最终指标,需要转化为直观的可视化图表。Matplotlib 是 Python 生态中最悠久、最稳定的绘图引擎。它采用类似于桌面排版软件的“画家模型”(Painter's Model),将图表划分为顶层画布(Figure)、绘图坐标系(Axes)、坐标轴线(Axis)、刻度标记(Tick)以及具体的图元(Line、Bar、Text)。
Matplotlib 既能作为 Pandas 快速绘图的后端驱动,也能脱离上层库独立使用。它允许开发者像素级调整图表中的每一个元素,无论是双 Y 轴对比、复杂的网格跨列布局,还是科研出版物要求的严苛矢量格式,Matplotlib 都能精确交付。
二、协作工作流:一次典型的数据流转步骤
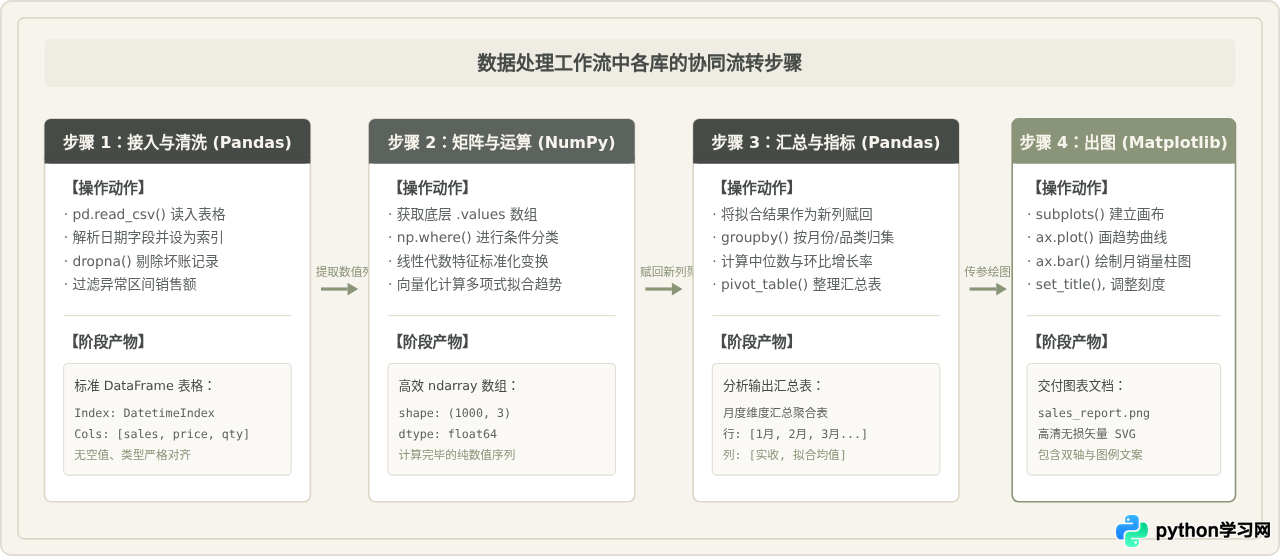
在完整的数据处理任务中,这三个库并非割裂运行,而是按逻辑顺序串行协作。以“电商销售记录的清洗、趋势计算与结果出图”为例,标准处理流转如图 2 所示。
协同代码示例
以下完整代码展示了三者在同一段脚本中的无缝配合:通过 Pandas 组织结构,调用 NumPy 函数生成数值模型,再由 Matplotlib 构建多子图可视化。
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# 1. 使用 Pandas 构建包含日期标签的业务数据框架
dates = pd.date_range("2026-01-01", periods=100, freq="D")
raw_sales = 200 + np.cumsum(np.random.normal(2, 5, 100))  # NumPy生成初始随机游走数据
df = pd.DataFrame({"sales": raw_sales}, index=dates)

# 2. 调用 NumPy 完成特征工程与向量化趋势计算
# 计算移动平均线与边界阈值
sales_array = df["sales"].to_numpy()
moving_avg = np.convolve(sales_array, np.ones(7)/7, mode="same")  # 7天均线
df["moving_avg"] = moving_avg
# 使用 NumPy 条件选择标记异常销售峰值
df["is_peak"] = np.where(df["sales"] > df["moving_avg"] * 1.08, True, False)

# 3. 使用 Pandas 进行聚合汇总
monthly_summary = df.resample("ME").agg({"sales": "mean"})

# 4. 使用 Matplotlib 的面向对象接口精准绘图
fig, (ax1, ax2) = plt.subplots(2, 1, figsize=(10, 8), sharex=False)

# 子图1:日销售波动与异常点
ax1.plot(df.index, df["sales"], label="Daily Sales", color="#464B48", linewidth=1.2)
ax1.plot(df.index, df["moving_avg"], label="7-Day MA", color="#8A9478", linestyle="--")
peaks = df[df["is_peak"]]
ax1.scatter(peaks.index, peaks["sales"], color="#C46D5E", label="Sales Peak", zorder=5)
ax1.set_title("Daily Sales Trend and Outlier Detection")
ax1.legend(loc="upper left")
ax1.grid(True, linestyle=":", alpha=0.6)

# 子图2:月度均值柱状图
ax2.bar(monthly_summary.index.strftime("%Y-%m"), monthly_summary["sales"], color="#8A9478", width=0.5)
ax2.set_title("Monthly Average Sales")
ax2.set_ylabel("Average Amount")

plt.tight_layout()
# 示例:plt.savefig("sales_report.png", dpi=300)
# plt.show()
三、核心数据对象形态与内存机制对比
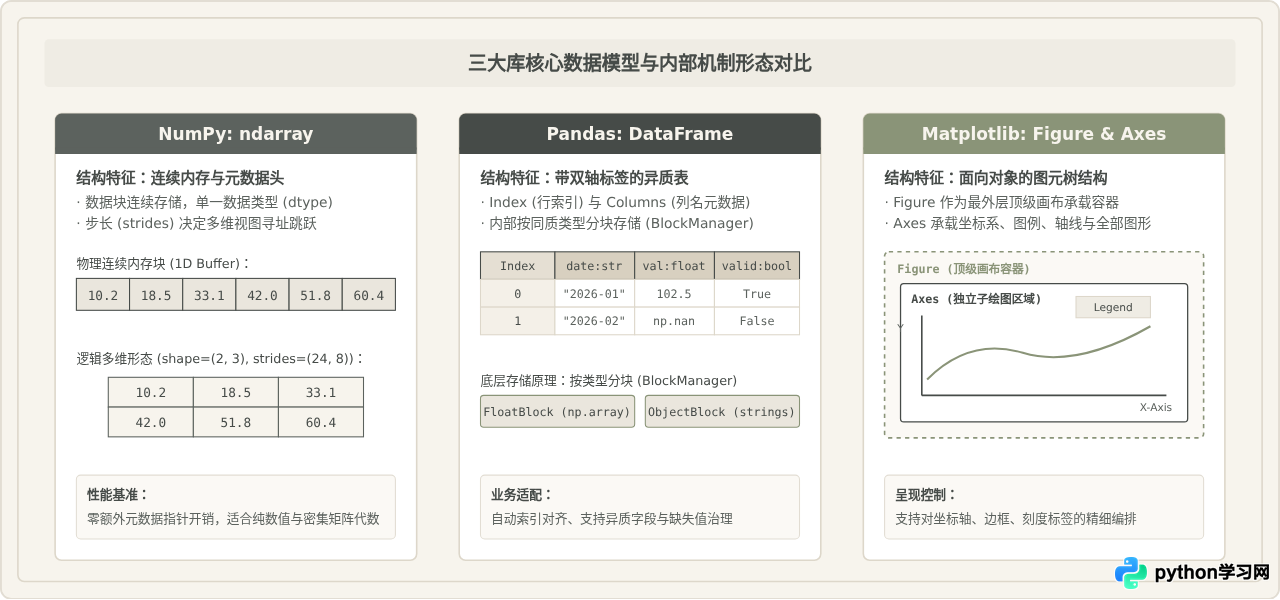
为了在实际开发中避免内存冗余复制或类型降级,必须深入理解三者所持有的底层对象模型。图 3 拆解了它们在内存与对象树层面的结构差异。
四、常见认知误区与说法辨析
在日常学习与实践中,初学者常会对这三个库产生一些看似合乎直觉但并不严谨的误解。厘清这些误区,有助于更清晰地把握工具选型的适用条件。
看似合理之处:Pandas 针对日常绝大多数操作(如计算均值、求和、过滤、分组、缺失值处理)提供了高度封装的 API。在常见的报表统计中,代码中确实常常只有 df['col'].mean() 或 df.groupby(),表面上看不到显式的 import numpy as np。
需要修正之处:这种说法忽略了底层依赖与高级场景:
- 空值底层表示:Pandas 中的标准数值缺失值
NaN本身就是由numpy.nan定义的。类型判断或赋值时(如np.isnan()或条件赋值)依然频繁需要直接调用 NumPy。 - 多条件向量化筛选:当面临复杂的多分支逻辑替换时,Pandas 的
apply()采用纯 Python 循环,性能极低;而使用np.select()或np.where()可以获得数十倍以上的计算性能提升。 - 下游机器学习对接:主流机器学习库(如 Scikit-Learn、PyTorch、TensorFlow)在传入模型训练时,最终都期望接收纯净的
numpy.ndarray。Pandas 在此阶段必须通过.to_numpy()将控制权移交回 NumPy。
看似合理之处:Seaborn 具备更加现代化、色彩优雅的默认主题,并且原生深度集成 Pandas DataFrame,一行代码就能画出分布图或热力图;Plotly 则提供了开箱即用的前端交互式图表。
需要修正之处:高级库与 Matplotlib 不是竞争替代,而是封装与被封装的关系:
- Seaborn 本质上就是 Matplotlib 的高阶封装。绝大多数 Seaborn 绘图函数的返回值就是 Matplotlib 的
Axes或FacetGrid。当需要微调坐标轴字体、添加特定文字注释、双轴重叠或修改画布边距时,调用的依旧是标准的 Matplotlib 方法。 - 在生成脱机报表、PDF 论文、印刷矢量图(SVG/EPS)以及服务端自动化批量静态产图场景下,Matplotlib 的轻量级依赖与确定性排版能力仍是不可替代的基石。
五、三大库选型决策与全景分工总结
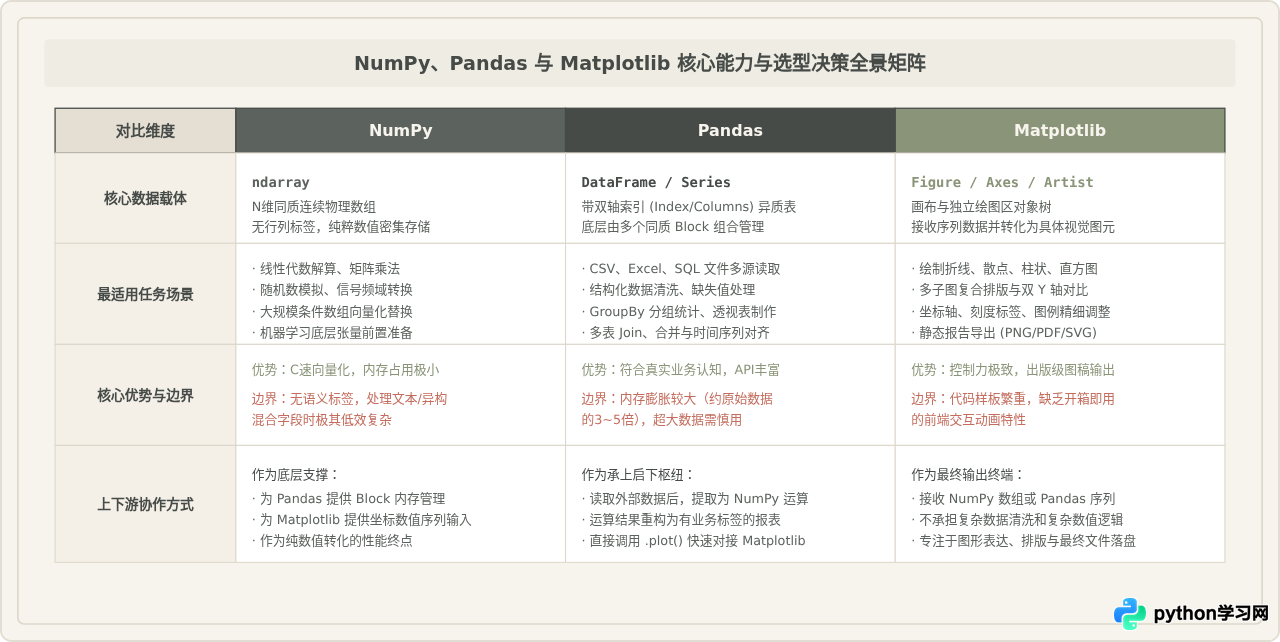
为了帮助读者在面临具体分析任务时快速决策,图 4 与对照表对 NumPy、Pandas 与 Matplotlib 的核心定位、边界限制以及协作关系进行了全景汇总。
总结
在 Python 数据分析体系中,库的选用不是“单选”,而是“组合”。NumPy 保证了计算速度与内存效率,Pandas 降低了处理复杂异质业务数据的认知成本,而 Matplotlib 则负责将晦涩的数字矩阵转化为具有说服力的视觉报告。掌握三者的分工边界,在正确的位置使用正确的工具,是建立专业、健壮数据分析流水线的核心所在。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









