

Python在实际工作中能解决哪些问题?爬虫、量化交易与后端开发案例
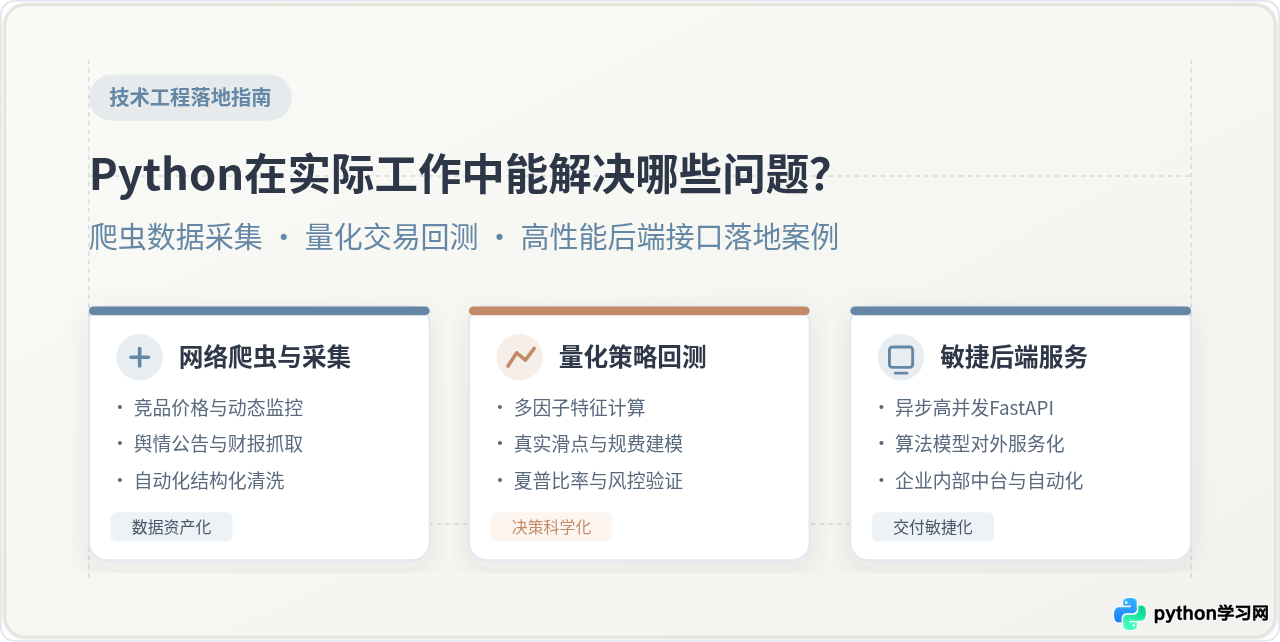
深入解析Python在实际工作中的核心应用场景,结合网络数据采集爬虫、量化策略回测与高性能后端开发三个典型工程案例,阐述其解决的问题、实现代码、架构设计与避坑注意事项。
一、外部数据资产化:网络爬虫解决信息孤岛与非结构化抓取
在企业日常经营中,大量关键决策指标并未以整齐的标准数据接口(API)形式存在于内部数据库中,而是散落在外部网络上。典型业务痛点包括:电商运营团队需要每日实时追踪数十个竞品平台的动态定价与促销策略;金融投研部门需要即时监听上市公司财报披露、监管处罚公告与行业论坛舆情;供应链采销人员需要监控跨国海运运价指数与大宗商品现货牌价。如果依赖人工每日逐页复制粘贴,不仅人力消耗巨大,而且存在严重的滞后性与人为录入错漏。
Python 在该场景下的核心能力,是将散落不可控的公网 HTML/JSON 页面,转化为组织内部可随时查询、比对与告警的结构化数据库记录。借助成熟的 HTTP 客户端(如 Requests、HTTPX)与 DOM 解析器(lxml、BeautifulSoup4),配合针对现代单页应用(SPA)的浏览器自动化工具(Playwright、Selenium),开发者能够以极低的代码成本建立起端到端的自动化抓取流水线。
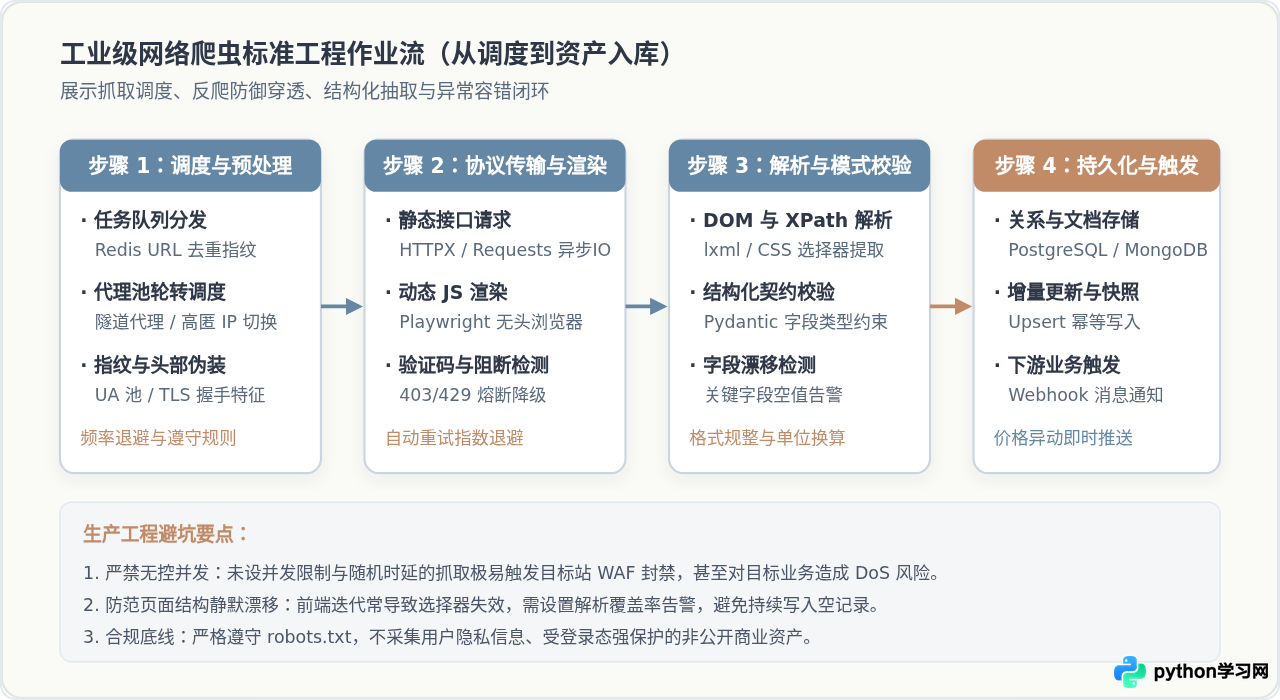
完整工程案例:抗反爬、带契约校验的商品价格监控采集器
工业级采集绝非简单的 requests.get(),它必须包含请求头指纹模拟、连接超时控制、自动重试指数退避,以及基于数据模型的契约校验。以下是一段可直接运行的工程化采集器代码,演示如何从电商列表页抽取商品数据、过滤脏数据并完成结构化验证:
import time
import logging
from typing import List, Optional
import httpx
from bs4 import BeautifulSoup
from pydantic import BaseModel, Field, ValidationError

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

class ProductItem(BaseModel):
    sku_id: str = Field(..., min_length=1, description="商品唯一编号")
    title: str = Field(..., min_length=2, description="商品全称")
    price: float = Field(..., gt=0.0, description="当前实际售价")
    in_stock: bool = Field(default=True, description="库存状态")
    crawl_timestamp: int = Field(default_factory=lambda: int(time.time()))

class RobustPriceCrawler:
    def __init__(self, base_url: str):
        self.base_url = base_url
        self.headers = {
            "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36",
            "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,*/*;q=0.8",
            "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
        }
        # 配置传输层超时限制:连接 5 秒,读取 10 秒
        self.client = httpx.Client(headers=self.headers, timeout=httpx.Timeout(10.0, connect=5.0))

    def fetch_page_with_retry(self, url: str, max_retries: int = 3) -> Optional[str]:
        """带指数退避的健壮页面抓取"""
        for attempt in range(1, max_retries + 1):
            try:
                response = self.client.get(url)
                if response.status_code == 200:
                    return response.text
                elif response.status_code in (403, 429):
                    logging.warning(f"触发反爬风控状态码: {response.status_code},进入退避等待...")
                    time.sleep(attempt * 2.5)
                else:
                    logging.warning(f"请求异常,状态码: {response.status_code},重试第 {attempt} 次")
            except (httpx.ConnectTimeout, httpx.ReadTimeout, httpx.NetworkError) as err:
                logging.error(f"网络层错误: {err},等待重试 {attempt}/{max_retries}")
                time.sleep(attempt * 1.5)
        return None

    def parse_products(self, html_content: str) -> List[ProductItem]:
        """解析 DOM 树并执行 Pydantic 强类型模式验证"""
        soup = BeautifulSoup(html_content, "html.parser")
        items: List[ProductItem] = []

        # 匹配商品列表容器卡片
        product_cards = soup.select(".product-card, .goods-item")
        for card in product_cards:
            try:
                sku = card.get("data-sku") or card.select_one(".sku-label").get_text(strip=True)
                title = card.select_one(".goods-title, .title").get_text(strip=True)
                raw_price = card.select_one(".price-value, .sale-price").get_text(strip=True)
                # 清洗非数字符号,例如 "¥ 1,299.00" -> 1299.00
                clean_price = float(raw_price.replace("¥", "").replace(",", "").strip())
                stock_text = card.select_one(".stock-status")
                in_stock = "缺货" not in (stock_text.get_text() if stock_text else "")

                # 经过强类型校验后实例化,杜绝空字段或脏格式流入下游
                item = ProductItem(
                    sku_id=sku,
                    title=title,
                    price=clean_price,
                    in_stock=in_stock
                )
                items.append(item)
            except (AttributeError, ValueError, ValidationError) as parse_err:
                logging.debug(f"跳过格式畸形的数据项: {parse_err}")
                continue
        return items

    def close(self):
        self.client.close()

# 示例调用流程(可替换为实际监控URL)
if __name__ == "__main__":
    crawler = RobustPriceCrawler(base_url="https://example.com/products")
    # 模拟输入结构化HTML进行单元验证
    mock_html = """
    <div class="goods-item" data-sku="SKU-88901">
      <div class="goods-title">工业级高精度温湿度传感器 RT-100</div>
      <div class="sale-price">¥ 349.50</div>
      <div class="stock-status">现货充足</div>
    </div>
    """
    products = crawler.parse_products(mock_html)
    for p in products:
        logging.info(f"成功清洗并校验商品数据: {p.sku_id} | {p.title} | 售价: {p.price}元")
crawler.close()- 频率退避与并发控制:严禁无间隔发起高并发请求。必须在爬虫调度器中集成随机休眠与滑动窗口限流(如令牌桶算法),否则极易导致目标站 Web 服务器或 CDN 瘫痪,引发法律风险。
- 解析器字段漂移防范:前端代码迭代频繁,类名变更会导致选择器失效。生产流水线中应设置“字段空值率阈值告警”:如果某一批次任务中解析出的有效商品数跌破历史均值的 50%,系统必须立即发出报警并熔断写入,防止数据库被全量空数据覆盖。
- 合规红线:严格遵守目标网站
robots.txt声明,严禁抓取受强身份鉴权保护的用户个人隐私信息、企业商业秘密以及受国家版权法明确保护的内容。
二、量化交易与数据驱动决策:高效率策略回测与风险收益建模
在资产管理、自营交易与个人理财领域,投资人经常面临的核心难题是:如何验证某种交易逻辑是否具有长期的统计学正期望?许多直觉上“合情合理”的交易法则(如均线金叉做多、超跌反弹做多、MACD 底背离抄底),在扣除现实中的交易佣金、滑点冲击与印花税之后,往往呈现出持续的资金净回撤。如果直接拿真实资金进入二级市场试错,资金沉没成本不可逆。
Python 之所以成为全球量化金融领域毋庸置疑的第一语言,原因在于它拥有基于底层 C/Fortran 加速的科学计算底座(NumPy、Pandas、SciPy)。开发者无需手动编写冗长的循环,而是通过向量化运算(Vectorized Operations),在一两秒内即可对数万根日 K 线或高频 Tick 数据完成跨周期的因子生成、仓位模拟撮合与夏普比率计算。从交易假设到回测报告的迭代周期,由传统的数天缩短至数分钟。
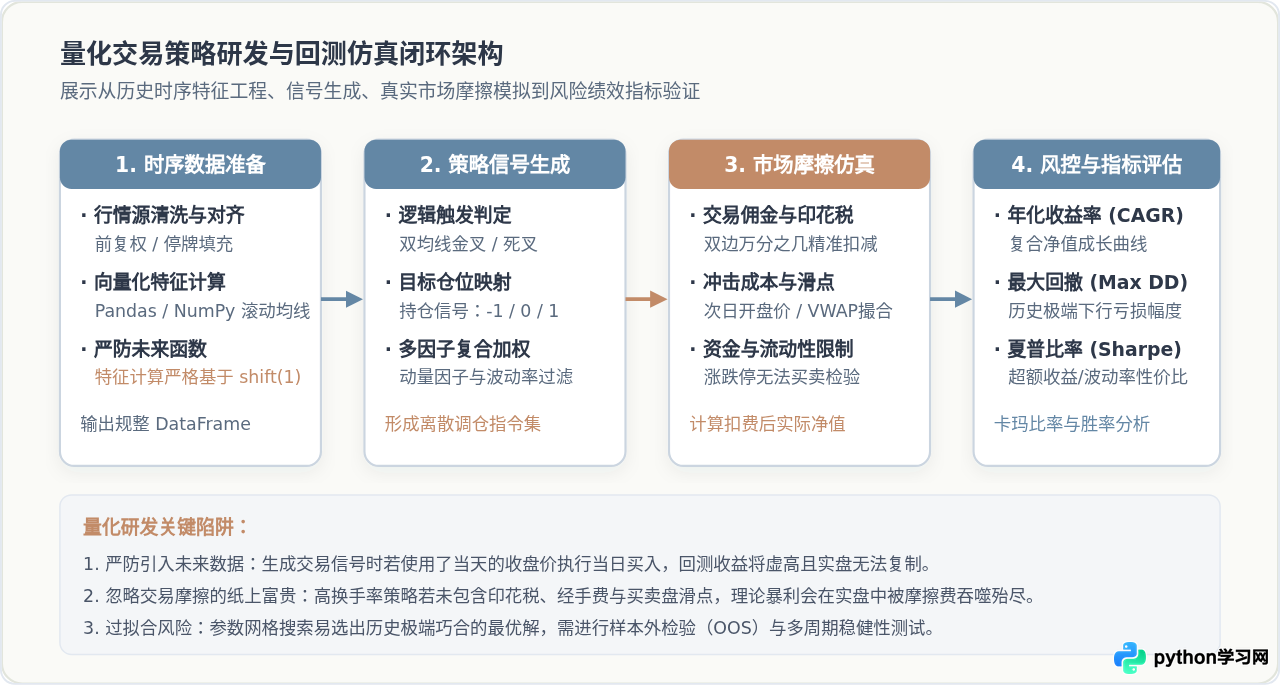
完整工程案例:考虑双边滑点与规费的双均线时序回测引擎
以下代码实现了一个标准向量化回测系统。案例不仅生成经典的短期/长期均线信号,更关键的是模拟了真实世界中的次日开盘调仓延迟、双边交易佣金扣除与最大回撤指标计算:
import numpy as np
import pandas as pd

def run_ma_strategy_backtest(
    df: pd.DataFrame,
    short_window: int = 10,
    long_window: int = 30,
    commission_rate: float = 0.0003, # 万分之三佣金
    slippage: float = 0.0002         # 万分之二滑点
) -> pd.DataFrame:
    """
    输入必须包含 'date', 'close', 'open' 列的时序行情数据。
    严格防范未来函数:当日收盘产生信号,次日开盘价执行调仓。
    """
    data = df.copy()
    data.sort_values("date", inplace=True)
    data.reset_index(drop=True, inplace=True)

    # 1. 向量化计算技术指标
    data["ma_short"] = data["close"].rolling(window=short_window).mean()
    data["ma_long"] = data["close"].rolling(window=long_window).mean()

    # 2. 生成理论目标持仓信号 (1: 持仓多头, 0: 空仓)
    # 当短期均线上穿长期均线时做多,下穿时平仓
    data["raw_signal"] = 0
    data.loc[data["ma_short"] > data["ma_long"], "raw_signal"] = 1

    # 3. 严格消除未来数据:信号产生于 T 日收盘,执行于 T+1 日,因此持仓信号向后平移 1 期
    data["actual_pos"] = data["raw_signal"].shift(1).fillna(0)

    # 4. 计算每日基础资产对数收益率
    data["pct_change"] = data["close"].pct_change().fillna(0)

    # 5. 计算调仓动作与摩擦成本 (买入与卖出均触发摩擦费)
    data["trades"] = data["actual_pos"].diff().abs().fillna(0)
    total_cost_per_trade = commission_rate + slippage
    data["friction_cost"] = data["trades"] * total_cost_per_trade

    # 6. 计算扣除摩擦后的策略实际日收益率
    data["strategy_ret"] = (data["actual_pos"] * data["pct_change"]) - data["friction_cost"]

    # 7. 累计净值曲线 (初始基准为 1.0)
    data["cumulative_ret"] = (1.0 + data["strategy_ret"]).cumprod()
    data["benchmark_ret"] = (1.0 + data["pct_change"]).cumprod()

    # 8. 向量化计算历史峰值与回撤曲线
    data["peak"] = data["cumulative_ret"].cummax()
    data["drawdown"] = (data["cumulative_ret"] - data["peak"]) / data["peak"]

    return data

def evaluate_performance(result_df: pd.DataFrame, trading_days: int = 252) -> dict:
    """评估年化收益率、夏普比率与历史最大回撤"""
    final_nav = result_df["cumulative_ret"].iloc[-1]
    n_days = len(result_df)

    # 复合年化增长率 (CAGR)
    cagr = (final_nav ** (trading_days / n_days)) - 1.0

    # 日波动率年化
    daily_vol = result_df["strategy_ret"].std()
    annual_vol = daily_vol * np.sqrt(trading_days)

    # 无风险利率假定为 2% (0.02)
    risk_free = 0.02
    sharpe = (cagr - risk_free) / annual_vol if annual_vol > 0 else 0.0

    max_dd = result_df["drawdown"].min()

    return {
        "最终累计净值": round(final_nav, 4),
        "年化收益率(CAGR)": f"{cagr * 100:.2f}%",
        "年化波动率": f"{annual_vol * 100:.2f}%",
        "夏普比率(Sharpe)": round(sharpe, 2),
        "历史最大回撤(MaxDD)": f"{max_dd * 100:.2f}%",
    }

# 构造模拟行情数据运行回测
if __name__ == "__main__":
    np.random.seed(42)
    dates = pd.date_range("2023-01-01", periods=250, freq="B")
    # 模拟几何布朗运动价格走势
    returns = np.random.normal(0.0006, 0.015, 250)
    price = 100.0 * np.exp(np.cumsum(returns))

    sample_data = pd.DataFrame({
        "date": dates,
        "close": price,
        "open": price * (1 + np.random.normal(0, 0.002, 250))
    })

    results = run_ma_strategy_backtest(sample_data, short_window=5, long_window=20)
    metrics = evaluate_performance(results)

    print("=== 量化策略回测绩效评估报告 ===")
    for k, v in metrics.items():
print(f"{k}: {v}")- 未来函数(Look-ahead Bias):量化代码中最隐蔽也最致命的逻辑错误。例如使用当天的收盘价计算出均线信号后,立即以当天收盘价撮合成交。在现实中,收盘价只有在收盘瞬间才能确立,此时已无法申报委托。必须通过
shift(1)强制信号次日撮合。 - 流动性与滑点模型失真:小市值标的或极端行情下,挂单簿深度极浅。若回测时假设能无限制按最新报价全额成交,实盘时市价单会直接打穿买卖盘口,导致严重滑点。
- 参数过拟合(Overfitting):通过网格搜索穷举 1000 组参数挑出的“完美均线组”,往往只是对历史噪声的刻舟求剑。必须划分训练集(In-Sample)与样本外测试集(Out-of-Sample),并进行跨资产标的的泛化检验。
三、轻量级与敏捷后端开发:基于 FastAPI 的高并发业务接口服务
企业后端研发场景极为多样:不仅有跨国电商平台的超大型分布式核心交易系统,更有成百上千个支撑日常业务运转的微服务接口、AI/算法模型服务化(Model Serving)、内部中台与自动化管理控制台。如果每个轻量级服务都采用重量级框架(如 Java Spring Boot),在开发初期需要编写大量样板代码、复杂的依赖注入配置以及繁琐的打包构建流程,极大拖慢了新业务的原型验证节奏。
现代 Python(自 3.8+ 引入成熟类型注解与原生 async/await 协程)彻底重塑了后端开发范式。以 FastAPI 为代表的现代化异步框架,底层依托性能极高的 uvicorn(基于 uvloop 事件循环)和由 Rust 编写核心引擎的 Pydantic v2,在保持单文件快速上手的极简体验同时,实现了接近 Node.js 与 Go 的单机并发 I/O 处理能力,并且能够自动生成符合 OpenAPI/Swagger 标准的交互式接口文档。
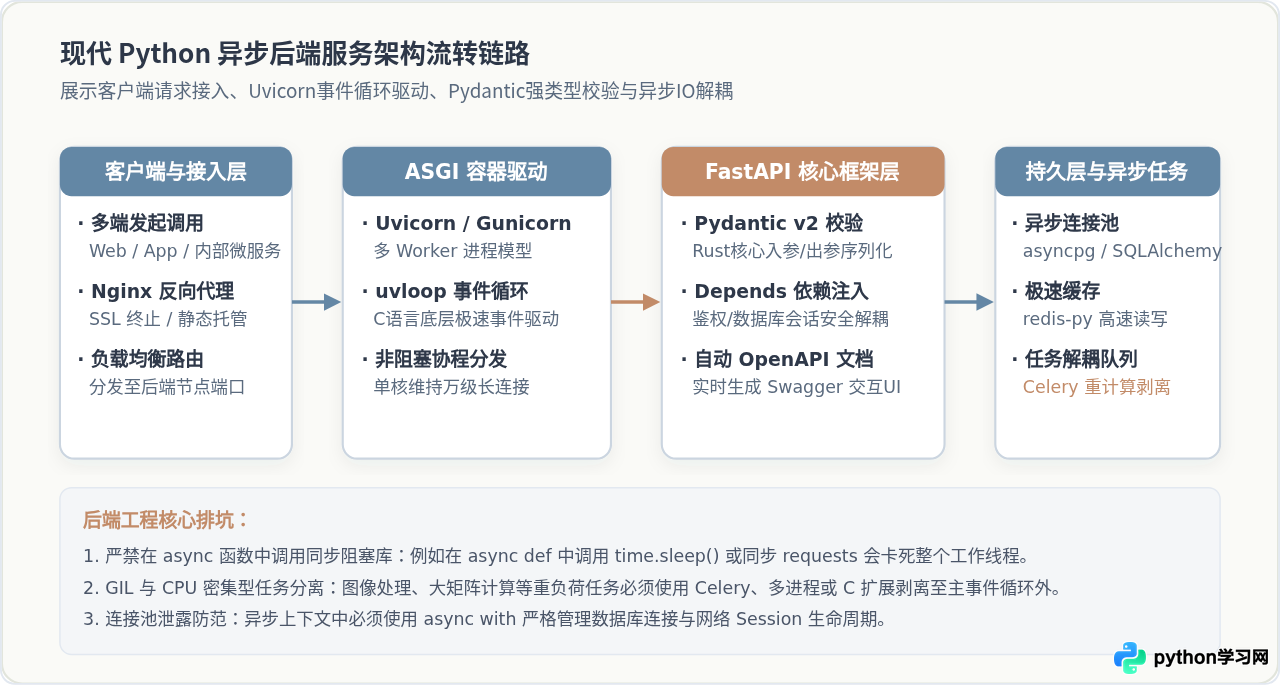
完整工程案例:带输入校验、生命周期管理与异步模拟查询的 FastAPI 服务
以下代码展示了一个可直接作为独立微服务运行的 Python API 后端。包含标准数据模型约束、全局异常处理拦截以及异步非阻塞处理:
from contextlib import asynccontextmanager
from typing import Dict, List, Optional
from fastapi import FastAPI, HTTPException, status, Query
from pydantic import BaseModel, Field

# 1. 契约定义:定义请求入参与响应出参模型
class OrderCreateRequest(BaseModel):
    user_id: str = Field(..., min_length=3, max_length=32, description="用户唯一ID")
    sku_id: str = Field(..., min_length=1, description="商品编号")
    quantity: int = Field(..., gt=0, le=99, description="购买数量 (1-99)")
    coupon_code: Optional[str] = Field(None, max_length=16, description="优惠券抵扣码")

class OrderResponse(BaseModel):
    order_id: str
    user_id: str
    sku_id: str
    total_amount: float
    status: str
    created_at: int

# 2. 模拟内存存储与连接生命周期
db_storage: Dict[str, dict] = {}

@asynccontextmanager
async def lifespan(app: FastAPI):
    # 应用启动时的资源初始化(如创建数据库异步连接池、连接 Redis 缓存)
    print("[System] 初始化异步数据库连接池与Redis客户端...")
    yield
    # 应用关闭时的资源清理(优雅关闭连接,防止文件句柄泄露)
    print("[System] 释放数据库连接池资源,等待挂起协程退出...")
    db_storage.clear()

# 3. 实例化核心服务
app = FastAPI(
    title="工业级自动化订单服务",
    description="演示现代 Python 在微服务 API、参数校验与异步IO中的落地实现",
    version="1.0.0",
    lifespan=lifespan
)

@app.post(
    "/api/v1/orders",
    response_model=OrderResponse,
    status_code=status.HTTP_201_CREATED,
    summary="创建业务新订单"
)
async def create_order(request: OrderCreateRequest):
    """
    异步订单创建接口:
    Pydantic 会在进入函数体前自动校验请求体 JSON,非法格式直接返回 422 错误。
    """
    import time
    import uuid

    # 模拟单价查询计算
    unit_price = 199.0
    total = unit_price * request.quantity
    if request.coupon_code == "DISCOUNT20":
        total = max(0.0, total - 20.0)

    order_id = f"ORD-{uuid.uuid4().hex[:10].upper()}"
    order_record = {
        "order_id": order_id,
        "user_id": request.user_id,
        "sku_id": request.sku_id,
        "total_amount": round(total, 2),
        "status": "PAID",
        "created_at": int(time.time())
    }

    # 异步非阻塞持久化操作
    db_storage[order_id] = order_record
    return order_record

@app.get(
    "/api/v1/orders/{order_id}",
    response_model=OrderResponse,
    summary="查询单笔订单详情"
)
async def get_order_detail(order_id: str):
    record = db_storage.get(order_id)
    if not record:
        raise HTTPException(
            status_code=status.HTTP_404_NOT_FOUND,
            detail=f"未查询到编号为 {order_id} 的订单记录"
        )
    return record

@app.get("/healthz", tags=["监控检查"])
async def health_check():
    return {"status": "healthy", "service": "order-api", "active_records": len(db_storage)}

# 生产部署命令示例:
# uvicorn main:app --host 0.0.0.0 --port 8000 --workers 4- 切忌在 async 协程中执行同步阻塞操作:在
async def路由中,如果调用了time.sleep()、原生的requests.get()或未适配异步的数据库驱动,会导致当前单线程事件循环被死锁,整个工作进程无法响应后续任何并发请求。必须使用asyncio.sleep()、httpx.AsyncClient或通过run_in_executor将阻塞任务转交后台线程池。 - GIL 与 CPU 密集计算瓶颈:Python 的全局解释器锁(GIL)决定了纯 Python 代码无法利用单个进程的多核执行 CPU 密集型任务。如果有高耗时的图像处理、PDF 生成或大模型矩阵运算,必须通过 Celery 等任务队列将计算剥离至外部 Worker 进程。
- 规范类型注解:在百人以上规模协作中,必须借助
mypy或pyright对后端代码执行静态检查,避免弱类型引发的生产环境AttributeError与NoneType异常崩溃。
四、Python 能力边界与工业选型决策矩阵
技术选型本质上是团队研发资源、时间成本与系统硬件开销之间的权衡。在实际软件工程中,没有一种语言能够包打天下。Python 能够解决的问题,集中在那些业务逻辑频繁迭代、需要迅速验证需求、重度依赖外部生态库、并且系统吞吐瓶颈主要集中在 I/O 等待的场景。相反,如果业务的核心矛盾是纳秒级延迟、极致内存占用或单机千万级长连接计算,强行使用 Python 则会付出极高的服务器硬件与调优代价。
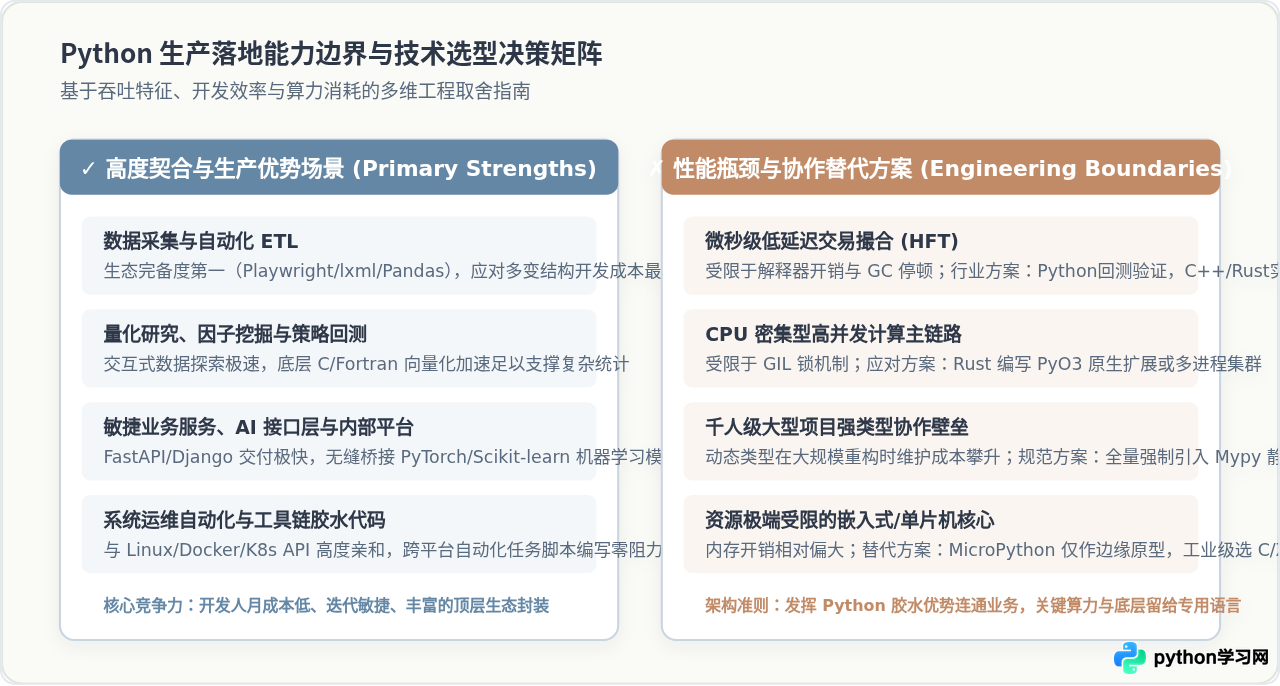
| 业务场景维度 | 推荐等级 | Python 技术支撑栈 | 核心价值与选型原因 | 替代 / 协同方案 |
|---|---|---|---|---|
| 分布式网络爬虫 | 极高推荐 | Scrapy, Playwright, HTTPX, lxml | 生态成熟度全球领先,面对频繁改版的前端结构,脚本重构耗时以小时计。 | 若追求千万级纯静态解析吞吐,可协同 Go/Colly 降本。 |
| 量化策略研究与回测 | 行业标准 | NumPy, Pandas, Backtrader, Polars | 交互式数据探索体验无出其右,底层矩阵运算速度与 C 语言无异。 | 实盘微秒级高频撮合(HFT)阶段需转写为 C++ / Rust 执行。 |
| 敏捷 Web / AI 微服务 | 高度推荐 | FastAPI, Django, SQLAlchemy, Uvicorn | 自动 OpenAPI 生成,类型安全,与各类机器学习/数据模型无缝桥接。 | 超高并发金融清算核心可协同 Go / Java 微服务体系。 |
| 系统自动化与运维胶水 | 行业标准 | Fabric, Ansible, Click, Boto3 | 与 Linux 底层高度亲和,轻松组装云厂商 API 与自动化流水线。 | 单二进制文件分发工具可选用 Go / Rust。 |
| 游戏引擎 / 底层驱动 | 不推荐 | Pygame, Ctypes (仅限学习原型) | 受限于解释器开销、垃圾回收(GC)偶发卡顿及内存布局松散。 | 首选 C++ / C / Rust 进行底层内存精准控制。 |
五、总结:如何高效发挥 Python 的工程生产力
回顾 Python 在实际工作中的核心定位,可以得出一个清晰的工程结论:Python 是一门将人类思考速度与代码交付速度最大化的“杠杆型”语言。
在网络爬虫领域,它打破了企业内外的数据壁垒,将互联网公开数据重塑为业务驱动的资产底座;在量化金融领域,它让投资研究员能够以数学公式般的直观代码验证交易假说,在真实风险发生前以极低试错成本完成策略证伪;在后端开发领域,现代异步架构与 Pydantic 强类型体系赋予了它高并发 I/O 处理能力,成为连接前端交互与内部算法模型的敏捷桥梁。
成熟的工程团队在使用 Python 时,通常遵循“Python 负责上层业务编排与快速试错,底层核心计算交由编译型语言或专用中间件”的协同范式。明确其能力边界、规范编写类型注解、严格控制异步上下文与未来函数,是让 Python 在企业真实生产环境中稳定释放巨大生产力的关键保障。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









