

只会Python语法好找工作吗?构建核心竞争力的关键步骤
深入分析只会Python基础语法为何难以满足当下岗位需求,全面梳理从语言底层、工程工具链、细分实战到架构设计的进阶路径,帮助求职者建立真正的核心竞争力。
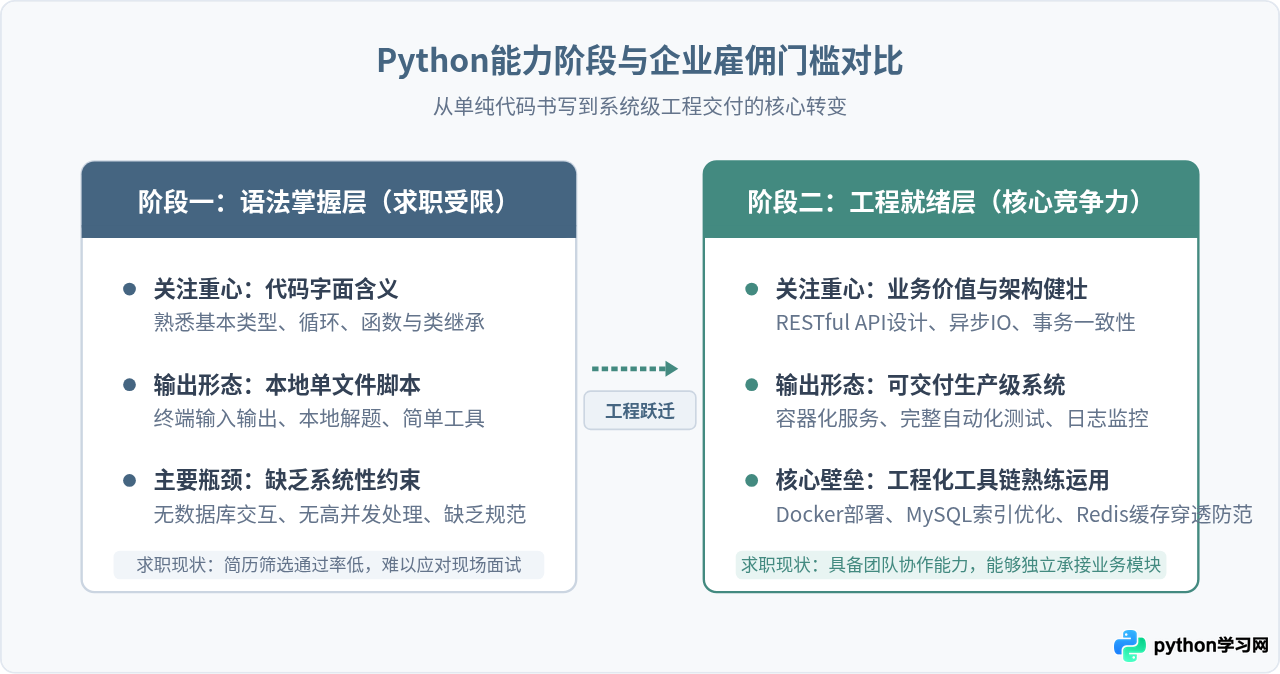
仅凭掌握基础语法,在当前就业市场中很难直接获得一份专业开发岗位。语法只是与计算机沟通的基础词汇规则,而企业招聘考察的核心是能否使用这门工具独立交付稳定、可维护且符合业务规范的软件产品。本文将直面这一求职现实,拆解企业岗位的真实诉求,并给出从“语法初学者”迈向“工程就绪型人才”的四步关键行动路径。
一、为什么“只会语法”在求职中屡屡受挫?
很多初学者在完整学完变量、数据结构、控制流、函数及面向对象概念后,能够流畅写出几十行的单文件脚本或解开基础算法题,便认为自己已经掌握了Python。然而,当面对真实招聘需求时,往往会发现要求列表中充斥着框架、中间件、并发模型与分布式架构等陌生术语。这种心理落差的根源在于:语法熟练度与工程交付能力之间存在巨大的认知与技能鸿沟。
在实际生产环境中,代码不仅要求“能跑通”,更要求高内聚低耦合、异常自愈、容纳高并发访问以及与上下游服务协同运作。企业不会为了“能写循环和判断语句”支付薪水,支付薪水的对象是“能解决业务问题并承担线上责任的工程师”。
二、构建核心竞争力的四个关键进阶步骤
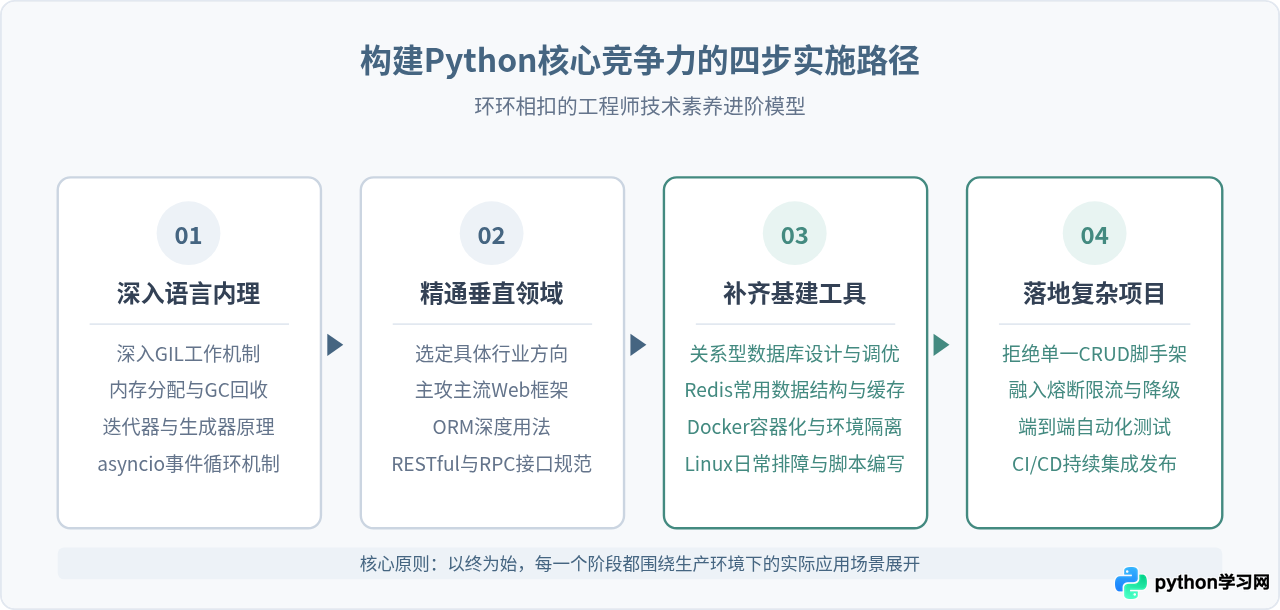
脱离单纯语法学习并不意味着需要死记硬背成百上千个库,而是应当遵循清晰的工程演进路径。下面四个步骤将帮助你由表及里建立不可替代的专业竞争力。
步骤一:突破语法表象,掌握底层运行机制
语法规则是表象,底层运行机理才是解决性能瓶颈与线上疑难Bug的依据。初学者常写出运行缓慢或内存飙升的代码,正是因为缺乏底层视角。需要重点钻研的内容包括:
- GIL(全局解释器锁)与多任务模型:理解为什么在CPython中多线程无法利用多核计算处理CPU密集型任务,而更适合处理IO密集型任务;掌握多进程(multiprocessing)与协程(asyncio)的具体边界与选型时机。
- 对象引用与垃圾回收(GC):理解引用计数为主、标记清除与分代收集为辅的回收体系,避免因循环引用导致的服务内存泄漏。
- 迭代器与生成器(Generators):掌握惰性求值的优势,学会在处理海量数据流或大文件解析时使用
yield降低峰值内存占用。 - 闭包与装饰器(Decorators):不仅仅会使用
@staticmethod,更要能纯手工编写用于权限鉴权、方法重试、性能打点及速率限制的通用参数化装饰器。
步骤二:锚定垂直领域,精研主流工业级框架
Python是一门通用语言,但招聘需求都是具体的。不要试图同时精通自动化测试、大数据挖掘、爬虫与Web后端。对大多数求职者而言,Web服务端开发与自动化运维研发是岗位基数较大且进阶路径最清晰的切入点。
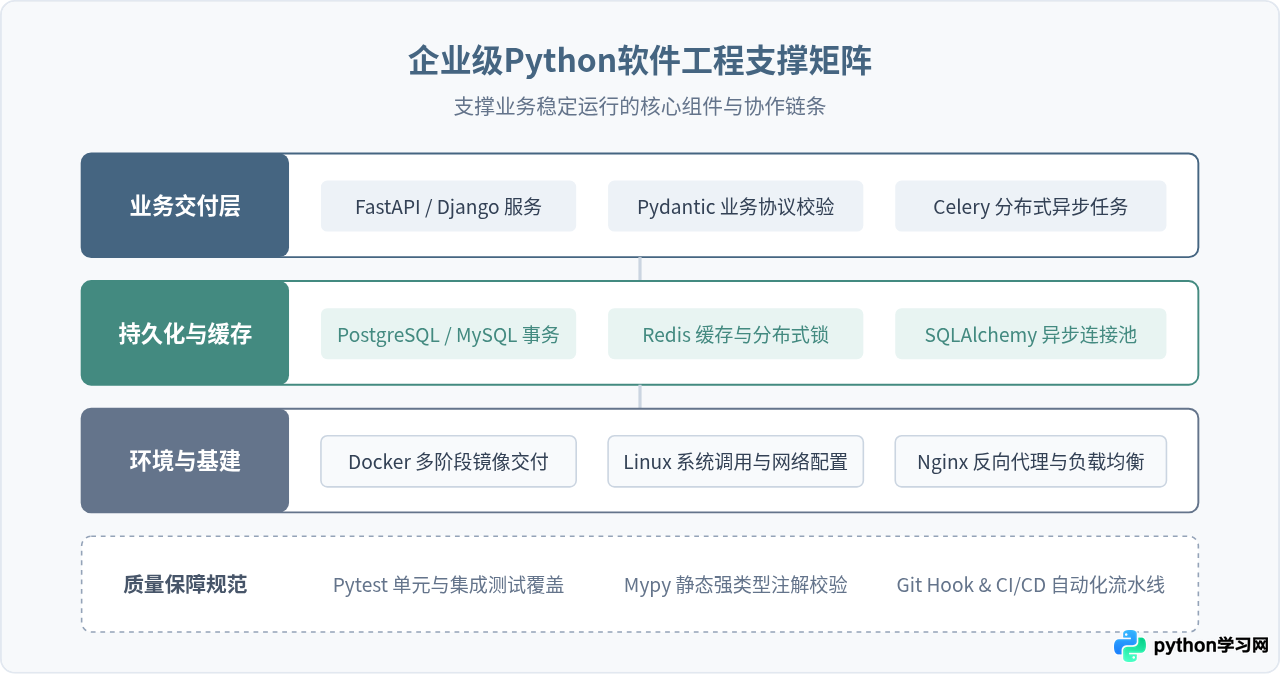
以当前主流的高性能异步框架 FastAPI 为例,合格的求职者不仅要会写路由函数,还要掌握完整的工业级代码编写范式:数据模型校验(Pydantic)、依赖注入系统(Depends)、数据库连接池管理与异步ORM操作。
from fastapi import FastAPI, Depends, HTTPException, status
from pydantic import BaseModel, EmailStr
from sqlalchemy.ext.asyncio import AsyncSession
from typing import AsyncGenerator

app = FastAPI(title="用户账户管理微服务")

# 1. 规范的输入数据校验模型
class UserCreateRequest(BaseModel):
    username: str
    email: EmailStr
    department: str

# 2. 依赖注入式数据库异步会话管理
async def get_db_session() -> AsyncGenerator[AsyncSession, None]:
    async with AsyncSessionLocal() as session:
        try:
            yield session
            await session.commit()
        except Exception:
            await session.rollback()
            raise

# 3. 生产级API端点:集成状态码、依赖注入与明确的业务异常处理
@app.post("/api/v1/users", status_code=status.HTTP_201_CREATED)
async def create_user_endpoint(
    payload: UserCreateRequest,
    db: AsyncSession = Depends(get_db_session)
):
    existing_user = await get_user_by_email(db, payload.email)
    if existing_user:
        raise HTTPException(
            status_code=status.HTTP_409_CONFLICT,
            detail="该电子邮箱已被注册,请更换后重试。"
        )
    created_id = await insert_user_record(db, payload)
    return {"status": "success", "user_id": created_id}
步骤三:补齐基础设施与协作工具链
现代软件系统没有孤立运行的Python脚本。面试官往往会通过周边技术栈来考察候选人的工程成熟度:
- 关系型数据库(MySQL / PostgreSQL):熟练编写复杂SQL、理解B+树索引工作原理、懂得利用
EXPLAIN分析慢查询,并理解事务隔离级别与行级锁。 - 高速缓存与消息中间件(Redis / RabbitMQ):掌握高并发场景下缓存的使用(String, Hash, ZSet),并知道如何应对缓存击穿、穿透与雪崩;掌握基于Celery或RQ的异步任务解耦。
- 容器化与部署交付(Docker & Linux):能够编写多阶段构建的
Dockerfile缩减镜像体积,熟练使用docker-compose一键编排本地开发依赖服务,熟悉在Linux环境下排查CPU占用与端口占用(top、netstat、journalctl)。 - 版本协作与代码质量工具(Git、Ruff、Mypy):遵守Git Flow分支管理规范,在CI流程中配置代码格式化与静态类型检查,保障团队工程底线。
步骤四:攻坚具有业务深度的实战项目
简历中最常出现的失误,是堆砌诸如“简易学生管理系统”、“静态个人博客”或“通用商城模板”。这类项目在面试官眼中缺乏真实价值,因为它们往往只有几张简单的单表增删改查,完全规避了实际业务中最棘手的问题。
打造具有竞争力的实战项目,必须人为引入非功能性挑战:
- 引入并发与数据一致性难题:例如设计一个微型库存扣减系统或优惠券领券模块,在代码中实现Redis分布式锁、MySQL行级悲观锁或乐观锁版本号机制,并使用压测工具(如Locust)跑出性能极限指标。
- 真实处理网络与第三方依赖的不确定性:为外部调用增加超时控制、重试退避策略(指数抖动回退)与熔断降级逻辑,并编写单元测试模拟网络断开与慢响应场景。
- 可观测性落地:拒绝
print()式排查,配置结构化日志输出(JSON格式),将请求追踪ID(Trace ID)贯穿调用链,方便线上故障追溯。
三、求职竞争力自查与复盘模型
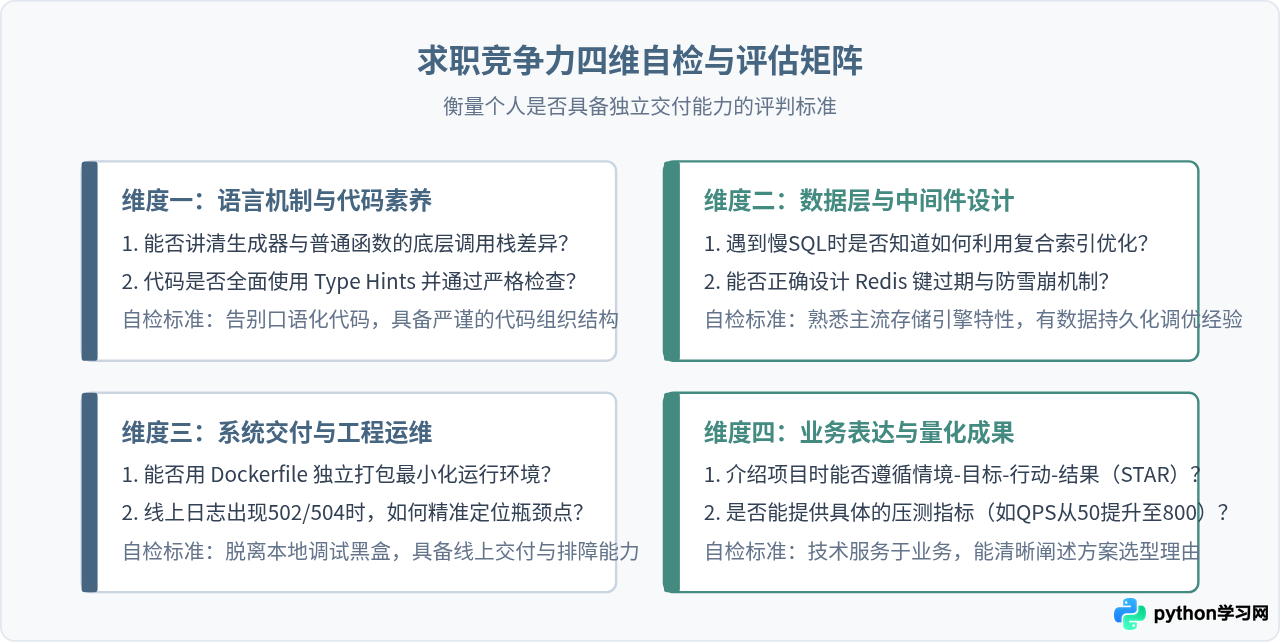
在投递简历前,求职者可以通过以下四个维度进行客观自评。如果每个维度都能清晰回答“遇到什么难题、为什么这样设计、量化指标提升了多少”,面试沟通将占据绝对主动。
四、总结与行动指南
“只会Python语法”并不是求职失败的死刑判决,而是每一位工程师都曾经历过的必经起点。意识到语法的局限性,恰恰是技术认知成熟的重要标志。
求职转型的核心在于转变学习视角:停止无休止地刷基础语法教程,转向以实际项目为载体,主动为系统引入并发、存储、部署与容灾等真实工程问题。当你能用规范的代码、合理的架构以及量化的测试数据向面试官证明你的系统抗风险能力时,你的核心竞争力就已经牢固建立。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









