

零基础转行Python开发工程师:分阶段学习路径与资源推荐
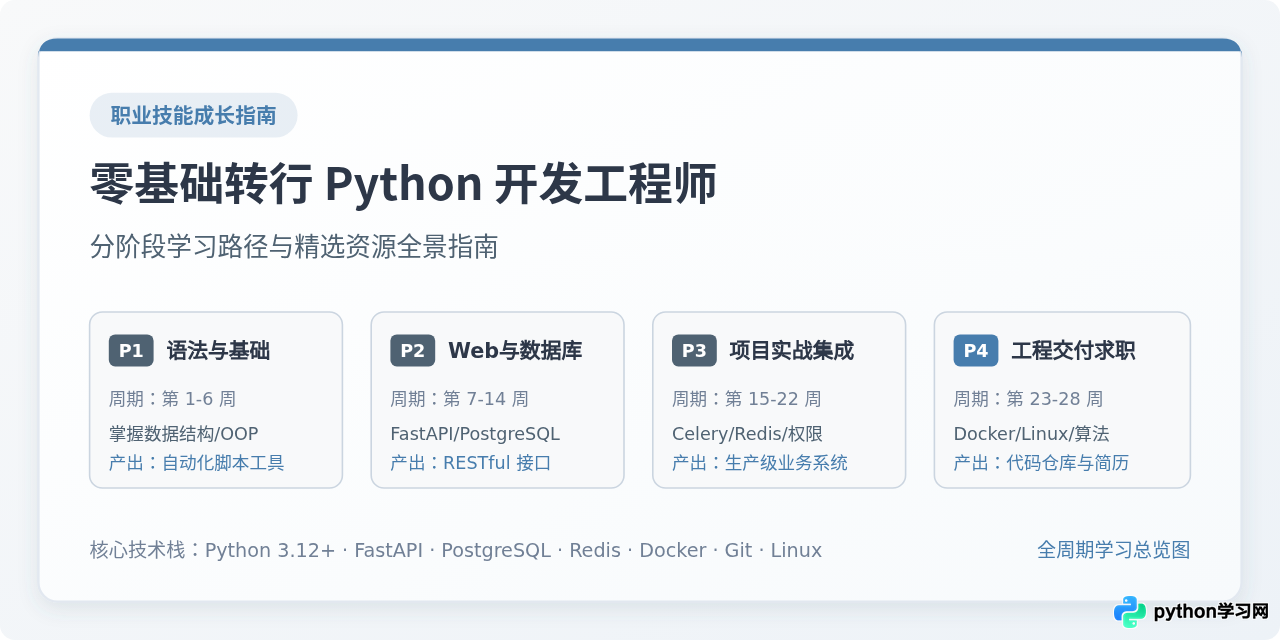
面向零基础转行群体的Python开发工程师实用学习路径,包含四个阶段的具体时间安排、核心技术栈、实战项目指导、推荐书籍与官方文档资源,以及工程化求职准备策略。
转行定位与现实预期:为什么选择后端开发方向?
Python 在人工智能、自动化脚本、数据分析和 Web 后端开发中均有广泛应用。但对于没有计算机科班背景的零基础转行者,将求职目标明确锁定在“Web 后端开发工程师”或“API 服务与数据工程工程师”是最具实操性与招聘确定性的路径。
与需要深厚数学与学术背景的算法岗位相比,Web 后端岗位更注重扎实的业务逻辑实现、数据库读写性能、接口规范以及系统稳定性;与自动化爬虫相比,后端开发拥有更稳定的企业需求和合规空间。在学习开始前,建议建立明确的时间预算:零基础学习没有速成捷径,按每天 2~3 小时计算,完成全部四个阶段通常需要 600 小时左右的纯代码编码与调试积累。
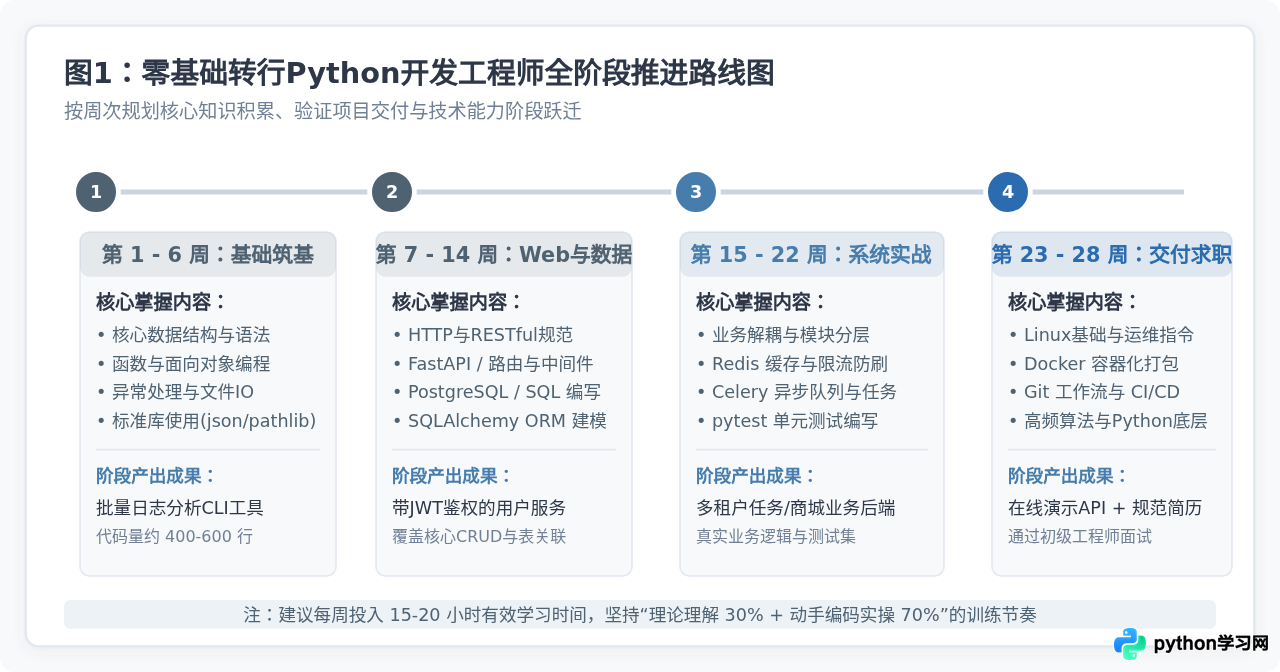
阶段一:Python核心语法与编程基础(第1~6周)
第一阶段的目标是建立扎实的编程手感和逻辑思维,能够熟练运用 Python 的内建数据结构解决常见的数据处理与流程控制问题。
核心技术与训练要点
- 开发环境搭建:使用 Python 3.12+ 官方环境,掌握轻量虚拟环境管理工具(内置
venv或新一代工具uv),配置 Visual Studio Code 并熟悉基本调试功能(断点调试、变量观察)。 - 核心数据结构:深入理解列表(list)、字典(dict)、元组(tuple)、集合(set)的内存特性与时间复杂度差异。重点训练列表推导式与字典解析,避免滥用嵌套循环。
- 函数与面向对象(OOP):掌握参数传递(
*args,**kwargs)、变量作用域、装饰器原理(闭包机制)、类与实例、继承、封装与特殊方法(魔术方法如__init__,__str__,__repr__)。 - 文件操作与标准库:熟练使用现代文件路径库
pathlib、数据序列化库json、时间处理库datetime以及日志库logging,掌握try-except-finally异常捕获策略。
阶段验收项目:日志分析与格式转换命令行工具
不要停留在控制台打印“九九乘法表”。在完成本阶段学习后,必须独立完成一个可在终端运行的 CLI 小工具:读取指定目录下的 Nginx 访问日志或应用程序错误日志,统计指定时间范围内的 IP 访问频次与状态码分布,并将结果整理为结构化 JSON 或 CSV 文件。
# 示例:阶段一验收项目核心结构示例(命令行工具设计)
import argparse
import json
import logging
from collections import Counter
from pathlib import Path

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

def parse_access_log(file_path: Path) -> dict:
    if not file_path.exists():
        raise FileNotFoundError(f"指定的日志文件不存在: {file_path}")

    status_counter = Counter()
    ip_counter = Counter()

    with file_path.open("r", encoding="utf-8") as f:
        for line_num, line in enumerate(f, start=1):
            parts = line.strip().split()
            if len(parts) >= 9:
                ip = parts[0]
                status_code = parts[8]
                ip_counter[ip] += 1
                status_counter[status_code] += 1

    return {
        "total_lines": line_num,
        "top_ips": ip_counter.most_common(5),
        "status_distribution": dict(status_counter)
    }

def main():
    parser = argparse.ArgumentParser(description="日志分析与汇总报告生成工具")
    parser.add_argument("--file", "-f", required=True, type=Path, help="待分析日志路径")
    parser.add_argument("--output", "-o", default=Path("report.json"), type=Path, help="输出报告文件")
    args = parser.parse_args()

    logging.info(f"开始解析日志: {args.file}")
    result = parse_access_log(args.file)
    with args.output.open("w", encoding="utf-8") as out:
        json.dump(result, out, indent=2, ensure_ascii=False)
    logging.info(f"分析完成,报告已保存至 {args.output}")

if __name__ == "__main__":
    main()
阶段一精选学习资源
阶段二:关系型数据库与Web后端开发(第7~14周)
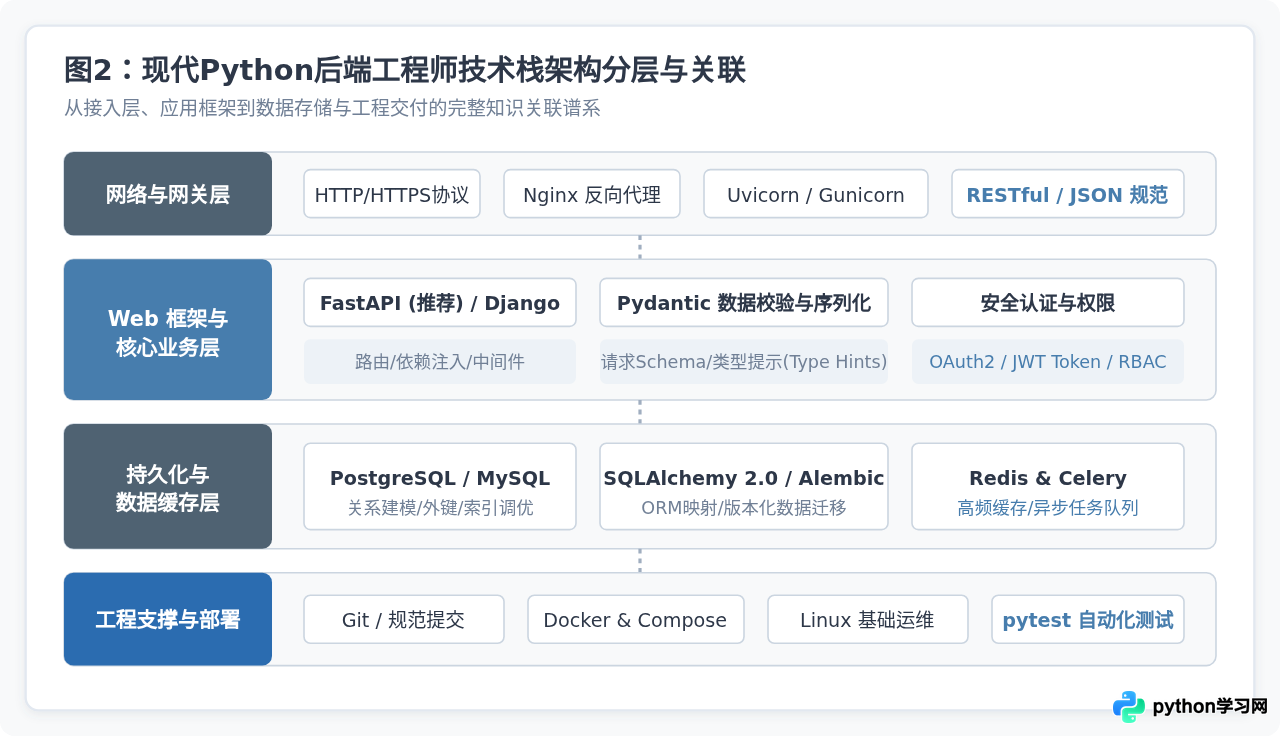
进入第二阶段,学习重点从“如何写 Python 代码”转向“计算机网络如何交互、数据如何持久化”。这一阶段是转行过程中的第一个分水岭,核心是掌握 Web API 的设计规范与数据库操作。
核心技术与训练要点
- 网络协议与接口规范:透彻理解 HTTP 请求报文结构(Method, Header, Query Parameter, Request Body)、状态码语义(200, 201, 400, 401, 403, 404, 500)以及 RESTful 架构约束。
- 现代 Web 框架选型(FastAPI 推荐):在当前招聘市场中,FastAPI 凭借原生异步支持、类型安全与自动生成 API 文档成为主流选择。深入学习路由分发、中间件(Middleware)、依赖注入系统(Dependency Injection)与 Pydantic 数据验证模型。
- 关系型数据库(PostgreSQL):安装并熟练使用 PostgreSQL。掌握 SQL 核心查询(SELECT、WHERE、JOIN 多表联查、GROUP BY 分组聚合)、主键与外键约束、唯一索引与联合索引的作用机制。
- ORM 与数据迁移工具:掌握 SQLAlchemy 2.0 异步/同步风格的实体建模与数据操作,熟练使用 Alembic 生成、升级与回滚数据库表版本迁移。
初学者在通过 ORM 关联多张表(如查询每个部门下的所有员工列表)时,极易写出循环内再次发起数据库查询的逻辑,导致一次请求触发上百次 SQL 查询。在 SQLAlchemy 中应学会显式使用
joinedload 或 selectinload 进行预先加载。
阶段验收项目:具备权限控制的 RESTful API 服务
实现一套包含用户注册、登录、鉴权与内容发布的多用户 API 系统:
- 用户密码必须经过
bcrypt或argon2哈希加密后存入数据库; - 登录接口返回签名后的 JSON Web Token (JWT),后续请求通过
Authorization: Bearer <token>携带; - 通过 FastAPI 依赖注入校验 Token 并提取当前登录用户对象,非本人资源限制修改权限;
- 完成文章/任务的分页查询(
offset/limit或游标分页),支持按标签过滤。
阶段二精选学习资源
阶段三:全流程业务项目实战与系统集成(第15~22周)
招聘方筛选简历时,最排斥的是千篇一律的教程模板项目(如简易待办清单、天气查询器)。第三阶段必须严格按照工业级工程规范,从零开发一套具备完整商业逻辑的后端项目。
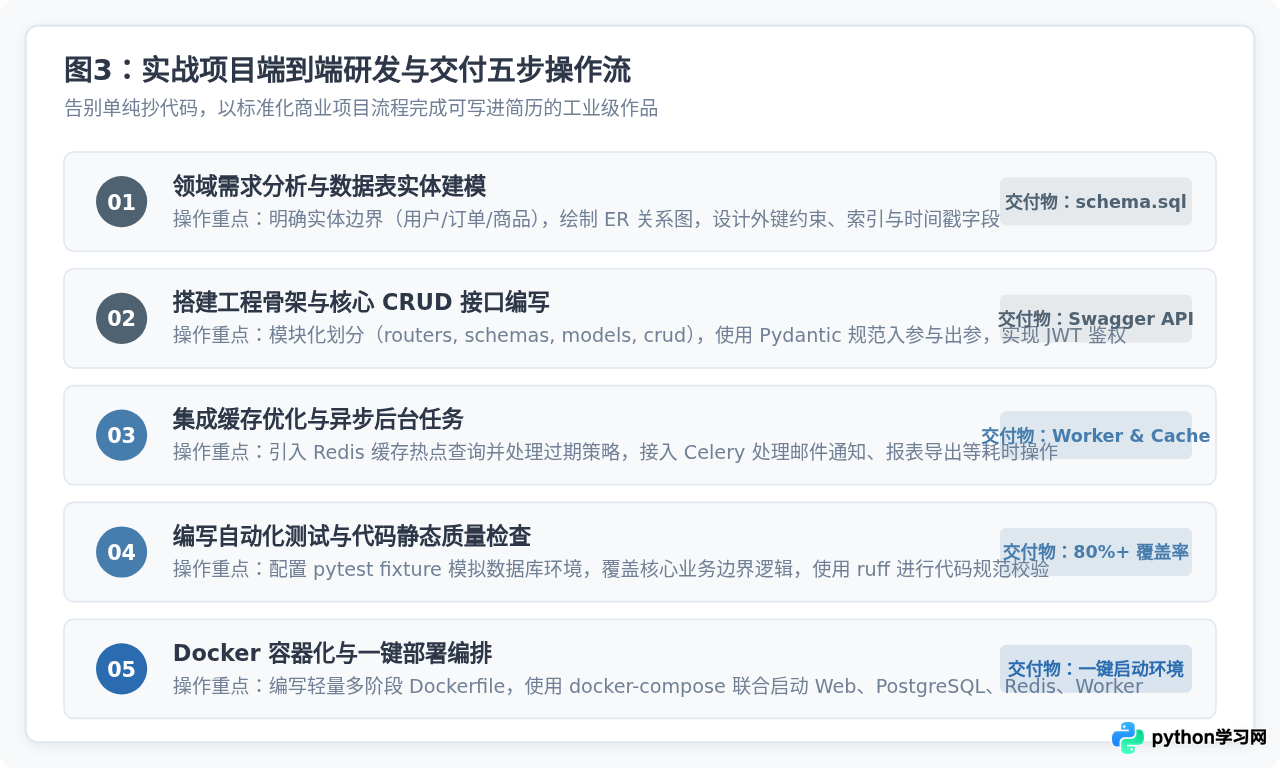
核心技术与训练要点
- 缓存与限流(Redis):将 Redis 用于高频查询缓存(如热门商品详情、用户信息缓存),设置合理的 TTL 过期时间;利用 Redis 的原子自增特性实现接口防刷与速率限制。
- 异步任务队列(Celery):将长耗时操作(如生成 PDF 账单、向外部邮箱发送验证码、大规模批量数据导入)解耦至后台异步 Worker 执行,保证 HTTP 接口毫秒级响应。
- 代码质量与类型提示:全量采用 Python Type Hints,使用
ruff统一代码风格与静态代码检查,杜绝未经捕获的全局未处理异常。 - 单元测试与集成测试:使用
pytest编写接口自动化测试用例,结合内存数据库或测试数据库环境对关键业务逻辑进行断言验证,追求 75% 以上的核心逻辑测试覆盖率。
推荐实战项目选题:多租户团队协作与定时任务 SaaS 后端
该项目应具备真实的业务复杂度与技术广度:
- 租户隔离与角色权限:实现 RBAC(基于角色的访问控制),区分租户管理员、普通成员与只读访客。
- 异步长任务执行:用户可提交批量数据清洗任务,系统返回任务 ID 并交由 Celery 执行,前端可通过轮询或 WebSocket 实时查询任务进度与结果。
- 审计日志:对租户内的敏感操作(修改账单、删除项目)通过异步中间件写入审计流水表。
阶段三精选学习资源
阶段四:工程化交付、面试储备与求职落地(第23~28周)
很多转行者技术学得不错,却由于不懂部署、无法在 Linux 环境独立排障、简历技术点空泛而倒在面试关卡。第四阶段旨在补齐软件生命周期中的“最后一公里”,将项目转化为真实的在线服务。
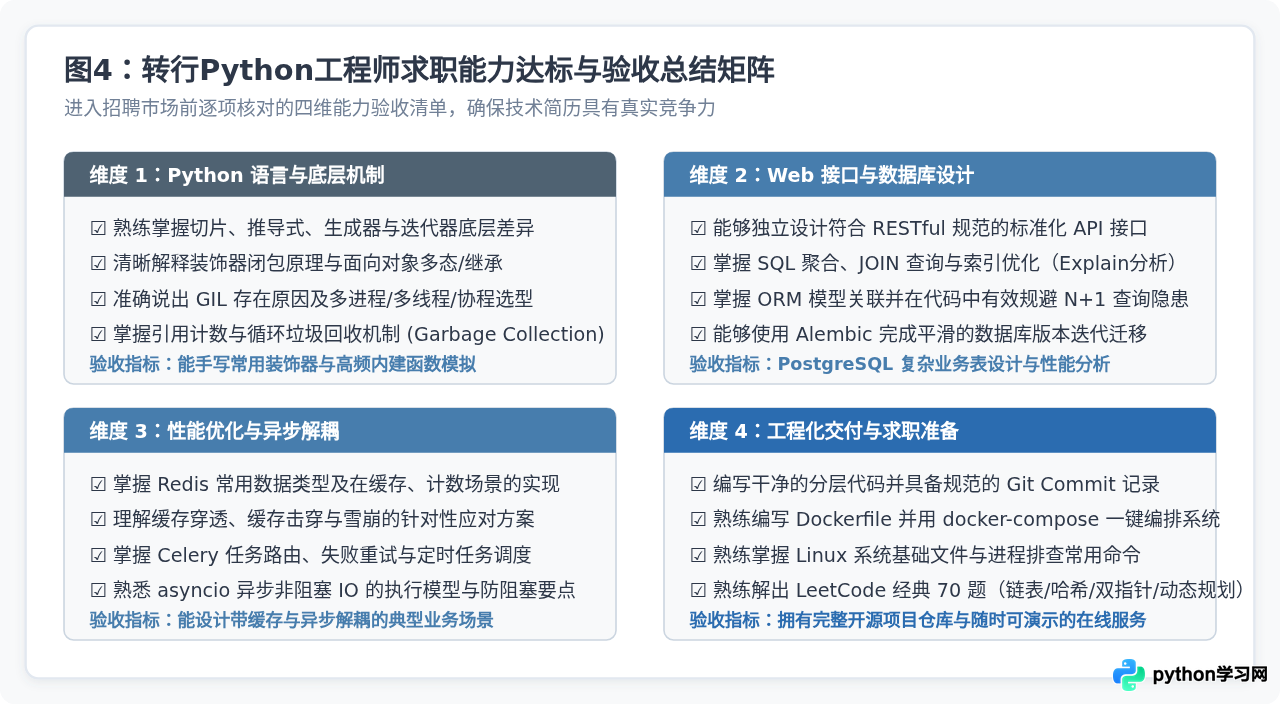
核心技术与训练要点
- Linux 基础与常用命令:掌握常用文件与系统操作(
ssh,systemctl,journalctl,top/htop,curl,netstat/ss),能够通过日志定位服务崩溃原因。 - Docker 容器化打包:编写轻量高效的 Dockerfile,配置多阶段构建减少镜像体积;编写
docker-compose.yml一键联动编排 FastAPI 应用、PostgreSQL、Redis 和 Celery Worker。 - Git 规范化工作流:遵循清晰的分支策略与 Conventional Commits 规范,让你的 GitHub 提交记录呈现清晰、专业的演进过程。
- 计算机基础与算法备考:重点攻克 LeetCode 经典 70~100 题,集中在数组、双指针、哈希表、链表、二叉树与简单动态规划。掌握 Python 特有的技术深度题:GIL 全局解释器锁、垃圾回收机制(引用计数 + 标记清除 + 分代回收)、生成器与
asyncio事件循环底层机制。
简历呈现与求职实操建议
| 考察维度 | 低竞争力表现(易被拒) | 高竞争力表现(受青睐) |
|---|---|---|
| 技术栈描述 | “熟悉 Python, Django, HTML, CSS, JavaScript, 机器学习”等杂而不精的罗列 | “熟练使用 Python 3.12+ / FastAPI 进行异步接口开发,熟练使用 PostgreSQL 并具备索引优化经验,熟练使用 Docker 容器化交付” |
| 项目经历 | “开发了一个图书管理系统,实现了增删改查功能” | “主导开发多租户协作后台,基于 FastAPI+PostgreSQL 架构,利用 Redis 缓存高频热点降低 40% DB 读压力,编写 Celery 异步队列处理报表,集成 pytest 达到 80% 核心分支覆盖率” |
| 代码展现 | 简历中无代码链接,或 GitHub 仓库只有一个提交,代码无注释无测试 | 附带排版整洁的 GitHub 仓库,包含完善的 README、架构图、测试命令说明以及可访问的在线 Swagger 接口演示地址 |
结语与执行原则
从零基础到拿到第一份开发工程师 Offer,本质是一次“认知与技能的系统重塑”。在接下来的学习周期中,牢记以下三条执行原则:
- 以输促学,拒绝被动刷课:每看一个技术点的讲解视频,必须在编辑器中亲手敲出至少三段变体代码。没有经过独立报错和自主排错的代码,就不算真正掌握。
- 保持代码库的持续演进:从第一阶段的 CLI 小脚本,到最终的商业级后端服务,全部托管在 GitHub 上。每一次 Bug 修复与功能重构都是对开发规范的肌肉记忆训练。
- 尽早直面真实求职市场:在完成第三阶段后,即可开始梳理简历框架,根据目标公司的招聘要求针对性强化薄弱环节,逐步进入模拟面试与实战投递状态。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









