

适合新手的Python实战项目推荐:从脚本到Web应用

初学 Python 时最容易遇到的瓶颈,是看懂了变量、条件分支、循环和函数定义,但在面对一个空白编辑器时依然不知从何下手。产生这种断层的主要原因,在于基础练习多是割裂的单点语法题,而真正的软件开发需要把模块串联成具备特定功能的完整流程。最稳妥的进阶路径,并不是直接跨越到动辄几十个组件的大型商业系统,而是按照“本地自动化脚本 → 命令行数据工具 → 轻量接口服务 → 交互式 Web 应用”的梯度循序渐进,每一步都在前一步的基础上补充一个核心技术维度。
一、阶段演进逻辑:为什么必须“从小到大”
很多初学者一上手就试图照着教程搭建博客或商城,往往会被 HTML/CSS、数据库模型、路由系统和用户认证等交织在一起的概念直接劝退。代码虽能照抄运行,却对背后的数据流动毫无感知。合理的训练路径应当遵循软件复杂度递增原则:
- 阶段一:本地单一脚本——专注核心逻辑、文件系统操作与标准库使用,无需处理外部网络与用户输入。
- 阶段二:CLI 命令行工具——引入第三方依赖、处理外部网络协议与数据解析,学习工程化参数配置。
- 阶段三:轻量 Web API——理解客户端-服务器通信范式,掌握 HTTP 规范与结构化数据响应。
- 阶段四:完整交互应用——整合数据持久化、前后端渲染及业务状态流转,形成全流程认知闭环。
二、阶段一:初试锋芒——自动化桌面文件整理脚本
每个人的下载文件夹和桌面都会随着时间推移堆满各类临时文件。编写一个自动按文件类型(如文档、图片、表格、压缩包)分类整理的脚本,是检验 Python 文件 I/O 与路径操作的最佳试金石。该项目不依赖任何复杂的第三方库,仅凭标准库中的 pathlib 与 shutil 即可交付立竿见影的实用价值。
1. 核心技术点与模块职责
pathlib.Path:现代化的面向对象路径操作,负责文件遍历、后缀提取与安全拼接。shutil.move:高层文件操作,负责将文件从源目录移动到分类目标目录。- 异常保护机制:防止目标同名文件被粗暴覆盖,以及处理权限不足的情况。
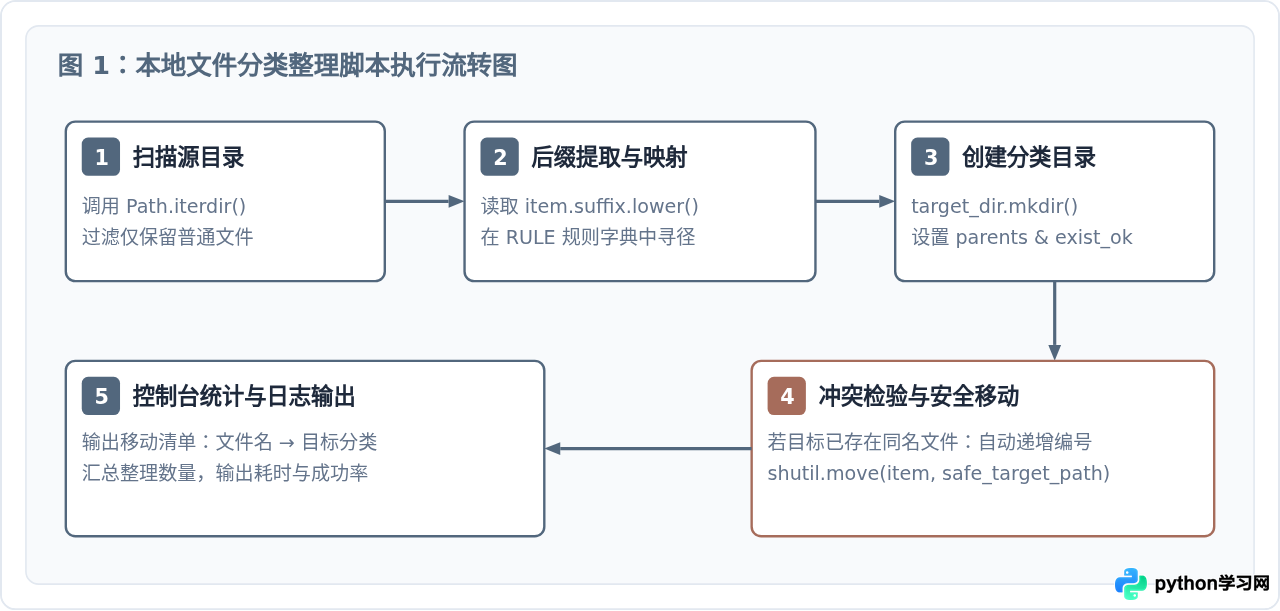
2. 核心参考实现
下面给出一段可以直接运行的整理代码。注意我们使用函数进行功能封装,并通过字典维护后缀规则,方便后续随时扩充支持的格式:
import shutil
from pathlib import Path

# 分类规则字典:分类文件夹名称 -> 对应的文件后缀集合
EXTENSION_MAPPING = {
    "文档资料": {".pdf", ".docx", ".doc", ".txt", ".md", ".xlsx", ".pptx"},
    "图片素材": {".jpg", ".jpeg", ".png", ".gif", ".webp", ".svg"},
    "压缩归档": {".zip", ".tar", ".gz", ".rar", ".7z"},
    "安装程序": {".exe", ".dmg", ".pkg", ".deb"}
}

def organize_directory(source_folder: str) -> None:
    source_path = Path(source_folder)
    if not source_path.exists() or not source_path.is_dir():
        print(f"[错误] 指定路径不存在或不是文件夹: {source_folder}")
        return

    summary = {category: 0 for category in EXTENSION_MAPPING}
    summary["其他未知"] = 0

    for item in source_path.iterdir():
        # 仅处理普通文件,忽略文件夹与隐藏文件
        if not item.is_file() or item.name.startswith("."):
            continue

        ext = item.suffix.lower()
        matched_category = "其他未知"

        for category, extensions in EXTENSION_MAPPING.items():
            if ext in extensions:
                matched_category = category
                break

        target_dir = source_path / matched_category
        target_dir.mkdir(parents=True, exist_ok=True)

        target_file = target_dir / item.name
        # 规避同名覆盖风险:如果存在则追加计数
        counter = 1
        while target_file.exists():
            target_file = target_dir / f"{item.stem}_{counter}{item.suffix}"
            counter += 1

        shutil.move(str(item), str(target_file))
        summary[matched_category] += 1
        print(f"已移动: {item.name} -> {matched_category}/")

    print("\n=== 整理完成报告 ===")
    for cat, count in summary.items():
        print(f"  - {cat}: {count} 个文件")

if __name__ == "__main__":
    # 可替换为您本地需要整理的测试目录
organize_directory("./test_downloads")os.system("mv ...") 拼接命令行字符串,这极易引发带空格路径的解析失败甚至安全漏洞。始终坚持使用 pathlib.Path 与 shutil 处理跨平台文件系统。
三、阶段二:功能进阶——网络数据抓取与实用 CLI 工具
单纯在本地文件打转很容易缺乏成就感。第二个阶段应引入外部网络交互,学习如何向网络接口发起请求、提取有效字段,并封装成一个能够接受命令行参数的实用工具,例如一个“特定城市天气与出行建议查询器”或“每日科技要闻采集器”。
1. 核心技术点与架构设计
requests库:处理 HTTP GET/POST 协议、Header 伪装、超时配置与状态码检查。- 数据解析与清洗:针对开放 REST API(返回 JSON)或静态网页(通过
BeautifulSoup4提取 DOM 节点)。 argparse模块:解析用户在终端传入的参数(如--city,--output),具备规范的-h/--help帮助提示。
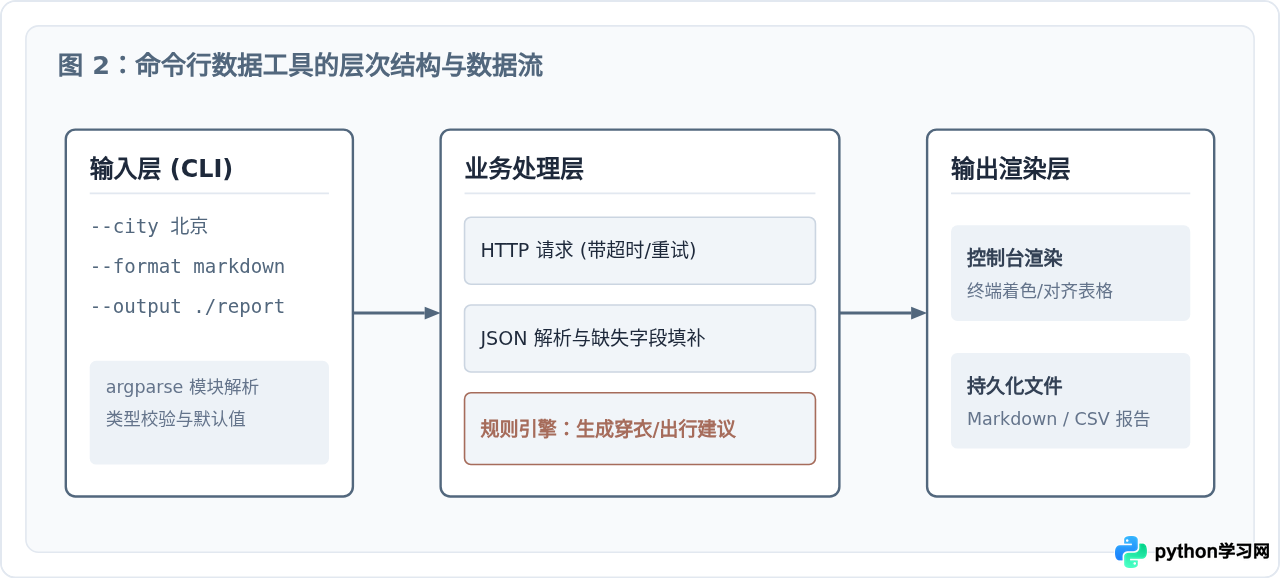
2. 编写网络请求代码的核心防坑点
很多新手初写爬虫或数据获取脚本,代码极度脆弱,一遇网络抖动或格式变更直接崩溃。在实现阶段二时,请务必建立以下防御性编码习惯:
- 明确超时设定:永远不要写
requests.get(url)这种无超时的调用,务必显式传入timeout=5,否则服务端挂起时程序会永久假死。 - 检查 HTTP 状态码:使用
response.raise_for_status()快速捕获 4xx/5xx 错误,而不是假设每次响应都是 200 OK。 - 安全解构 JSON:使用字典的
.get(key, default)方法获取字段,严禁直接通过连续方括号索引,以防遇到缺失节点抛出KeyError。
四、阶段三:走向服务——轻量级 RESTful API 开发
写完 CLI 之后,初学者需要理解程序如何从“一次性运行的命令”变成“7×24小时待命并对外提供服务的常驻进程”。这一阶段最推荐的项目是使用 FastAPI 或 Flask 编写一个待办事项(To-Do)后端接口。
1. 为什么选择轻量 API 作为过桥项目
相比于一开始就折腾 HTML 页面和 CSS 样式,只返回 JSON 数据的 API 能够让你把全部精力集中在后端核心概念上:
- HTTP 动词语义:明确区分 GET(查询)、POST(创建)、PUT(全量更新)、DELETE(删除)。
- 请求生命周期:理解请求是如何被路由(Routing)匹配到特定函数,以及返回值如何被序列化为 JSON 字符串。
- 数据验证与类型声明:体验现代 Python 类型注解(Type Hints)带来的自动校验与接口文档生成。
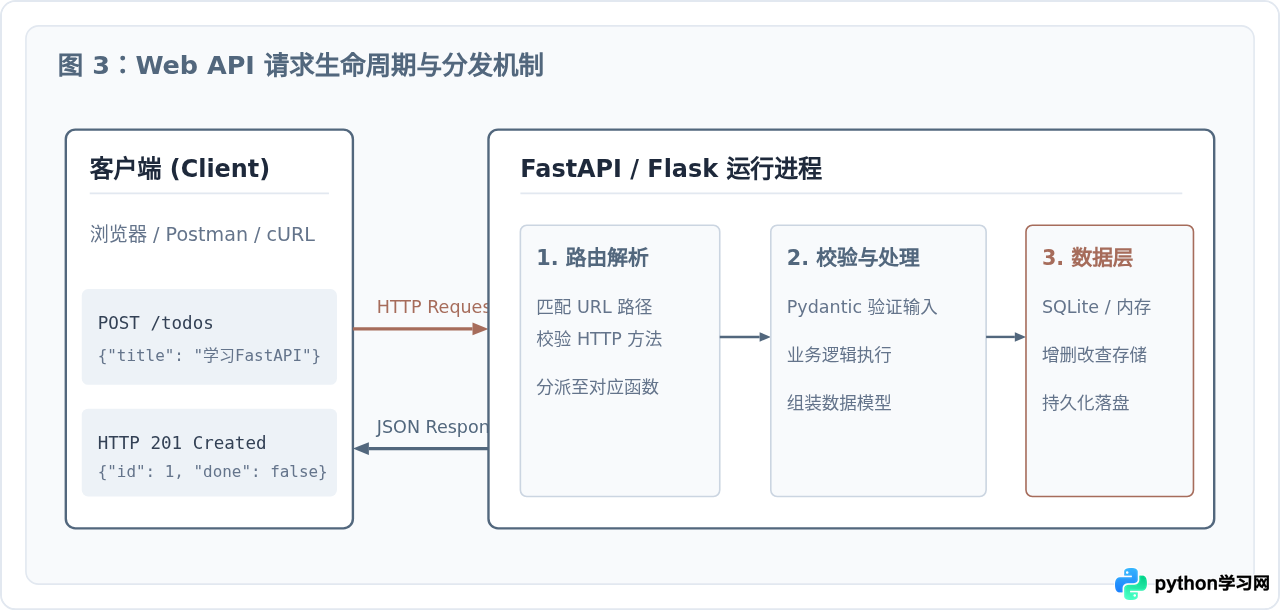
2. 极简 FastAPI 示例实现
以 FastAPI 为例,短短数十行代码便可构建一个拥有完备数据校验与交互式文档(访问 /docs)的后端接口:
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel
from typing import List, Optional

app = FastAPI(title="待办事项简易服务")

# 定义数据传输模型(Schema)
class TodoItem(BaseModel):
    id: Optional[int] = None
    title: str
    completed: bool = False

# 内存数据存储(新手入门无需一开始配置重型数据库)
database: List[dict] = []
id_counter = 1

@app.get("/todos", response_model=List[TodoItem])
def get_all_todos():
    """获取所有待办项"""
    return database

@app.post("/todos", status_code=201)
def create_todo(item: TodoItem):
    """创建新待办项"""
    global id_counter
    todo_dict = item.dict()
    todo_dict["id"] = id_counter
    id_counter += 1
    database.append(todo_dict)
    return todo_dict

@app.delete("/todos/{todo_id}")
def delete_todo(todo_id: int):
    """根据 ID 删除指定项"""
    for index, item in enumerate(database):
        if item["id"] == todo_id:
            return database.pop(index)
    raise HTTPException(status_code=404, detail="未找到该待办记录")

# 启动命令: uvicorn main:app --reload
五、阶段四:完整交互——从后端逻辑到交互式 Web 应用
当你对 HTTP 接口和数据结构足够熟悉后,即可正式迈向第四个阶段:构建一个带有可视化前端界面、支持用户表单交互与关系型数据库持久化的完整 Web 应用。建议从个人备忘录/轻量看板系统或团队知识库起步。
1. 关键集成技术
- 模板引擎(Jinja2):学习服务端渲染(SSR)的基本原理,掌握如何在 HTML 模板中通过循环和条件语句嵌入 Python 数据变量。
- 关系型数据库(SQLite + SQLAlchemy / Peewee):摆脱易丢失的内存字典,使用 ORM(对象关系映射)操作真实的数据表。
- 表单与状态反馈:接收用户通过浏览器提交的表单数据,进行安全性转义,并向界面回传操作成功/失败的状态提示。
2. 为什么推荐 SQLite 作为新手的第一个数据库
不少新手一开始就按照教程安装配置 MySQL 或 PostgreSQL,往往在连接权限、端口冲突、编码设置等环境问题上耗费数天时间。对于新手实战项目,SQLite 是最好的选择:它是 Python 原生内置支持的单文件数据库,无需安装任何额外服务进程,代码复制到任何电脑上都能直接运行。等待业务规模或并发需求真正上升时,再通过更换数据库连接串平滑迁移至 MySQL 或 PostgreSQL 即可。
六、进阶路线全景总结与避坑指南
从单文件脚本成长为能够独立交付 Web 应用的开发者,关键在于每一步都扎实积累当前阶段的核心技术,不求快但求透彻。以下是四个项目的综合能力矩阵对比:
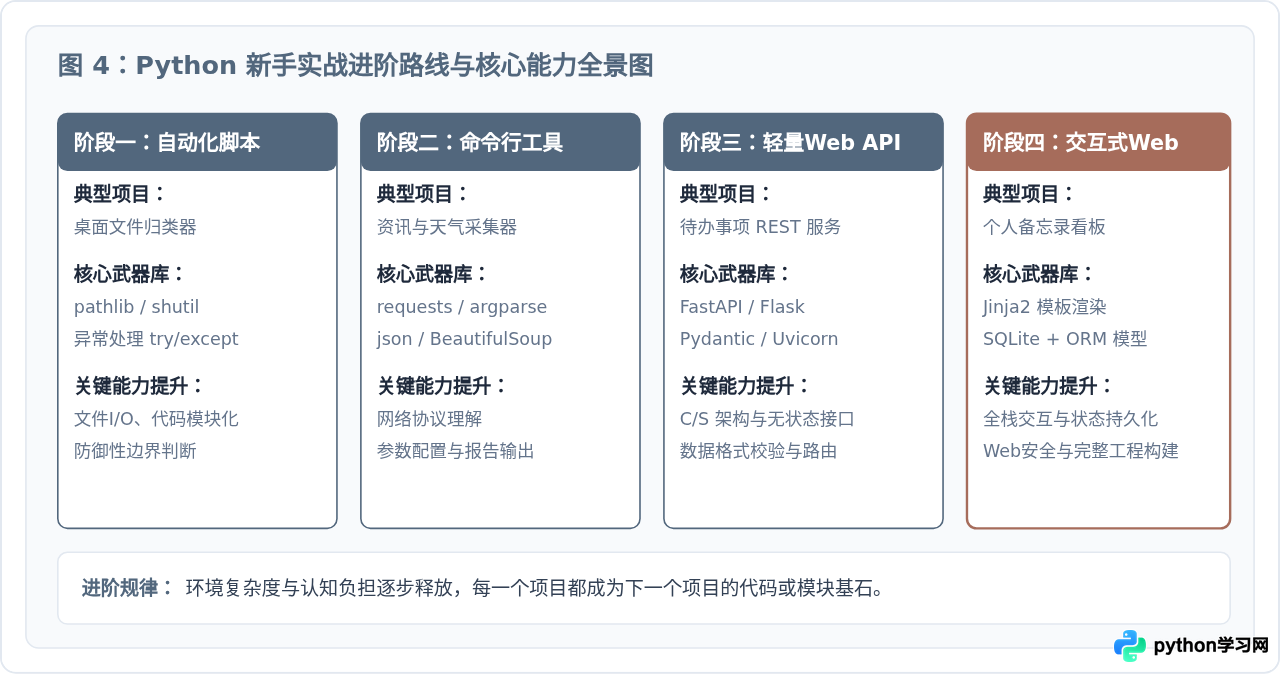
python -m venv .venv),并使用 Git 进行版本管理。先让最简版本的代码跑通,再逐步增加功能分支,这种敏捷迭代的体感将伴随你整个软件开发生涯。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









