

怎么判断一个数据分析项目该锁定pandas哪个版本?
针对数据分析项目如何科学判断并锁定pandas版本提供完整指南,从Python运行时、NumPy 2.0兼容性、PyArrow后端、Copy-on-Write机制及遗留语法破坏点等维度深入剖析,并提供五步落地操作与场景矩阵。
.append() 移除与 Copy-on-Write)的容忍度,以及内存吞吐诉求共同约束决定的。判断清楚这四个维度,就能在 1.5.3、2.0~2.1 以及 2.2.x 之间做出确定性的技术选择并精准固化。
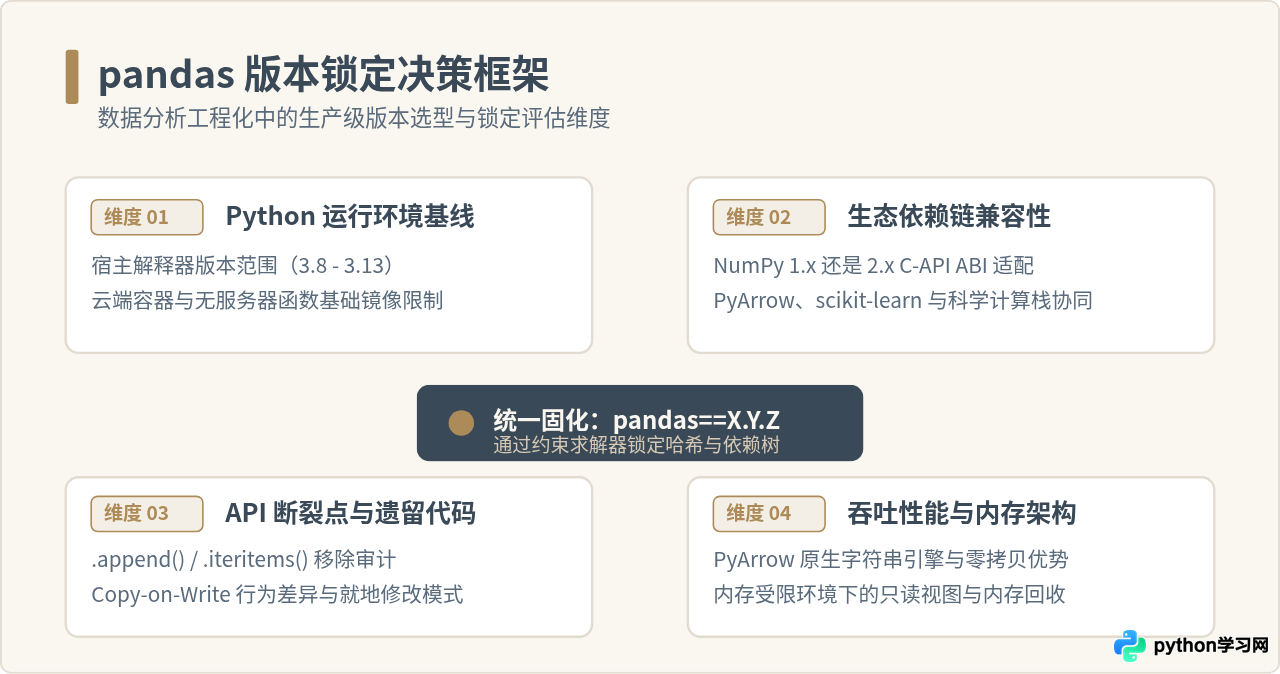
一、为什么数据分析项目必须严格锁定 pandas 版本
在数据工程与分析实践中,如果只在依赖清单中模糊书写 pandas 或宽泛的 pandas>=1.5,构建环境极易在下游自动化调度或新机器拉起时遭遇“漂移”。pandas 在演进到 2.x 以后,底层引入了 PyArrow 数据类型后端、重构了时间戳解析机制,并逐步推行 Copy-on-Write(写时复制)模型,同时彻底废弃了大量在 1.x 时代被广泛滥用的接口。
一旦环境拉取到未经测试的次版本或大版本,最直接的后果是原有 ETL 管道出现致命的 AttributeError、隐式切片赋值引发数据未按预期变更,或者底层 C 扩展与 NumPy 2.x 产生 ABI 冲突导致解释器崩溃(Segmentation Fault)。因此,针对项目特征锁定一个确定性的三位版本号(例如 pandas==2.2.3)是保障分析流程确定性与可复现性的前提。
二、核心分水岭:pandas 关键分支能力与兼容性
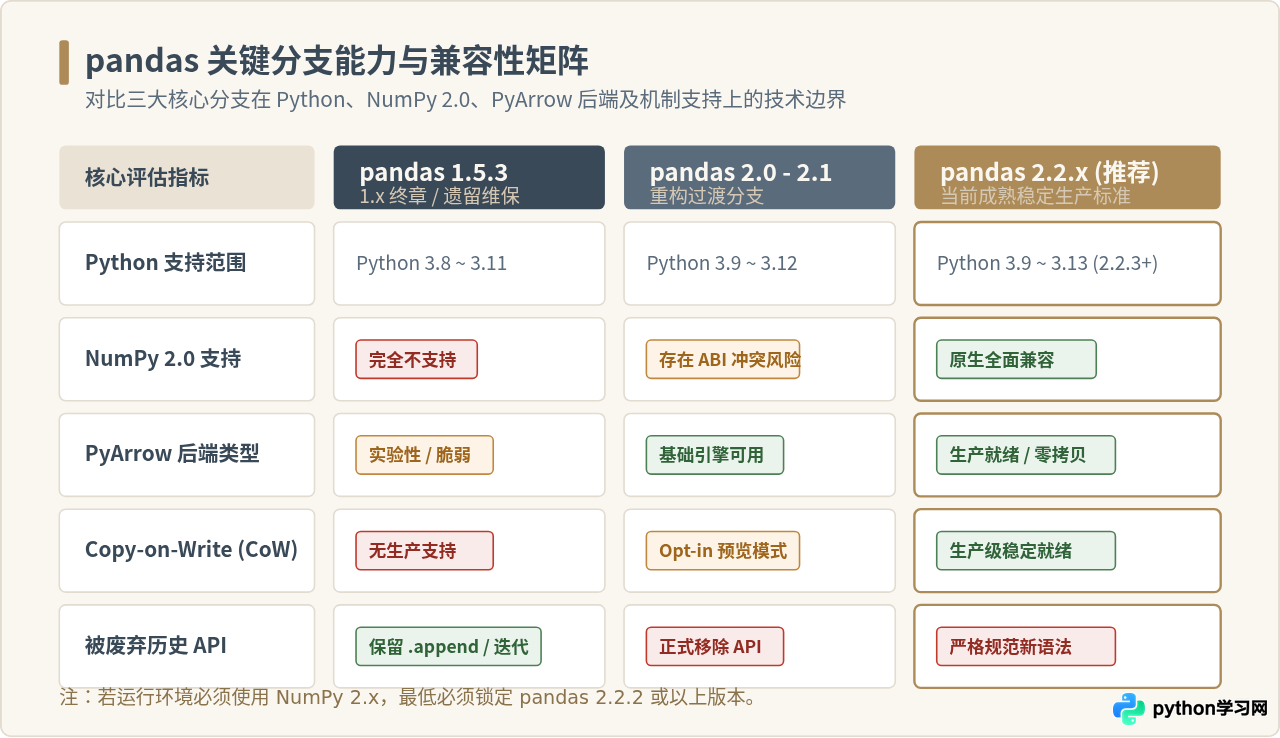
评估版本锁定时,首先要建立对 pandas 历史版本梯队的全局认知。当前数据分析领域主要涉及三个标志性版本区间:1.5.3、2.0.x ~ 2.1.x 以及 2.2.x(目前最新的成熟生产分支)。
1. pandas 1.5.3:1.x 系列的终章与遗留安全岛
发布于 2023 年初的 1.5.3 是 pandas 1.x 的最终维护版本。它的核心价值在于向下兼容性完备。如果你的项目包含数万行历史分析代码,广泛使用了 DataFrame.append()、Series.iteritems() 等传统语法,且生产宿主环境受限于旧版 Linux 发行版内置的 Python 3.8,那么 1.5.3 是唯一的低风险选择。
numpy>=2.0.0,导入 pandas 时会直接抛出 C 扩展二进制不兼容错误。
2. pandas 2.0.x ~ 2.1.x:架构重构的过渡代
pandas 2.0 正式引入了 PyArrow 作为可选列式存储后端,大幅改进了时间戳精度(支持从纳秒放宽到微秒、毫秒),并移除了积累多年的废弃 API。但作为架构剧烈变动的第一代,2.0 和 2.1 在 PyArrow 交互与 Copy-on-Write 预览模式下存在部分边缘边界问题,且对随后发布的 NumPy 2.0 缺乏原生编译兼容。除非是当时已经完成锁定的历史项目,新项目不建议选择该区间。
3. pandas 2.2.x:当前兼顾现代架构与高稳定的基准
pandas 2.2.x(特别是 2.2.2 及后续补丁版本 2.2.3)是当前现代数据分析项目的黄金锁定标准。它带来了两大决定性优势:
- 全面支持 NumPy 2.0:从 2.2.2 开始,pandas 预编译 wheel 完全适配了 NumPy 2.0 C-API,同时向下兼容 NumPy 1.x,彻底化解了科学计算依赖链中的版本锁死难题。
- 生产级 Copy-on-Write(写时复制):在该版本中,CoW 机制已经达到生产可用状态,能够根治困扰数据分析多年的
SettingWithCopyWarning隐式切片篡改问题,并在链式操作中节省大量不必要的深拷贝内存。
三、破坏性变更审计:评估代码是否满足 2.x 要求
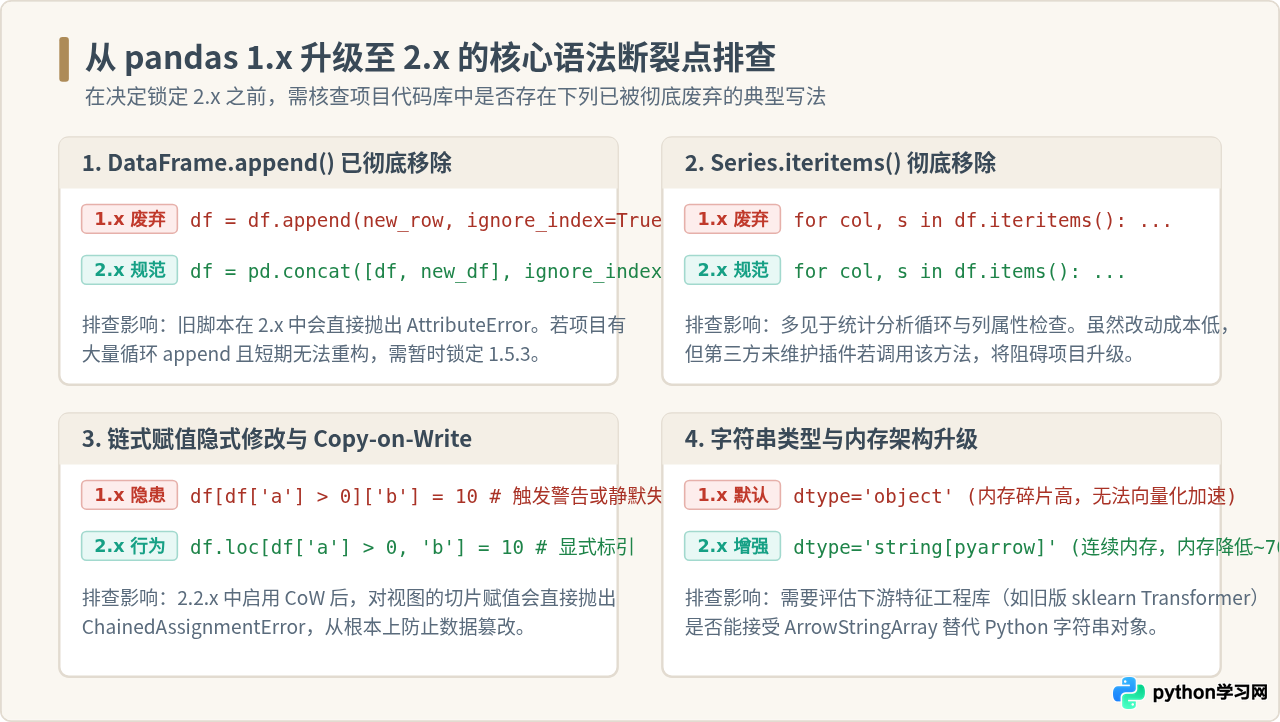
从 1.x 跨越到 2.x 时,许多常见习惯写法被正式移除或改变行为。如果项目代码或所依赖的内部辅助函数包含这些写法,就必须在“重构代码后锁定 2.2.x”与“继续锁定 1.5.3”之间做出权衡。
1. DataFrame.append() 彻底废除
在 1.x 中,初学者常在循环中调用 df = df.append(row)。该方法在 2.x 中被彻底删除,直接抛出 AttributeError: 'DataFrame' object has no attribute 'append'。
规范解法是将多条数据收集到列表或字典中,最终调用 pd.concat([df, new_df], ignore_index=True)。若现有分析项目涉及数百个包含 .append() 的独立脚本且人力无法即时重构,短期内应坚决锁定 pandas==1.5.3。
2. Series.iteritems() 彻底废除
在 2.x 中,为了与 Python 字典原生标准统一,.iteritems() 被正式移除,必须替换为 .items()。该变更虽然批量替换难度低,但如果项目引用了未经维护的内外部第三方扩展库,调用该方法将导致运行时不可逆的中断。
3. 链式赋值与 Copy-on-Write 的深层转变
在 1.x 时代,执行 df[df['age'] > 30]['score'] = 100 会触发著名的 SettingWithCopyWarning,开发者往往难以确定修改究竟生效在原 DataFrame 上还是被抛弃的临时视图上。
而在 pandas 2.2 中显式开启 pd.options.mode.copy_on_write = True 后,对切片视图进行赋值会直接抛出明确的 ChainedAssignmentError,强制要求使用显式标引方式:df.loc[df['age'] > 30, 'score'] = 100。这种严格性在初期可能暴露出旧代码的缺陷,但对长期数据质量具有重要保障价值。
四、操作指南:数据分析项目版本锁定五步落地法
判断并最终固化 pandas 版本的流程不能依赖拍脑袋,应通过结构化的排查链条逐步执行。
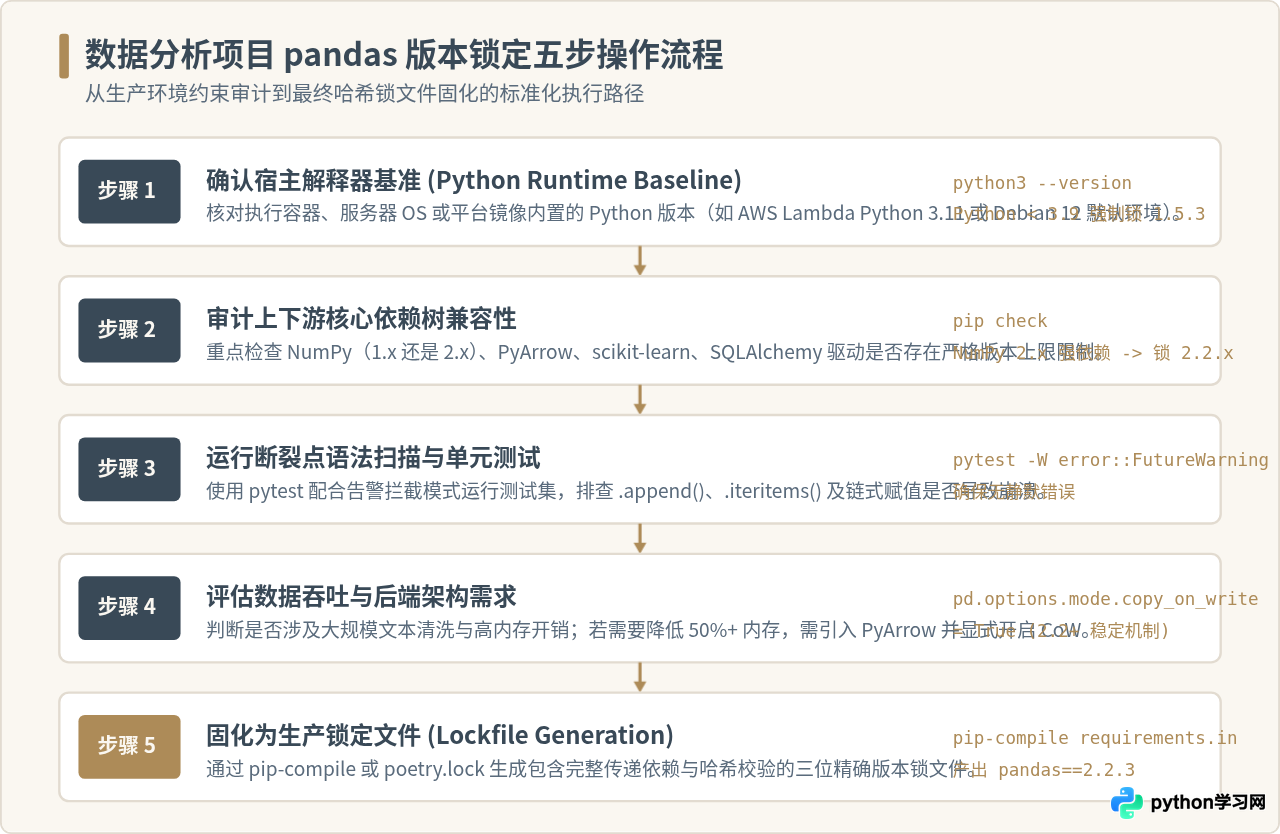
第一步:探测宿主解释器基准
检查部署目标(如开发机、CI/CD 节点、Airflow Worker、AWS Lambda 或基础 Docker 镜像)的 Python 版本:
python3 --version如果宿主环境强制为 Python 3.8,pandas 2.1+ 已不再提供官方预编译二进制,应锁定 pandas==1.5.3;如果环境是 Python 3.10 ~ 3.12,则完全具备升级至 pandas==2.2.3 的基础条件。
第二步:审计上下游科学计算依赖树
在现有或规划的虚拟环境中,执行依赖诊断命令:
pip check重点关注项目中是否有特定包对 NumPy 做了版本限制:
- 如果项目依赖
numba旧版本、某些未更新的量化金融库,明确要求numpy<2.0.0,则锁定pandas==2.2.3配合numpy<2.0.0,或继续锁定pandas==1.5.3。 - 如果项目使用了需要与 Arrow 紧密交互的
pyarrow、polars、duckdb,优先选择pandas==2.2.3,以避免 Arrow 内存格式转换时的额外开销。
第三步:运行断裂点测试与告警排查
在预发布测试环境中将弃用告警提升为致命错误,快速扫描潜在断裂点:
pytest -W error::FutureWarning -W error::DeprecationWarning tests/如果测试套件能够绿灯通过,说明代码资产已经完全脱离了 1.x 废弃 API 的绑定。
第四步:评估内存与后端选型
如果项目包含大量字符串处理(如日志分析、用户行为文本标记),且受限于机器内存限制,可以在 Python 脚本入口处配置现代后端:
import pandas as pd

# 启用写时复制,避免无谓深拷贝
pd.options.mode.copy_on_write = True

# 读取海量文本时显式使用 PyArrow 字符串引擎
df = pd.read_csv("large_logs.csv", engine="pyarrow", dtype_backend="pyarrow")
这种模式需要锁定 pandas==2.2.3 配合 pyarrow>=15.0.0。
第五步:固化精确版本与依赖哈希
确定版本后,不要只在纯文本文件中手动输入 pandas==2.2.3,推荐使用现代依赖锁定工具(如 pip-tools 或 Poetry)锁定全量传递依赖。
在声明文件 requirements.in 中定义顶层目标:
pandas==2.2.3
numpy>=1.26.4,<3.0
pyarrow>=15.0.0
执行编译生成确定性锁文件:
pip-compile --generate-hashes requirements.in -o requirements.txt
生成的 requirements.txt 将包含所有间接依赖(如 python-dateutil、pytz、tzdata)的精确版本与 SHA256 哈希,彻底杜绝环境污染。
五、决策总结:典型场景选型归纳矩阵
为了便于快速对照与决策,下表总结了四种常见项目形态的推荐锁定策略与技术边界。
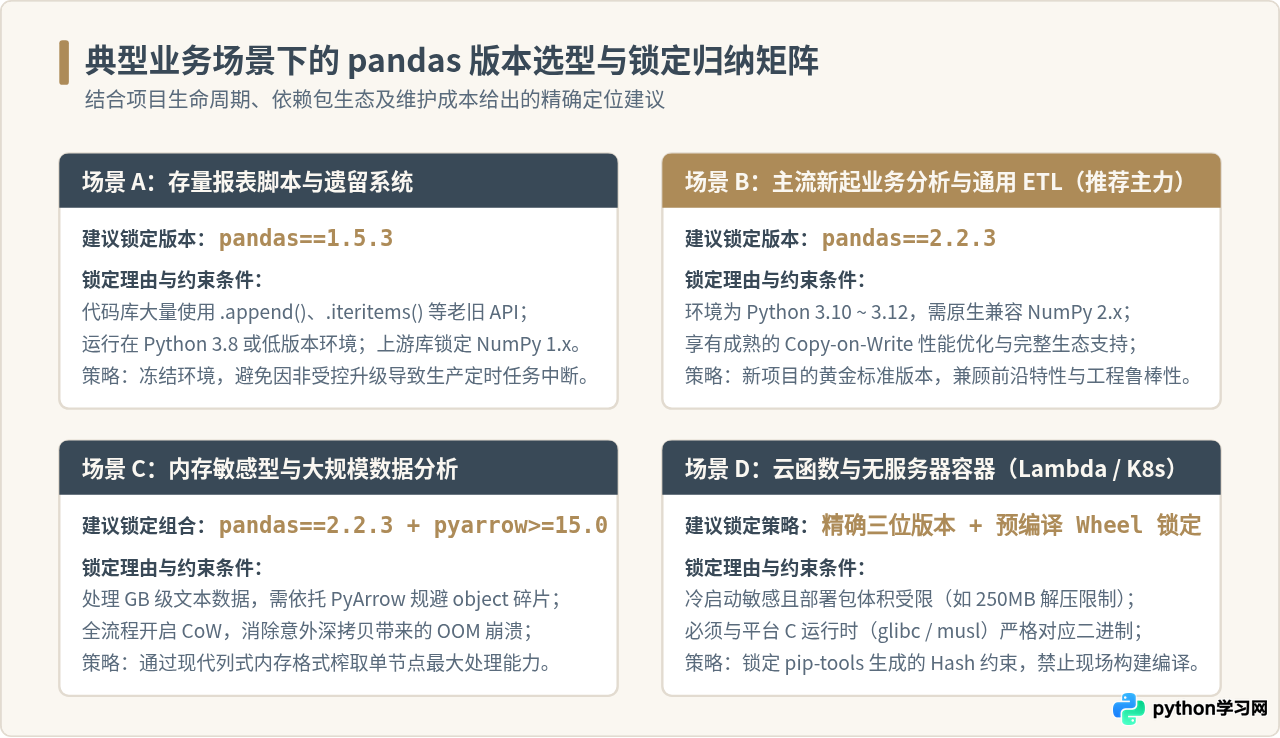
| 业务项目形态 | 推荐锁定版本 | 协同环境依赖 | 核心决策理由 |
|---|---|---|---|
| 历史存量报表与稳态系统 | pandas==1.5.3 |
Python 3.8~3.10numpy<2.0.0 |
完全保留 .append() / .iteritems() 历史兼容性,保障既有脚本零成本平稳运行。 |
| 常规业务分析与新起 ETL | pandas==2.2.3 |
Python 3.10~3.12 NumPy 1.x 或 2.x |
当前生产标准版本,原生兼容 NumPy 2.0,消除断裂期 Bug,拥有成熟的社区支持。 |
| 内存受限与大规模文本管道 | pandas==2.2.3 |
pyarrow>=15.0.0开启 Copy-on-Write |
利用 PyArrow 连续内存布局降低 50%~70% 的字符串内存开销,规避 OOM 风险。 |
| 云函数与无服务器容器 (Serverless) | pandas==2.2.3 |
锁定平台 Wheel pip-compile 哈希 |
严格控制镜像构建层体积与 C 运行时匹配,确保无现场编译损耗与冷启动性能。 |
pandas==2.2.3(或 2.2 分支的后续补丁版本),并在项目初始化阶段就启用 pd.options.mode.copy_on_write = True。这不仅能享受到当下的性能提升与 NumPy 2.0 兼容保障,也为未来向 pandas 3.0 的无缝演进打下了最坚实的基础。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









