

基于菜鸟教程示例的Python爬虫实战:requests与BeautifulSoup入门
以菜鸟教程网页结构为真实示例,系统讲解使用Python requests库获取网页以及BeautifulSoup库提取关键数据的完整操作流程。
假设你正在学习 Python,希望把菜鸟教程(runoob.com)首页上归纳的“核心教程模块名称”及对应的“直达链接”批量提取并整理成文本清单。本文将以菜鸟教程真实的网页排版为分析样本,演示如何使用 Python 的 requests 库发起网络请求,配合 BeautifulSoup(bs4)完成 HTML 标签筛选与数据提取,最终实现一份清晰结构化列表的完整闭环。
一、抓取机制与依赖准备
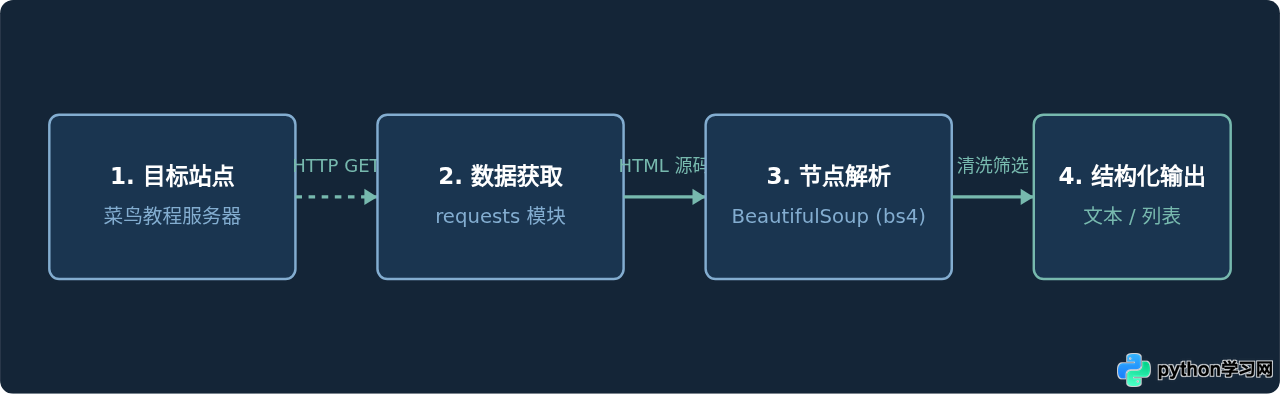
网络爬虫的核心机制可以拆解为两步:第一步是由 requests 扮演浏览器的角色,向目标网站服务器发送 HTTP 请求并获取 HTML 纯文本;第二步是由 BeautifulSoup 扮演解析器的角色,将 HTML 文本构建为树状节点对象,并按标签名、CSS 类名或属性抽取目标字段。
在开始写代码前,需要在命令行终端安装这两个第三方库。同时建议安装 lxml 解析引擎,它的解析效率优于 Python 原生自带的 html.parser:
pip install requests beautifulsoup4 lxml二、分析菜鸟教程目标网页结构
在编写解析逻辑之前,必须先打开浏览器(如 Chrome 或 Edge)访问 https://www.runoob.com/,右键点击网页并选择“检查”(Inspect)。
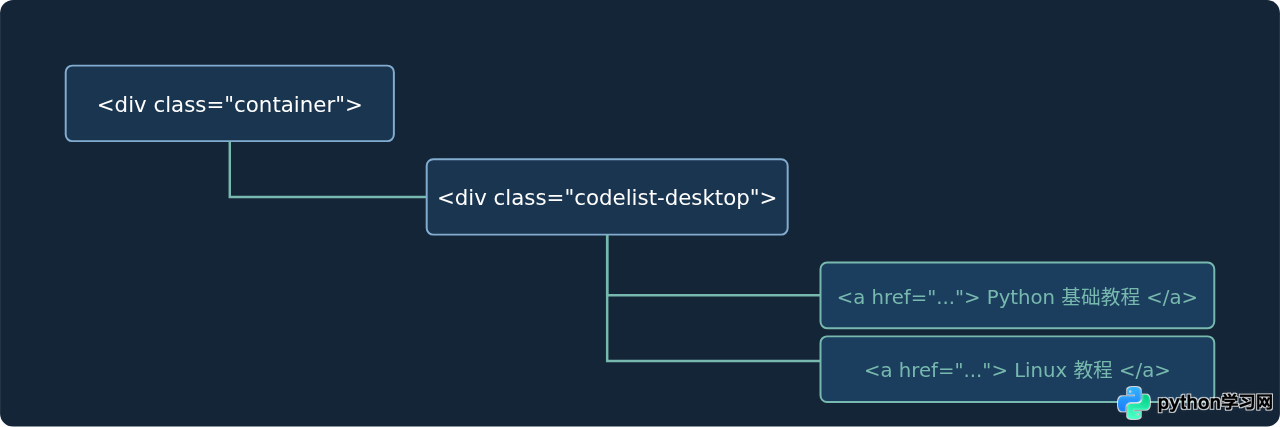
在开发者工具的 Elements 面板中,可以看到菜鸟教程首页将各个技术教程卡片放在特定的容器中。典型的层级结构如下:
- 教程分类区块通常位于包含
class="codelist-desktop"或各个<div class="item">容器中。 - 每个具体教程项目是一个
<a>链接标签,比如<a href="/python/python-tutorial.html">Python 基础教程</a>。 - 链接标签内部可能包含
<h4>标题标签,或者直接包裹文本内容。
三、分步实战:从请求到提取
1. 构建请求并处理编码
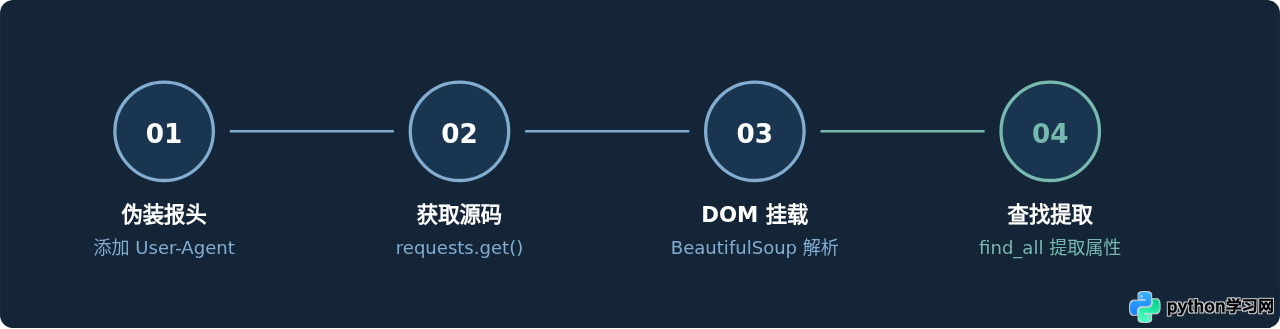
直接使用 requests.get() 获取国内中文网站时,容易遇到乱码问题。这是因为 requests 根据 HTTP 头部猜测的编码有时并不准确。通过显式声明 response.encoding = 'utf-8',可以避免标题出现常见乱码字符。
headers 字典,指定 User-Agent 字段。
2. 编写完整抓取脚本
以下是获取菜鸟教程首页导航分类与示例链接的完整 Python 代码:
import requests
from bs4 import BeautifulSoup
from urllib.parse import urljoin

# 1. 目标地址与请求头设置
url = "https://www.runoob.com/"
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
}

try:
    # 2. 发起请求并核对响应状态
    response = requests.get(url, headers=headers, timeout=10)
    response.raise_for_status()
    response.encoding = 'utf-8'

    # 3. 将网页源码送入 BeautifulSoup 解析
    soup = BeautifulSoup(response.text, 'lxml')

    # 4. 提取目标节点(以首页导航中的各卡片链接为例)
    # 观察菜鸟教程首页结构,定位到包含课程卡片的容器
    course_links = soup.find_all('a', href=True)

    results = []
    for link in course_links:
        title = link.get_text(strip=True)
        href = link['href']

        # 过滤空标题和非教程类链接
        if title and ('tutorial' in href or 'runoob.com' in href or href.startswith('/')):
            # 处理相对路径,拼接为完整可访问 URL
            full_url = urljoin(url, href)
            results.append((title, full_url))

    # 输出前 8 项作为结果校验
    print(f"成功获取链接总数: {len(results)}")
    print("--- 示例数据提取结果 ---")
    for item_title, item_url in results[:8]:
        print(f"教程名称: {item_title:<12} | 链接: {item_url}")

except requests.exceptions.RequestException as e:
    print(f"网络请求发生异常: {e}")
3. 运行输出示例
运行上述脚本后,终端会打印出过滤整理后的真实标题与补齐后的完整 URL(以下为输出示例):
成功获取链接总数: 142
--- 示例数据提取结果 ---
教程名称: HTML 教程    | 链接: https://www.runoob.com/html/html-tutorial.html
教程名称: CSS 教程     | 链接: https://www.runoob.com/css/css-tutorial.html
教程名称: JavaScript  | 链接: https://www.runoob.com/js/js-tutorial.html
教程名称: Python 3 教程| 链接: https://www.runoob.com/python3/python3-tutorial.html
教程名称: C 语言教程   | 链接: https://www.runoob.com/cprogramming/c-tutorial.html
教程名称: Java 教程    | 链接: https://www.runoob.com/java/java-tutorial.html
教程名称: Linux 教程   | 链接: https://www.runoob.com/linux/linux-tutorial.html
教程名称: SQL 教程     | 链接: https://www.runoob.com/sql/sql-tutorial.html
四、关键语法对比与总结
在提取节点信息时,初学者容易混淆 find() 与 find_all(),以及读取属性和读取文字的方式。这里将核心语法归纳如下:
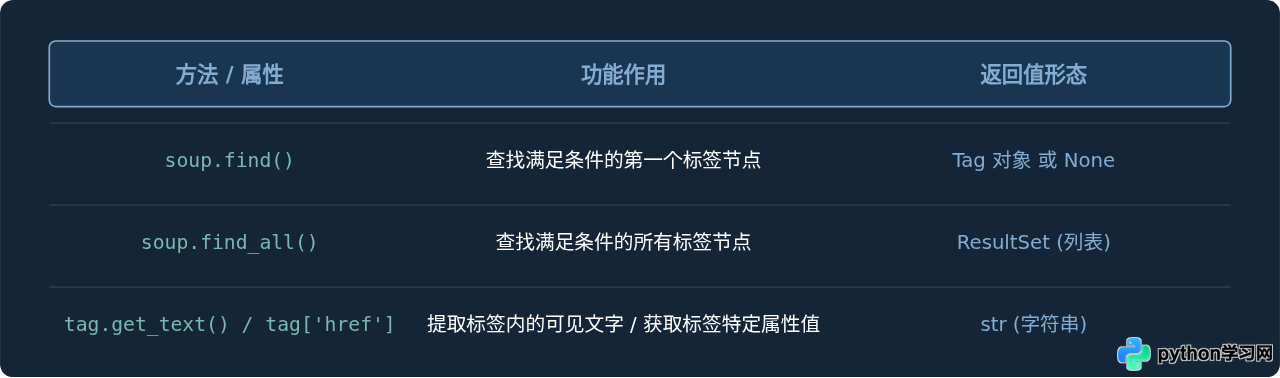
只要掌握了“配置伪装头发送请求 → 浏览器审查元素确认标签结构 → 使用选择器抽取文本与属性”这个标准化链条,便能应对绝大多数采用服务端渲染的静态网页。在深入学习之后,还可以继续拓展 CSS Selector(soup.select())或将抽取的数据保存为 CSV、JSON 文件。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









