

Python爬虫新手入门:用Requests和BeautifulSoup抓取第一个网页
面向零基础读者的Python爬虫入门教程,使用Requests发送HTTP请求、BeautifulSoup解析HTML,完整演示从安装到提取数据的每一步。
这篇教程带你从零完成一个最小的Python爬虫:用Requests库向目标网站发送HTTP请求拿到HTML源码,再用BeautifulSoup把其中需要的数据解析出来。全程只需要十几行代码,完成后你会清楚爬虫最基本的工作流程,也能拿这个骨架去抓取其他简单页面。
准备工作:安装Python和两个库
开始之前需要确认电脑上有Python 3.6或更高版本。打开终端(Windows用命令提示符或PowerShell,macOS/Linux用Terminal),执行:
python --version如果输出类似 Python 3.10.12 的版本号,说明已经安装好了。部分系统需要用 python3 --version 来查看。
接下来安装Requests和BeautifulSoup4。两个库都可以通过pip一次性安装:
pip install requests beautifulsoup4安装完成后在Python交互环境中试一下能否正常导入:
import requests
from bs4 import BeautifulSoup
print("导入成功")
如果没有报错,说明环境准备完毕。
pip 命令提示找不到,试试 pip3 或者 python -m pip install。在有些Linux发行版上还需要先安装 python3-pip 包。第一步:用Requests获取网页HTML
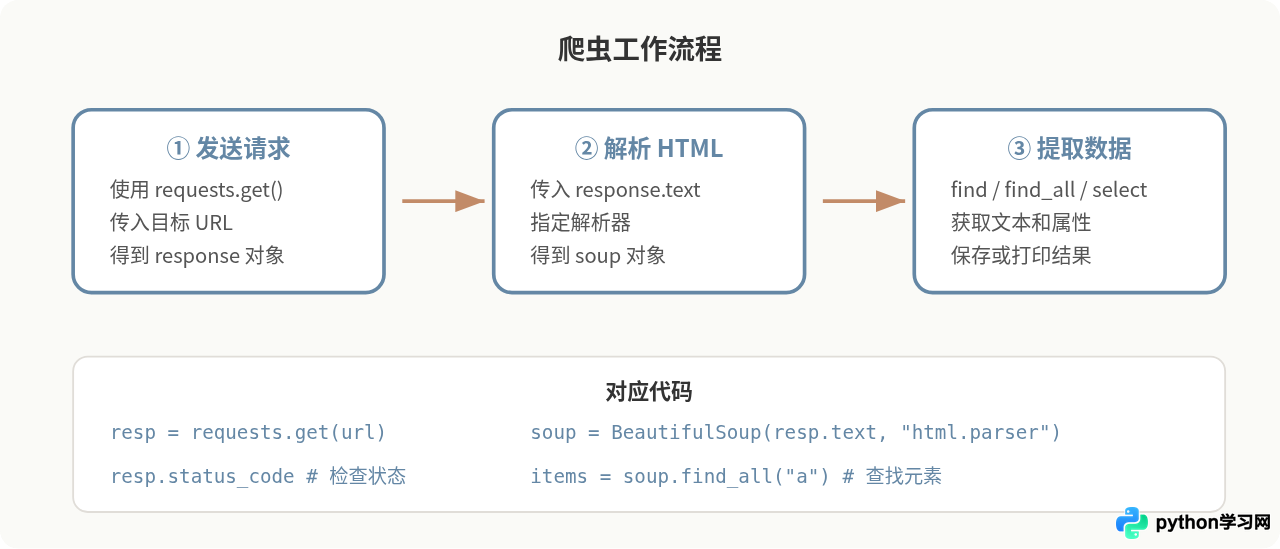
Requests库的作用是模拟浏览器向服务器发送HTTP请求,并拿回响应内容。最常用的是 requests.get(),只需要传入一个URL。
下面以Python官方文档首页为目标做演示,因为它结构稳定、允许正常访问:
import requests

url = "https://docs.python.org/3/"
response = requests.get(url)

print("状态码:", response.status_code)
print("编码:", response.encoding)
print("前200个字符:", response.text[:200])
运行后会看到类似这样的输出(示例):
状态码: 200
编码: utf-8
前200个字符: <!DOCTYPE html>...(HTML源码片段)
几个关键点:
response.status_code返回HTTP状态码,200表示请求成功。response.text是服务器返回的完整HTML文本,后续交给BeautifulSoup解析。response.encoding是Requests根据响应头推断的编码。如果页面出现乱码,可以手动设置response.encoding = "utf-8"。
第二步:用BeautifulSoup解析HTML
拿到HTML源码后,直接用字符串操作去提取数据既繁琐又容易出错。BeautifulSoup会把HTML文本解析成一棵可以方便遍历和搜索的树,几行代码就能定位到想要的元素。
from bs4 import BeautifulSoup

soup = BeautifulSoup(response.text, "html.parser")

# 获取页面标题
print("页面标题:", soup.title.string)
BeautifulSoup() 接收两个参数:第一个是HTML文本,第二个是解析器名称。html.parser 是Python自带的解析器,不需要额外安装。如果需要解析不太规范的HTML,可以安装 lxml(速度更快、容错更好),使用时把第二个参数改成 "lxml"。
查找元素的常用方法
BeautifulSoup提供了两组核心方法来查找元素:
find() 返回第一个匹配的元素,find_all() 返回所有匹配元素的列表。它们都支持按标签名、属性、CSS类名等条件查找。
# 找到第一个 <a> 标签
first_link = soup.find("a")
print("第一个链接:", first_link.get("href"))

# 找到所有 <a> 标签
all_links = soup.find_all("a")
print(f"共找到 {len(all_links)} 个链接")

# 按class查找
sidebar = soup.find("div", class_="sphinxsidebar")

# 按id查找
content = soup.find("div", id="content")
另外还有 select() 方法,支持CSS选择器语法,用起来和前端开发写CSS选择器一样:
# CSS选择器方式
links_in_content = soup.select("div.body a")
for link in links_in_content[:5]:
    print(link.get("href"), link.get_text(strip=True))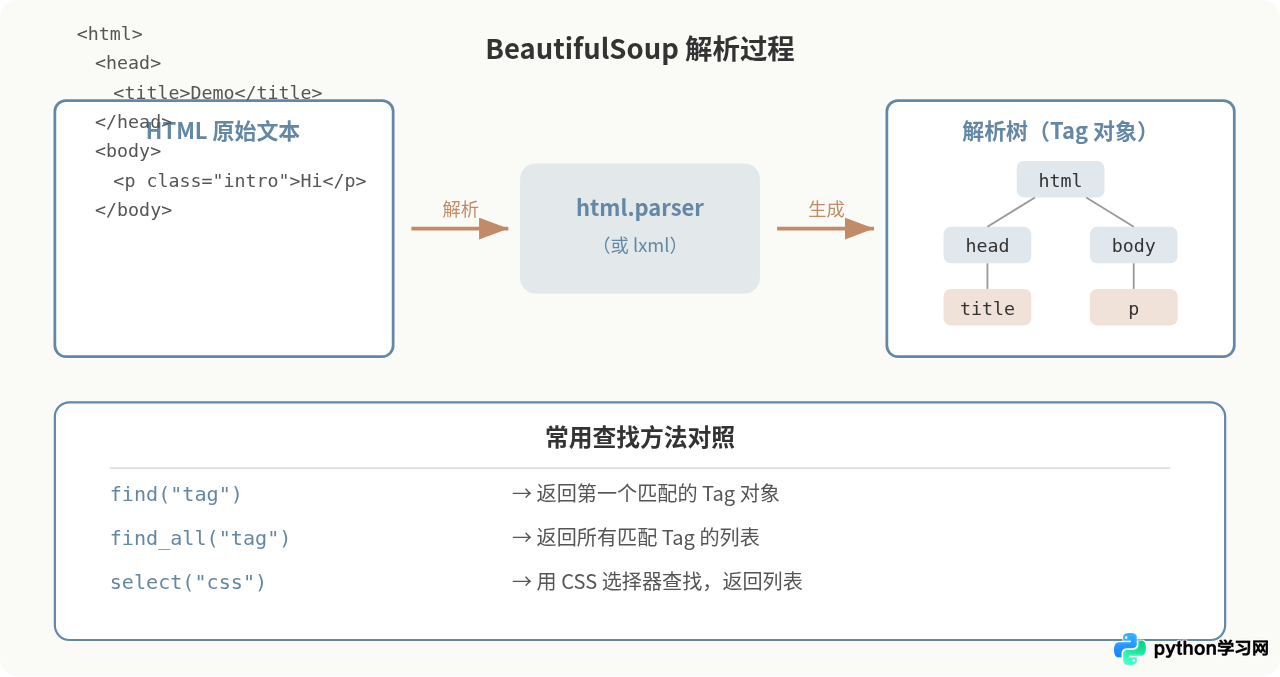
第三步:一个完整的抓取示例
把前面的步骤串起来,写一个完整的脚本——抓取Python官方文档首页上的所有章节链接,提取链接文字和对应的URL:
import requests
from bs4 import BeautifulSoup

# 1. 发送请求
url = "https://docs.python.org/3/"
response = requests.get(url)

if response.status_code != 200:
    print(f"请求失败,状态码: {response.status_code}")
    exit()

# 2. 解析HTML
soup = BeautifulSoup(response.text, "html.parser")

# 3. 提取数据——找到所有章节链接
#    文档首页的章节链接在 class="sphinxglobaltoc" 的 div 中
links = soup.select("a.reference.internal")

print(f"共找到 {len(links)} 个内部链接\n")
print("前10个链接:")
print("-" * 50)

for link in links[:10]:
    text = link.get_text(strip=True)
    href = link.get("href", "")
    print(f"  {text}")
    print(f"  -> {href}")
    print()
示例输出可能类似这样:
共找到 42 个内部链接

前10个链接:
--------------------------------------------------
  What's New in Python
  -> whatsnew/3.12.html

  Tutorial
  -> tutorial/index.html

  Library Reference
  -> library/index.html
  ...
核心逻辑就三步:发请求 → 解析 → 提取。实际项目中可能需要处理翻页、登录、反爬等情况,但底层思路不变。
理解获取到的数据:Tag对象的常用操作
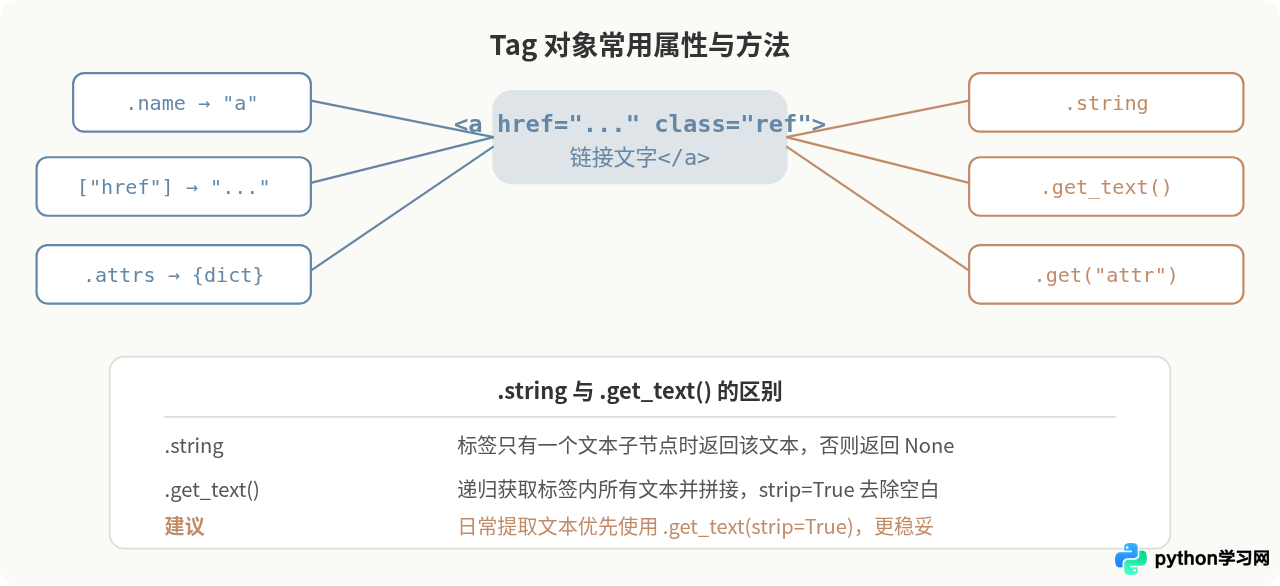
BeautifulSoup查找到的每个元素都是一个Tag对象,了解它的几个常用属性和方法,提取数据时会方便很多:
tag = soup.find("a")

# 获取标签名
print(tag.name)          # 输出: a

# 获取属性值
print(tag["href"])       # 获取href属性
print(tag.get("href"))   # 同上,但属性不存在时返回None而非报错
print(tag.attrs)         # 获取所有属性的字典

# 获取文本内容
print(tag.string)        # 标签内的直接文本(只有一个文本子节点时)
print(tag.get_text())    # 获取标签内所有文本,包括子标签的
print(tag.get_text(strip=True))  # 去除首尾空白
tag.string 和 tag.get_text() 的区别值得注意:当标签内部还嵌套了其他标签时,tag.string 会返回 None,而 tag.get_text() 会把所有子元素的文本拼接起来。日常使用 get_text(strip=True) 更稳妥。
容易踩的坑和注意事项
编码问题
有些中文网页的编码声明和实际编码不一致,导致Requests自动推断出错。如果抓取结果出现乱码,可以先查看网页源码里 <meta charset="..."> 声明的编码,然后手动指定:
response.encoding = "gbk" # 或 "gb2312"、"utf-8"请求被拒绝
有些网站会检查请求头中的 User-Agent 字段,如果发现不是浏览器就直接拒绝。解决方法是在请求时加上一个浏览器的 User-Agent:
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
}
response = requests.get(url, headers=headers)
动态加载的内容抓不到
Requests只能拿到服务器直接返回的HTML。如果页面上的数据是通过JavaScript动态加载的(比如下拉加载更多、Ajax请求),response.text 里不会包含这些内容。这种情况需要找到数据的API接口直接请求,或者使用Selenium、Playwright等可以执行JavaScript的工具。这已经超出本教程的范围,但知道有这个限制很重要。
抓取频率
短时间内对同一个网站发送大量请求,可能导致IP被封或给对方服务器造成压力。即使是练习,也建议在请求之间加上间隔:
import time
time.sleep(1)  # 每次请求后等待1秒
把抓取结果保存到文件
数据抓取出来之后通常需要保存。最简单的方式是写入CSV文件,Python标准库就支持:
import csv
import requests
from bs4 import BeautifulSoup

url = "https://docs.python.org/3/"
response = requests.get(url)
soup = BeautifulSoup(response.text, "html.parser")

links = soup.select("a.reference.internal")

with open("links.csv", "w", newline="", encoding="utf-8") as f:
    writer = csv.writer(f)
    writer.writerow(["文本", "链接"])  # 写入表头
    for link in links:
        text = link.get_text(strip=True)
        href = link.get("href", "")
        writer.writerow([text, href])

print(f"已保存 {len(links)} 条数据到 links.csv")
运行后会在脚本同目录下生成 links.csv 文件,用Excel或文本编辑器打开就能看到整理好的数据。
总结
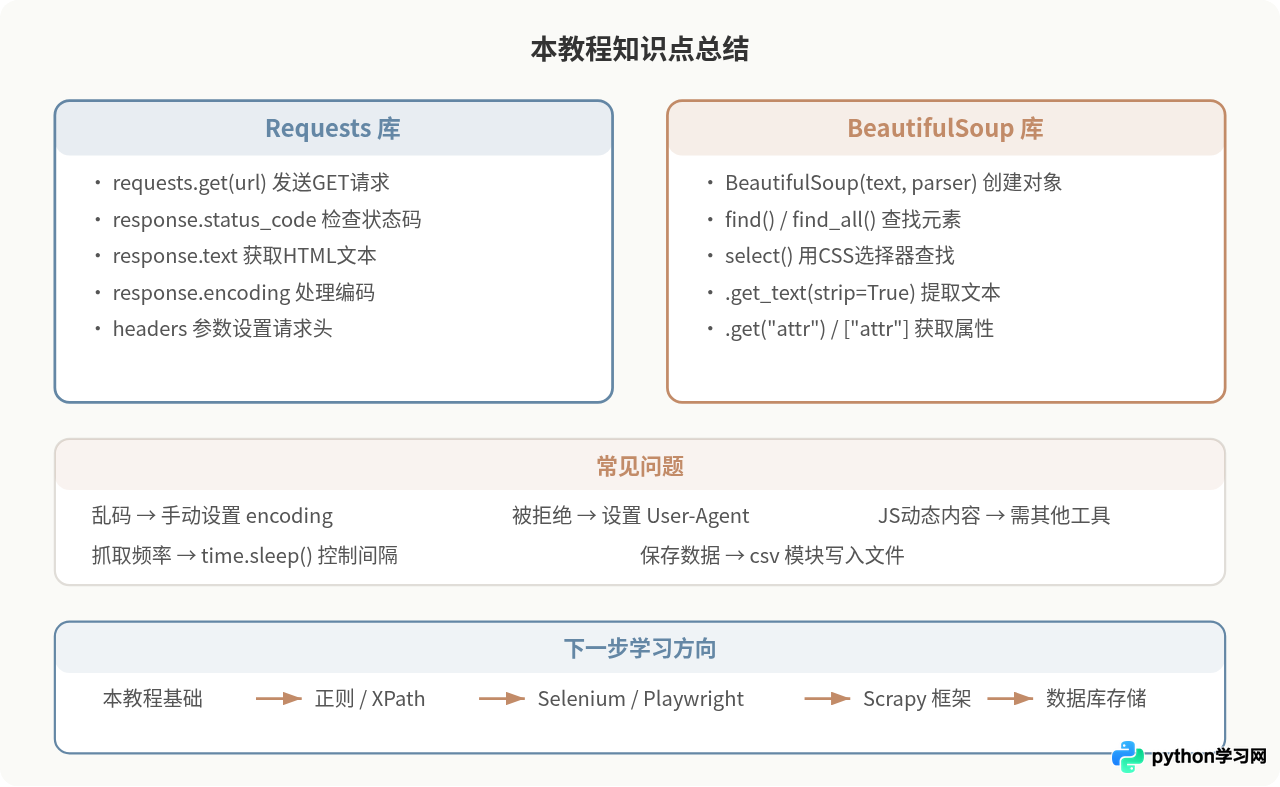
这篇教程完成了一个最基本的Python爬虫:用Requests发送HTTP请求获取HTML页面,用BeautifulSoup解析HTML并提取需要的数据,最后把结果保存到CSV文件。整个过程的代码量很小,核心就是 requests.get() → BeautifulSoup() → find_all() / select() 这条链路。
掌握这个基本流程之后,可以尝试抓取其他静态网页练手。遇到抓不到数据的情况,先检查三件事:状态码是否正常、目标内容是否在HTML源码里、查找条件(标签名、class、id)是否写对。这三个检查能解决新手阶段大部分问题。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









