

Python多线程爬虫为什么快?GIL限制下的IO密集型优势分析
深入解析Python多线程网络爬虫在GIL全局解释器锁限制下依然能够成倍提升抓取速度的底层机制,剖析IO密集型任务特性、系统调用释放GIL原理与工程实践方案。
很多初学者在刚接触 Python 时都会被“全局解释器锁(GIL)导致多线程无法利用多核”的说法所困扰,甚至误以为 Python 多线程一无是处。然而在网络爬虫工程中,多线程却能带来成倍甚至数十倍的速度跃升。本文将深入剖析 GIL 的真实限制边界,结合 CPython 底层 Socket I/O 的运行机制,揭示多线程在爬虫场景下高效提速的根本原因。
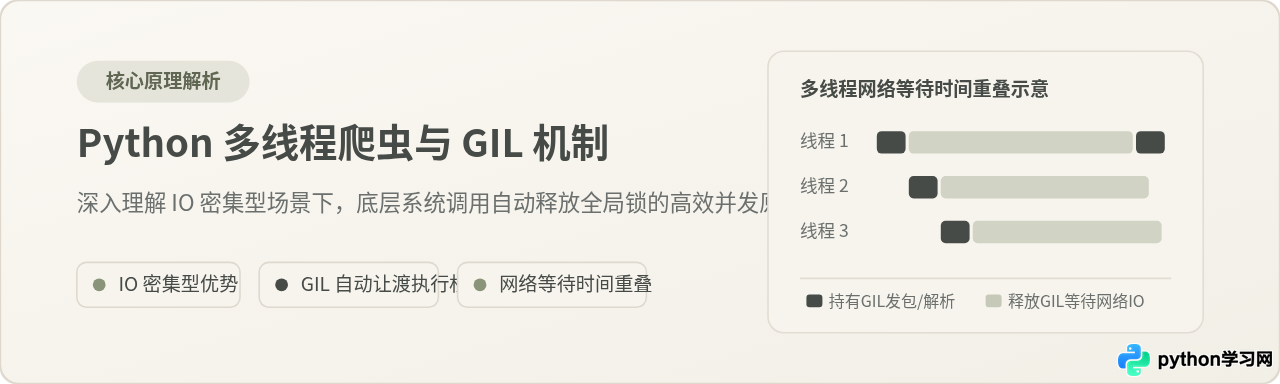
Python 多线程爬虫之所以快,并不是因为打破了全局解释器锁(GIL)去多核并行计算,而是因为网络爬虫是极端的 I/O 密集型任务。一个网络请求中 95% 以上的时间都在等待远程网络往返(RTT),CPU 计算耗时微乎其微。CPython 解释器在调用底层 Socket 执行网络收发时会自动释放 GIL;在等待响应的空闲期内,其他就绪线程可以无缝接管 CPU 继续发起新请求,从而实现网络等待时间的充分重叠。
一、认识误区辨析:GIL 究竟限制了什么?
在讨论爬虫加速之前,必须先澄清关于 GIL 的普遍误解。GIL(Global Interpreter Lock,全局解释器锁)是 CPython 解释器为了保证内部对象内存管理(特别是引用计数机制)线程安全而引入的一把互斥锁。它的规则极其直接:在同一时刻,同一个 Python 解释器进程内只允许一个原生线程执行 Python 字节码。
这个规则让很多人得出了一个看似逻辑严密却不全面的推论:“既然同一时间只能跑一个线程,那多线程就无法实现并行,所以多线程毫无加速价值。”这个推论在特定的场景下是正确的,但在网络爬虫中却完全不成立。关键分水岭在于任务类型:
- CPU 密集型任务(如大矩阵运算、科学计算、图像编解码、压缩解压):线程的全部时间都在高负荷消耗 CPU 算力。此时多个线程在单个核上被 GIL 强制串行调度,并且频繁的线程上下文切换与锁抢占还会带来额外的系统开销。在这种情况下,Python 多线程往往比单线程还要慢。
- I/O 密集型任务(如网络爬虫、文件读写、数据库查询):线程的绝大多数生命周期都在等待外部输入输出设备或网络信号返回,本地 CPU 计算所占时间比例极小(通常不足 5%)。
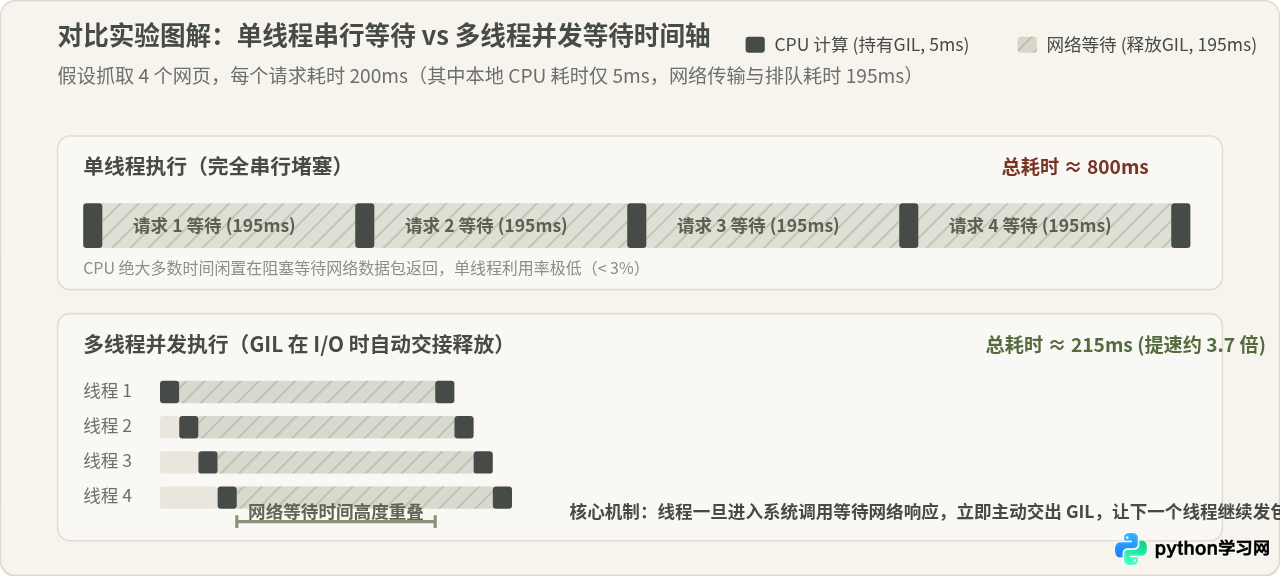
假设我们编写一个抓取 4 个网页的简单爬虫程序,每个请求需要消耗 200ms。其中本地构造 HTTP 请求及最终解析响应只需要 5ms 的 CPU 运算,而剩余的 195ms 都是数据包在网线、光纤与远程服务端之间往返的等待时间。单线程执行时,程序必须呆滞地等待前一个网页完全返回,才发起第二个请求,CPU 在 97% 的时间里处于完全闲置;而在多线程模型中,4 个线程几乎在第一瞬间将 4 个网络请求全部发送出去,随后的漫长等待在时间轴上彼此重叠。
二、底层机制剖析:Socket 调用中的 GIL 释放流程
许多开发者会有疑问:“既然多线程是在同一个 CPU 核心上交替轮转,为什么线程 1 在等待网络数据时,线程 2 可以运行?GIL 不会卡住线程 2 吗?”
答案隐藏在 CPython 解释器处理底层系统调用的实现中。Python 标准库中的 socket 模块由 C 语言编写。当 Python 代码执行到网络收发方法(例如底层 socket.connect()、socket.send()、socket.recv() 以及封装它们的 urllib 和 requests)时,CPython 源码在进入阻塞式系统调用之前,会显式调用一对内置宏:Py_BEGIN_ALLOW_THREADS 与 Py_END_ALLOW_THREADS。
1. 宏指令的真实工作流程
- 释放 GIL 锁:在发起系统内核网络调用(如操作系统的
select、epoll或阻塞recv)之前,宏Py_BEGIN_ALLOW_THREADS立即释放当前线程持有的 GIL,并将当前线程在 Python 内部的状态标记为“非运行中”。 - 内核等待挂起:该线程进入操作系统的等待队列,等待网卡中断和 TCP 数据包到达。在此期间,该线程不执行任何 Python 字节码,也不霸占任何 CPU 算力。
- 就绪线程接管:由于 GIL 已经被释放,操作系统与 Python 调度器立即唤醒就绪队列中的下一个线程(如线程 B),线程 B 顺畅取得 GIL,开始执行其 Python 代码并发出下一个 HTTP 请求。
- 数据到达与重新竞争:当远程服务器的 HTML 数据终于抵达网卡,操作系统唤醒线程 A。在线程 A 从 C 语言层返回 Python 解释器继续执行后续代码之前,宏
Py_END_ALLOW_THREADS会强制要求线程 A 重新获取 GIL。一旦成功持有 GIL,线程 A 即可利用这短暂的数毫秒完成 HTML 正文提取,随后结束或进入下一次循环。
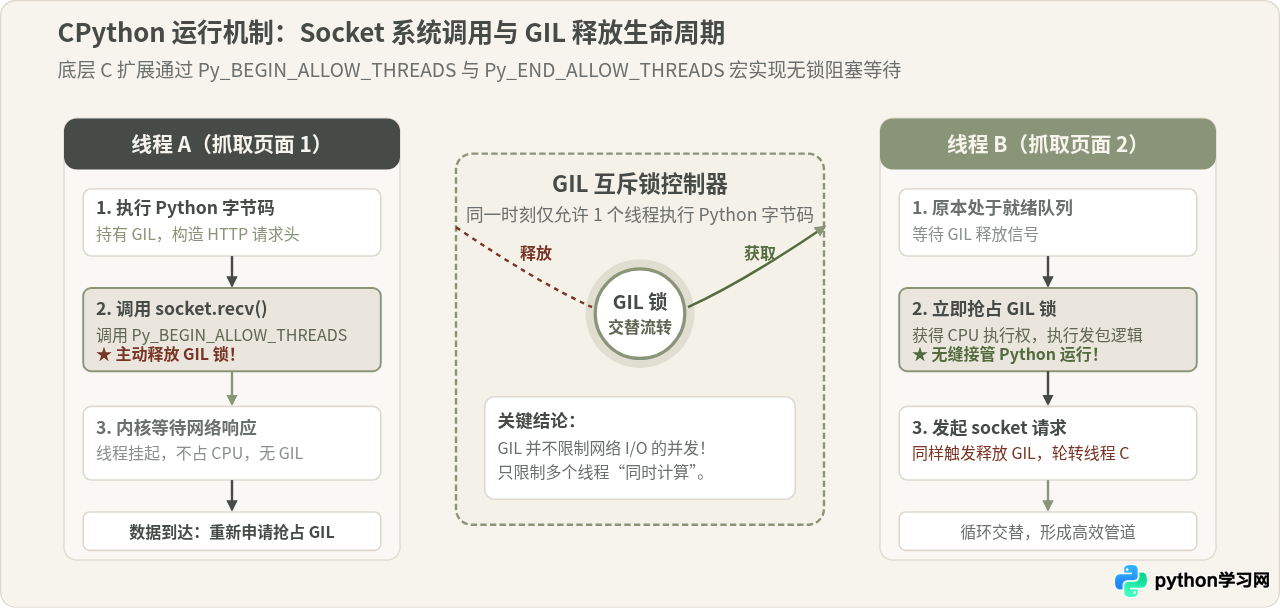
由此可见,GIL 限制的仅仅是 Python 字节码的并行执行,从未限制底层操作系统 I/O 的并发推进。网络 I/O 并不依赖 Python 虚拟机去跑,网卡与操作系统网络栈本身就是独立于 Python 运行时的底层硬件与内核系统。
三、工程实战:基于 ThreadPoolExecutor 的标准化爬虫流水线
在早期的 Python 代码中,很多人习惯直接使用 threading.Thread 手动 start() 和 join()。但在生产环境中,无节制地创建原生线程容易引起内存激增、线程栈溢出与系统崩溃。现代 Python 推荐使用标准库自带的高级封装:concurrent.futures.ThreadPoolExecutor。
一个健壮的多线程爬虫需要涵盖任务派发、合理超时控制、异常隔离与线程安全收集五个核心环节:
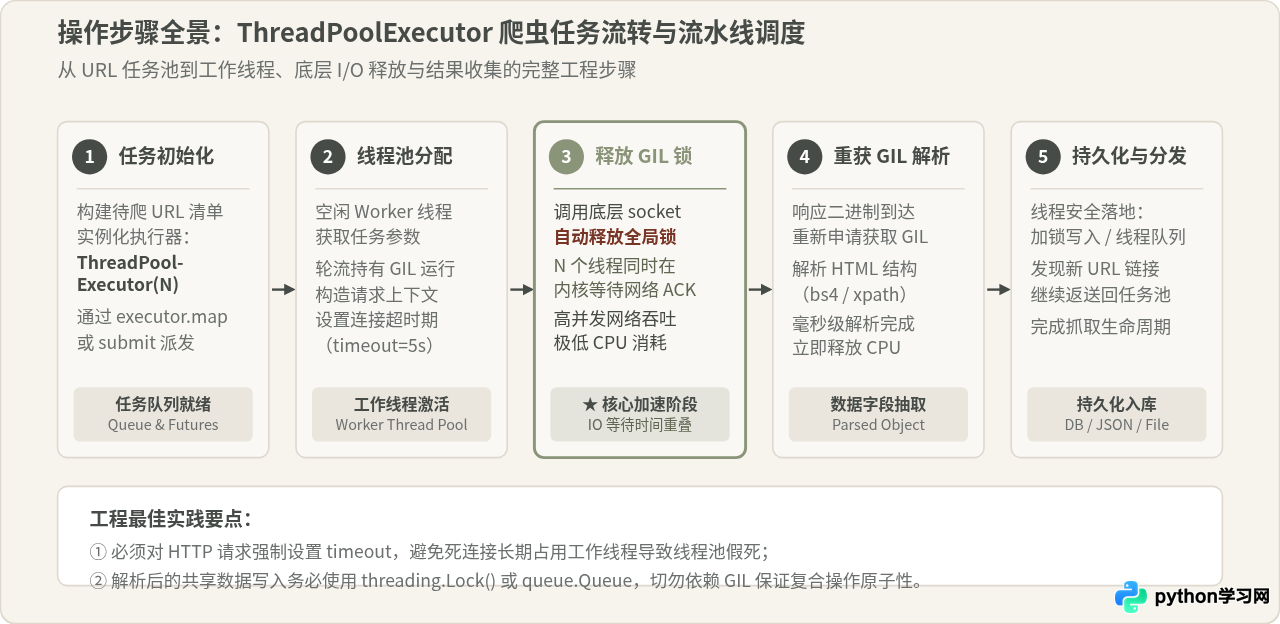
完整代码示例:可运行的受控线程池爬虫
以下代码使用 Python 3 标准库构建,无需安装第三方依赖。代码通过设置严密的 timeout 确保工作线程不会被死连接卡死,并通过异常捕获保证单个 URL 失败不会影响整个采集批次:
# -*- coding: utf-8 -*-
import concurrent.futures
import urllib.request
import urllib.error
import time

# 模拟待抓取的目标 URL 列表
TARGET_URLS = [
    f"https://httpbin.org/delay/1?page={i}" for i in range(1, 9)
]

def fetch_single_url(url: str, timeout: int = 5) -> dict:
    """单个 URL 的网络抓取工作单元,包含超时与异常控制"""
    start_ts = time.time()
    req = urllib.request.Request(
        url,
        headers={"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) SimpleSpider/1.0"}
    )
    try:
        # 进入底层系统调用,触发 Py_BEGIN_ALLOW_THREADS 释放 GIL
        with urllib.request.urlopen(req, timeout=timeout) as response:
            content_bytes = response.read()
            elapsed = time.time() - start_ts
            return {
                "url": url,
                "status": response.status,
                "bytes_len": len(content_bytes),
                "elapsed": round(elapsed, 2),
                "error": None
            }
    except urllib.error.URLError as e:
        return {"url": url, "status": 0, "bytes_len": 0, "elapsed": round(time.time() - start_ts, 2), "error": str(e)}
    except Exception as e:
        return {"url": url, "status": 0, "bytes_len": 0, "elapsed": round(time.time() - start_ts, 2), "error": str(e)}

def run_crawler_pipeline(urls, max_workers: int = 4):
    """使用线程池执行批量并发采集"""
    total_start = time.time()
    print(f"[*] 启动爬虫任务,目标总数: {len(urls)},工作线程数: {max_workers}")

    results = []
    # 使用上下文管理器安全管理线程池生命周期
    with concurrent.futures.ThreadPoolExecutor(max_workers=max_workers) as executor:
        # 提交所有采集任务到线程池
        future_map = {executor.submit(fetch_single_url, url): url for url in urls}

        # as_completed 按照任务完成的先后顺序实时返回迭代结果
        for future in concurrent.futures.as_completed(future_map):
            target_url = future_map[future]
            try:
                data = future.result()
                results.append(data)
                status_desc = f"状态: {data['status']}" if not data['error'] else f"异常: {data['error']}"
                print(f"  [√] 完成: {target_url} | 耗时: {data['elapsed']}s | {status_desc}")
            except Exception as exc:
                print(f"  [!] 抓取发生未捕获异常 {target_url}: {exc}")

    total_elapsed = round(time.time() - total_start, 2)
    print(f"[*] 全部采集完成!累计耗时: {total_elapsed}s")
    return results

if __name__ == "__main__":
    run_crawler_pipeline(TARGET_URLS, max_workers=4)
示例运行输出(标准终端环境)
实测数据分析:每个请求受远程 delay/1 接口限制至少耗时 1 秒以上。如果采用单线程依次抓取 8 个链接,总耗时将稳定超过 8 × 1.3s ≈ 10.4s;而采用 4 线程后,8 个任务分两批并行等待,整体仅耗时 2.72 秒,速度提升接近 4 倍,且 CPU 占用率维持在 1% 以下。
四、性能边界与工程避坑:线程并非越多越好
既然多线程能重叠网络等待,那是否意味着只要把 max_workers 设为 1000 甚至 5000,爬虫速度就能起飞?答案是否定的。多线程并发存在明确的物理与工程边界:
1. 线程膨胀带来的三大边际负收益
- 系统上下文切换与内存开销:Python 的
threading.Thread映射的是操作系统原生内核线程。在 64 位 Linux/macOS 系统中,每个线程默认会预分配数兆字节(MB)的虚拟内存栈空间。如果开设几千个线程,仅线程栈内存就会吃掉数吉字节(GB),同时操作系统在成千上万个线程间来回切换(Context Switch)的损耗将剧增。 - 文件描述符(FD)与网络端口耗尽:每个处于连接状态的 Socket 都会占用一个文件描述符。操作系统的
ulimit -n默认通常为 1024。过多的并发请求不仅容易遭遇Too many open files报错,还会迅速消耗本地临时端口,导致大量 TCP 连接处于TIME_WAIT状态。 - 目标服务端的风控与限流(Rate Limiting):绝大多数中大型网站都有高防网关(如 Cloudflare、WAF)与频率限制。极高的突发请求会直接触发
HTTP 429 Too Many Requests或直接拉黑 IP。爬虫追求的是稳定的吞吐,而非瞬时暴击。
2. 线程池配置建议
对于常规的 Python 多线程爬虫,推荐的线程数设置原则如下:
- Python 标准库默认规则:在 Python 3.8+ 中,
ThreadPoolExecutor的默认线程数设定为min(32, (os.cpu_count() or 1) + 4),这适合通用的混合任务。 - 网络延迟较高、单页面抓取较慢的站点:建议将线程数设定在 10 ~ 30 之间。在这个区间内,网络等待时间能够充分被平摊,且系统内存与上下文切换开销极小。
3. 两个必须警惕的编码陷阱
如果在 requests.get() 或 urlopen() 中漏传 timeout,当目标服务器发生丢包或僵死时,底层 Socket 将一直阻塞等待,该工作线程将永远无法归还给线程池。久而久之,所有工作线程都会被卡死在僵尸连接中,导致整个爬虫程序无限期停摆。
GIL 只能保证单条 Python 字节码指令的原子性,无法保证复合业务逻辑的原子性。例如多线程同时执行 counter += 1 或 if url not in visited: visited.append(url),在底层字节码层面包含了读取(LOAD)、修改(INPLACE_ADD)、写回(STORE)多个步骤。如果中间触发了线程切换,依然会发生严重的线程安全竞态问题(Data Race)。因此,对共享数据结构的写入,必须使用 threading.Lock() 或自带线程安全机制的 queue.Queue。
五、技术选型矩阵:多线程、协程与多进程如何取舍?
在面对复杂的爬虫与并发需求时,Python 提供了三种主流并发技术栈:多线程(Threading)、异步协程(Asyncio)以及多进程(Multiprocessing)。根据核心瓶颈与工程成本进行选型,才能达到最优的开发收益:
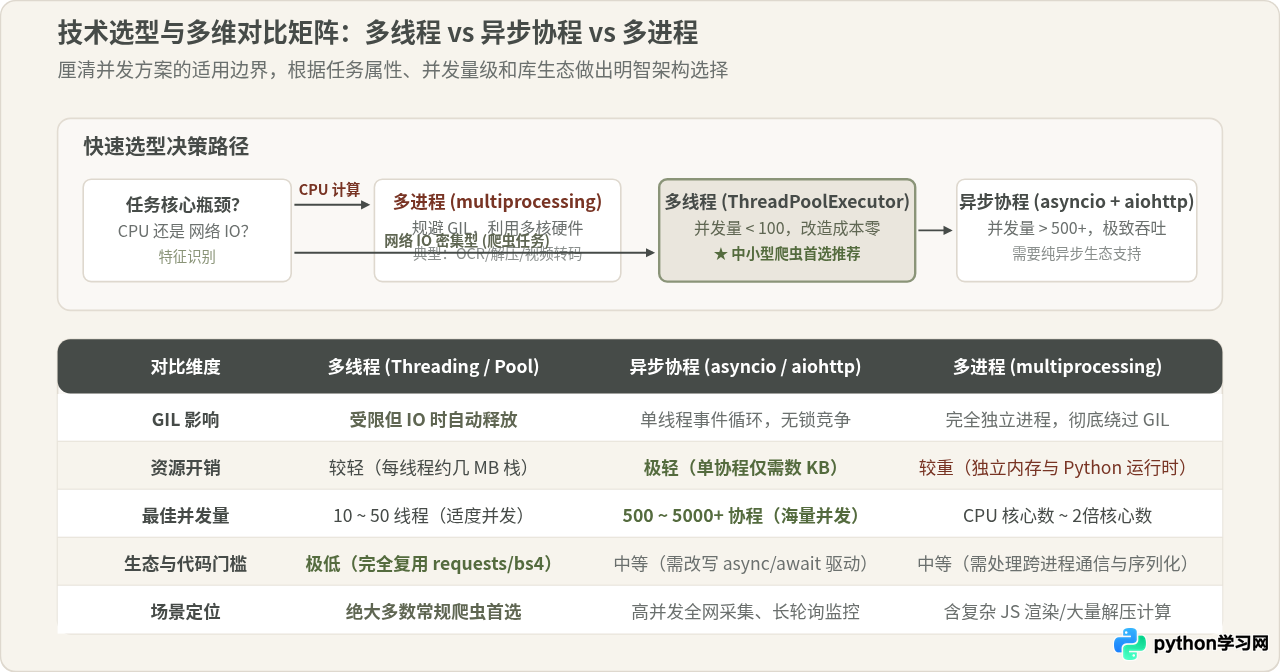
| 方案类型 | GIL 限制应对方式 | 单机推荐并发规模 | 代码重构门槛 | 最佳适用业务场景 |
|---|---|---|---|---|
| 多线程 (ThreadPoolExecutor) | I/O 阻塞时自动释放 GIL | 10 ~ 50 线程 | 极低(完全复用同步库与现有代码) | 中小规模爬虫、企业内部接口数据采集、办公自动化抓取 |
| 异步协程 (asyncio + aiohttp) | 单线程非阻塞事件循环,无锁竞争 | 500 ~ 5000+ 协程 | 中高(需使用 async/await 纯异步驱动) | 全网高频数据采集、行情盯盘监控、万级链接高吞吐爬虫 |
| 多进程 (ProcessPoolExecutor) | 独立进程与解释器,完全规避 GIL | CPU 核心数 ~ 2倍核心数 | 中等(需处理跨进程 IPC 与对象序列化) | 爬虫伴随大量本地 CPU 计算(如图像验证码识别、解密与格式转换) |
从工程性价比角度看,对于绝大部分日常网页抓取任务,多线程爬虫依然是平衡了开发效率、心智负担与性能加速的最佳利器。在不需要改写既有网络库逻辑的前提下,只需封装几行 ThreadPoolExecutor,即可彻底激活 Python 在 I/O 密集型领域的并发吞吐潜力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









