

Python并发选型指南:多线程、多进程与Asyncio的场景对比

在 Python 并发开发中,选型的核心在于准确识别任务瓶颈(计算密集还是 I/O 密集)与系统的并发规模:对于利用多核算力的计算任务,多进程是唯一能够突破 GIL 限制的选择;对于中小规模阻塞式 I/O,多线程能够以极低的重构成本复用传统同步库;而面对数千至数万级连接的高并发网络 I/O,基于单线程非阻塞事件循环的 Asyncio 则能提供最优的吞吐量与极低内存开销。本文将通过底层机制、时序对比、决策流程与实战代码,为你建立清晰可落地的选型依据。
一、底层机制剖析:从 GIL、进程空间与事件循环说起
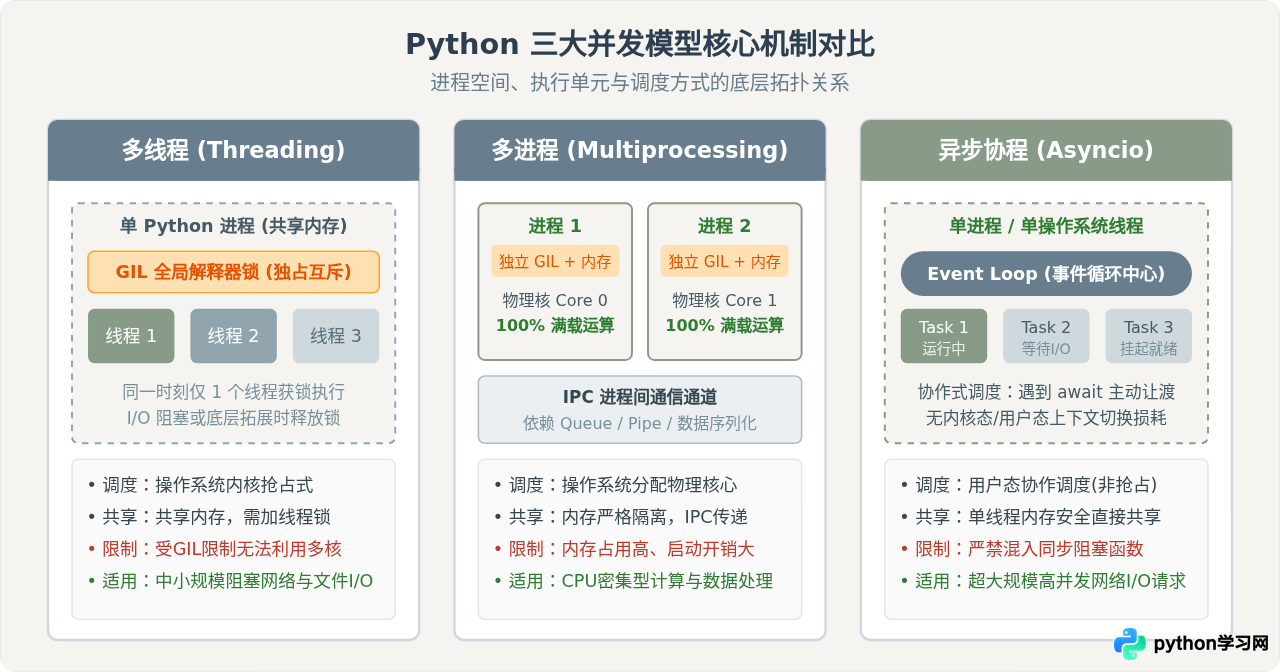
理解 Python 并发工具差异的前提,是弄清它们在操作系统与解释器层面的工作方式。标准 CPython 解释器拥有一个核心机制——全局解释器锁(GIL,Global Interpreter Lock)。GIL 保证在任意时刻,只有一个操作系统原生线程在执行 Python 字节码。这一特性从根本上决定了多线程在 Python 中的能力边界。
1. 多线程(Threading):通过调用操作系统的原生线程运行,所有线程共享所属 Python 进程的内存空间与资源。由于受到 GIL 约束,多线程无法实现真正的多核 CPU 并行计算;但在进行网络请求、磁盘 I/O 或调用释放了 GIL 的 C 扩展底层函数(如 NumPy 矩阵计算、加密模块)时,当前线程会主动释放 GIL,使得其他线程能够立即继续执行。
2. 多进程(Multiprocessing):通过派生独立的子进程来执行任务。每个进程拥有完全独立的 Python 解释器实例、独立的 GIL 以及隔离的内存地址空间。因此,多进程能毫无阻碍地分配至不同物理 CPU 核心同时运行,实现真并行。但其代价是较高的系统启动损耗、更大的内存占用,以及跨进程通信必须经过的数据序列化(Pickle)开销。
3. 异步协程(Asyncio):运行在单操作系统进程与单线程之内,属于用户态的协作式调度。它通过一个事件循环(Event Loop)持续驱动多个轻量级协程(Coroutine)。协程在遇到 I/O 操作时通过 await 关键字主动交出 CPU 控制权,让给就绪的下一个协程,等待操作系统内核完成底层 I/O 后再唤醒回调。它完全避开了操作系统线程切换的上下文开销,是纯粹的网络 I/O 吞吐放大器。
二、场景决策流程:四步推导最优并发模型
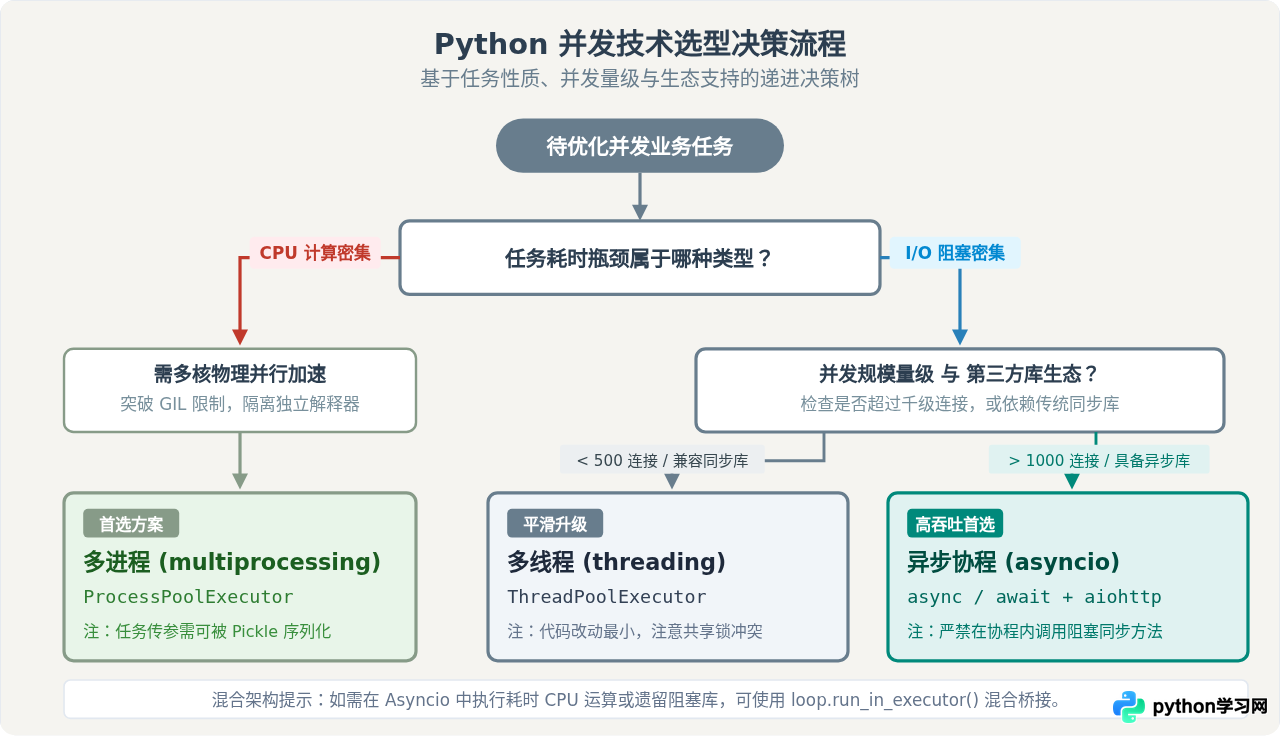
在面对具体的业务需求时,技术选型不应当依靠直觉或盲目追求新技术,而应按照系统化的推导路径进行评估。决策主要由任务类型(CPU/IO)、并发连接数、第三方生态兼容性与重构成本四个关键维度决定。
第一步:判定计算密集度。检查任务的主耗时是在 CPU 运算(如视频解码、图像缩放、大矩阵运算、分词、密码学加解密),还是在等待外部资源返回(如 HTTP 请求、数据库读写、文件系统调用)。如果是 CPU 密集型任务,无需犹豫,直接选多进程;多线程不仅无法加速,反会因频繁争夺 GIL 和线程切换导致耗时剧增。
第二步:评估 I/O 并发规模。如果确认是 I/O 密集型任务,评估最大并发连接数(Concurrency Scale)。如果并发数处于数十到几百个连接(例如后台批量调用几十个第三方接口、常规爬虫),多线程模型完全能够承载,且操作系统调度足够成熟;如果并发数需要达到数千到数万(例如高吞吐 Web 服务、实时推送、大规模高频爬取),线程栈内存(每个线程默认占用数 MB 栈空间)将迅速耗尽内存,必须使用轻量级的 Asyncio 协程。
第三步:核查第三方库生态兼容性。Asyncio 具有极强的“传染性”——只要在协程链条中调用了一个阻塞式的标准同步函数(如传统的 requests.get() 或 time.sleep()),整个单线程事件循环就会被直接卡死,后续所有协程无论多少都会被无差别阻塞。如果项目中重度依赖的 SDK 仅提供同步阻塞接口,且无法轻易替换,使用 concurrent.futures.ThreadPoolExecutor 包装是成本最低、风险最小的实用方案。
三、执行时序与资源调度对比
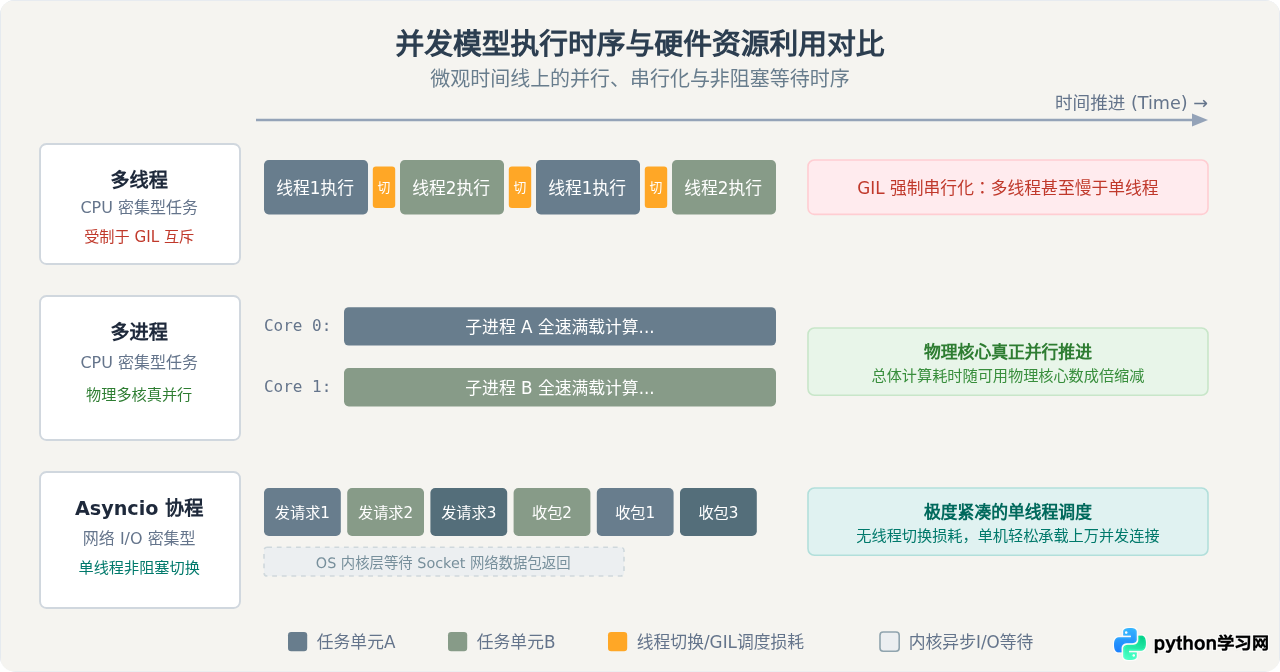
为了直观展现三种技术方案在相同时间线内的微观调度差异,我们对比它们在处理典型工作负荷时的 CPU 核心与时间切片占用情况。
在 CPU 密集任务中,多线程在单个物理核心上不断切换,每个线程争抢 GIL;每次切片不仅无法提高计算速度,反因操作系统强制保存与恢复上下文寄存器引发额外消耗。相反,多进程各自独享一个物理核心,两组任务在两条独立的物理电路上平行推进,理想情况下耗时可直接按可用物理核心数成倍缩短。
在 I/O 密集任务中,Asyncio 展现出了极高的运行效率。当协程 A 发起网络请求后,底层 OS 的 epoll/kqueue 开始接管网络事件等待,CPU 并不休眠,而是由事件循环立即切入协程 B、C 发起新请求。所有网络等待时间与后续 CPU 处理紧凑交织,在单线程内达到了极高的硬件利用率。
四、三大模型的标准代码实现与实战示例
在现代 Python 开发中,推荐优先使用标准库高层封装模块 concurrent.futures 与内置的 asyncio 模块。以下分别为三种模型提供标准化、可直接使用的代码骨架与最佳实践配置。
1. 多进程:利用 ProcessPoolExecutor 处理 CPU 密集型任务
多进程非常适合大批量图片压缩、复杂文本提取、科学计算与加密签名等场景。编写多进程代码时,必须将启动逻辑放置在 if __name__ == '__main__': 守卫语句之下,以防止子进程在 Windows/macOS 默认的 spawn 机制下递归自导入。
import math
from concurrent.futures import ProcessPoolExecutor, as_completed
import os

# 模拟 CPU 密集型计算任务
def heavy_cpu_task(number: int) -> int:
    pid = os.getpid()
    count = 0
    # 密集素数检验/因数分解
    for i in range(2, int(math.isqrt(number)) + 1):
        if number % i == 0:
            count += 1
    return count

def run_multiprocess():
    test_numbers = [999999937, 999999929, 999999883, 999999797] * 4

    # max_workers 建议设为物理核心数或逻辑核心数(默认为 os.cpu_count())
    with ProcessPoolExecutor(max_workers=os.cpu_count()) as executor:
        # 使用 submit + as_completed 灵活获取已完成结果
        futures = {executor.submit(heavy_cpu_task, num): num for num in test_numbers}
        for future in as_completed(futures):
            num = futures[future]
            try:
                result = future.result()
                print(f"数值 {num} 计算完成,因子数: {result}")
            except Exception as exc:
                print(f"任务异常: {exc}")

if __name__ == '__main__':
    run_multiprocess()
2. 多线程:利用 ThreadPoolExecutor 处理中低规模阻塞 I/O
如果现有业务逻辑中广泛使用了传统的同步客户端(如 requests 发起 HTTP 请求、boto3 访问云存储),重写为异步协程需要大幅改动代码且容易引入缺陷。此时,直接利用线程池能以最低成本实现高并发提升。
from concurrent.futures import ThreadPoolExecutor, as_completed
import time
import requests

def fetch_url(url: str, timeout: int = 5) -> dict:
    # requests 请求在等待网络返回期间,CPython 会主动释放 GIL
    resp = requests.get(url, timeout=timeout)
    return {"url": url, "status_code": resp.status_code, "length": len(resp.content)}

def run_multithread():
    target_urls = [
        "https://www.python.org",
        "https://docs.python.org/3/",
        "https://pypi.org"
    ] * 5

    # 对于 I/O 密集任务,线程数可适当设大,通常为 2*CPU_COUNT 至 32
    max_workers = min(32, (os.cpu_count() or 1) + 4)
    with ThreadPoolExecutor(max_workers=max_workers) as executor:
        futures = {executor.submit(fetch_url, url): url for url in target_urls}
        for future in as_completed(futures):
            res = future.result()
            print(f"已拉取 {res['url']} -> 状态码: {res['status_code']}")

if __name__ == '__main__':
    run_multithread()
3. 异步编程:基于 Asyncio 与 aiohttp/httpx 的超高并发网络 I/O
当并发连接数达到数百上千时,协程的优势完全体现。在编写异步代码时,务必使用 asyncio.Semaphore 控制并发瞬时上限,防止瞬间建立过多 TCP 连接耗尽本地文件描述符(Too many open files)或触发目标服务器的反爬与限流。
import asyncio
import aiohttp

async def fetch_async(session: aiohttp.ClientSession, url: str, semaphore: asyncio.Semaphore) -> dict:
    # 通过信号量严格限制并发窗口大小
    async with semaphore:
        async with session.get(url, timeout=aiohttp.ClientTimeout(total=5)) as resp:
            content = await resp.read()
            return {"url": url, "status": resp.status, "bytes": len(content)}

async def run_asyncio():
    urls = ["https://httpbin.org/delay/1"] * 50
    concurrency_limit = 10  # 限制最大同时飞行请求数为 10
    semaphore = asyncio.Semaphore(concurrency_limit)

    connector = aiohttp.TCPConnector(limit=concurrency_limit)
    async with aiohttp.ClientSession(connector=connector) as session:
        # 创建一组协程任务
        tasks = [fetch_async(session, url, semaphore) for url in urls]
        # 并发收集所有结果
        results = await asyncio.gather(*tasks, return_exceptions=True)

        for res in results:
            if isinstance(res, Exception):
                print(f"请求失败: {res}")
            else:
                print(f"异步响应 {res['url']} -> {res['status']}")

if __name__ == '__main__':
    asyncio.run(run_asyncio())
五、综合指标对比与避坑指南
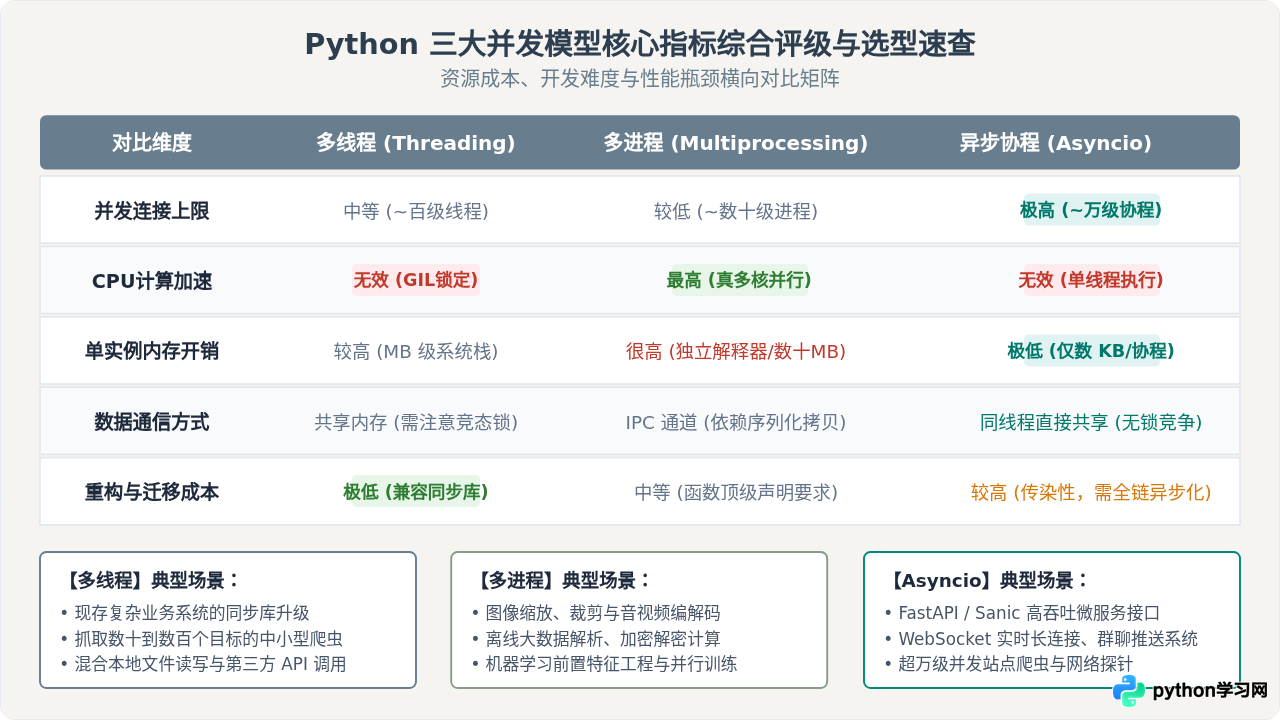
为了给工程架构选型提供直观参考,我们从内存消耗、开发复杂度、调试难度及最大并发能力等核心维度进行横向指标汇总。
- 陷阱 1:Asyncio 混用阻塞调用:在协程内部若直接调用
time.sleep(5)或标准requests.get(),整个进程的事件循环会瞬间完全挂起。如果必须执行此类代码,应显式通过loop.run_in_executor(None, sync_func)将其隔离至后台线程池执行。 - 陷阱 2:多进程数据序列化失败:传递给子进程的参数以及子进程返回的结果对象,必须能够被
pickle序列化。嵌套函数(闭包)、未绑定的 lambda 表达式、打开的文件句柄、数据库连接对象均无法跨进程传递,否则会抛出PicklingError。 - 陷阱 3:多线程无锁并发修改:虽然 CPython 拥有 GIL,但 GIL 仅保证单条字节码指令的原生执行安全。像
count += 1这种常见代码在底层其实由读取、加法、写回三条字节码组成,在多线程并发场景下极易出现覆盖丢失,必须使用threading.Lock进行显式同步。
六、总结与落地建议
在 Python 体系中,并发模式并不是非此即彼的对立关系。成熟的工程系统往往采用混合架构:使用 Asyncio 作为系统最外层的高性能网络接入网关,以数千并发处理海量网络 I/O;当接收到密集的算力请求时,通过 ProcessPoolExecutor 将计算切片分发至工作进程池充分利用多核;而在维护对接老旧第三方服务的模块中,则保留轻便稳妥的 ThreadPoolExecutor。把握住底层资源流转逻辑,依据业务瓶颈精准裁切,才是编写出兼具高稳定性与卓越吞吐量系统的关键法则。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









