

Python多线程与多进程代码示例:并发任务处理
深入解析Python多线程与多进程的核心差异与代码实现,结合GIL工作原理与实战代码示例,详解I/O密集型与CPU密集型任务的并发处理方法。
在 Python 中编写并发程序的核心,在于根据任务特性在多线程与多进程之间做出准确选型。受限于 CPython 的全局解释器锁(GIL),多线程无法利用多核 CPU 加速纯计算任务,但在网络请求、文件读写等 I/O 阻塞场景下消耗低、响应快;多进程则通过创建独立解释器实例绕过 GIL 限制,实现真正的多核并行计算。本文提供多线程与多进程的标准代码示例,深入解析并发池化管理与数据安全操作细节。
一、核心认知:GIL 机制与两类并发任务
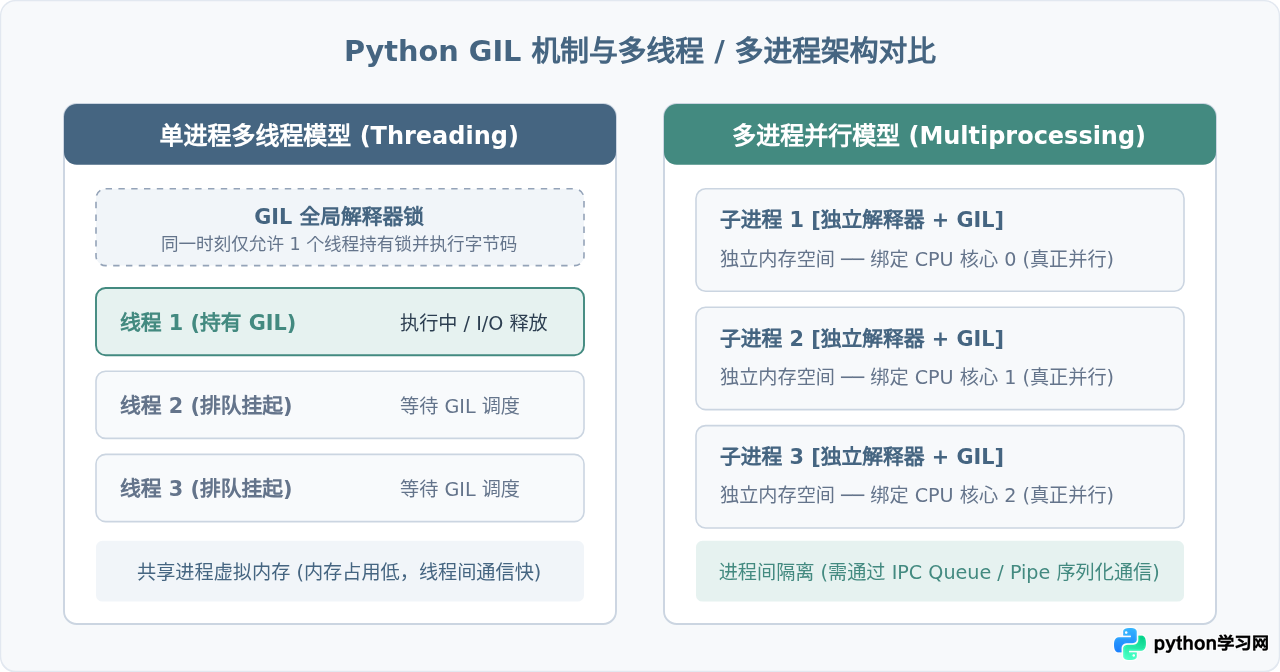
处理并发任务前,必须厘清操作系统级进程与线程在 Python 运行环境下的区别。进程是操作系统分配资源的独立单元,拥有私有的内存空间;线程是进程内部的执行流,同属一个进程的多个线程共享堆内存与全局变量。
官方标准解释器 CPython 引入了全局解释器锁(Global Interpreter Lock,简称 GIL)。GIL 是一个互斥锁,用于保护 Python 内部对象的内存管理免受并发竞态破坏。其关键影响如下:
- CPU 密集型任务:大量依赖 CPU 进行循环计算、数据压缩、矩阵运算或图像处理。在单进程多线程模型下,由于 GIL 的限制,任意时刻仅有一个线程在执行 Python 字节码,多线程不仅无法利用多核性能,还会因频繁的线程上下文切换导致执行总耗时增加。此类任务必须使用多进程。
- I/O 密集型任务:大部分时间处于等待状态(如网络 API 响应、磁盘大文件写入、数据库查询)。当线程进入操作系统底层的 I/O 等待时,CPython 会主动释放 GIL,允许其他就绪线程执行。因此,多线程在 I/O 密集场景能够显著削减总体等待时间。
二、并发任务处理的标准设计流程
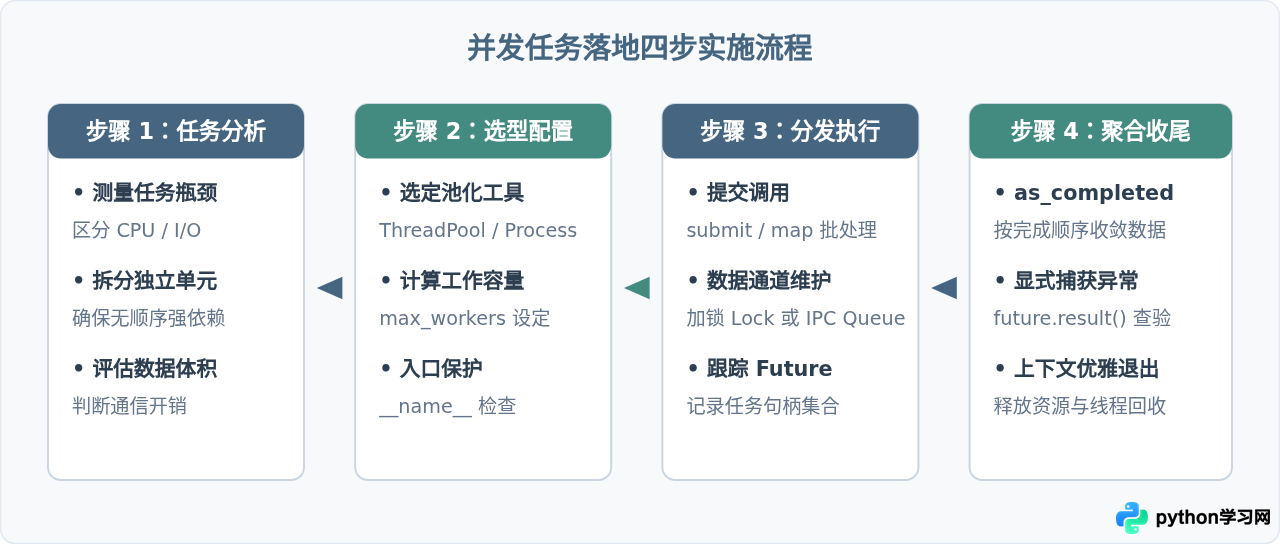
构建并发处理任务时,不应盲目启动大量线程或进程。应当遵循明确的技术链路进行设计与资源分配:
- 分析任务瓶颈:确认主要消耗来源于 CPU 算力还是网络/外设 I/O 阻塞。
- 选择并发工具:现代 Python 编程中,优先选用
concurrent.futures模块提供的高层抽象(ThreadPoolExecutor与ProcessPoolExecutor),代替手动管理线程或进程生命周期。 - 合理配置并发度:CPU 密集型进程数通常设置为机器逻辑核心数(
os.cpu_count());I/O 密集型线程数通常根据目标接口承受能力与本地网络带宽设定在 5 到 50 之间。 - 收敛异常与回收资源:通过上下文管理器
with自动完成执行器的等待与资源关闭,避免僵尸进程或资源泄漏。
三、多线程实战:I/O 密集型并发处理
针对批量发起网络请求、读取远程接口或批量写入本地文件的场景,多线程是成本最低的并发方案。以下通过 concurrent.futures.ThreadPoolExecutor 实现一个批量数据抓取的典型模型。
1. 线程池并发示例代码
import time
from concurrent.futures import ThreadPoolExecutor, as_completed

def fetch_resource(task_id: int, mock_latency: float) -> dict:
    """模拟执行网络 I/O 任务"""
    time.sleep(mock_latency)
    if task_id == 3:
        # 演示单任务异常时的捕获处理
        raise ConnectionResetError("模拟网络连接重置")
    return {"task_id": task_id, "status_code": 200, "latency": mock_latency}

def run_thread_pool_example():
    task_configs = [
        (1, 0.4),
        (2, 0.2),
        (3, 0.3),
        (4, 0.5),
        (5, 0.1),
    ]

    print("--- 启动多线程任务池 ---")
    start_time = time.perf_counter()
    results = []

    # 使用 with 上下文管理器,确保线程池执行完毕后自动释放所有工作线程
    with ThreadPoolExecutor(max_workers=3) as executor:
        # 提交所有任务,记录 Future 与任务参数的映射关系
        future_to_task = {
            executor.submit(fetch_resource, tid, delay): tid
            for tid, delay in task_configs
        }

        # as_completed 会在任意一个任务完成后立即产出,无需等待所有任务同步结束
        for future in as_completed(future_to_task):
            task_id = future_to_task[future]
            try:
                data = future.result()
                results.append(data)
                print(f"[完成] 任务 {task_id} 成功返回: 耗时 {data['latency']}s")
            except Exception as exc:
                print(f"[异常] 任务 {task_id} 发生错误: {exc}")

    total_time = time.perf_counter() - start_time
    print(f"全部任务处理完毕,有效结果数: {len(results)},总耗时: {total_time:.2f}s")

if __name__ == "__main__":
run_thread_pool_example()[完成] 任务 2 成功返回: 耗时 0.2s
[异常] 任务 3 发生错误: 模拟网络连接重置
[完成] 任务 5 成功返回: 耗时 0.1s
[完成] 任务 1 成功返回: 耗时 0.4s
[完成] 任务 4 成功返回: 耗时 0.5s
全部任务处理完毕,有效结果数: 4,总耗时: 0.61s
2. 线程安全与互斥锁(Lock)
多线程共享同一份进程内存,若多个线程同时读写同一个全局对象(例如递增计数器或操作无锁字典),会发生数据覆写竞争。解决该问题需使用 threading.Lock 确保临界区的互斥访问。
import threading

class ThreadSafeMetrics:
    def __init__(self):
        self._count = 0
        self._lock = threading.Lock()

    def record_success(self):
        # 使用 with self._lock 自动获取并保证释放锁
        with self._lock:
            self._count += 1

    @property
    def total_count(self) -> int:
        with self._lock:
            return self._count
四、多进程实战:CPU 密集型并发处理
对于密码学哈希、科学计算或大规模数据转换等消耗 CPU 算力的任务,必须使用多进程来调度多个独立 CPU 核心。Python 提供了 multiprocessing 原生模块及高层的 ProcessPoolExecutor。
spawn 启动子进程,子进程会重新导入入口模块。因此,必须将主执行逻辑置于 if __name__ == '__main__': 保护块内,否则会引发子进程无限递归创建导致系统崩溃。
1. 进程池并发计算示例代码
import os
import time
from concurrent.futures import ProcessPoolExecutor, as_completed

def heavy_math_computation(seed: int, iterations: int) -> int:
    """模拟 CPU 密集型运算"""
    accum = 0
    for i in range(1, iterations + 1):
        accum = (accum + (i * seed)) % 100000007
    return accum

def run_process_pool_example():
    # 测试数据:4 个大型计算量任务
    tasks = [
        (101, 8_000_000),
        (202, 8_000_000),
        (303, 8_000_000),
        (404, 8_000_000),
    ]

    cpu_count = os.cpu_count() or 4
    # 限制进程数不超过 CPU 可用核心数,避免过量进程争抢上下文
    workers = min(len(tasks), cpu_count)
    print(f"主机检测到 {cpu_count} 核心,使用 {workers} 个工作进程并行计算")

    start_time = time.perf_counter()
    computed_records = []

    with ProcessPoolExecutor(max_workers=workers) as executor:
        future_map = {
            executor.submit(heavy_math_computation, seed, iters): seed
            for seed, iters in tasks
        }

        for fut in as_completed(future_map):
            seed = future_map[fut]
            res = fut.result()
            computed_records.append((seed, res))
            print(f"[进程计算完成] 种子 {seed} -> 运算校验值: {res}")

    elapsed = time.perf_counter() - start_time
    print(f"并行计算执行完毕,耗时: {elapsed:.2f}s")

if __name__ == "__main__":
run_process_pool_example()[进程计算完成] 种子 202 -> 运算校验值: 84672105
[进程计算完成] 种子 101 -> 运算校验值: 42336052
[进程计算完成] 种子 404 -> 运算校验值: 69344210
[进程计算完成] 种子 303 -> 运算校验值: 27008157
并行计算执行完毕,耗时: 0.86s
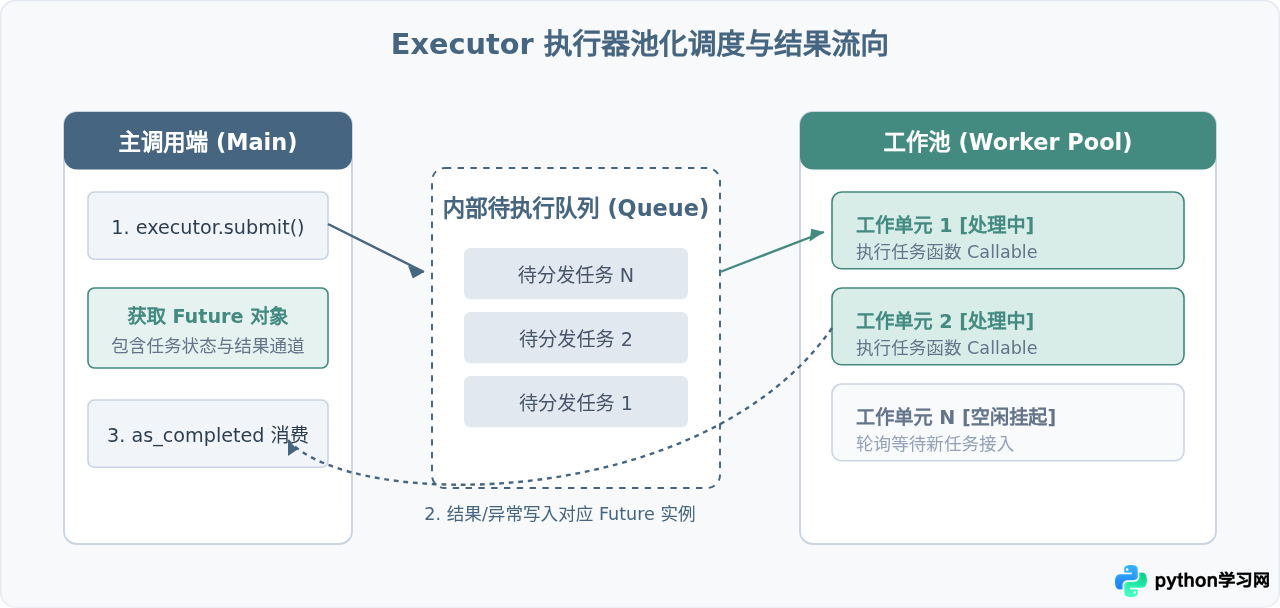
2. 线程池与进程池的工作协作时序
无论是 ThreadPoolExecutor 还是 ProcessPoolExecutor,其底层均由主线程调度队列、工作线程/进程池、结果状态集(Future)三部分构成。理解其内部运转流向有助于排查并发卡顿或内存堆积问题。
五、并发处理常见误区与避坑指南
在实际生产环境中,并发代码若处理不当,不仅无法提高效率,反而会引发严重的死锁、内存泄露或进程异常退出:
- 不可序列化对象错误(PicklingError):多进程之间传递的参数、闭包或返回值必须支持
pickle序列化。如果向子进程传入了生成器、数据库连接游标(如sqlite3.Cursor)或复杂的局部函数对象,会直接报序列化失败。对于需要复用的连接,应在子进程启动内部单独初始化。 - 过度创建并发实体导致系统颠簸:启动成百上千个原生线程会导致操作系统内核内存膨胀与上下文切换风暴。务必通过
max_workers限制线程池/进程池上限。 - 未捕获的任务异常导致静默失败:在并发池中,如果子任务发生异常,主线程默认不会主动崩溃中断,异常被保存在
Future对象中。如果未在主进程中调用future.result(),异常就会被完全吞噬,排查极为困难。 - 死锁隐患:在多线程中混用多个
Lock时,务必保证所有线程按照完全一致的顺序申请锁;在多进程使用multiprocessing.Queue时,若队列缓冲区已满且主进程在等待子进程join(),会导致双方陷入相互等待的死锁状态。
六、并发选型与关键参数对比总结
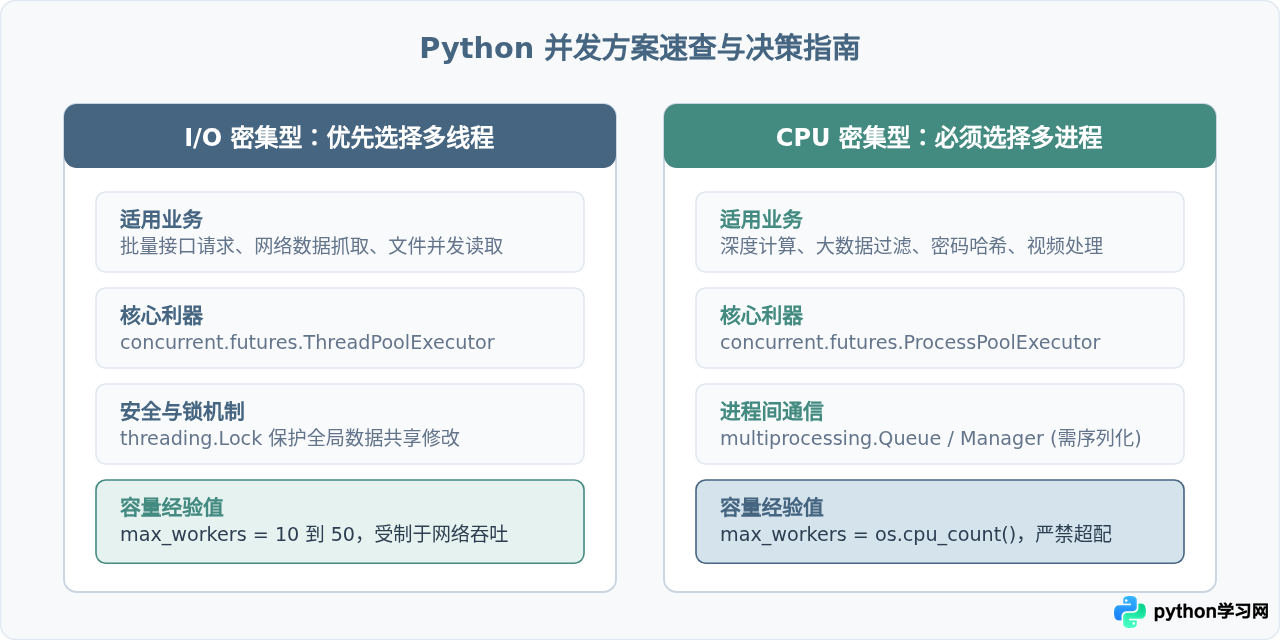
为了帮助在实际业务场景中快速抉择,以下总结了 Python 多线程与多进程在核心特性与参数配置上的对照维度:
| 对比维度 | 多线程 (Threading / ThreadPoolExecutor) | 多进程 (Multiprocessing / ProcessPoolExecutor) |
|---|---|---|
| 本质原理 | 单个进程内多个执行线程,共享内存 | 多个独立 Python 解释器进程,内存物理隔离 |
| 受到 GIL 限制 | 是。同一时刻仅单核执行 Python 字节码 | 否。每个进程拥有专属 GIL,真正多核并行 |
| 最佳适用场景 | 网络爬虫、文件读取、批量 HTTP 请求 (I/O 密集) | 图像渲染、数值计算、加密哈希 (CPU 密集) |
| 内存资源开销 | 低(仅几百 KB 栈空间) | 高(需加载整个解释器与模块上下文) |
| 数据通信机制 | 直接访问全局变量(需配合 Lock) |
需通过 Queue、Pipe 或 Manager 序列化传输 |
| 推荐并发容量 | 10 ~ 50 个工作线程(依网络带宽与目标负载而定) | 等于或略小于物理核心数(os.cpu_count()) |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









