

怎么用Python手动模拟栈实现汉诺塔非递归算法
本文详细讲解如何使用Python显式栈(list)手动模拟系统调用栈,实现汉诺塔经典非递归算法,彻底规避RecursionError溢出并实现单步可控的状态机模型。
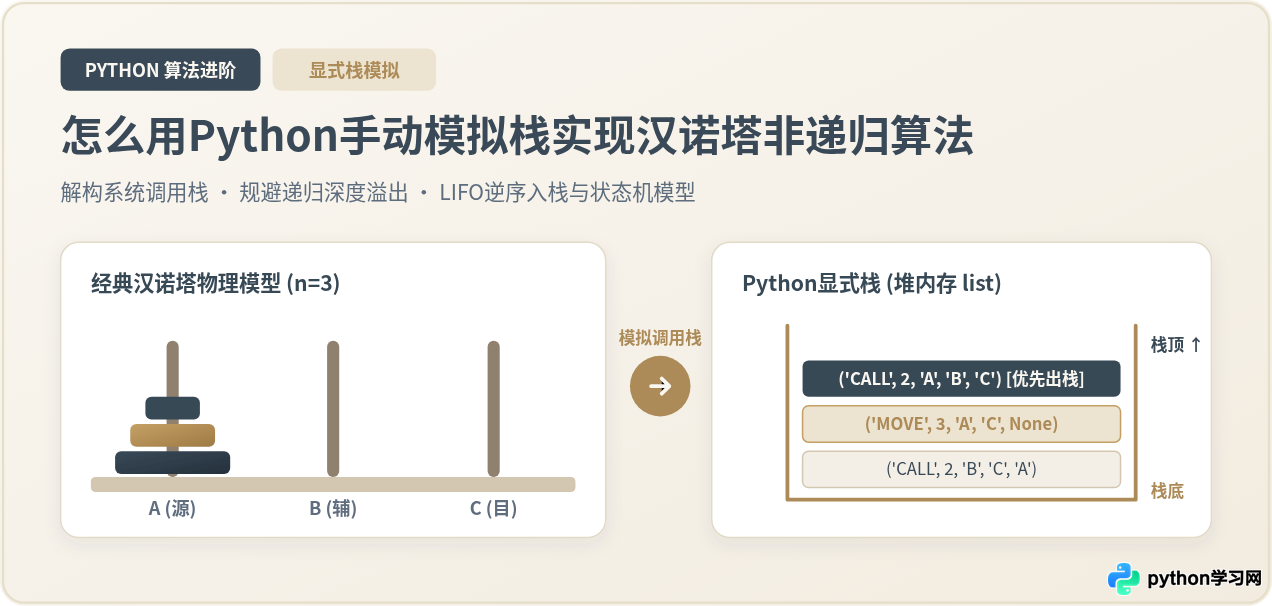
在 Python 中,通过手动维护一个基于列表(list)的显式栈(Explicit Stack),可以将汉诺塔的经典递归调用转化为迭代循环,从而彻底规避解释器对调用栈深度(sys.getrecursionlimit())的硬性限制。实现这一算法的核心,在于将每次盘面迁移解构为“任务分解”与“实体移动”两类指令帧,并利用栈的后进先出(LIFO)特性,按逆序依次压入子任务,在 while 循环中持续消费栈顶指令完成求解。
一、为什么需要手动模拟栈:从调用栈溢出谈起
汉诺塔问题是递归思想的典范教材。给定三根柱子(A 为源柱、B 为辅助柱、C 为目标柱)和 $n$ 个大小不等的圆盘,规则要求每次只能移动一个盘片,且大盘永远不能压在小盘上方。虽然递归代码仅需四行,但在实际工程与深层推演中,原生递归存在不可回避的架构局限。
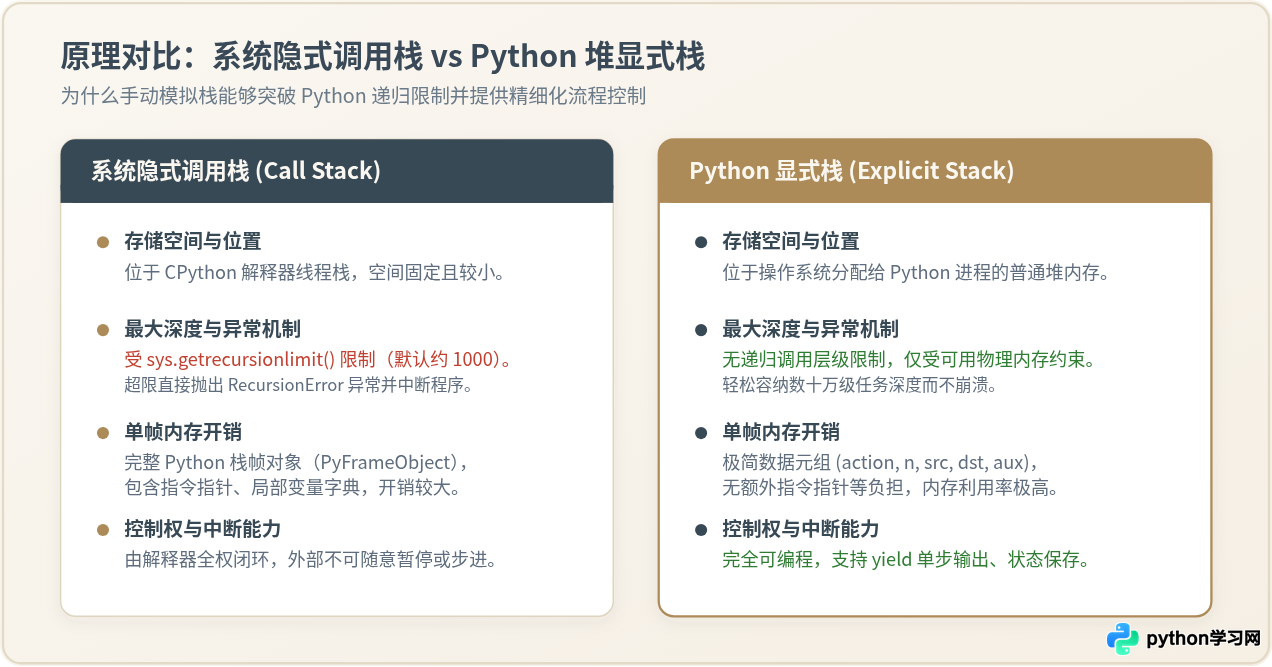
在 CPython 解释器中,每次函数调用都会在 C 语言层级的调用栈上分配一个独立的 PyFrameObject 栈帧。该栈帧不仅要保存局部变量与参数,还要存储当前代码对象的指令指针和异常处理链。Python 默认将递归深度限制在 1000 左右(可通过 sys.getrecursionlimit() 查看)。一旦递归调用层级超过阈值,解释器就会立刻抛出 RecursionError: maximum recursion depth exceeded 异常并崩溃终止。
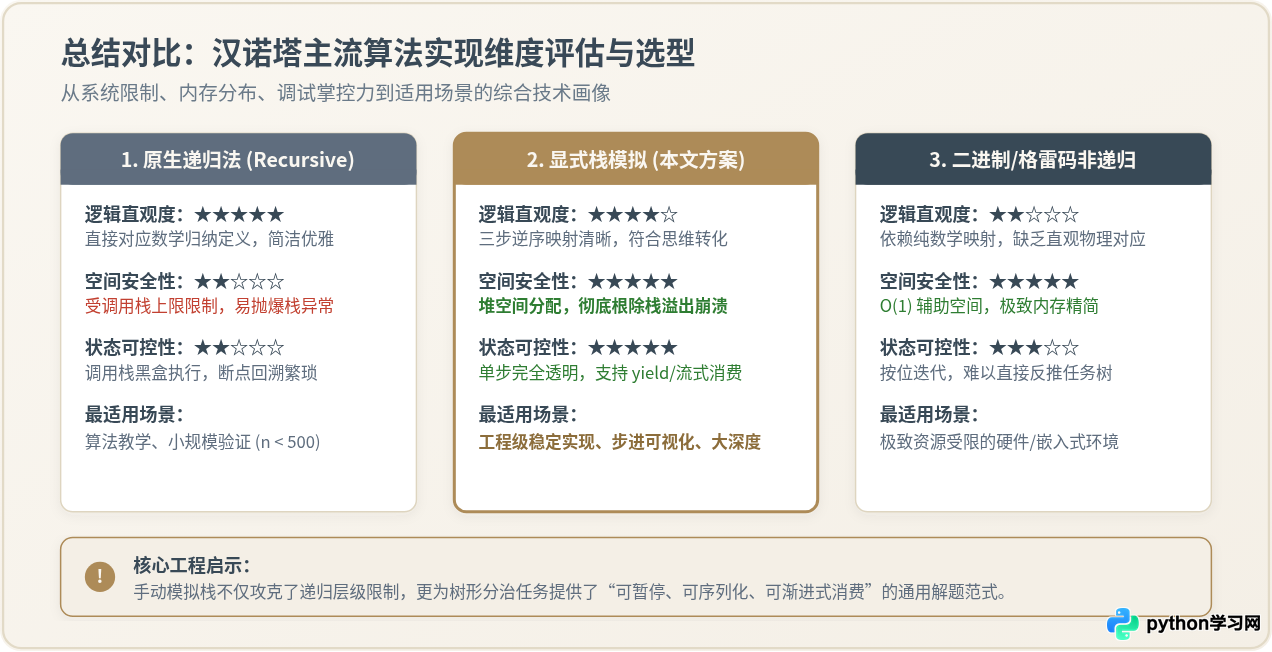
手动模拟栈的核心思想,是将原本由操作系统和解释器在 C 调用栈上隐式管理的执行上下文,转移到开发者在用户态堆内存中分配的普通 Python 列表对象(list)。堆内存的大小直接受宿主物理内存支配,能够轻松承载数万乃至百万级别的压栈操作,从根本上消除了“爆栈”风险。
二、汉诺塔的递归本质与三步拆解
要将递归转换为非递归,首先需要精确理清递归函数在数学与执行层面的原子拆解。对于规模为 $n$ 的汉诺塔任务,其求解步骤严格划分为三个阶段:
- 第一阶段(移动上方圆盘):借助目标柱 C,将 A 柱上方的 $n-1$ 个圆盘全部移至辅助柱 B。
- 第二阶段(移动底部大盘):将 A 柱上剩下的唯一最大圆盘(第 $n$ 号盘)直接移至目标柱 C。
- 第三阶段(收拢归位):借助源柱 A,将目前在 B 柱上的 $n-1$ 个圆盘全部移到目标柱 C。
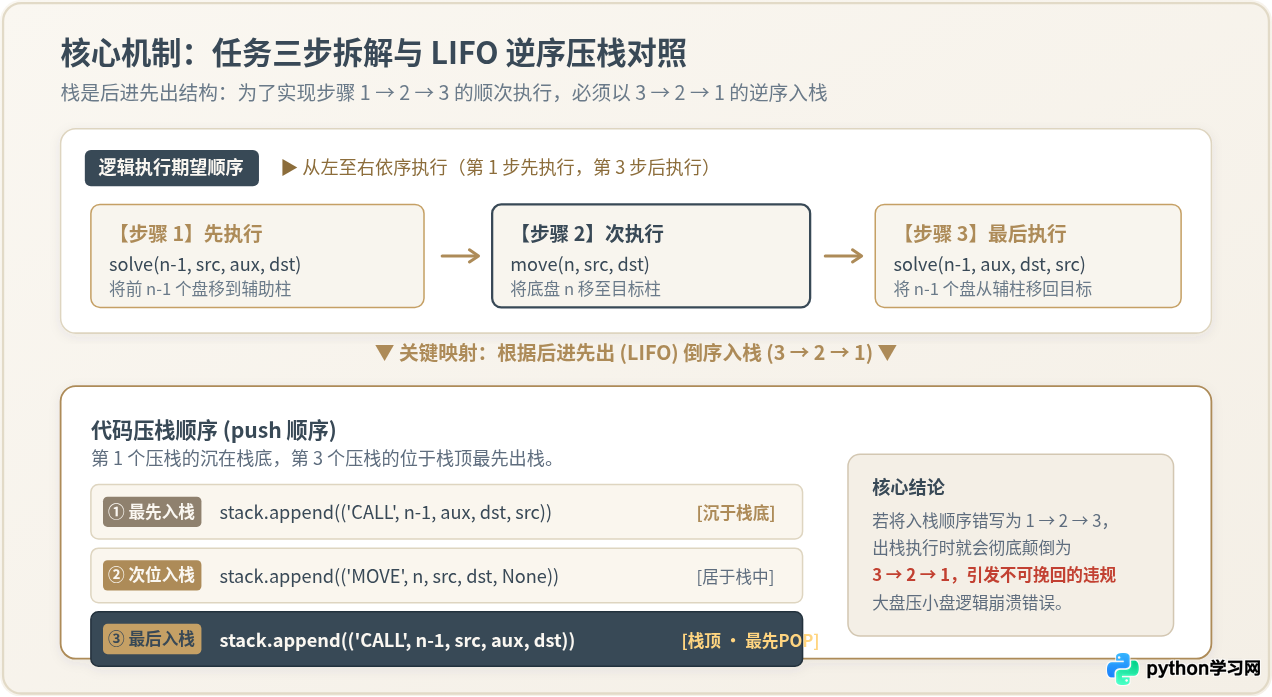
在传统的递归函数中,这三步通过两次函数递归调用和一次直接移动输出体现。然而在非递归的栈结构中,栈是严格后进先出(LIFO,Last In First Out)的。这意味着:最先被压入栈底的任务,将最后出栈执行;最后被压入栈顶的任务,将最先出栈执行。
很多初学者在第一次尝试手动模拟栈时,容易直觉性地按照“步骤 1 → 步骤 2 → 步骤 3”的正序把任务压入栈中,结果导致步骤 3 最先出栈执行,算法瞬间颠倒崩溃。正确的做法必须是逆序压栈:即先压入“步骤 3”,再压入“步骤 2”,最后压入“步骤 1”。这样在紧接着的出栈流程中,步骤 1 就会浮在栈顶被首先处理。
三、栈帧设计与二元指令分发机制
在 Python 中模拟调用栈,最清晰且健壮的方式是建立一个明确的状态机模型。栈中的每一个元素(栈帧)不只是简单的数字,而是一个包含操作类型和迁移参数的元组:
(action_type, n, source, destination, auxiliary)
我们定义两种截然不同的指令行为(Action Type):
ACTION_CALL:表示当前任务是一项复合任务,需要将其进一步拆分为更细颗粒度的子任务。ACTION_MOVE:表示当前任务是一个不可再分的原子动作,要求立刻执行物理盘片转移并记录/打印结果。
执行循环的判定逻辑
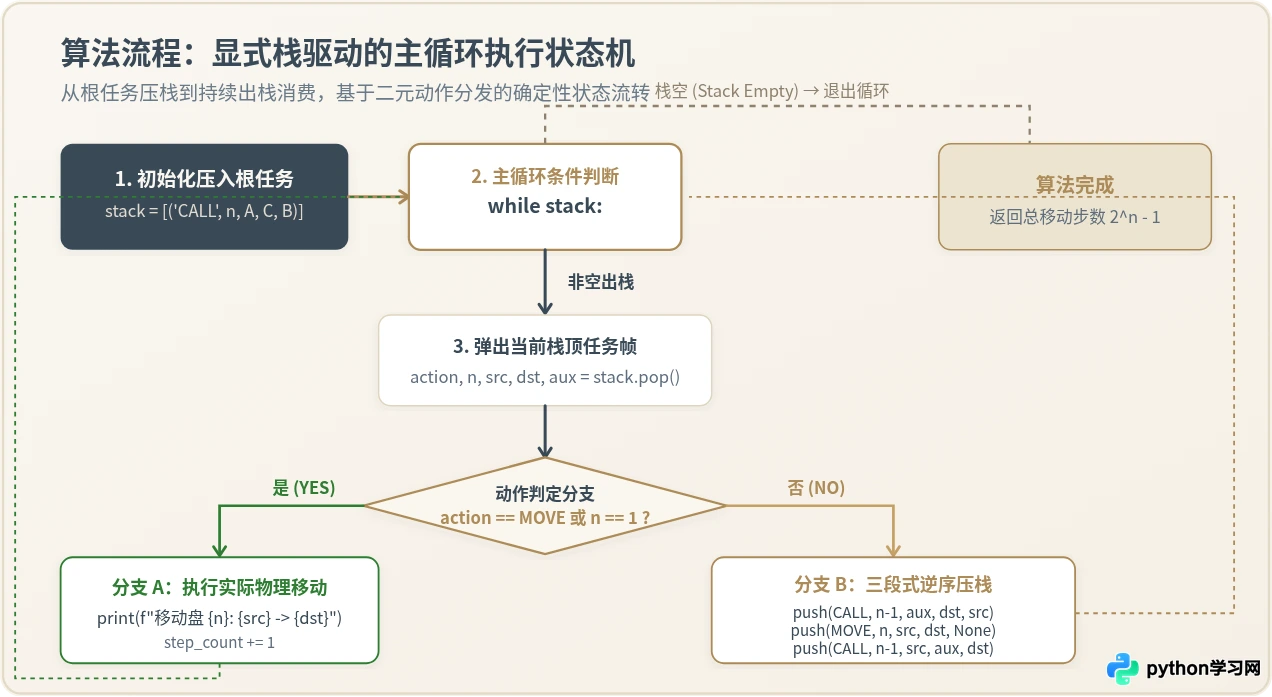
算法启动时,将初始总任务 ('CALL', n, 'A', 'C', 'B') 压入栈中,随后启动一个持续运行的 while stack: 循环:
- 弹出栈顶:从栈顶弹出当前待执行的栈帧元组。
- 判断指令类型:
- 如果指令为
ACTION_MOVE或者盘数 $n == 1$,说明该步骤已经抵达可直接执行的基准情况,直接输出盘片移动日志(如"移动盘 1: A -> C"),累计步数。 - 如果指令为
ACTION_CALL且 $n > 1$,说明该任务必须被解构。此时我们按照逆序向栈中压入三条新指令:
① 先压入子任务 3:('CALL', n - 1, aux, dst, src)
② 再压入子任务 2:('MOVE', n, src, dst, None)
③ 最后压入子任务 1:('CALL', n - 1, src, aux, dst)
- 如果指令为
四、完整 Python 代码实现与运行测试
下面是遵循上述架构实现的完整 Python 脚本。代码使用类型注解(Type Hints)明确参数结构,同时封装了步数统计与移动追踪功能,可以直接在 Python 3 环境下执行。
Python 完整代码示例:hanoi_stack.py# -*- coding: utf-8 -*-
"""
Python 手动模拟栈实现汉诺塔非递归算法
"""
from typing import List, Tuple, Optional
# 定义两种指令状态常量
ACTION_CALL = "CALL" # 复合任务,需拆解
ACTION_MOVE = "MOVE" # 原子任务,需执行移动
# 栈帧数据结构定义: (指令类型, 盘数, 源柱, 目标柱, 辅助柱)
StackFrame = Tuple[str, int, str, str, Optional[str]]
def hanoi_non_recursive(n: int, source: str = "A", destination: str = "C", auxiliary: str = "B") -> int:
"""
使用手动显式栈求解汉诺塔问题
:param n: 圆盘总数
:param source: 源柱代号
:param destination: 目标柱代号
:param auxiliary: 辅助柱代号
:return: 总移动步数
"""
if n <= 0:
print("圆盘数必须大于 0")
return 0
# 1. 显式栈初始化,压入顶层任务
stack: List[StackFrame] = [(ACTION_CALL, n, source, destination, auxiliary)]
step_count = 0
print(f"=== 开始求解汉诺塔非递归算法 (n = {n}) ===")
# 2. 状态机驱动的主循环
while stack:
# 弹出栈顶指令
action, current_n, src, dst, aux = stack.pop()
# 分支 A: 若为原子移动指令,或者仅剩 1 个圆盘无需再拆
if action == ACTION_MOVE or current_n == 1:
step_count += 1
print(f"第 {step_count:2d} 步: 将盘 [{current_n}] 由柱子 {src} 移至柱子 {dst}")
# 分支 B: 若为复合任务,触发三段式逆序压栈
else:
# 步骤 3 (最后执行,最先压入栈底): 借助 src 将 n-1 个盘从 aux 移到 dst
stack.append((ACTION_CALL, current_n - 1, aux, dst, src))
# 步骤 2 (中间执行,次位压栈): 将当前最大的第 n 号盘从 src 移到 dst
stack.append((ACTION_MOVE, current_n, src, dst, None))
# 步骤 1 (最先执行,最后压入栈顶): 借助 dst 将 n-1 个盘从 src 移到 aux
stack.append((ACTION_CALL, current_n - 1, src, aux, dst))
print(f"=== 移动完毕:总共执行了 {step_count} 步 (理论值: 2^{n} - 1 = {2**n - 1}) ===\n")
return step_count
if __name__ == "__main__":
# 以 3 阶汉诺塔作为基准执行测试
hanoi_non_recursive(3, source="A", destination="C", auxiliary="B")
在终端中运行上述代码,控制台将输出 3 阶汉诺塔的完整移动过程。如下为实际示例输出结果:
第 1 步: 将盘 [1] 由柱子 A 移至柱子 C
第 2 步: 将盘 [2] 由柱子 A 移至柱子 B
第 3 步: 将盘 [1] 由柱子 C 移至柱子 B
第 4 步: 将盘 [3] 由柱子 A 移至柱子 C
第 5 步: 将盘 [1] 由柱子 B 移至柱子 A
第 6 步: 将盘 [2] 由柱子 B 移至柱子 C
第 7 步: 将盘 [1] 由柱子 A 移至柱子 C
=== 移动完毕:总共执行了 7 步 (理论值: 2^3 - 1 = 7) ===
可以看到,7 步移动逻辑与经典递归解法的每一步完全一致,验证了显式模拟栈的正确性。
五、执行轨迹剖析:以 n=3 栈帧流转推演
为了彻底理解为什么逆序压栈能够保证顺次执行,我们跟踪 $n=3$ 时栈内数据的单步流转过程:
| 循环轮次 | 出栈任务 (Pop) | 执行动作或新压入帧 | 实际生效输出 | 当前栈内元素数 |
|---|---|---|---|---|
| 初始化 | - | 压入 ('CALL', 3, 'A', 'C', 'B') | - | 1 |
| 第 1 轮 | ('CALL', 3, 'A', 'C', 'B') | 拆解并逆序压入:CALL(2,B,C,A), MOVE(3,A,C), CALL(2,A,B,C) | - | 3 |
| 第 2 轮 | ('CALL', 2, 'A', 'B', 'C') | 拆解并逆序压入:CALL(1,C,B,A), MOVE(2,A,B), CALL(1,A,C,B) | - | 5 |
| 第 3 轮 | ('CALL', 1, 'A', 'C', 'B') | n=1 达到基准边界,直接执行移动 | 盘 1: A -> C | 4 |
| 第 4 轮 | ('MOVE', 2, 'A', 'B') | MOVE 命中原子动作,直接执行移动 | 盘 2: A -> B | 3 |
| 第 5 轮 | ('CALL', 1, 'C', 'B', 'A') | n=1 达到基准边界,直接执行移动 | 盘 1: C -> B | 2 |
| 第 6 轮 | ('MOVE', 3, 'A', 'C') | 底盘移动,直接执行 | 盘 3: A -> C | 1 |
| 第 7 轮 | ('CALL', 2, 'B', 'C', 'A') | 再次拆解为 3 个子任务压栈 | - | 3 |
后续轮次以此类推,直到第 15 次出栈后栈完全清空。整个过程清晰地展现了树形递归如何被平铺为一个完全线性的调度流水线。
六、关键细节与容易忽视的技术陷阱
在实际编写手动模拟栈算法时,有几个关键细节极易出现隐蔽 bug,需要重点关注:
1. 柱子角色轮换的位置映射
这是实现汉诺塔时最容易混淆的参数传递点。在拆解任务时,柱子的相对角色会发生动态轮换:
- 在步骤 1(将 $n-1$ 个盘从源柱移到辅助柱)中:源柱依旧是
src,但目标柱变成了aux,原本的目标柱dst此时充当辅助角色。因此参数顺序为(n-1, src, aux, dst)。 - 在步骤 3(将 $n-1$ 个盘从辅助柱移到目标柱)中:源柱变成了
aux,目标柱恢复为dst,原本的源柱src则转变为辅助柱。因此参数顺序为(n-1, aux, dst, src)。
2. 时间复杂度与空间消耗认知
使用显式模拟栈只解决了调用栈深度的空间限制,并没有改变算法的时间复杂度。
- 空间复杂度:在任意时刻,栈中最多保存的任务层级为 $3n$(树的最大高度方向),空间复杂度为优异的 $O(n)$。堆内存完全可以承受 $n=1000$ 甚至更高的栈帧存储。
- 时间复杂度:汉诺塔的数学移动总步数严格等于 $2^n - 1$。无论使用递归还是非递归,其时间复杂度均为指数级的 $O(2^n)$。当 $n = 64$ 时,总步数约为 $1.84 imes 10^{19}$ 步,即使现代计算机每秒执行 10 亿次循环,也需要耗费约 584 年。因此,不能期望通过非递归算法使极大盘数的汉诺塔在瞬间计算完成。
七、总结
用 Python 手动模拟栈实现汉诺塔非递归算法,不仅是解决特定算法题的有效手段,更是一套极具通用价值的工程设计方法:
- 解构本质:任何树形分治或多路递归,其底层执行模型都可以等价还原为基于 LIFO 栈的循环分发过程。
- 消除硬限:将调用栈从系统管理的 C 栈迁移至用户态的堆列表,打破了 Python 默认递归深度的限制。
- 赋能扩展:显式栈使得整个计算流程具备了前所未有的掌控度。借助 Python 的
yield语法,我们可以极其轻松地将上述代码改造成生成器(Generator),实现盘面的单步流式推送、按需计算或随时中断持久化,为构建复杂的步进式图形交互界面提供了坚实的底层支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









