

怎么解决Python三引号字符串中的缩进干扰问题
深入讲解如何彻底解决Python在函数或类中定义三引号多行字符串时因代码对齐产生的缩进干扰与首尾空行问题。详细对比textwrap.dedent、inspect.cleandoc以及圆括号隐式拼接的实现原理、踩坑细节与工程最佳实践。
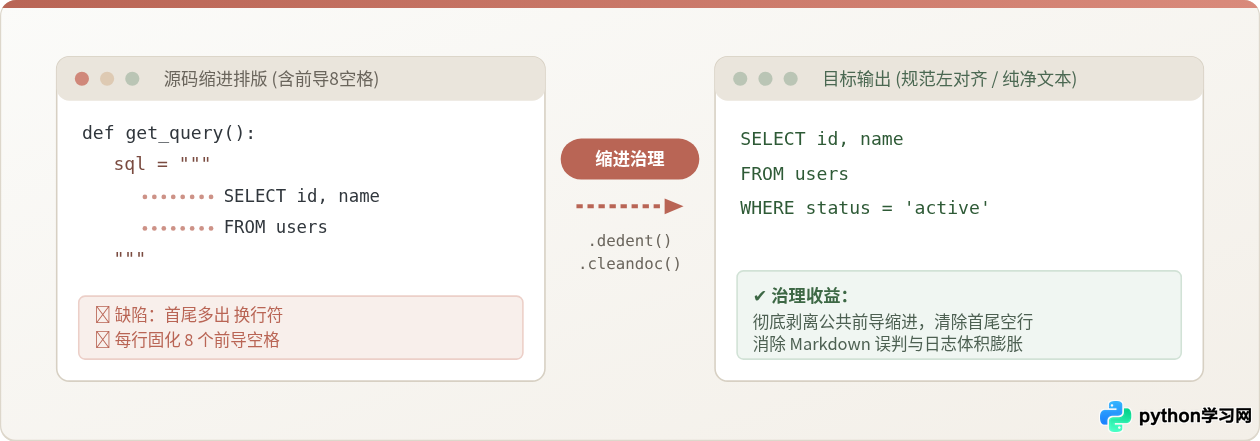
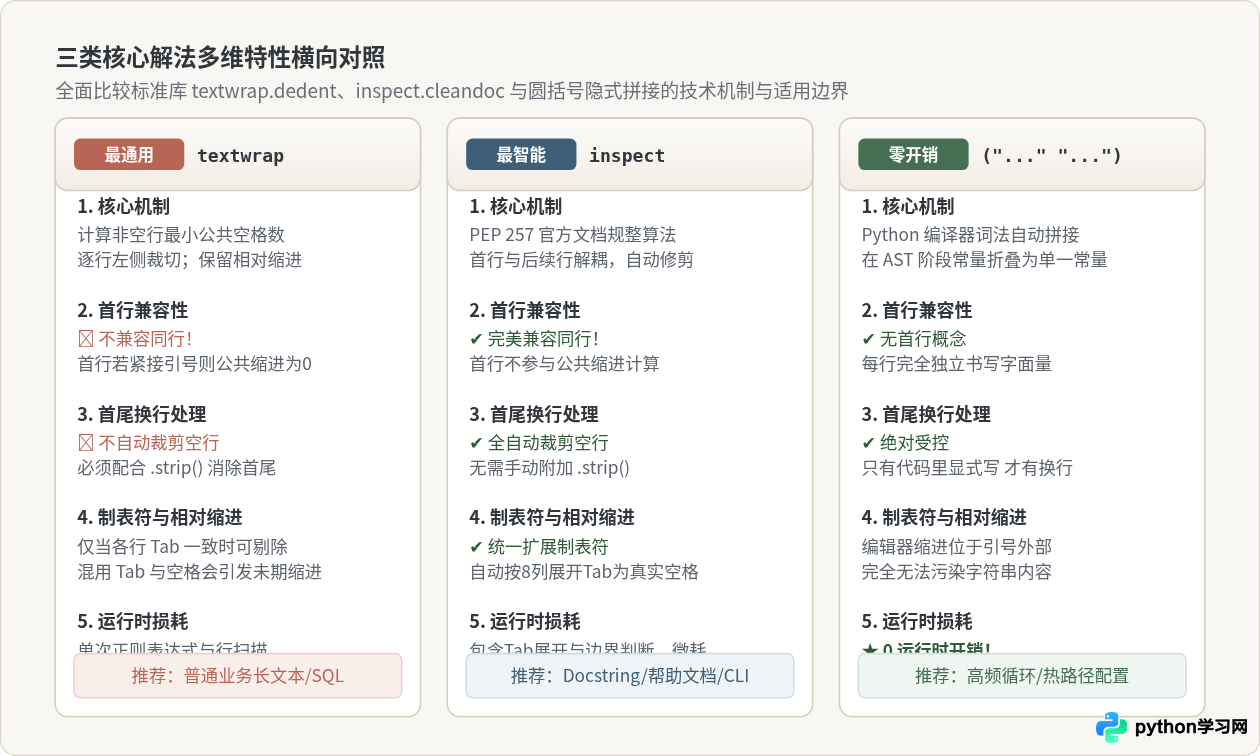
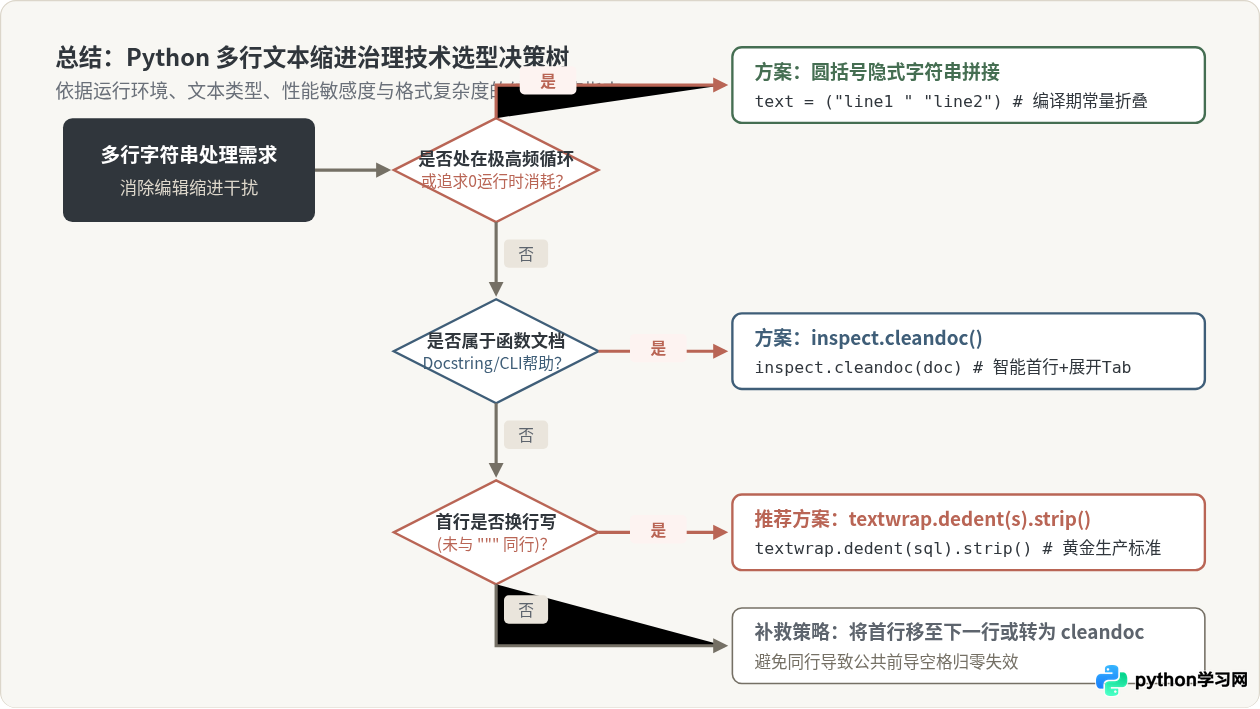
""" 或 ''')定义多行文本时,为了符合 PEP 8 代码排版整洁度而输入的缩进空格会被解释器原样保留在字符串内部;同时,开闭三引号各占一行还会额外引入首尾空行。解决这一缩进干扰的核心途径主要有三种:最通用且符合工程规范的做法是采用标准库 textwrap.dedent(text).strip();处理文档型文本或 Docstring 时优先选用能自动展开 Tab 并规整首行的 inspect.cleandoc();而在性能极端敏感的热路径或固定短配置中,则推荐使用圆括号隐式字符串拼接彻底消除缩进。
一、缩进干扰的本质与典型踩坑场景
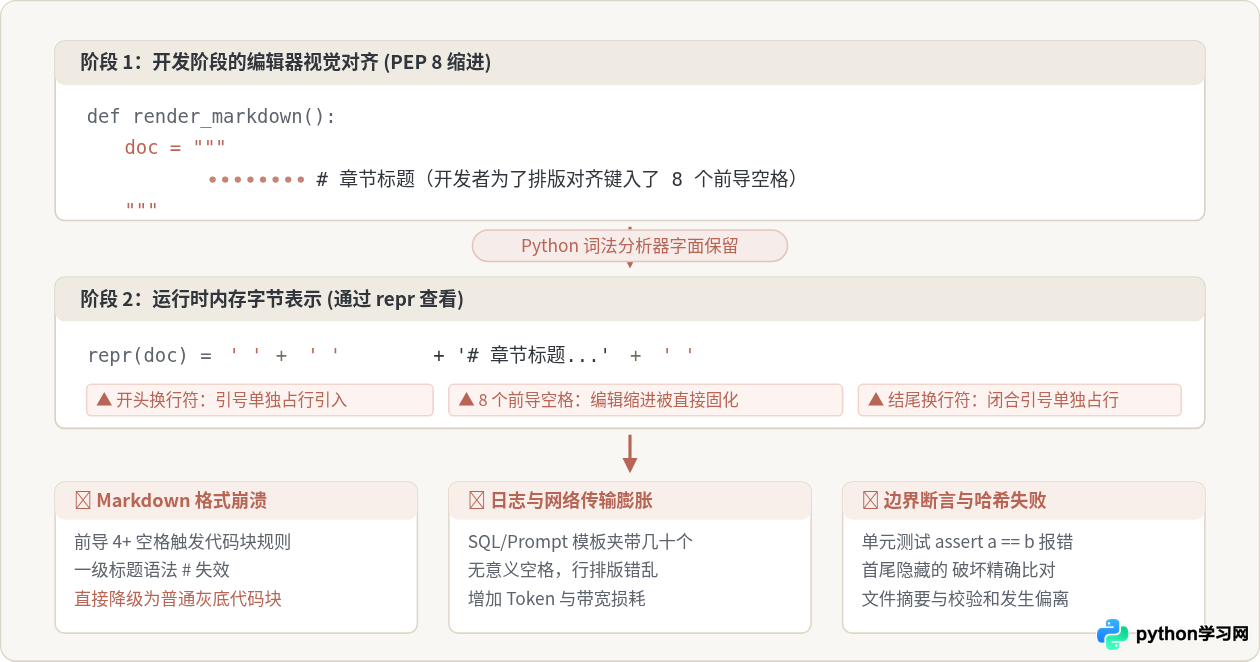
Python 词法分析器(Lexer)在解析三引号多行字符串时,遵循“字面值精确捕获”规则:在开合三引号范围内的所有字符,包括换行符 \n、制表符 \t 以及每一行起始处的缩进空格,都会被忠实记录并写入运行时的 str 对象中。
在实际工程开发中,开发者为了保持代码的层级感,必然会将三引号内的每一行代码向右缩进。例如一个深处两层缩进结构(如函数与 if 分支内)的代码块,文本左侧通常会带有 8 个空格:
def render_report():
    markdown_doc = """
        # 系统健康周报
        - 状态: 正常
        - 节点负载: 12%
    """
    return markdown_doc
如果我们通过 repr(render_report()) 观察返回值,会发现真实的内存表示为 '\n # 系统健康周报\n - 状态: 正常\n - 节点负载: 12%\n '。这种字面量污染会在以下常见场景中引发隐蔽故障:
- Markdown 语法解析崩溃:按照 CommonMark 及主流 Markdown 规范,行首连续 4 个空格或 1 个 Tab 会被直接触发并解析为“缩进代码块(Indented Code Block)”。上述示例中的
# 系统健康周报因为前导 8 个空格,直接丧失了一级标题的语义,被降级为灰底纯文本代码块显示。 - SQL 与日志排版紊乱:打印到终端或写入文件的日志中充斥着大段参差不齐的空白前缀,不仅显著增加了磁盘占用和网络传输体积,还在多层级异常排查时制造严重的视觉噪声。
- 边界断言与哈希校验失败:因为开闭引号单独成行,首尾各多出一个肉眼极易忽视的
\n换行符。当针对该字符串执行单元测试assert generated_text == expected_text或生成 SHA-256 摘要时,会导致测试屡屡失败。
二、标准解法:使用 textwrap.dedent() 清除公共缩进
解决此问题最标准、最通用的工具是 Python 内置的 textwrap 模块。该模块提供的 textwrap.dedent() 函数专门用于移除文本中所有非空行共同拥有的前导空白字符(Common Leading Whitespace)。
1. 工作机制与代码实现
textwrap.dedent() 在处理文本时,会遍历文本的每一行。它会跳过纯空白行,计算所有包含可见字符的行中最短的前导空格数,然后将这个统一长度的前缀从所有行中剔除。更重要的是,它能够完好保留正文内部的相对缩进。
import textwrap

def build_query():
    sql = """
        SELECT
            user_id,
            username
        FROM tbl_users
        WHERE status = 'active'
    """
    # 去除公共的 8 个前导空格,并去除首尾由引号换行带来的 \n
    return textwrap.dedent(sql).strip()

# 执行输出:
# SELECT
#     user_id,
#     username
# FROM tbl_users
# WHERE status = 'active'
在上面的代码中,SELECT、FROM 和 WHERE 开头的 8 个空格被彻底移除,而字段列表 user_id 前面相对于 SELECT 额外缩进的 4 个空格被精准保留。
2. 必须警惕的两个核心陷阱
虽然 textwrap.dedent() 十分高效,但在初次使用时常因以下两个排版习惯引发问题:
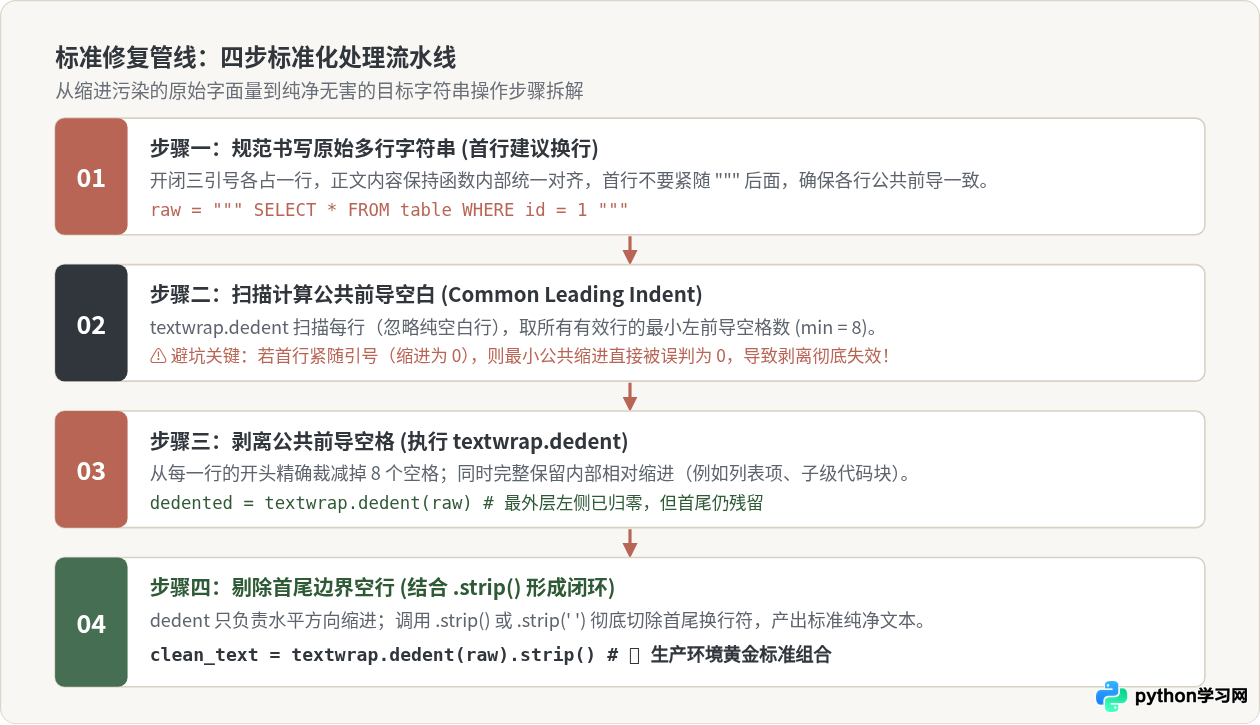
如果将文本第一行直接紧跟在开合三引号后面:
text = """SELECT id, name

          FROM users"""
此时第一行
SELECT id, name 的前导空格数量为 0!根据 dedent 寻找“所有有效行最小公共缩进”的计算规则,最小公共前导空白被判定为 0。结果是 dedent() 将原样返回字符串,后续行的前导空格一个都不会被删除。规范做法:开合引号必须单独换行,或者改用下面介绍的 cleandoc。
dedent() 仅在水平方向上削减空格,它不会删除第一行引号换行所引入的起始 \n,也不会删除末尾引号前的闭合换行符。因此在工程实践中,必须形成肌肉记忆,将 textwrap.dedent(text).strip() 或 .strip('\n') 作为标准组合调用。
三、高级解法:使用 inspect.cleandoc() 规整文档与复杂文本
如果你的文本不可避免地存在首行紧随三引号书写的习惯,或者文本来自模块、类的 __doc__ 属性,那么 Python 标准库中的 inspect.cleandoc() 是比 textwrap.dedent() 更省心、更智能的选择。
1. cleandoc 的三大自动处理优势
inspect.cleandoc() 是 Python 核心团队按照 PEP 257(Docstring 规范)标准实现的专用清理工具。与 textwrap.dedent() 相比,它具备三个鲜明的自动化特性:
- 首行与后续行解耦计算:即便第一行直接写在
"""之后(前导空格为 0),cleandoc也会自动忽略第一行,单独计算第二行及后续行的公共缩进并予以剥离,最终将首行与已缩进修剪的后续行自然拼接。 - 自动裁剪首尾边界空行:它在内部会自动修剪掉文本开头和末尾因排版引入的连续空白行,开发者不再需要额外手动附加
.strip()。 - 制表符(Tab)统一展开:它会自动调用内部规则将
\t按照 8 字符列宽规范转换为标准空格,从根源上避免 Tab 与空格混用导致的公共缩进计算失效。
import inspect

def render_cli_help():
    # 首行与引号同行,且尾部有空行换行
    help_text = inspect.cleandoc("""用法: app [OPTIONS] COMMAND [ARGS]...

        一个高性能分布式任务处理命令行工具。

        选项:
            --version  查看版本
            --help     显示当前帮助信息
    """)
    return help_text
上述代码中,第一行 用法: ... 处于顶格位置,而后续段落与选项缩进了 8 到 12 个空格。inspect.cleandoc() 能够识别第一行的大纲属性,将第二行之后的公共缩进完整移除,同时保留 --version 选项相对于 选项: 的内部层级。
四、编译期零开销解法:圆括号隐式字符串拼接
无论是 textwrap.dedent() 还是 inspect.cleandoc(),本质上都是在 Python 运行时(Runtime)通过字符串扫描、换行切分或正则表达式完成的修剪操作。如果一段文本处于高频调用的性能关键路径上(例如每秒执行上万次的网络序列化或循环体内部),反复调用文本修剪函数会产生不必要的 CPU 开销。
此时,最佳方案是利用 Python 解释器在编译期阶段的隐式字符串字面量合并特性(Implicit String Literal Concatenation):在圆括号 (...) 内部,两个或多个相邻的单引号或双引号字符串会被词法分析器直接在 AST 抽象语法树构建阶段融合成单一常量,完全不产生运行期损耗。
def get_critical_headers():
    # 在编译期由 Python 自动合并为单个常量字符串,零运行时函数调用
    request_headers = (
        "Host: api.internal.local\n"
        "Content-Type: application/json\n"
        "X-Service-Cluster: production-ap-east\n"
        "Connection: keep-alive"
    )
    return request_headers
这种写法的核心优势在于:
- 彻底杜绝缩进污染:每一行的缩进空格都处于双引号外部,代码虽然在编辑器中呈现出清晰的缩进结构,但字符串内容完全由双引号内部定义,绝不会掺杂任何前导空格。
- 换行符完全受控:换行符
\n由开发者显式控制,末尾行不加\n就绝对不会有多余的尾部空行。 - 零运行时开销:通过 Python 字节码反汇编
dis.dis(get_critical_headers)可以验证,该函数内部只产生了一条LOAD_CONST指令,运行速度达到极限。
如果多行文本中包含需要根据上下文动态计算的变量,使用由列表推导式构成的
"\n".join([...]) 能够在保持代码对齐的同时,提供优异的内存分配效率与可读性。
五、方案选型与工程实践决策指南
为了在团队协作与日常开发中避免重复踩坑,我们可以根据文本性质、性能要求和代码结构,按以下矩阵进行决策:
| 对比维度 | textwrap.dedent(s).strip() | inspect.cleandoc(s) | 圆括号隐式拼接 ("..." "...") |
|---|---|---|---|
| 适用主力场景 | 业务级多行 SQL、Markdown 模板、HTML 片段 | 函数/类 Docstring、CLI 帮助文档、提示词文本 | 高频热循环代码、固定协议头、简短配置项 |
| 首行同行支持 | 不支持(会导致公共缩进计算归零) | 原生完美支持(首行独立于公共缩进之外) | 不涉及(每行独立引号定义) |
| 首尾空行修剪 | 需显式配合 .strip() |
内置自动剔除首尾空行 | 精准受控(仅显式写 \n 时换行) |
| 制表符兼容性 | 仅支持严格一致的 Tab;混用易失效 | 内置自动将 \t 展开为 8 个空格 |
完全不受外部缩进字符影响 |
| 内部相对缩进 | 完好保留各层相对结构 | 完好保留各层相对结构 | 完全由字符串字面量显式声明 |
| 执行期性能 | 毫秒级(运行时字符串扫描与截取) | 毫秒级(运行时 Tab 展开与行规整) | 常量级(0 运行时开销,编译期完成) |
六、日常编码中的防错建议
在实际编写多行文本时,牢记以下三条工程自检清单,可以规避 90% 以上的排版 Bug:
- 坚决杜绝 Tab 与空格混用:Python 3 严格禁止同一作用域内混用制表符与空格作为代码缩进。如果在三引号字符串中某一行使用了真实 Tab,而另一行使用了 4 个空格,
textwrap.dedent()无法识别它们在视觉上的等价性,会直接导致剥离失败。建议在 IDE 中开启“显示不可见空白字符”以及“Tab 键自动转换为空格”配置。 - 使用 Raw String 时防范转义冲突:当三引号内部包含正则表达式或 Windows 路径反斜杠时,通常会写作
r"""..."""。需要注意,原始字符串末尾不能紧跟单个反斜杠(如r"""path\"""会导致 Python 语法解析报错,认为三引号尚未闭合)。若需在末尾表达反斜杠,应改用常规字符串并显式转义\\。 - 保持团队代码规范统一:建议在项目团队内明确规范:对于大段静态业务模板,统一采用首行换行的书写方式并搭配
textwrap.dedent(s).strip();对于 CLI 工具提示文本与文档解析,统一引入inspect.cleandoc()。
通过将代码的视觉结构缩进与字符串的底层字面量清晰解耦,我们既能享受 Python 优雅的代码排版,又能确保下游消费端得到精准无瑕的文本数据。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









