

Python多线程读取文件真的比单线程快吗?
深入探讨Python多线程读取文件是否比单线程更快,从GIL释放机制、存储介质(SSD与HDD)、文件数量形态到实测代码与技术选型,给出清晰的判断依据。
很多开发者在接触 Python 多线程时,都听过两句看似矛盾的话:“Python 有 GIL,多线程无法实现真正的并行”以及“I/O 密集型任务适合使用多线程”。当落实到“读取本地文件”这个典型 I/O 操作时,究竟应该使用单线程还是多线程?要得到确定且可落地的结论,我们需要剥离经验主义,从 Python 解释器机制、操作系统与底层硬件特性三个层面逐一拆解。
一、底层机制:为什么 Python 多线程在 I/O 时能够提速?
要理解多线程读取文件的性能表现,首要问题是厘清 GIL(Global Interpreter Lock,全局解释器锁)与系统调用的关系。很多初学者误以为 Python 的多线程在任何地方都是完全串行的,但实际上,CPython 在设计之初就对 I/O 阻塞调用做了专门的优化。
当 Python 代码调用标准库的 open() 和 read() 方法读取文件时,底层 C 语言实现会通过宏包裹 Py_BEGIN_ALLOW_THREADS 与 Py_END_ALLOW_THREADS。这意味着:当一个线程向操作系统内核发出文件读取系统调用(例如 POSIX 下的 read())并开始等待磁盘或网络响应时,该线程会主动释放 GIL。此时,CPU 控制权被让出,其他就绪的 Python 线程可以立即获取 GIL,继续运行并发出各自的文件读取请求。
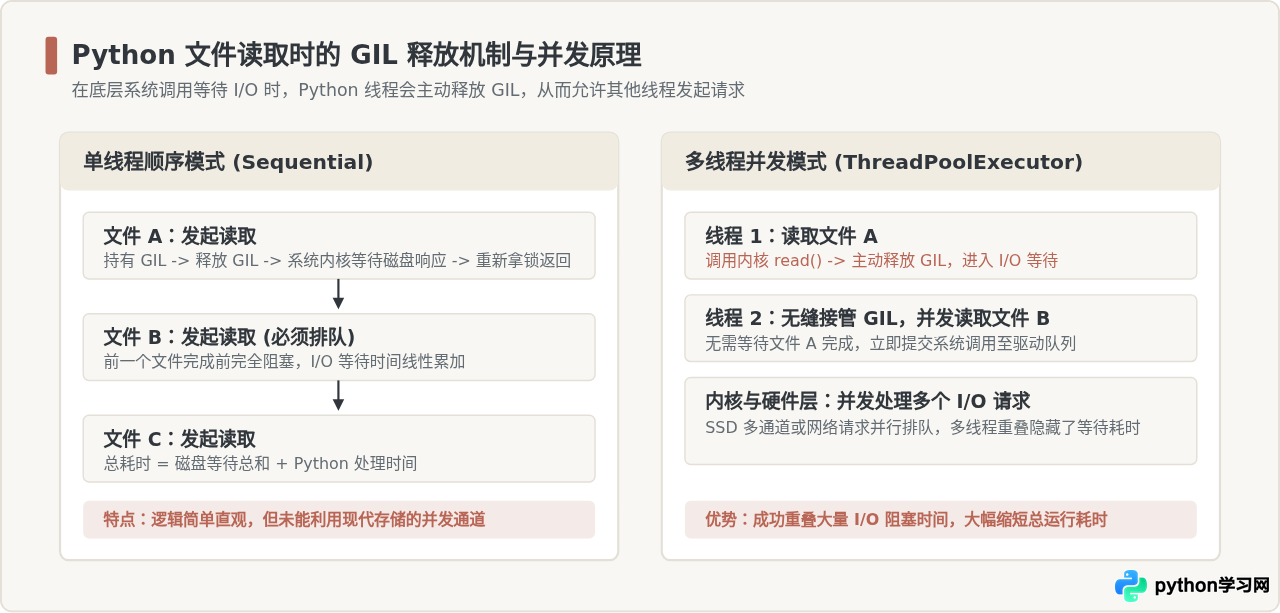
因此从语言层面来看,Python 的多线程完全有能力实现 I/O 请求的并发重叠。但多线程能否真正带来性能提升,决定权不在 Python 本身,而在于下层的硬件介质、文件形态以及处理链路。
二、决定性能的关键变量:硬件介质与文件形态
在现实开发中,同样是多线程读取文件,有人测出速度提升了 4 倍,有人测出反而变慢了一半。这种差异通常是由以下三个核心变量决定的:
1. 存储介质:机械硬盘(HDD)vs 固态硬盘(SSD)
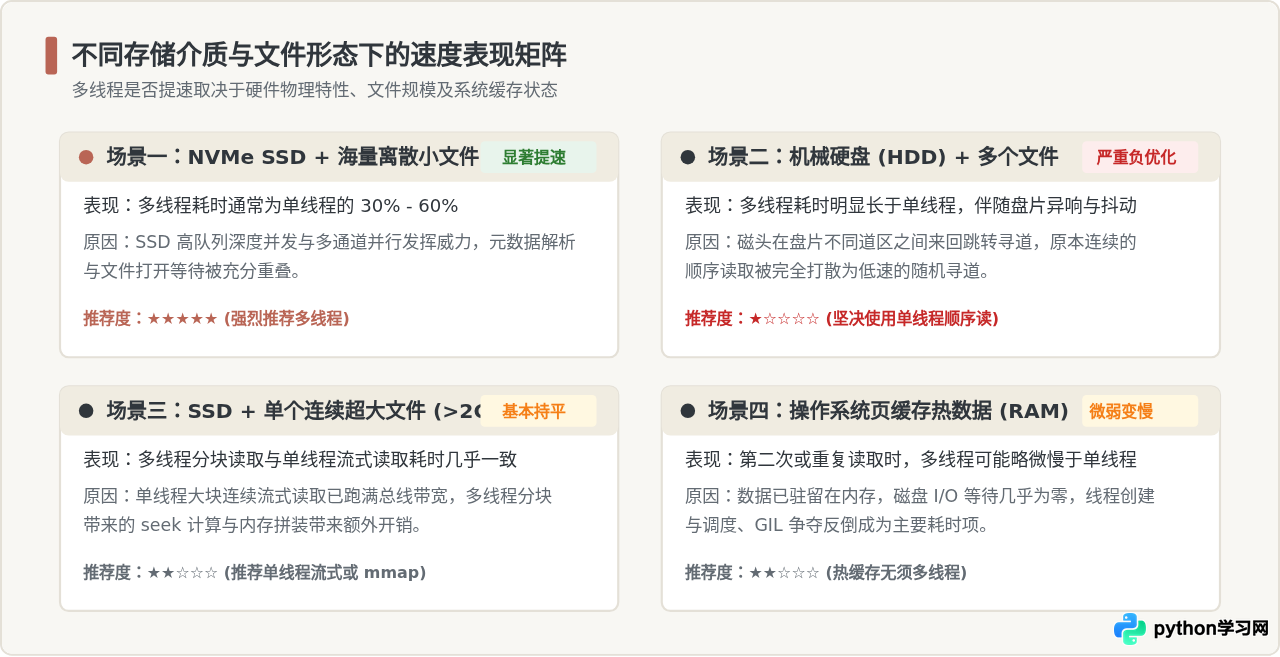
机械硬盘依赖物理磁头寻道。当单线程顺序读取一个或一组连续存放的文件时,磁头处于平稳的连续扫描状态;如果启用多个线程并发读取不同文件,由于各线程交替请求不同扇区的数据,磁盘调度器会迫使磁头在不同盘道之间频繁剧烈移动,导致“随机寻道延迟”急剧增加,原本的顺序 I/O 退化为随机 I/O,总读取耗时往往大幅度落后于单线程。
而现代固态硬盘(特别是 NVMe 协议 SSD)内部由多个闪存颗粒与多通道闪存控制器组成,天然具备高达数十至上百万的 IOPS(每秒读写次数)与高队列深度(Queue Depth)。单线程发起的单一请求往往只能填满极浅的队列,无法喂饱 SSD 控制器;而多线程并发发起读取,正好能打满硬件的并发通道,充分释放固态硬盘的物理潜力。
2. 文件组织形态:海量离散小文件 vs 单个超大文件
读取文件并不只有“传输数据”这一步,还包括系统层面的文件打开、路径查找、权限校验、inode 元数据解析以及句柄释放。对于海量小文件(如数十万张小型图片、代码文本或传感器日志),元数据与系统调用的等待耗时甚至超过了实际数据传输时间。多线程可以很好地将这些元数据查找延迟彼此重叠遮盖。
相反,如果要读取的是一个 10GB 的单一连续大文件,磁盘单通道流式读取的吞吐量通常已经逼近物理上限。即使在代码中通过指定 seek() 偏移量让多线程分块并发读取,不仅对整体吞吐没有实质贡献,还会引入额外的分块偏移计算、线程切换、内存拼装与互斥锁开销,反而适得其反。
3. 操作系统页缓存(OS Page Cache)
现代操作系统拥有强大的页缓存机制。如果一个文件在不久前被访问过,或者系统物理内存非常充足,文件内容可能早已被操作系统缓存在内存中。这种情况下,所谓的“读取文件”实际上变成了纯粹的内存拷贝(Memory Copy),没有任何磁盘物理 I/O 等待。在纯内存操作面前,GIL 锁竞争和线程上下文切换开销立刻显现,多线程读取甚至可能比单线程更慢。
三、具体实现:单线程与多线程读取的代码对比
在面对最适合多线程的“海量小文件批量加载”场景时,推荐使用 Python 标准库中的 concurrent.futures.ThreadPoolExecutor,它提供了结构清晰的高阶线程池管理与异常收归能力。
1. 单线程顺序读取示例
import time
from pathlib import Path

def read_single_file(file_path: Path) -> tuple[str, int]:
    """读取单个文件并返回文件路径及字节数"""
    with open(file_path, "rb") as f:
        data = f.read()
    return file_path.name, len(data)

def sequential_read(files: list[Path]) -> dict[str, int]:
    """单线程顺序遍历所有文件"""
    results = {}
    start_time = time.perf_counter()
    for file_path in files:
        name, size = read_single_file(file_path)
        results[name] = size
    elapsed = time.perf_counter() - start_time
    print(f"单线程读取完成,总计 {len(files)} 个文件,耗时: {elapsed:.3f} 秒")
    return results
2. 多线程池并发读取示例
import os
import time
from pathlib import Path
from concurrent.futures import ThreadPoolExecutor, as_completed

def concurrent_read(files: list[Path], max_workers: int = None) -> dict[str, int]:
    """使用线程池并发读取文件"""
    # 若未指定线程数,通常建议设为核心数的 2 到 4 倍,或不超过 32
    if max_workers is None:
        cpu_count = os.cpu_count() or 4
        max_workers = min(32, cpu_count * 4)

    results = {}
    start_time = time.perf_counter()

    with ThreadPoolExecutor(max_workers=max_workers) as executor:
        # 将读取任务分发至线程池
        future_to_file = {executor.submit(read_single_file, fp): fp for fp in files}
        for future in as_completed(future_to_file):
            file_path = future_to_file[future]
            try:
                name, size = future.result()
                results[name] = size
            except Exception as exc:
                print(f"读取文件 {file_path} 时出现异常: {exc}")

    elapsed = time.perf_counter() - start_time
    print(f"多线程读取完成 (worker={max_workers}),耗时: {elapsed:.3f} 秒")
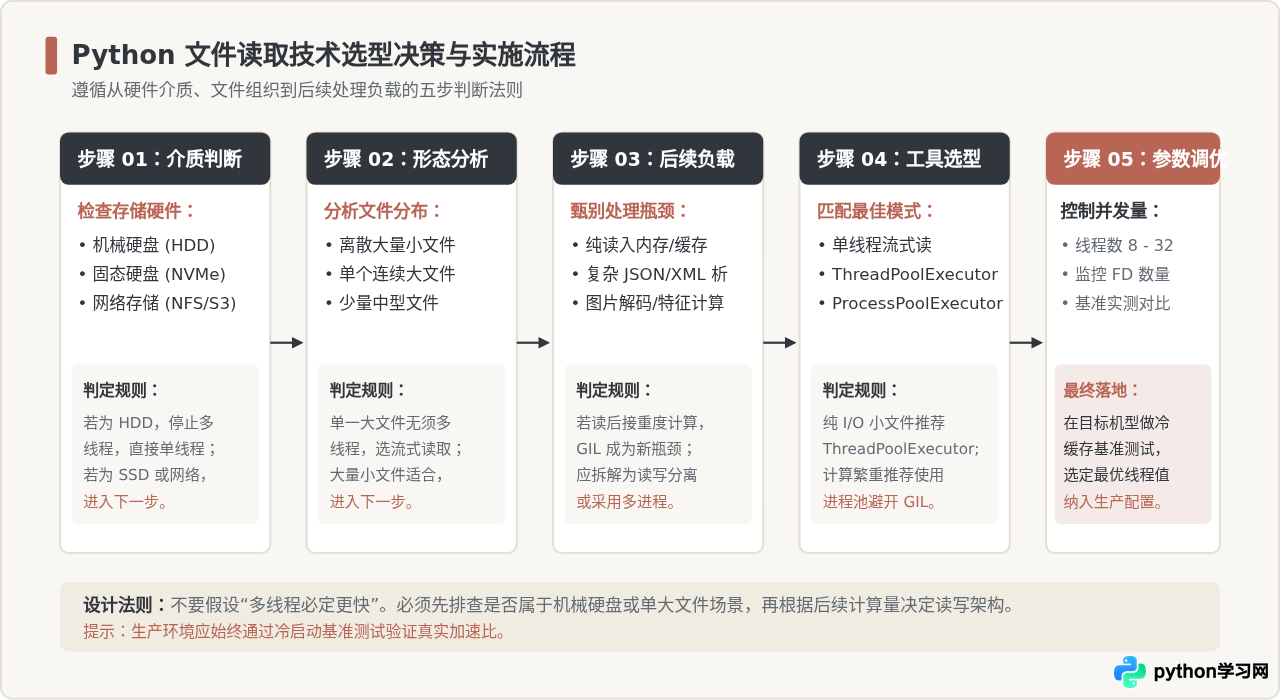
return results很多开发者误认为“线程越多越快”,将 max_workers 设为 500 甚至 1000。这不仅会导致瞬时文件描述符(File Descriptor)耗尽引发 OSError: [Errno 24] Too many open files,还会引起操作系统内存与线程上下文频繁切换的剧烈震荡。对于纯 I/O 读取任务,通常将工作线程数控制在 16 到 32 之间即可让 SSD 或网络通道达到饱和。
四、关键决策:什么时候该用?操作判定流程
在工程项目中,决定是否采用多线程读取文件,可以按照以下五步进行结构化排查与决策:
五、容易被忽视的反例:读后处理的计算瓶颈
在实际业务代码中,纯粹“读出字节便扔掉”的场景极其罕见。通常读取完数据后,紧接着需要进行业务处理,例如反序列化 JSON 文本、解压 gzip 文件、用 Pillow 解码图像或利用 Pandas 构建 DataFrame。正是这部分后续计算,经常让多线程读取的提速功亏一篑。
如果在读取工作线程的内部直接嵌套了繁重的 CPU 计算:
# 典型的反模式:在多线程中混杂重度 CPU 运算
def process_data(file_path):
    with open(file_path, "r", encoding="utf-8") as f:
        raw_text = f.read() # 此处释放了 GIL
    # 以下 CPU 密集型解析操作会重新独占 GIL
    parsed_json = json.loads(raw_text)
    features = extract_heavy_features(parsed_json)
    return features
在上述代码中,尽管 read() 阶段释放了 GIL,但只要线程进入 json.loads() 或特征提取计算,就会重新抢占 GIL。由于 CPython 解释器在 CPU 密集任务下的线程争抢机制,多个线程会频繁在锁竞争中打转,导致多核 CPU 无法有效利用,整体耗时比单线程顺序执行并无改善。
推荐的工程架构:
- 读算解耦(生产者-消费者模型):由单线程或少量多线程专门负责高并发读取文件,将二进制原始数据放入一个有界队列
queue.Queue;后方启动多个独立的子进程(multiprocessing.Process)作为消费者,从队列中取得数据并行进行 CPU 密集型解析。 - 纯多进程(ProcessPoolExecutor):如果单个文件体积较大且解析逻辑复杂,可以直接使用进程池。每个子进程拥有独立的 Python 解释器与独立内存空间,彻底绕过 GIL 限制。
六、总结与技术选型对照
回答“Python 多线程读取文件真的比单线程快吗?”,关键在于把握具体的前提约束。我们可以将常见场景归纳为下方的选型总结:
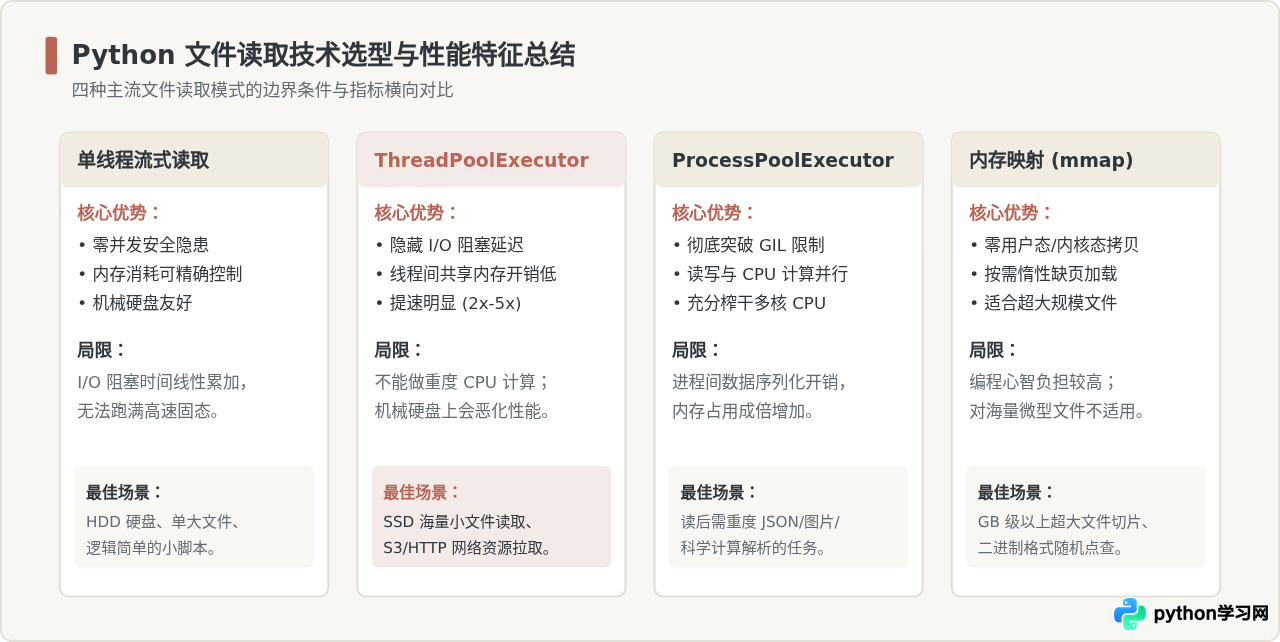
综上所述,Python 多线程读取文件不是银弹。它的提速本质是用软件并发去填补物理层面的 I/O 阻塞等待。当你的工作负载运行在 SSD 上、需要批量加载大量独立小文件时,毫不犹豫地使用 ThreadPoolExecutor;而当面对机械硬盘、单一超大文件或重度 CPU 计算任务时,保持单线程或切换为多进程架构,才是获得最佳性能的理性选择。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









